经过决策训练的语言模型,重新打开生成开关后,未必还能稳定地推理。在研究者的实验中,4B 模型在约 40% 的问题上几乎不生成推理;9B 模型则走向另一端,在约 70% 的问题上持续生成,直到触及长度上限。
这两种相反的失败模式提示:让决策模型从「直接判断」转向「逐步计算」,并非一次开关操作。除了选对答案,模型还需要形成有效的推理过程,并在计算完成后适时结束。
来自 StartLux、香港大学与南方科技大学的研究者围绕这一问题提出 StartLux-Decision。研究将单次预测版本 Instant 与按需推理版本 AutoThink 建立在统一的选项概率接口上,通过三阶段训练发展两类能力,并提出 RLCD²,以推理前后概率预测质量的变化训练推理策略。配套评测 DecisionPivot 则检验:当一个决定答案的细节发生变化时,模型能否相应改变决策。
论文标题:StartLux-Decision: AutoThink Decision Models with Reinforcement Learning for Calibrated Deliberative Decisions
统一的概率接口,两种注意力设计
请求路由、检索结果判断、工具调用校验和任务验收,通常不需要模型生成一篇解释,而需要它在明确的候选项之间作出判断。StartLux-Decision 将这类请求表示为「输入状态+问题+候选选项」,输出每个选项的概率,支持多选一、是非判断与等级评分。
概率直接来自语言模型已有的输出层。研究者将选项映射为 A、B、C 等字母,在提示的最后一个位置读取对应 logits,经温度缩放和 softmax 得到概率分布,不额外增加分类头。Instant 的单次预测,以及 AutoThink 推理前后的两次预测,采用相同的读出方式。
两种版本的区别首先体现在注意力结构。Instant 无需自回归生成,预测前已经获得完整输入,因此研究者在 Full Attention 层中去掉因果掩码,让提示内的 token 双向交互;Linear Attention 层仍保留因果计算。AutoThink 则保留因果注意力,以支持后续生成推理轨迹。
这里改变的不只是最后一个位置能看到哪些信息。因果模型的最终读出位置原本就能看到完整提示;双向化进一步允许前面的状态描述,在中间层整合后文的问题与候选项。对需要结合选项重新理解输入的决策任务,这提供了不同的表示计算方式。
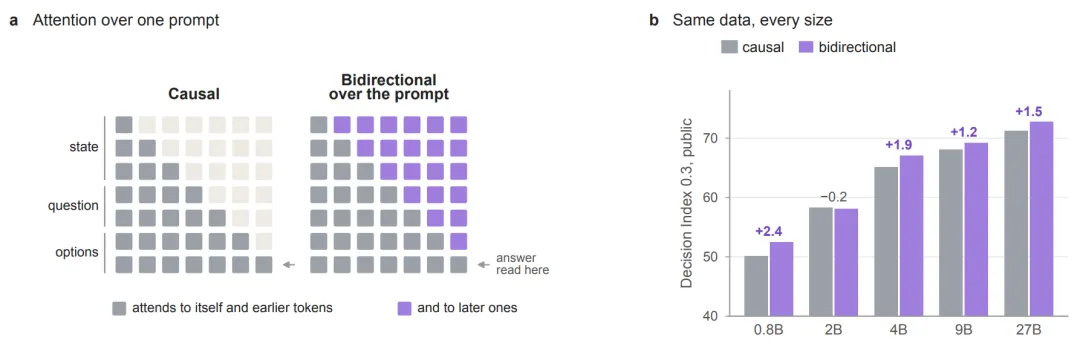
图 1|双向注意力的受控比较。左侧仅修改 Full Attention 层的提示注意力方向,Linear Attention 层仍保持因果计算;右侧为相同数据、相同初始检查点下的得分差异。(原论文图 4)
这项改动接受了同数据、同初始检查点的对照检验。五个参数规模中,四个规模的 DI 0.3 公开部分得分有所提高,最高增幅为 2.4 分;2B 的变化为 −0.2 分,未呈现同样的收益。论文同时报告,相同训练配置下不同随机种子之间存在 0.2—0.7 分的波动。因此,实验支持双向注意力在多数设置中有效,而不是对所有规模都必然有效。
共享的决策能力由前两个训练阶段建立。第一阶段对语言模型做全参数监督微调,0.8B—9B 使用约 270 万条决策样本,27B 使用约 80 万条;第二阶段使用约 170 万条样本训练并合并适配器,同时完成注意力方向的分化。Instant 到此形成单次预测模型,AutoThink 再进入推理监督与强化学习阶段。
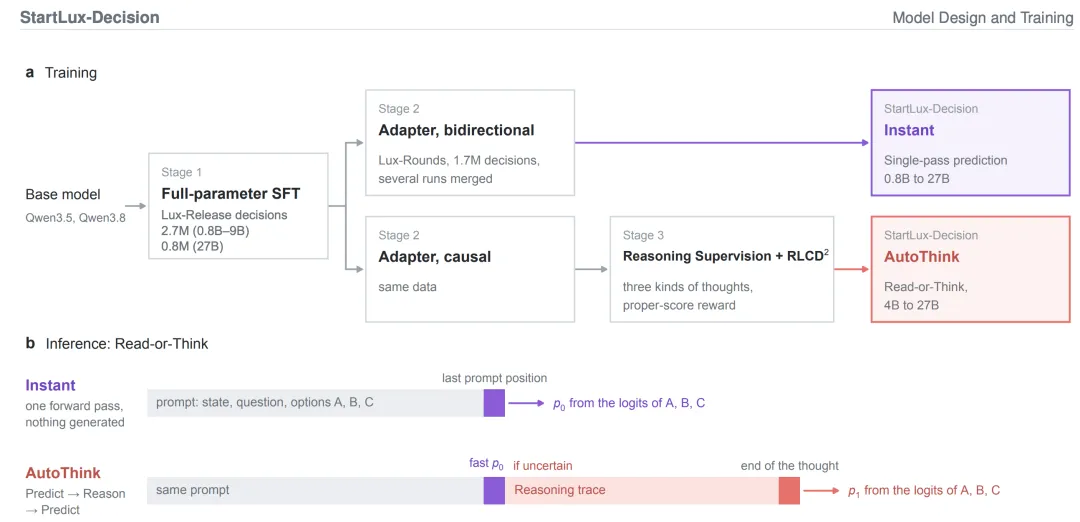
图 2|训练与推理流程。前两个阶段建立决策能力并分化注意力设计;第三阶段为 AutoThink 引入推理监督与 RLCD²。Instant 与 AutoThink 共用选项概率读出形式,但并非同一组发布权重。(原论文图 2)
Read-or-Think:先预测,再决定是否推理
AutoThink 先以一次因果前向计算得到初始选项分布 p₀。按照论文的默认评测配置,最大选项概率达到 0.9 时直接返回;低于 0.9 时,模型重新处理提示,生成推理轨迹,再从轨迹末尾读取选项分布 p₁。初始预测、推理生成与最终读出均使用同一组模型参数。
进入推理分支后,最终输出不是完全覆盖初始预测,而是对两次分布加权:
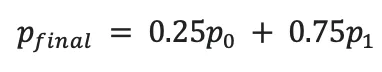
其中,75% 的推理后权重根据训练分布预留样本上的 Brier 分数选择,关注的是整个概率分布的预测质量,而不只是最高概率选项是否正确。这一权重在 9B 和 27B 上使该分数最优,在 4B 上接近最优。
论文用同一条数据导出政策下的两个案例说明这一过程。政策规定,处于法律保全状态的数据通常需要人工审核,但导出少于 100 条记录时该规则不适用;另有规则要求,过去 30 天导出少于 2 次、且本次少于 500 条时可以批准。两例均未触发更高优先级的拒绝规则。
第一个案例申请导出 3,332 条记录,过去 30 天已有 1 次导出。模型一次预测便给「转交人工审核」约 0.96 的概率,超过阈值,因此直接作答。
第二个案例只导出 8 条记录,过去 30 天没有导出。模型初始仍偏向人工审核,但最高概率只有约 0.57,于是进入推理。它核对了「少于 100 条」这一例外,再检查批准条件,用 159 个 token 得到结论。推理后「批准」的概率约为 0.995,与初始预测融合后约为 0.848,最终选项随之改变。
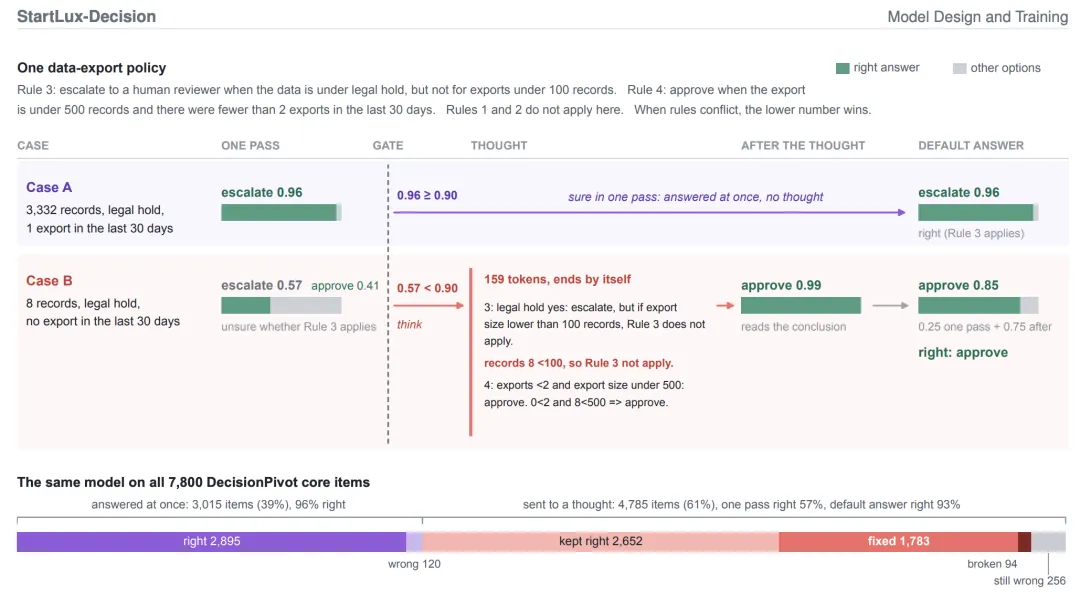
图 3|同一政策下的直接预测与推理修正。下方统计覆盖 7,800 道核心题:约 39% 直接作答,约 61% 进入推理。此图报告单题准确率,不是后文的成对准确率。(原论文图 3)
这一分流也体现在整体统计中。在 7,800 道 DecisionPivot 核心题上,27B AutoThink 对约 39% 的题直接作答,单题准确率约为 96%;其余约 61% 进入推理,融合后的准确率由初始的约 57% 提升至约 93%。推理纠正了 1,783 道原本答错的题,也引入了 94 道新错误。它改善的是一组被选中问题上的总体表现,并不保证每次展开推理都能修正答案。
RLCD²:用概率预测的改善评价推理
按置信度分流解决了何时触发推理的问题,但并不能保证被触发的推理有效。针对开篇提到的空推理与无法终止现象,第三阶段先使用约 4,000—21,000 条推理监督样本训练适配器,恢复各规模模型的推理生成与终止能力,再引入强化学习。
研究者提出的 RLCD²,全称为 Reinforcement Learning for Calibrated Deliberative Decisions,沿着 RLCD 与 OpenJev-RLCD 所探索的概率决策训练方向,显式优化推理对决策质量的贡献。
它与只奖励最终答案对错的训练存在一个区别:同样选中了正确答案,赋予它 0.55 还是 0.95 的概率,会影响下游系统是否自动执行、继续核验或交给人工处理。因此,奖励需要评价完整的概率分布,而不是只看最大概率选项。
为此,研究者冻结一份经过推理监督的模型,用它分别读取推理前后的选项概率。生成推理的模型继续训练,冻结副本负责评分。奖励由概率评分的增量与超长惩罚共同组成:
这里的两次概率读出均来自冻结评分模型,t 为目标分布,τ 为生成的推理轨迹,L 为该轨迹的 token 数。S 采用决策加权的严格恰当评分规则,在保持「如实报告结果概率具有最优期望得分」这一性质的同时,对高置信度区域的概率误差给予更大权重。它并不是单纯鼓励模型变得更自信。
发布配置中,软长度预算 B 为 3,072 个 token,超过部分每 token 扣除 10⁻⁴ 的奖励。这个预算并非硬截断点:模型仍可继续生成,直到 4,096 个 token 的上限。训练由此在概率质量和计算成本之间建立约束,而不要求所有问题都在同样短的篇幅内完成。
推理变短之后,哪些能力真正发生了变化?
研究者在 2,986 条预留样本上,对推理监督后的模型与 RLCD² 训练后的模型进行比较。为隔离强化学习的影响,这组实验对每道题都启用推理,统一采用 4,096 个 token 的生成上限;它不同于前述按置信度分流的运行方式。
9B 的变化最明显:推理自行结束的比例由 45.9% 升至 93.9%,平均长度从 2,494 降至 868 个 token,减少约 65%。4B 的自行结束比例由 89.5% 升至 99.3%,平均长度从 1,140 降至 722 个 token。27B 在强化学习前已有 97.2% 的推理能够自行结束,平均长度仅 313 个 token,进一步改善的空间较小。
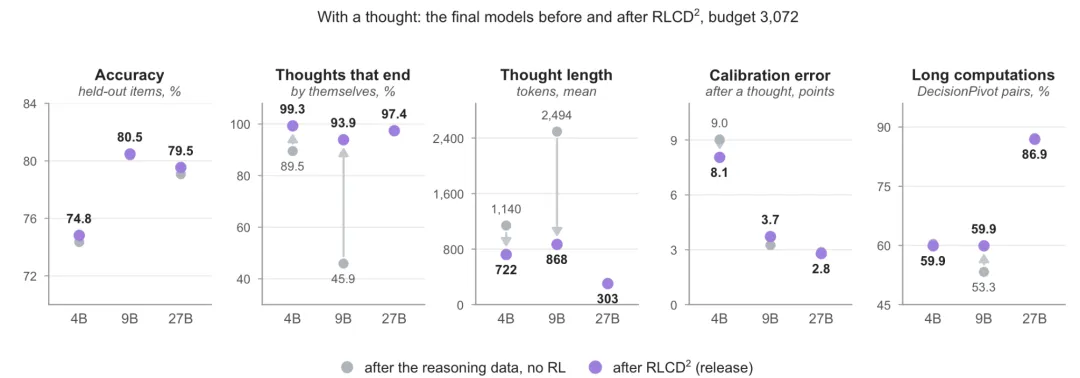
图 4|RLCD² 前后的终止、长度与质量变化。前四栏在 2,986 条预留样本上逐题启用推理;最右栏在 DecisionPivot 上使用 0.9 门控。3,072 是软惩罚预算,生成上限为 4,096 个 token。(原论文图 5)
三个规模在这组预留样本上的最终决策准确率,变化区间均包含零。因此,这组对照最直接支持的结论是推理终止和生成效率得到改善,而不是强化学习使所有规模的准确率显著提高。奖励消融进一步表明,长度惩罚主要推动推理终止,恰当评分奖励则对概率校准发挥作用,两者的贡献并不相同。
更短也不总是更好。在 DecisionPivot 上,4B 模型强化学习前的成对准确率为 60.4%;当长度惩罚从 512 个 token 后就开始生效时,该指标降至 52.9%。将软预算放宽到 3,072 个 token 后,成对准确率恢复到 59.9%。
完全去掉长度惩罚虽然得到 61.7% 的成对准确率,却使该评测中约三分之一的推理无法在生成上限内自行结束。实验揭示的是一种具体的取舍:需要抑制重复生成,但不能把真正需要长计算的问题一并压缩。发布模型统一采用 3,072 个 token 的软预算,是这一取舍下的配置,而不是适用于所有任务的最优长度。
DecisionPivot:关键细节变了,答案是否随之改变?
平均准确率不一定能反映模型是否识别了决定答案的条件。一个模型可能在大部分常见情况中选对,却在规则例外、阈值边界或一个被改动的字段上失误。
为检验这种敏感性,研究团队构建了 DecisionPivot。其核心部分包含 13 类程序生成任务,每类 600 道题,共 7,800 道,覆盖筛选匹配、台账核对、排班冲突、权限继承、目标状态核验和工具调用校验等场景。多数题目组成对照题对,只改变一个足以改变正确答案的细节,答案由程序验证。
核心指标是成对准确率:只有同一题对中的两道题均回答正确,才算通过,再对 13 类任务取平均。它比逐题统计更直接地检查,模型是否区分了表面相似、决策却不同的情况。论文明确说明,该评测未用于训练数据、检查点或推理配置的选择。
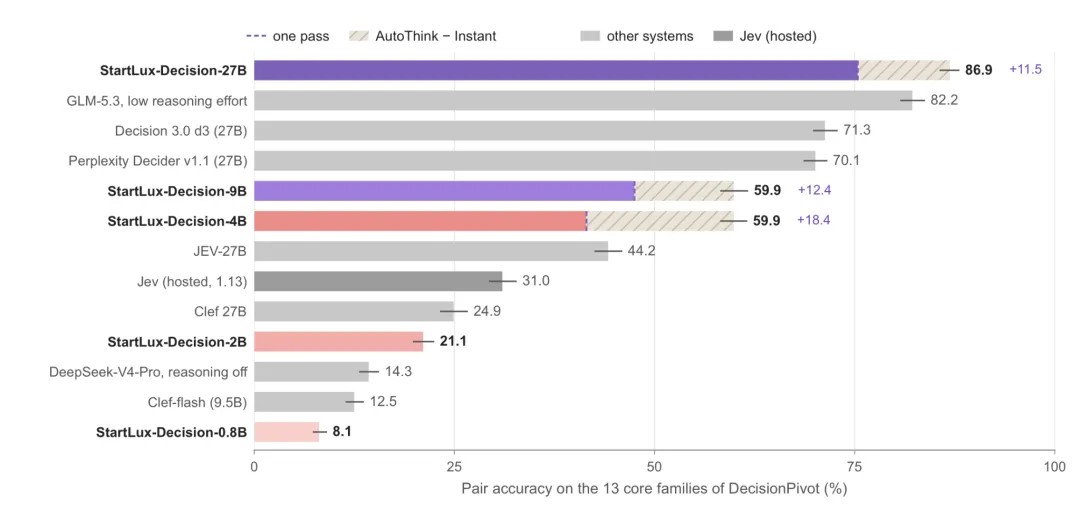
图 5|DecisionPivot 核心任务的成对准确率。彩色实心部分为 Instant,斜线部分为 AutoThink 相对 Instant 的差值;误差线为 95% bootstrap 置信区间。对照模型的推理设置如图所示。(原论文图 9)
4B、9B 和 27B AutoThink 的成对准确率分别为 59.9%、59.9% 和 86.9%;对应 Instant 为 41.5%、47.5% 和 75.4%,差值为 18.4、12.4 和 11.5 个百分点。对照系统中,Decision 3.0 d3 与 Perplexity Decider v1.1 分别为 71.3% 和 70.1%,启用低推理强度配置的 GLM-5.3 为 82.2%。这些比较对应图中列明的模型与运行设置。
收益并不均匀分布在所有任务上。4B 和 9B 的提升集中在筛选、目标状态核验与排班冲突等需要计算或逐项检查的任务;而政策解释、条款变动与依赖关系处理等任务中,强单次预测模型仍有较好的表现。这说明,显式推理的价值与任务所需的计算有关,不能只用一个总分概括。
固定同一个模型,分离推理本身的收益
Instant 与 AutoThink 的比较同时包含注意力方向和训练阶段的差异。要判断额外推理究竟贡献了多少,还需要固定同一个 AutoThink 检查点,只改变是否启用推理。
研究者将置信度阈值从 0 扫描到 1:前者从不推理,后者始终推理。27B AutoThink 在 DecisionPivot 上关闭推理时,成对准确率为 48.0%;采用默认 0.9 阈值后为 86.9%,平均每题使用 304 个推理 token。9B 则从 22.3% 提升至 59.9%,平均每题使用 1,365 个推理 token。这里的平均值包含不推理、生成 token 数为零的题目。
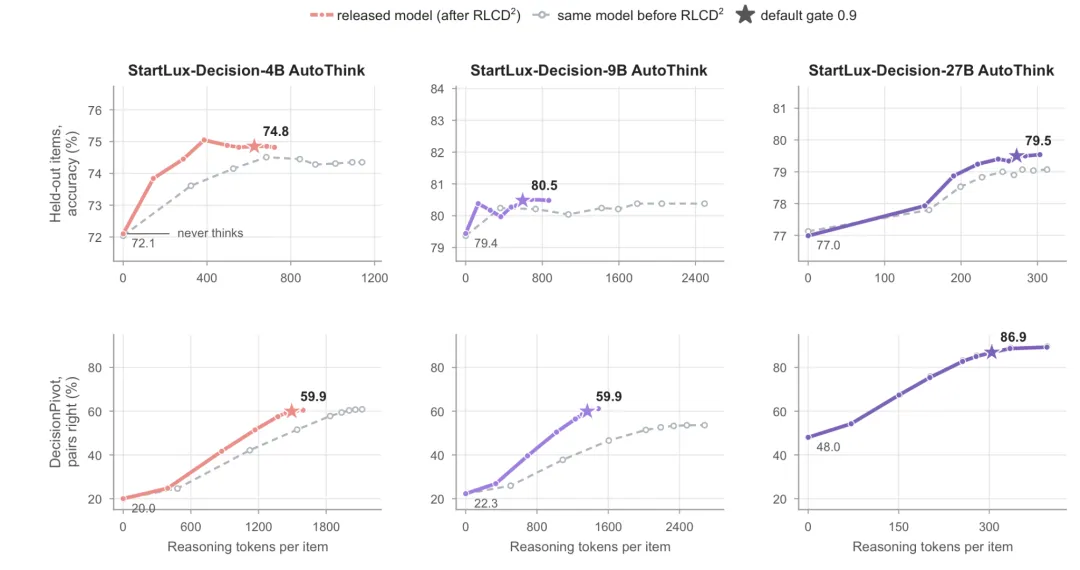
图 6|固定 AutoThink 检查点后,改变推理阈值的效果。上排为预留样本单题准确率,下排为 DecisionPivot 成对准确率;横轴包含直接作答题目的零 token 开销,各规模横轴范围不同,星号标记 0.9 阈值。(原论文图 13)
其中,48.0% 是 AutoThink 自身关闭推理后的成绩,不是 27B Instant 的 75.4%。前一组比较用于分离同一模型中显式推理的作用,后一组比较的是两种完整训练方案,二者不能互换。
在训练分布的预留样本上,27B 默认配置比关闭推理提高约 2.5 个准确率百分点,平均每题使用 273 个推理 token;9B 在默认阈值下获得约 1 个百分点的收益,而对全部题都启用推理并未进一步提高准确率。两类评测的差异说明,按需推理的收益和开销依赖任务分布,不能由单个案例或固定的推理比例推及所有请求。
Decision Index:总体得分与任务差异
在 DI 0.3 公开部分,五档 Instant 模型的得分从 0.8B 的 53.8,依次上升到 2B 的 59.1、4B 的 67.9、9B 的 70.0 和 27B 的 72.8。相对于各规模中最强的已评测第三方决策模型,差值为 7.4—16.9 分。这里是经过机会水平校正、按领域汇总的指数分数,不是原始准确率。
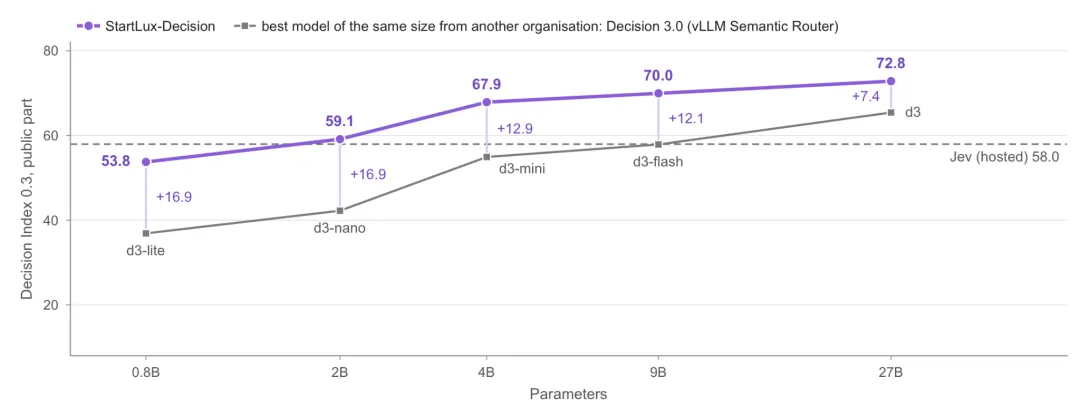
图 7|DI 0.3 公开部分的规模对比。紫线为 Instant,灰线连接各规模最强的已评测第三方决策模型;Jev 为参数规模未公开的托管模型。图中分数不代表完整 DI 0.3 榜单成绩。(原论文图 7)
AutoThink 的综合分数进一步达到 4B 的 68.21、9B 的 70.45 和 27B 的 73.37。总体增幅不大,但分领域结果更能体现差异:「知识与推理」中,4B 和 9B 比 Instant 分别提高约 7.0 和 6.2 分;在一些其他领域,Instant 反而保留优势。这与两类模型的设计取舍相对应,并不意味着开启推理后所有任务都会改善。
这些数值需要放在论文的评测范围内理解。DI 0.3 公开部分只对应完整榜单评分的 20%,且曾用于本研究的数据配方与模型选择;它不是独立测试集。AutoThink 的数值是论文使用公开评测工具得到的结果,不能视为其进入了排除推理轨迹生成模型的单次预测榜单。论文因此另外使用未参与开发选择的 DecisionPivot 进行独立检验。
概率经过筛选和路由,还能保持原来的含义吗?
模型选对答案之外,还有一个直接影响系统使用的问题:一个「80% 的把握」,在不同决策流程中是否仍对应相近的实际正确率?
论文发现,单条预测上的概率校准不能自动迁移到下游策略。以 9B 模型作为验证器,原始预测中被赋予 80%—90% 置信度的单条回答,实际正确率为 92%;但从 32 个候选回答中挑出最高分后,同一置信区间内的正确率降至 78%。这里下降的是固定置信区间中的正确率,并不能据此推断 best-of-N 的总体准确率下降。
原因在于,选择操作改变了返回预测的条件分布。最高分不仅反映答案质量,也可能包含评分的向上波动;其他候选的得分还能提供问题难度的信息,而这些信息没有被最终的一个分数充分表示。即使先对单条预测做常规校准,随着候选池扩大,这种偏移仍可能存在。
图 8|策略感知校准。左侧在常规校准与策略感知校准后,比较固定置信区间内的正确率;右侧为四类流程中的平均绝对置信度 — 准确率差距。校准改变置信度估计,并未重新训练底层模型。(原论文图 15)
研究者因此提出策略感知校准(policy-aware calibration):先在带标签的校准数据上执行实际的筛选或路由策略,再使用被返回的预测及相关策略信息拟合校准映射。候选选择需要考虑候选数量、平均候选分数等信息;按需推理和级联则将触发路由的置信度纳入校准。
这一步不重新训练底层模型,也不把原本选错的答案改对,而是调整对最终输出可靠性的估计。在覆盖 best-of-N、推理门控、级联与先筛选后推理的 184 组设置中,有符号的置信度 — 准确率差距从 −11.7 至 +20.5 个百分点,缩小到 −2.7 至 +2.1 个百分点。
校准仍有分布边界。将映射迁移到未见数据集后,论文观察到最高约 6.1 个百分点的残余过度自信。因此,可靠性不仅是模型检查点的属性,还与候选数量、路由规则和任务分布有关;系统策略改变后,校准与接受阈值也需要重新检验。
将推理质量、计算成本与系统可靠性分开检验
部署实验延续了这种区分。论文提供 vLLM、llama.cpp 与 MLX 支持,并评测了不同量化格式。在单张 H200、BF16、256-token 提示与单请求条件下,Instant 的单次读出中位延迟为 24—52 毫秒;一旦 AutoThink 触发推理,端到端延迟还包括轨迹生成和后续读出,不能沿用单次预测的毫秒数。在配备 64GB 统一内存的 Apple M5 Pro 上,27B 的 BF16 版本超出可用内存,8-bit 与 4-bit 量化则使本地运行成为可能。
研究也留下了明确的开放问题。新增决策数据的收益主要落在已覆盖的任务族,跨任务族迁移的证据仍然有限;固定置信度阈值并不等于已经找到逐题最优的计算分配策略;分布变化也会削弱已经拟合的校准映射。
StartLux-Decision 将这些问题分别落到了可检验的设计上:注意力方向影响单次预测的表示能力,RLCD² 优化推理带来的概率收益及其生成成本,DecisionPivot 检验对关键细节的辨别,而策略感知校准关注概率进入系统后的行为。对决策模型的评价,由此不再停留于一次预测是否正确,还需要追问额外计算改善了什么,以及最终返回的置信度究竟能支持怎样的行动。
© THE
来源:机器之心