新具身基础模型连接了预训练,后训练和部署后学习,帮助机器人发展通用能力并通过现实体验不断提高
智元机器人 揭示了GO-3预览,这是一个具身基础模型,支持在预训,后训和部署后的整个生命周期中进行大规模学习.
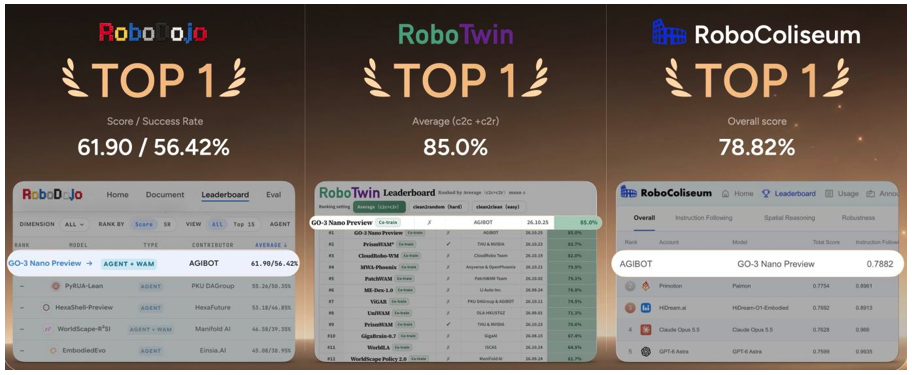
该模型还获得了三大具身智能基准 RoboDojo,RoboTwin和RoboColiseum的第一名,并在2026年底之前将完全开源.
基于智元机器人自主研发的具身智能架构,WRAM (世界理性行动模型),GO-3预览统一了任务理解,未来状态预测和行动生成,使机器人能够在任务中通用并执行精确的操纵.
与Genie Evolver,智元机器人的混合后训练系统以及Genie Master,其体现的代理框架一起,GO-3预览构成了一个跨越预训,后训和现实世界部署的综合学习系统.
智元机器人将这种方法称为"全生命周期扩展",旨在帮助机器人发展通用能力,通过互动完善技能,并通过从事现实工作不断提高技能.
大型语言模型在推理和基于知识的任务方面取得了显著进展,
像抓住小物体和组装组件这样的任务需要预测环境变化,管理接触力和执行精确的物理运动的能力.
对于具身智能来说,挑战不仅仅是扩大模型训练,而是延伸学习到整个生命周期. 机器人必须通过训练后的互动学习,并在部署后继续适应.
GO-3预览基于这一原则:使机器人不仅能够学习如何执行任务,而且通过执行任务也可以变得更有能力.
预训练规模化:建立在任务中转移的通用能力
考虑一个简单的说明: 拿起杯子.物体可能是一个带手柄的杯子或一个光滑的玻璃,放置在桌子中间或被杂乱所包围.
在预训练期间,GO-3 Preview通过其体现的本土WRAM架构扩大数据和模型能力来解决这一挑战.这种方法旨在帮助机器人学习可转移技能并更快地适应未熟的情况.
在一个统一的架构中,WRAM将任务理解,未来状态预测和行动生成连接起来.三个核心设计 (CoAE,SVP和KASO) 合作,帮助模型了解需要做什么,预测接下来可能会发生什么,并生成完成任务所需的行动.
控制导向自动编码器 (CoAE) 通过将视觉感知与物理行动联系起来,它提供了预测未来状态和产生适当的运动的基础.
副总裁 基于当前观测和任务条件,在单一步骤中生成未来状态的完整预测. 行动生成模块然后学习如何从当前状态向预测结果移动.
通过将机器人的观测与可能的未来发展联系起来,SVP帮助模型预测变化,而不是仅依赖于立即的视觉输入.
卡索 通过选择与训练期间实际采取的行动更一致的未来预测来解决物理环境中多种可行的结果的挑战.
这些选择的预测用于联合学习,帮助将未来状态预测与行动生成协调起来,以便模型能够学习导致物理一致的结果的行动.
在这些三个机制基础上,GO-3预览通过数据和模型开发来扩展学习.数据方面,模型从异质来源中学习.人类第一人视频提供了对象互动和任务执行的丰富的例子,而机器人轨迹建立了观测,行动及其物理结果之间的联系.
在模型方面,学习能力的提高有助于系统组织这些多元化的经验,并将其转化为可用于不同任务的通用能力.目标不仅仅是学习更多的例子,而是在遇到新情况时更好地利用这些经验.
GO-3预览从人类的第一人视频和机器人轨迹中学习,将对象互动和任务执行与行动和物理结果联系起来.
在预训练后,GO-3预览展示了零射击和少射击设置中的任务适应性.在零射击场景中,该模型可以在物理机器人上应用以前学到的功能到新任务上,而不需要具体任务的监督细节调整.
这表明它能够将一般技能转移到陌生的任务和环境中.对于更复杂的操作,GO-3预览可以通过简单的学习进一步改进,使用少数示范来调整其能力.

LEGO 装配提供了一个例子. 任务要求机器人识别单个组件,精确地抓住它们,将它们的位置排列并正确地插入它们.
通过有限的额外示范和细节调整,模型可以学习这些精确的操纵技巧,而一个体现的代理将单个步骤协调成一个完整的装配过程.
这些例子展示了预先培训如何建立一个支持直接任务转移和进一步适应的总体基础.
训练后扩展:通过物理和虚拟互动提高
只有通用能力才能使机器人能够可靠地完成每项复杂任务.就像人们通过重复练习来完善他们的技能一样,机器人也需要机会进行实验,获得反和改进他们的行动策略.
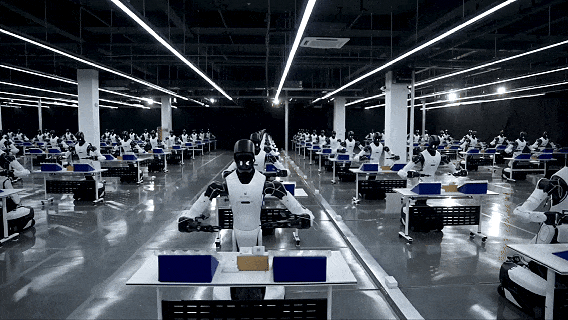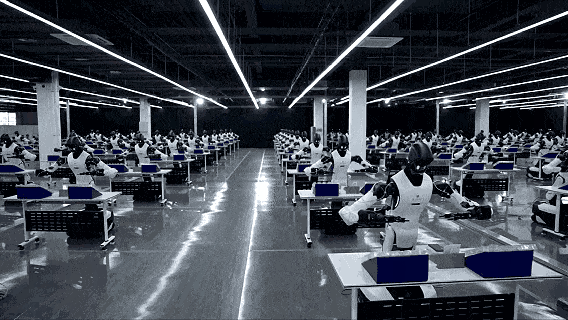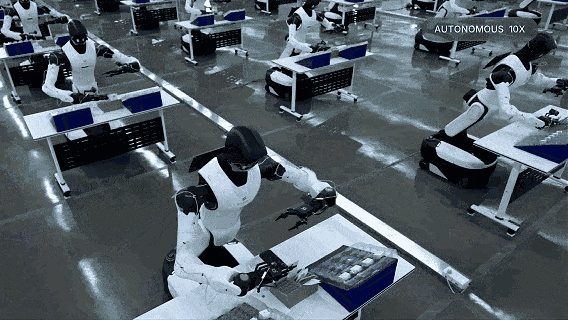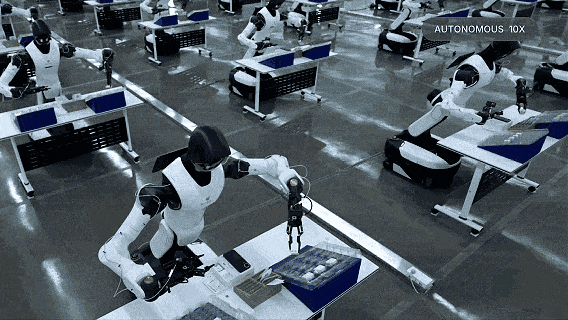
为了GO-3预览后训练阶段,智元机器人开发了Genie Evolver,这是一个分布式混合环境训练系统,它结合了100个物理机器人机队,物理模拟和世界模型.
通过扩大互动的规模和多样性,Genie Evolver使机器人能够从物理执行和虚拟探索中学习,通过反不断完善其行动政策.该系统汇集了三个互补学习环境.
物理机器人:从集体经验中学习
在现实环境中,Genie Evolver使用CEL (集体体验学习) 来汇总多种机器人中的执行经验.成功的轨迹提供了有效行动的例子,而围绕失败尝试的背景有助于确定需要改进的地方.
通过获取相关成功经验和更新共享策略,CEL使得单个机器人所学到的经验有利于更广泛的机器人队伍.
物理模拟:扩大互动范围
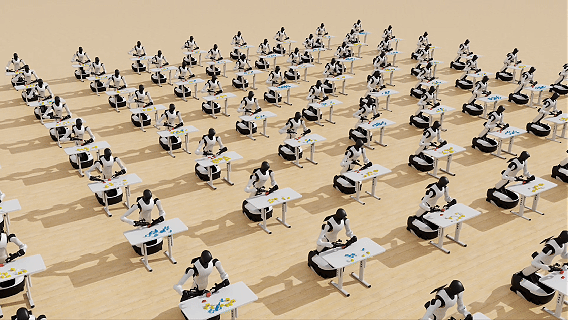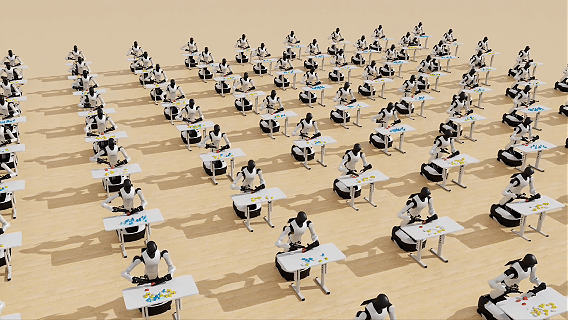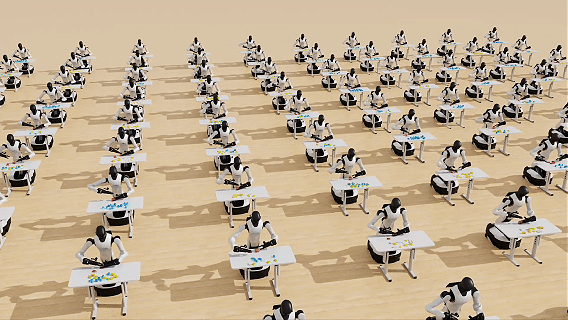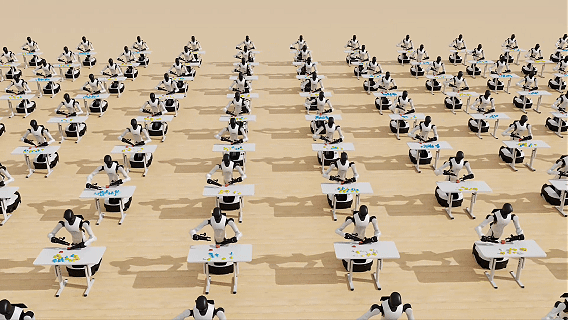
物理模拟提供了控制环境,机器人可以在不同的条件下练习和评估.
这些环境扩大了训练可用的物理互动和场景的范围,同时允许在一致的条件下重复实验. 这使得探索替代策略并提高在更广泛的情况中强度.
物理模拟帮助机器人在各种场景中练习和改进.
世界模式:探索多种可能的未来
世界模型允许系统通过探索其他结果,从每个现实世界的经历中更多地学习.
而不是把互动视为单一的行动序列,Genie Evolver可以重新审视关键决策点,在世界模型中测试不同的可能行动,预测和比较他们的结果.这些探索的反后被用来完善行动策略,后者可以在物理机器人上测试.
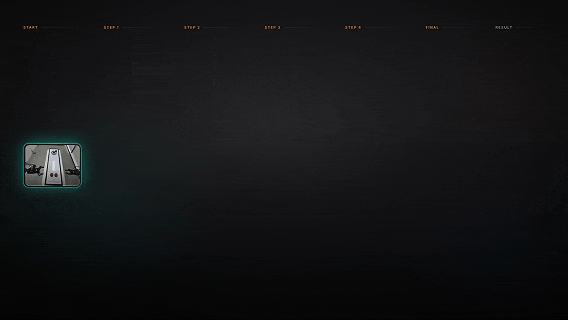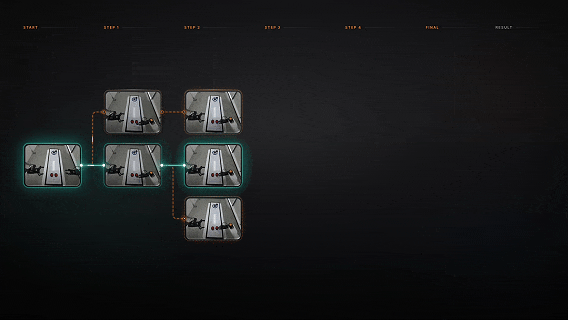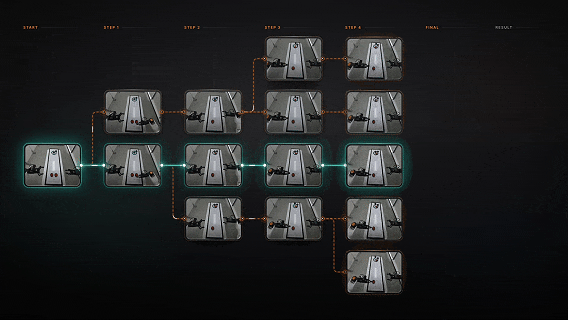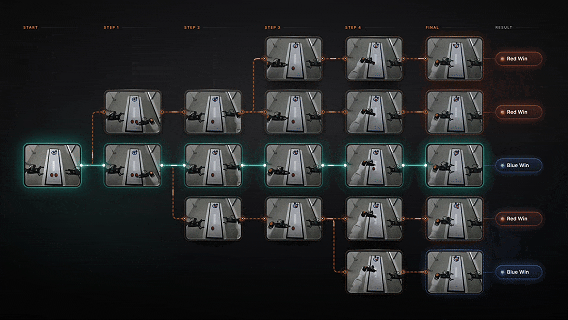
这些环境共同创造了一个持续的改进过程,其中现实世界执行,模拟和未来状态探索相互加强.智元机器人通过多项需要精度,适应和快速决策的操纵任务来证明这一方法.
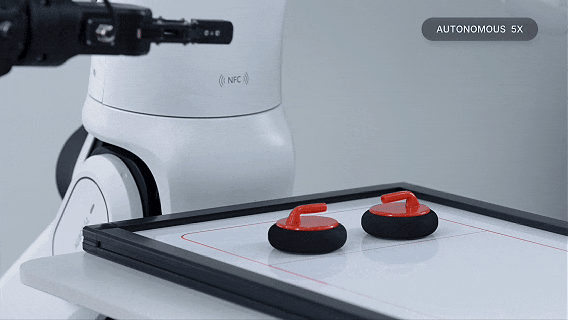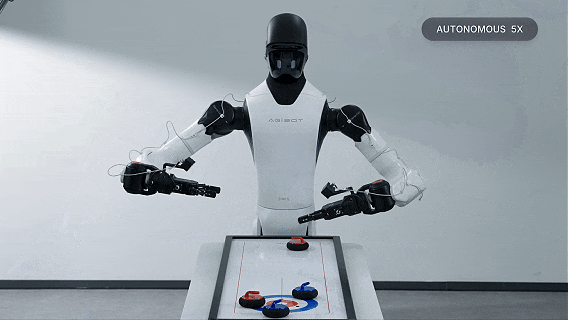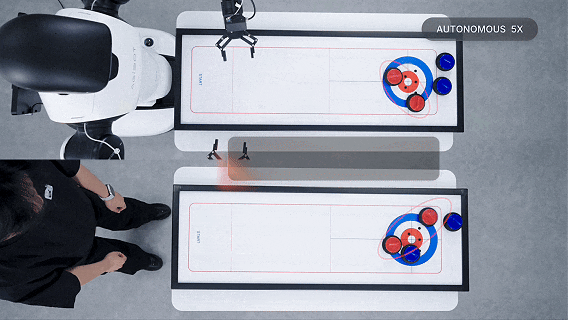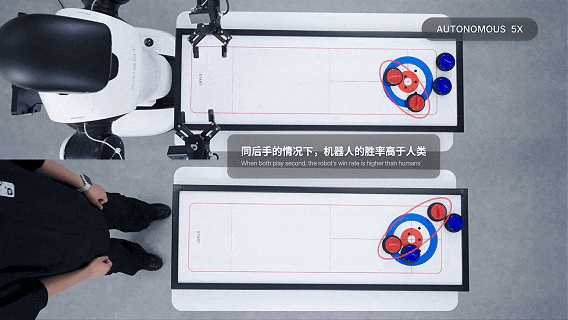
在 桌面卷轴,机器人必须控制每次射击的力量和角度.过少的力量可能无法移动对手的石头,而过度的力量可以使机器人自己的石头离开得分区.成功取决于在考虑石头的位置时达到正确的平衡.
根据智元机器人的说法,仅仅经过几个小时的练习,结合现实世界互动和世界模型学习,
区块提取 每个成功的行动都会改变下一个行动的条件.当删除一个红色块时,剩下的块的位置和方向可能会发生变化.这些变化可能会影响后续的决定,使得通过固定的运动序列完成任务变得困难.
通过利用积累的经验,机器人可以在每个操作后重新评估堆,调整其策略,并继续移除目标块,直到任务完成.

把球扔进一个移动的篮子 与静止目标不同,移动篮子给机器人观察,预测和反应的时间较少.机器人必须快速识别篮子的位置,同时在实时调整投篮的力量和角度.
快速变化的条件的准确预测同样重要,使机器人能够协调其运动,并在合适的时刻释放球.
部署后规模化:通过现实工作学习和改进
即使在广泛的预训练和后训练中,机器人必然会遇到以前从未见过的情况.传统上,解决这些问题通常需要人类工程师修改代码,收集额外的数据或手动调整机器人的行为.
这限制了部署后能力的快速提高.智元机器人的方法是将学习扩展到部署阶段,使机器人能够在执行实际任务时提高.
通过其体现的代理框架,Genie Master,智元机器人将规划,执行,反和体验保留连接起来,以帮助机器人适应新的挑战并不断发展其能力.Genie Master引入了EEP (Embodied Execution Protocol),该协议标准化了四类界面:能力,指导,反和连续性.
这些接口使实体代理能够识别有哪些机器人能力,确定应如何执行任务,评估结果是否符合预期要求,并跟踪未完成的工作.
通过连接这些功能,Genie Master帮助机器人协调任务执行,识别故障,从例外中恢复并保持有用的操作经验.
最重要的是,这种经验可以通过两个互补的学习途径为未来的改善做出贡献. 第一个将操作经验转化为长期记忆在任务规划和执行过程中,系统记录了成功和失败的尝试,
在每天运营结束时,模型将这些经验的可重复使用知识集成到长期记忆中.
当类似的任务或情况出现时,代理人可以获取相关的过去经验来指导任务规划,改善决策和支持从失败中恢复. 这使得一项任务中学到的经验成为未来运营的有用知识.
第二个途径将执行经验转化为改进的行动政策由于代理协助执行,在必要时接管并支持从故障中恢复,系统会产生轨迹和反,以捕捉问题,调整和结果.
随着时间的推移,可以将有效的调整纳入模型参数,将实践经验转化为可在后续任务中重复使用的能力.
这创造了一个反循环,部署不仅使现有技能发挥作用,还创造了新的学习机会.
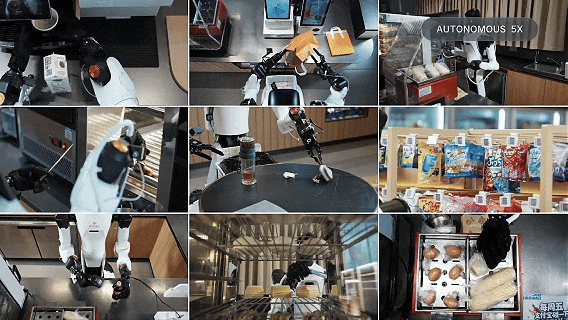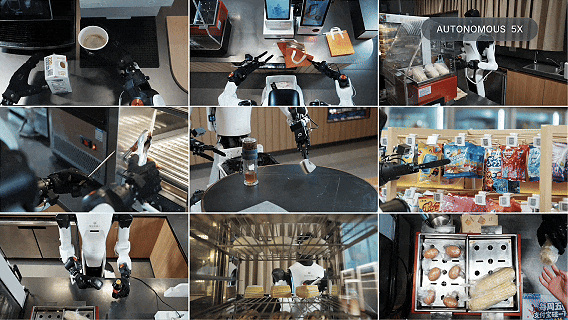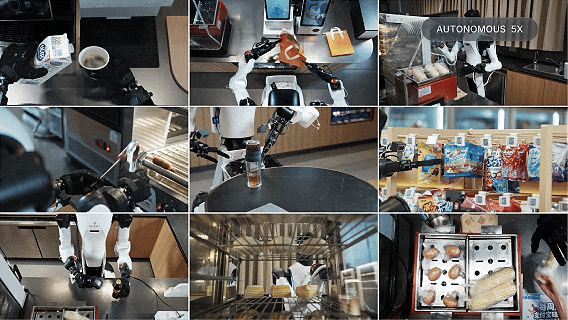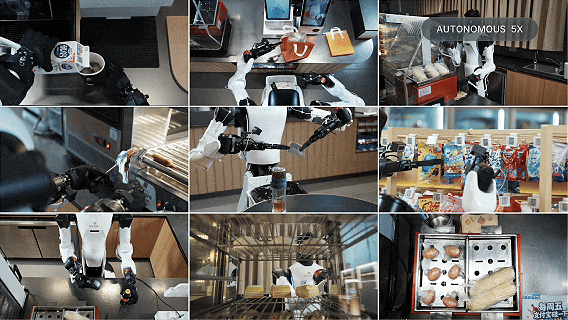
凭借Genie Master的动力,该机器人能够识别任务失败的原因,调整其策略,并在执行操作任务时积累经验.
根据智元机器人的说法,机器人在多个复杂任务中继续改进,需要精确的操纵,而不依赖于人类的示范或手动调节.
该公司将这项演示描述为没有人在循环中进行自主改进的例子,
智元机器人还将此描述为实业环境中的物理RSI (物理世界回复自我改善) 的示范,将自我改善的概念扩展到模拟和实验室设置之外.
这种方法的意义在于将现实执行与持续学习联系起来.而不是将部署视为模型开发的最后阶段,Genie Master使操作经验成为持续改进的资源.
从GO-1到GO-3:在整个学习生命周期中扩展规模化
从 GO-1 引入的 ViLLA 框架到 GO-2 开创的行动链思想方法,智元机器人 继续扩大其具身智能 模型的功能.
GO-3预览是这一发展的下一步,扩展了扩展到预训练之外,包括后训练和部署后学习.
它在RoboDojo,RoboTwin和RoboColiseum上排名第一,以及任务转移,复杂操纵和适应现实世界的示范,突出了这种全生命周期方法的潜力.
而不是依赖于单一阶段的改进,GO-3预览,Genie Evolver和Genie Master将三个基本过程连接起来:通过预训练开发通用能力,通过物理和虚拟互动完善行动策略,并将现实运营经验转化为持续学习.
由于数据,反和经验形成了持续的循环,系统旨在帮助机器人随着时间的推移扩大其能力.
对于智元机器人来说,整个生命周期的扩展意味着从获得技能到应用,再利用和改进的道路,使机器人能够将所学到的知识转化为实际的成绩,并将现实世界中的每项任务转化为提高能力的机会.
为了了解更多信息,请访问智元机器人.com,并关注智元机器人在:
关于智元机器人
智元机器人是全球一般用途人工智能机器人行业的先驱,其核心技术侧重于具身智能.智元机器人s One架构中的三种智能集成了移动智能,互动智能和操纵智能在一个统一的体现系统中.
在2026年9月,智元机器人宣布其第20000台机器人已经从生产线上推出.
主要图片:GO-3预览从人类的第一人视频和机器人轨迹中学习,将对象互动和任务执行与行动和物理结果联系起来.