开源模型的第一梯队几乎已经被 MoE 占据,但从 Dense 转向 MoE,远不只是把 FFN 替换成多个 Expert。Router、负载均衡、跨 GPU 的 All-to-All 通信,都会给训练引入新的工程问题。
Hugging Face 这份 The Ultimate MoE Training Handbook,前两章从一次真实训练出发,依次介绍如何检查 GPU 和集群通信性能、构建训练镜像、准备 Tokenization 数据,再使用相同的数据和训练配置,跑通 Dense 基线与第一个 MoE 模型。
其中一个很实用的设计是先建立 Dense 参考基线,再引入 Expert。文中给出了一个总参数量为 6.86B、每个 token 激活约 1.22B 参数的 MoE 实例,并通过对照实验检查架构切换后 Loss、梯度和训练行为的变化。这样做的意义在于,能够尽可能排除数据和训练配置带来的干扰,将问题定位到 MoE 本身新增的机制与开销。
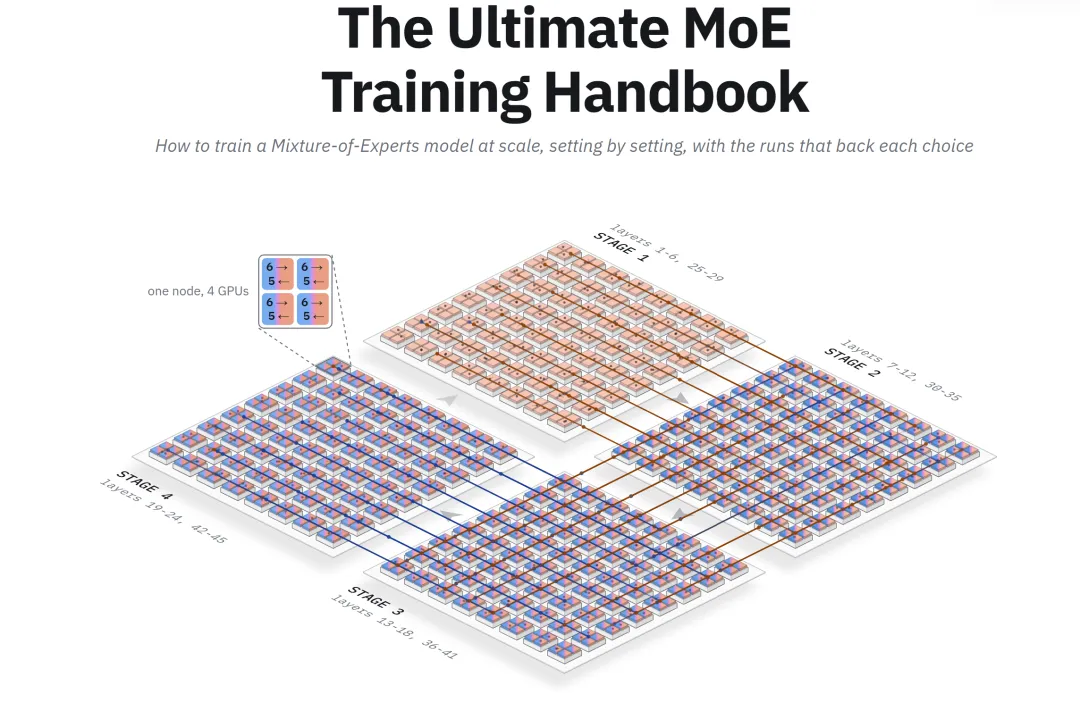
如何从零开始训练大规模 Mixture-of-Experts 模型:逐项解析训练配置,并通过实际训练实验验证每一项选择
1. 引言(Introduction)
前沿模型正在走向稀疏化。
阅读本文预计需要 1~2 天。为了获得最佳阅读体验,我们建议不要使用手机阅读。
在 Artificial Analysis 的开源权重模型排行榜中,得分最高的 20 个模型里,有 18 个采用了 Mixture-of-Experts(MoE)架构。仅有两个例外:排名第十二的 Nanbeige4.3-33B 和排名第十三的 Qwen3.8 27B,它们采用的是 Dense 架构。
这些模型还包括五家领先实验室各自排名最高的模型:DeepSeek V4.1 Flash 1017、GLM-5.3、MiMo-V2.6-Pro、Ling 3.1 Flash 1019 和 MiniMax-M3.1-Flash。
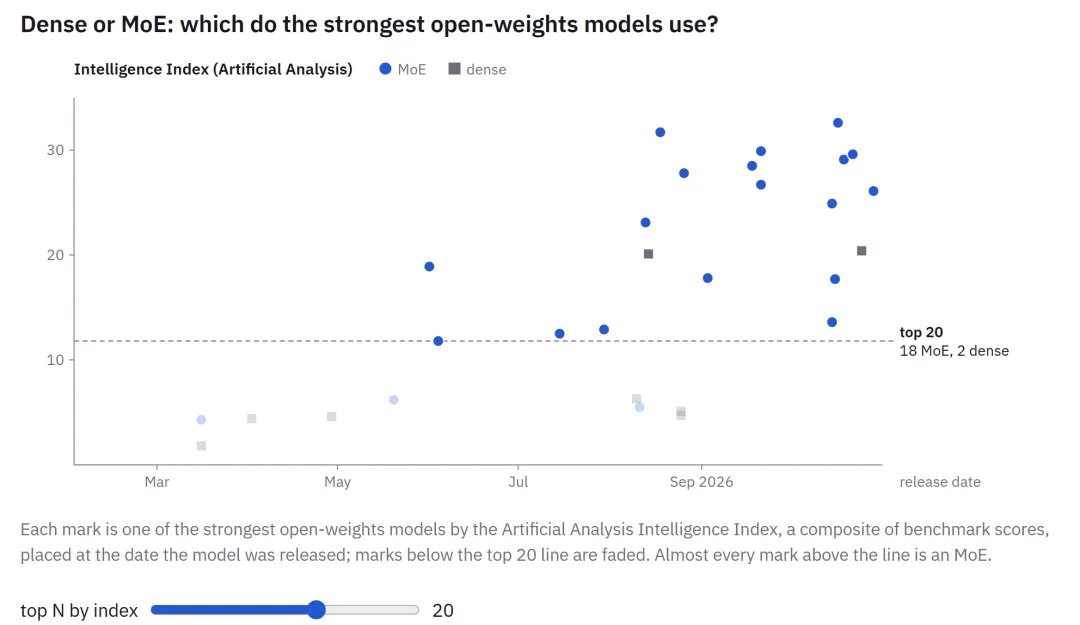
图 1.1
MoE 的优势在于它如何分配推理计算量(Inference Compute)。每个 token 只需要经过少数几个 Expert,因此模型可以容纳远多于单个 token 实际使用的参数量。
例如,在第二章中,你将训练一个小型 MoE 模型。它总共有 6.86B 参数,但每个 token 实际激活的参数只有 1.22B。
真正困难的地方在于:如何将推理阶段节省下来的计算量,转化为训练速度的提升。
我们此前发布过一篇关于模型训练的深度指南——Smol Training Playbook,主要介绍 Dense 模型的训练,但只涉及了 MoE 设计的一部分内容。
由于那本手册的核心模型 SmolLM3 是一个 Dense Transformer,其训练过程并不需要 MoE 特有的技术,例如 Expert Parallelism。
不过,我们仍然在手册的「Going Sparse: MoE」章节中简要介绍了 MoE,涵盖了一些高层次的架构设计选择,包括稀疏性(Sparsity)、粒度(Granularity)、共享 Expert(Shared Experts)和负载均衡(Load Balancing)。
该章节也指出了分布式 MoE 训练复杂性的主要来源:Expert 放置、负载均衡以及 All-to-All 通信,但并没有深入讨论其中的具体实现细节。
本手册将从这份问题清单出发,逐一展开。
从 Dense 模型转向 MoE,你需要应对三个新的挑战:
Router(路由器): 决定每个 token 应该使用哪些 Expert。
负载均衡: 确保不同 Expert 之间的负载保持均衡。
跨 GPU Token 交换: 当 Expert 被分配到不同 GPU 上时,每一层 MoE 都需要在这些 GPU 之间进行 token 交换。
每个方面都会引入 Dense 模型训练中从未出现过的新配置,以及全新的训练失败方式。
接下来的章节将逐一分析这些配置,深入讨论其具体细节,并提供可以直接运行的代码。在大多数情况下,我们还会给出来自自身集群实验的直接结果和数据。
一次失败的训练运行,通常只会告诉你出现了什么症状,却不会直接告诉你背后的原因。
下面这张图提供了一份高层次的故障排查指南,帮助你追溯问题根源:首先观察训练运行出现了什么故障,然后找到最早出现的异常信号(也就是煤矿里的金丝雀,Canary in the Coal Mine),最后阅读本文中解释潜在原因的对应部分。
当训练运行出现问题时,你可以随时参考这张图。
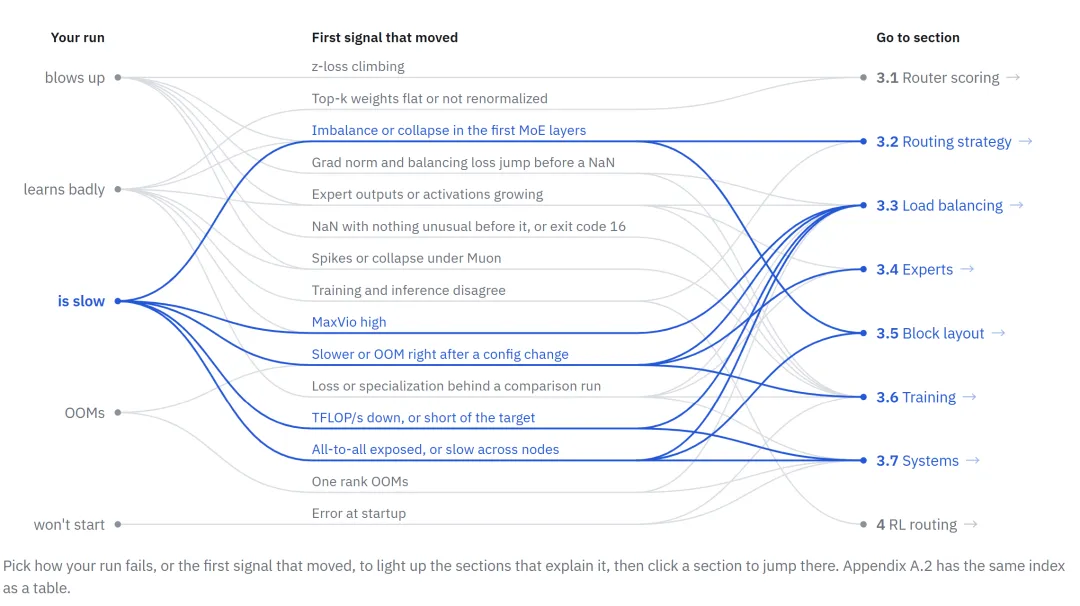
图 1.2
在正式开始之前,我们先简单说明一下本手册面向的读者。
这本手册适合谁?
如果你已经在 GPU 集群上训练过 Dense 模型,并且希望接下来训练一个 MoE,那么这本手册会对你很有帮助。
第二章将介绍所需的环境配置,并带你在单个节点上完成一个小型 MoE 模型的训练。
如果你更关心 MoE 的工作原理,以及当前前沿模型采用了哪些设计,而不是实际运行一个 MoE,那么可以直接跳到第三章:Anatomy of MoE Training。
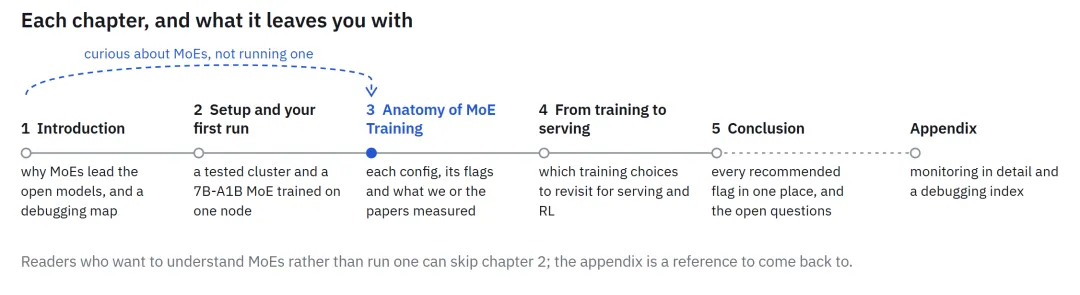
图 1.3
当 Expert 被分配到不同 GPU 上之后,每一层 MoE 都需要在 GPU 之间交换 token。这是我们此前训练 Dense 模型时从未使用过的通信模式。
那么,在你修改模型中的任何一行代码之前,是否能够确信集群中的 GPU 互联链路可以可靠地支持这种通信模式?
2. 环境配置与首次训练(Setup and your first run)
2.0 所需环境(What you need)
本章中的所有命令都针对一种统一的机器环境编写,以确保每个人运行的环境一致:一个由八卡节点组成的 Slurm 集群。
本节将介绍这一环境配置、如何使用一张 GPU 甚至完全不使用 GPU 阅读本文,以及如何通过 Hugging Face Jobs 租用一个八卡节点。如果你的机器配置有所不同,仍然可以参考其中的解释,并根据实际情况调整命令。
命令所假设的集群环境
这些命令要求使用一个 Slurm 集群,其中每个 GPU 节点配备八张 GPU。容器通过 Enroot 和 Pyxis 启动,它们允许 srun 在指定镜像内部启动任务。
2.1 节中的节点就绪检查使用 NVIDIA 的 DCGM diagnostics(DCGM 诊断工具)。我们的实验运行在通过 Elastic Fabric Adapter(EFA)互联的 AWS P5 节点上,每个节点配备八张 80 GB 的 H100 GPU。
本章的大部分内容都可以在单个节点上完成。Dense 基线模型和第一个 MoE 模型都只需要申请一个配备八张约 80 GB GPU 的节点。
只有网络检查需要更多节点:2.1 节中的 All-to-All 测试分别在两个、四个和八个节点上运行;2.2 节中的 EFA 镜像则在两个节点上完成验证。
软件环境来自两个固定版本的代码源。
第一个是 NGC PyTorch 镜像 26.06-py3。我们会在 2.2 节中导入该镜像,并在此基础上扩展集群所需的网络库。
第二个是固定在 commit d6316eb45 的 Megatron 代码仓库。我们不会将它直接构建到容器镜像中,而是在运行时将其挂载进去。
此外,你还需要一个能够同时被 CPU worker 和 GPU 节点读取的文件系统,因为 2.3 节会在 CPU 分区上对数据进行 tokenization,而训练任务需要从该文件系统中读取处理后的数据。
使用一张 GPU,甚至不使用 GPU 阅读
即使没有集群,你仍然可以阅读本文的大部分内容。
第三章将拆解 MoE Layer 的各个组成部分:每个部分的作用是什么、前沿模型如何选择,以及支撑这些选择的证据是什么。你可以从头到尾阅读这一章,而不需要运行任何代码;等拥有相应硬件后,再使用其中的配置参数。
第四章则会进一步讨论这些设计选择如何延伸到预训练之后,包括模型 Serving 和 RL。
在本章中,2.3 节的 tokenization 在 CPU 上运行。它提供了一个可以在单台机器上运行、无需 Slurm 的小型示例,因此你可以生成并检查与训练任务读取的相同格式的数据文件。
2.4 节和 2.5 节的训练方案则假设你拥有八张约 80 GB 的 GPU,MoE 模型会将其 Expert 分布到全部八张 GPU 上。
如果你的 GPU 数量更少,可以将这两节作为方法参考,重点理解两次运行中哪些配置保持不变、Expert 的宽度如何选择,以及应该比较哪些指标。
2.1 节的 All-to-All 测试和 2.2 节的 EFA 环境配置,则需要多个节点才能按照文中的方式运行。
在 Hugging Face Jobs 上租用节点
如果你希望运行单节点实验,但自己没有相应硬件,可以使用 Hugging Face Jobs。
它可以在 Hugging Face 的机器上运行 Docker 镜像和指定命令,并按照分钟计费。
任何拥有正数 Credit Balance 的个人用户或组织都可以使用该服务。PRO、Team 或 Enterprise 订阅所提供的月度额度也可以用于支付 Jobs 任务。
hf jobs hardware 列出的最大硬件配置包含八张 GPU,正好满足 2.4 节和 2.5 节的需求。例如,h200x8 配备八张 141 GB 的 H200 GPU。
一个 Job 由 Docker 镜像、执行命令和硬件配置共同定义。镜像可以来自 Docker Hub 或 Hugging Face Space。
因此,要在 Jobs 上运行本章的实验,需要将 2.2 节构建的镜像打包为 Docker 镜像,并将 Slurm 启动器替换为 Jobs 命令。
如果不设置其他超时时间,Job 会在运行 30 分钟后停止。
首先,可以运行下面的命令,检查 Job 是否能够识别全部八张 GPU:
hf jobs run --flavor h200x8 --timeout 10m \
    pytorch/pytorch:2.6.0-cuda12.4-cudnn9-devel \
    python -c "import torch; print(torch.cuda.device_count())"
无论你是在自己的集群上运行训练方案,还是租用节点,实际获得的机器性能都不一定符合硬件规格所标注的水平。
那么,应该如何发现某张 GPU 或某条通信链路正在悄悄地低于预期性能?
2.1 测试硬件(Test your hardware)
在开始调整模型之前,首先需要确定机器实际能够提供怎样的性能。
使用 Megatron 的 alltoall dispatcher 时,每个 MoE Layer 都会将 token 发送到持有对应 Expert 的 GPU 上,然后再通过另一次 All-to-All 通信将计算结果传回来。
因此,GPU 之间的互联链路本身也是需要测试的对象。即使 All-Reduce 测试结果正常,也不能说明这些 token 交换能够以多快的速度完成。
在启动训练之前,应当在已经分配的 Job 资源中运行下面的检查。
通过 Pyxis,srun --container-image 可以启动容器。下一节将介绍如何准备训练镜像。
检查每个节点
首先,对每个已分配的节点执行就绪检查。
NVIDIA 的 DCGM 提供多个级别的诊断功能。其中,Level 1 专门用于就绪检查;更高级别则会增加更多测试,以帮助调查硬件故障。
下面的命令会在每个节点上启动一个任务,以便你在开始训练之前逐一检查各节点的结果。
NNODES=$SLURM_JOB_NUM_NODES
srun --nodes="$NNODES" --ntasks="$NNODES" --ntasks-per-node=1 \
    dcgmi diag -r 1 --fail-early
如果所有节点都通过检查,就可以继续进行通信测试。
如果某个节点未通过检查,应当保留其诊断输出,并在继续之前调查问题。
例如,在我们的一次实验中,Level 2 诊断发现某个节点上的三张 GPU 存在温度违规,同时 PCIe 和显存测试也未通过。
更耗时的诊断应当安排在单独的维护窗口中执行。
NVIDIA 将 Level 3 和 Level 4 定义为管理员使用的事后诊断测试,而 Level 1 则用于就绪检查。
准备诊断镜像
如果你的集群已经提供 nccl-tests 镜像,可以直接将 NCCL_TESTS_IMAGE 设置为对应路径。
否则,如果你使用的是带有 EFA 的 AWS 集群,可以导入 AWS NCCL 测试方案维护的公开镜像。
选择一个所有已分配节点都可以访问的文件系统路径:
NCCL_TESTS_IMAGE=/shared/images/nccl-tests.sqsh
mkdir -p "$(dirname "$NCCL_TESTS_IMAGE")"
enroot import -o "$NCCL_TESTS_IMAGE" \
    'docker://public.ecr.aws#hpc-cloud/nccl-tests:latest'
应当将导入后的 SquashFS 文件与基线测试结果一起保存,因为再次导入 latest 标签时,可能会得到不同的镜像版本。
如果希望确保导入过程可复现,应当从 AWS 测试方案中选择一个带有明确版本号的 Tag,而不是使用 latest。
AWS 测试方案还提供了 Dockerfile,可以在需要时自行构建镜像。
如果使用其他网络互联架构,则应当采用该集群支持的 CUDA、NCCL、MPI 和网络插件组合。
NVIDIA 的 nccl-tests 构建说明介绍了如何选择这些库的路径。
多节点测试要求使用启用了 MPI=1 的构建版本。下面的 Benchmark 假设 MPI 可以通过 Slurm 的 PMIx 集成启动,因此需要确保镜像中的 MPI 配置与你的集群环境相匹配。
测量实际使用的 Collective 通信性能
所有节点通过检查后,就可以测量整个资源分配范围内的 All-to-All 带宽。
下面的命令会为每张 GPU 启动一个 Rank,并在每个 Rank 之间交换一个 8 GiB 的 Buffer,与我们基线测试所使用的大消息量配置保持一致。
使用前面准备好的 NCCL_TESTS_IMAGE 路径。如果镜像中的 nccl-tests 安装在其他位置,则需要相应调整可执行文件路径。
srun --nodes="$NNODES" --ntasks="$((8 * NNODES))" \
    --ntasks-per-node=8 --gres=gpu:8 --mpi=pmix --cpu-bind=none \
    --container-image="$NCCL_TESTS_IMAGE" --no-container-mount-home \
    /opt/nccl-tests/build/alltoall_perf \
    -b 8G -e 8G -g 1 -c 1 -n 20
首先检查 Rank 列表,再分析测试结果。
例如,一个由两个八卡节点组成的资源分配,应该列出 16 个 Rank。
随后检查对应测试规模下的 busbw 和 #wrong 两列。
下面是我们两节点基线测试中的 Out-of-place 结果,其他列已省略:
size (B)      busbw (GB/s)    #wrong
8589934592    77.14           0
#wrong 为 0,表示该次测试通过了正确性检查。
带宽数值则为后续测试提供了参考基线。后续测试应当保持相同的节点数量、每节点 GPU 数量和测试参数,以便进行比较。
同时,应当记录参与测试的节点列表,这样之后如果出现性能下降,就可以追溯到具体涉及的机器。
在另一次独立的两节点资源分配中,我们设置了 NCCL 调优环境变量,测试得到的相同消息规模下的带宽为 39.84 GB/s。因此,应当记录每次测试使用的节点和配置。
All-Reduce 仍然是有价值的对照指标,但在相同机器上,两种 Collective 通信的表现可能存在很大差异。
在上述较慢的两节点测试中,All-Reduce 带宽达到了 398.52 GB/s,而 All-to-All 只有 39.84 GB/s。
对于需要跨节点交换 token 的 MoE 模型而言,第二个指标才是真正能够检验相关通信模式的指标。
为不同规模的资源分配建立baseline
随着节点数量增加,All-to-All 交换中需要跨节点网络传输的数据比例也会增加。
我们的多节点测试说明了为什么必须根据节点数量分别建立基线:
两个节点:77.14 GB/s
四个节点:39.25 GB/s
八个节点:30.91 GB/s
比较不同资源分配的性能时,应当使用对应节点数量下的基线,并确保消息规模和结果列保持一致。
在确定参考基线之前,应当在已知运行正常的配置上重复测试,同时固定硬件、软件和测试参数。
根据得到的性能范围,判断新的资源分配是否满足训练要求。
一个实用的初始策略是:要求带宽至少达到基线的 90%,同时通过正确性检查。
例如,对于上面的两节点测试结果,带宽阈值应当设定在约 69 GB/s。
具体阈值应当根据集群实际观测到的性能波动进行调整。
例如,如果统一采用 33 GB/s 的固定阈值,那么前面性能较差的两节点测试就会被接受,而八节点测试结果反而会被拒绝。
在调查性能较差的资源分配时,应当保持基线不变。
如果还希望尝试 NCCL 调优环境变量,则应当在相同节点上、使用相同测试参数比较不同配置。
我们此前的默认配置和调优配置使用了不同的节点组合,因此,两者之间的带宽差异无法用于判断这些环境变量究竟产生了什么影响。
检查训练期间的性能变化
如果希望在训练期间定期检查硬件状态,可以使用 Megatron 提供的参数:
--gpu-sniff-test-interval <n>
该参数会在训练开始前执行一次检查,之后每隔 n 次迭代再次执行。
检查内容包括 Expert Parallelism Group 内部的一次 All-to-All 通信。
如果出现性能下降,系统会通过 Outlier Warning 标记需要进一步调查的 Rank。
前面的诊断镜像已经帮助我们测试了 GPU 及其互联链路。
接下来,需要确保训练镜像也能够访问相同的硬件,因此我们来准备训练镜像,并检查其中的网络库。
2.2 构建镜像(Build your image)
训练环境有两个部分需要正确配置:一是执行 GPU 计算的库,二是负责连接不同节点 GPU 的网络库。
我们首先使用 NVIDIA PyTorch 容器配置第一部分,然后添加集群所需的网络支持。
将 Megatron 保留在独立的代码仓库中,可以让你在保持镜像不变的情况下修改训练代码。
这里的示例使用 Slurm、Enroot 和 Pyxis。
基础镜像为 NGC PyTorch 26.06-py3;网络相关的配置则针对我们使用的带有 EFA 的 AWS P5 节点。
如果你使用的是其他集群,应当为网络部分采用该集群支持的网络协议栈。
导入基础镜像
Enroot 会将容器镜像导入为 SquashFS 文件,之后 Pyxis 就可以通过 srun 启动该镜像。
选择一个计算节点都可以访问的输出路径,然后导入基础镜像:
IMAGE=/path/to/images/pytorch-26.06.sqsh
enroot import -o "$IMAGE" docker://nvcr.io#nvidia/pytorch:26.06-py3
将 Megatron 代码仓库保留在镜像之外,并在启动训练时将其挂载到容器中。
本文中的配置参数针对 commit d6316eb45。显式切换到这一版本,可以确保你阅读的代码与实际运行的代码保持一致。
源码说明中列出了每项测量所使用的镜像版本和代码 Commit。
将该代码仓库,以及后续生成的数据和 Tokenizer,放在 CPU worker 和 GPU 节点都可以读取的文件系统中。
在下面的命令中,SHARED_ROOT 表示这一共享目录,PROJECT_DIR 表示项目目录。配套脚本会被克隆到项目目录下的 scripts/ 文件夹中。
export SHARED_ROOT=/path/to/shared/work
export PROJECT_DIR="$SHARED_ROOT/moe-blogpost"
git clone  "$PROJECT_DIR/scripts"
git clone  "$SHARED_ROOT/Megatron-LM"
cd "$SHARED_ROOT/Megatron-LM"
git checkout d6316eb45bf1bfbb6f1f848c0b56e55166564d80
验证 GPU 访问
在添加集群网络库之前,首先检查基础镜像能否成功导入 PyTorch 和 Transformer Engine,并能否识别 GPU。
在一个已经分配了八张 GPU 的节点上运行下面的命令,使用前面设置的 IMAGE 路径:
srun --nodes=1 --ntasks=1 --gres=gpu:8 \
    --container-image="$IMAGE" --no-container-mount-home \
    python -c '
import torch, transformer_engine
print("torch", torch.__version__)
print("transformer_engine", transformer_engine.__version__)
print("device_count", torch.cuda.device_count())
x = torch.randn(8).cuda().sum()
print("cuda sum ok", x.item())
'
原始镜像报告了以下版本和设备数量。
命令的最后一行还会输出一个在 GPU 上计算得到的求和结果,因此在继续之前,需要同时检查库导入是否正常以及这一计算结果。
torch 2.13.0a0+8145d630e8.nv26.06
transformer_engine 2.16.0+4220403e
device_count 8
CUDA 计算结果用于检查当前节点内部的 GPU 执行是否正常。
如果需要通过 EFA 在不同节点之间进行通信,则还需要添加下面介绍的网络插件及其依赖。
添加 EFA 支持
在我们的 AWS 节点上,网络层由 EFA 用户态库和 aws-ofi-nccl 插件组成。该插件需要针对镜像内部的 NCCL 进行构建。
本次构建使用的版本为:
EFA Installer:
1.49.0aws-ofi-nccl:v1.19.2
应当将这两个版本与基础镜像版本一起记录在构建配置中。
EFA 镜像构建脚本 会从基础镜像创建一个可写的 Enroot 容器,使用 --skip-kmod 安装 EFA 用户态库,并针对镜像中的 NCCL 编译网络插件。
随后,它会导出一个新的 SquashFS 镜像,并删除临时容器。
在一个已经分配、具备 Enroot 和 GPU 访问权限的计算节点上运行该脚本,并指定一个新的输出路径:
EFA_IMAGE=/path/to/images/pytorch-26.06-efa.sqsh
bash "$PROJECT_DIR/scripts/build_efa_image.sh" "$IMAGE" "$EFA_IMAGE"
后续启动训练时,将 EFA_IMAGE 用作 --container-image 的路径。
该脚本负责准备网络层。还需要将下面的环境变量配置与该镜像一起使用,以确保 Job 能够找到并选择正确的网络库。
这里的库路径指向容器内部安装的库副本,而 NCCL_NET_PLUGIN=ofi 则通过名称选择对应插件。
在我们的环境中,如果将文件系统路径直接作为插件值传入,NCCL 会构造出一个无效的库名称。
export LD_LIBRARY_PATH=/opt/amazon/ofi-nccl/lib:/opt/amazon/efa/lib:${LD_LIBRARY_PATH:-}
export NCCL_NET_PLUGIN=ofi
export FI_PROVIDER=efa
export FI_EFA_USE_DEVICE_RDMA=1
export NCCL_SOCKET_IFNAME='^lo,docker0,veth_def_agent'
export NCCL_DEBUG=INFO
Socket 接口排除配置针对的是 NCCL 建立通信时使用的初始连接。
在我们的节点上,NCCL 选择了 veth_def_agent,并尝试连接其 Link-local 地址,最终出现 Connection refused 错误。
排除该接口后,训练任务便能够正常启动。
如果要在其他集群中复用这一配置,需要根据实际网络接口调整排除列表。
验证网络路径
首次启动多节点训练任务时,应当检查 NCCL 初始化日志,然后再分析训练性能。
这一步用于验证训练镜像本身所使用的网络路径。
对于本文介绍的 EFA 镜像,需要重点查找下面这行日志:
NCCL INFO Using network Libfabric
如果看到的是 Using network Socket,则需要检查其上方紧邻的插件加载日志。
插件名称无效或缺少对应版本的库,都可能导致 NCCL 回退到 Socket 通信。
例如,EFA_1.4 错误表明缺少相应版本的库,需要先解决这一问题再重新尝试。
日志能够确认 Job 最终选择了哪种传输方式,但实际带宽仍然需要单独测量。
应当将训练镜像和网络配置与 2.1 节中的诊断结果一起记录,并明确区分这两个测试环境,以便比较它们的性能。
硬件检查和镜像准备完成后,就可以开始第一次训练了。
整个过程从数据开始:将原始文本转换为 token 序列,并按照 Megatron 所要求的格式进行存储。
2.3 Tokenization(数据 Tokenization)
Megatron 从成对的索引文件中读取训练文本。.bin 文件存储 token ID,而 .idx 文件则记录每个序列的起始位置和结束位置。
提前准备好这些文件,可以让 Dense 和 MoE 两次训练运行读取完全相同的 token,从而确保模型架构发生变化时,训练数据不会同时发生变化。
我们将使用 FineWeb-Edu 数据集和 Llama 3.2 Tokenizer。Datatrove 的 MegatronDocumentTokenizer 可以直接写出 Megatron 所需的文件格式。剩下的工作就是选择输出目录、检查一小部分样本,然后提交完整的 Tokenization 任务。
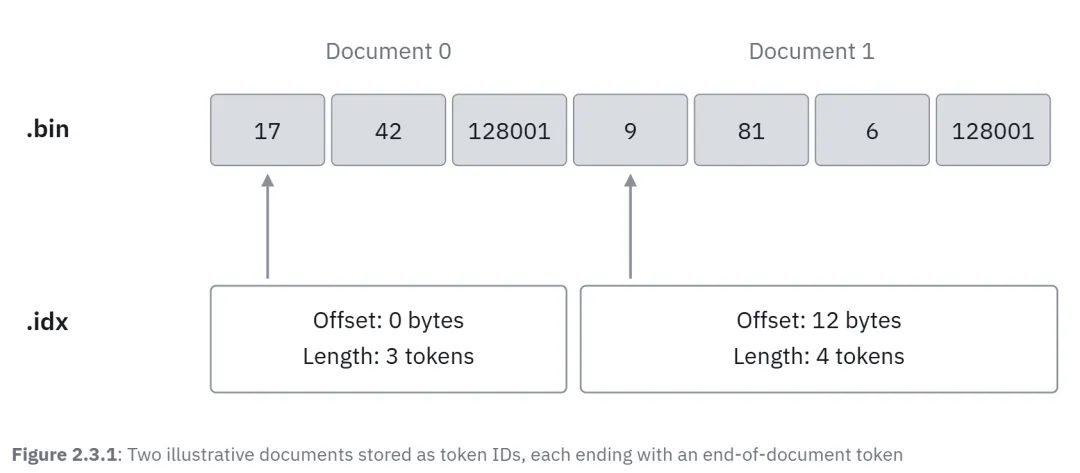
图 2.3.1: 两个示例文档以 token ID 的形式存储,每个文档都以一个文档结束 token 结尾。
准备 Tokenizer
将数据和 Tokenizer 保存在 SHARED_ROOT 下,也就是 2.2 节中配置的共享目录。
Tokenization 脚本会先在本地运行一个小型样本,然后为完整任务提交一个 Slurm Array Job。
export TOKENIZER_DIR="$SHARED_ROOT/tokenizer"
python3.11 -m venv "$SHARED_ROOT/tokenize-venv"
source "$SHARED_ROOT/tokenize-venv/bin/activate"
python -m pip install \
    'datatrove @ git+ \
    pyarrow tokenizers huggingface_hub
原始 Tokenizer 仓库 meta-llama/Llama-3.2-1B 需要经过访问权限审批。
如果你的账户已经获得访问权限,可以运行 hf auth login,然后在下载命令中使用该仓库。
否则,可以使用无需访问授权的副本 unsloth/Llama-3.2-1B。我们的对比结果显示,两者具有相同的词表和 token ID。
无论采用哪一个版本,Tokenization 和训练阶段都会读取同一份已下载的 Tokenizer 文件。
TOKENIZER_REPO=unsloth/Llama-3.2-1B
hf download "$TOKENIZER_REPO" \
    --include 'tokenizer*' --include 'special_tokens_map.json' --include 'config.json' \
    --local-dir "$TOKENIZER_DIR"
Datatrove 会从该目录读取 tokenizer.json,并在每个文档末尾追加 <|end_of_text|>。
随后,Megatron 通过 --tokenizer-model 接收该目录,同时也会读取其中的 Tokenizer 配置。
检查一个小型数据分片
在提交完整任务之前,先在 CPU 计算节点上对一个小型样本进行 Tokenization。
下面的命令最多读取 1,000 个文档,并保留全部文档。输出会写入一个独立目录,避免将该样本误认为正式训练语料。
python "$PROJECT_DIR/scripts/tokenize_first_run.py" \
    --tokenizer "$TOKENIZER_DIR/tokenizer.json" \
    --output "$SHARED_ROOT/data-smoke" --limit 1000
输出文件的前缀为 fineweb-edu_00000_tokens。
接下来,使用 2.2 节准备的训练镜像,通过 Megatron 自带的读取器检查该文件。需要申请一个能够通过 Pyxis 启动容器的资源分配。
首先停用 Tokenization 环境,避免其中的 Python 环境覆盖镜像自带的解释器。
如果使用 EFA 环境,将 TRAIN_IMAGE 设置为 EFA_IMAGE;如果使用其他集群,则设置为已经准备好的训练镜像。
deactivate
export TRAIN_IMAGE="$EFA_IMAGE"
export MEGATRON_PATH="$SHARED_ROOT/Megatron-LM"
srun --nodes=1 --ntasks=1 \
    --container-image="$TRAIN_IMAGE" \
    --container-mounts="$SHARED_ROOT:$SHARED_ROOT" \
    --container-workdir="$MEGATRON_PATH" --no-container-mount-home \
    env PYTHONPATH="$MEGATRON_PATH" python -c '
import sys
from megatron.core.datasets.indexed_dataset import IndexedDataset
data = IndexedDataset(sys.argv[1])
assert len(data) > 0
print("sequences", len(data))
for i in range(min(3, len(data))):
    tokens = data[i]
    assert len(tokens) and tokens[-1] == 128001
    print("length", len(tokens), "last token", int(tokens[-1]))
' "$SHARED_ROOT/data-smoke/fineweb-edu_00000_tokens"
你应该看到一个非零的序列数量,并且每个被检查序列的最后一个 token 都是 128001。
这个末尾 token 就是我们要求 Tokenizer 追加的文档边界标记。
通过 Megatron 读取该数据分片,还可以验证 Megatron 能否正确解析索引文件,并在 GPU 训练开始之前读取 token 文件中的前几个序列。
提交 Tokenization 任务
小型样本检查的是文件格式,而完整任务则负责准备一份可以随着训练实验扩展而重复使用的语料。
在登录节点上提交任务,并保持相同的虚拟环境处于激活状态。
将 CPU_PARTITION 设置为集群的 CPU 分区;如果调度器要求,还需要添加 --qos。
该脚本为每个任务申请 12 个 CPU 和 24 GB 内存,并且要求这些 worker 能够通过相同路径访问虚拟环境。
source "$SHARED_ROOT/tokenize-venv/bin/activate"
export OUT_DIR="$SHARED_ROOT/data/fineweb-edu"
CPU_PARTITION=your_cpu_partition
python "$PROJECT_DIR/scripts/tokenize_first_run.py" \
    --tokenizer "$TOKENIZER_DIR/tokenizer.json" --output "$OUT_DIR" \
    --tasks 100 --limit -1 --sample-rate 0.074 --partition "$CPU_PARTITION"
Datatrove 会输出已提交任务的 Job ID。
使用该 ID 通过 squeue -j <job-id> 跟踪 Array Job 的执行情况,并检查 $OUT_DIR/logs 下失败任务的日志,然后再重新提交相同命令。
每个任务都会读取一部分输入文件,并在 Tokenization 之前随机保留其中 7.4% 的文档。
由于不同文档的长度不同,这个采样比例并不能确定最终输出的 token 数量。
如果需要重新启动中断的任务,应当保持任务数量、采样率和输出目录不变。
Datatrove 会利用日志目录下的完成标记跳过已经执行完毕的任务。
将数据分片传递给 Megatron
等待 Array Job 全部完成之后,再生成训练数据清单(Training Manifest)。
下面的检查会验证全部 100 个任务的完成标记以及预期的数据分片文件是否存在,然后将各个数据分片的前缀写入 data-args.txt,每行一个。
每个前缀同时对应 .bin 和 .idx 两个文件,因此 Manifest 中不应该单独包含 .bin 或 .idx 后缀。
export DATA_ARGS="$OUT_DIR/data-args.txt"
python - <<'PY'
import os
from pathlib import Path
root = Path(os.environ["OUT_DIR"])
prefixes = [root / f"fineweb-edu_{rank:05d}_tokens" for rank in range(100)]
for rank, prefix in enumerate(prefixes):
    assert (root / "logs/completions" / f"{rank:05d}").is_file(), rank
    for suffix in (".bin", ".idx"):
        path = Path(str(prefix) + suffix)
        assert path.is_file() and path.stat().st_size > 0, path
Path(os.environ["DATA_ARGS"]).write_text("\n".join(map(str, prefixes)) + "\n")
print(f"wrote {len(prefixes)} prefixes")
PY
deactivate
训练时将通过 --data-args-path 读取这个文件。
该参数提供的数据列表与 --data-path 相同,但可以避免在启动命令中直接写入大量数据分片路径。
启动脚本还会通过 --data-cache-path 指定一个持久化目录,用于存储 Megatron 的样本索引。这样,后续使用相同数据集配置的训练任务就可以重复利用这些索引。
在最初的训练实验中,我们使用 --split 100,0,0,将全部数据分配给训练集。
在使用训练结果比较模型质量之前,应当预留一个独立的 Held-out 数据集。
现在,我们已经拥有可以正常读取的数据集,以及指向各个数据分片的 Manifest,可以启动 Dense 基线模型了。
在引入 Expert 之前,先通过它的 Loss、梯度范数和 Step Time 建立参考基线。
2.4 Dense 基线模型(Dense baseline)
当 MoE 模型出现意外情况时,Dense 模型可以提供一个具体的对照对象。
两个模型将使用相同的数据、Batch Size 和优化器,因此,当 Loss 出现突增或者某个训练 Step 变慢时,我们可以首先与更简单的 Dense 模型进行比较。
这一基线实验还可以在引入 Router 之前,同时验证训练镜像和 Data Loader 是否能够正常工作。
模型包含 16 个 Transformer Layer,Hidden Size 为 2,048,Feed-Forward Network 的宽度为 8,192。
使用包含 128,256 个 token 的词表,模型总参数量约为 1.22B。
该训练方案面向一个配备八张 GPU、每张 GPU 显存约为 80 GB 的节点。
之后的 MoE 实验也会复用同一个启动脚本。
在单个节点上启动训练
我们将使用 Trackio 记录训练指标。
Trackio 是 Hugging Face 推出的轻量级开源实验跟踪工具。它的 API 与 wandb 类似,因此现有代码通常只需要将 wandb 替换为 trackio 即可。
实验数据会记录到由你自己控制的本地数据库中。你可以通过本地 Dashboard 浏览实验结果,也可以将数据同步到 Hugging Face Space,与团队成员实时分享训练曲线,无需账户或付费订阅。
首先,在共享存储中创建一个 Python 环境。该环境需要在训练镜像内部创建,以继承镜像中的 GPU 库,然后安装固定版本的实验跟踪工具:
srun --nodes=1 --ntasks=1 \
    --container-image="$TRAIN_IMAGE" \
    --container-mounts="$SHARED_ROOT:$SHARED_ROOT" --no-container-mount-home \
    bash -c 'python -m venv --system-site-packages "$1/train-venv" &&
        "$1/train-venv/bin/python" -m pip install "trackio==0.42.0"' _ "$SHARED_ROOT"
export TRACKIO_PROJECT=moe-first-run
启动脚本使用 Trackio 的入口,将 Megatron 的标量指标发送到每个 Job 对应的独立实验运行记录中。
两个实验运行共享上面的 Project,其数据保存在 $SHARED_ROOT/trackio 下。
该适配器使用 Megatron 现有的标量日志记录接口,因此,诸如 --log-memory-to-tensorboard 这样的参数仍然可以控制哪些指标会被发送到 Trackio。
首次训练脚本将训练参数组织为 Bash 数组。
它会使用前面章节准备的训练镜像、固定版本的 Megatron 代码仓库、Tokenizer 目录和数据 Manifest。
确保挂载路径都位于 SHARED_ROOT 下,并将 TRAIN_IMAGE 设置为已经准备好的 SquashFS 镜像。
在共享的 Blog 代码仓库目录下,将 Dense 任务提交到 GPU 分区。
提交任务时,保留 2.3 节中已经导出的环境变量。
脚本会将镜像路径、Megatron Commit 和数据 Manifest 一并记录到输出中。
cd "$PROJECT_DIR"
GPU_PARTITION=your_gpu_partition
sbatch --partition="$GPU_PARTITION" scripts/first_run.sbatch dense
Slurm 会为该任务预留一个八卡节点。
在节点内部,一个 srun 任务会启动 torchrun,后者再为每张 GPU 启动一个训练进程。
运行输出可以在 $SHARED_ROOT/runs/dense-<job-id> 下找到,训练日志则位于提交目录中的 first-run-<job-id>.out。
这次初始训练运行会在 120 次迭代后停止。
在这一环境检查实验中,Checkpoint 保存和 Validation 均被禁用。
进入 MoE 实验之前,应当保留这次运行的日志和 Trackio 数据,它们将作为下一节的参考基线。
如果希望检查训练曲线,可以在能够读取保存目录的机器上安装 trackio==0.42.0,然后启动 Dashboard。
在 Project 中选择 Dense 和 MoE 两次运行,即可对它们进行比较。
TRACKIO_DIR="$SHARED_ROOT/trackio" trackio show --project "$TRACKIO_PROJECT"
理解训练配置
由于 Tensor Parallelism 和 Pipeline Parallelism 都设置为 1,因此每张 GPU 都保存一份完整的 Dense 模型副本。
Data Parallelism 则将 Batch 分配到八张 GPU 上,同时,两个实验都启用了 Distributed Optimizer 和通信重叠。
--tensor-model-parallel-size 1 --pipeline-model-parallel-size 1
--expert-model-parallel-size 1 --context-parallel-size 1
--use-distributed-optimizer --overlap-grad-reduce --overlap-param-gather
--micro-batch-size 8 --global-batch-size 512
每个 Micro-batch 在每张 GPU 上包含 8 个序列。
八张 GPU 合计每个 Micro-batch 处理 64 个序列;经过 8 次梯度累积后,形成 512 的 Global Batch Size。
当序列长度为 4,096 时,每个 Optimizer Step 消耗的 token 数量为 2,097,152。
保持这些数值不变,可以让 Dense 和 MoE 的 Step Time 具有直接可比性。
学习率采用 Warmup、Stable 和 Decay 三阶段调度策略,通过 --lr-decay-style WSD 指定。
学习率首先逐渐升高至 5e-4,随后保持稳定,最后在配置的 Token Budget 接近结束时开始衰减。
这次 120 次迭代的运行会在 Stable 阶段结束;训练停止条件不会缩短学习率调度计划。
完整的 Activation Recomputation 能够让初始配置满足基线实验的显存预算。
在 Micro-batch Size 为 8、使用原生 Cross-Entropy 实现的情况下,如果不启用 Recomputation,Loss 计算阶段就会发生显存溢出。
我们在两个模型中都保留 Recomputation,避免第一次比较时同时引入模型结构变化和显存优化变化。
--recompute-granularity full --recompute-method uniform --recompute-num-layers 1
--cross-entropy-loss-fusion --cross-entropy-fusion-impl native
将 Dense 模型的 Loss、梯度范数和 Step Time 保存在 Trackio 中,作为后续参考基线。
当你将 Feed-Forward Layer 替换为 Expert 后,这些指标将帮助你观察架构变化对训练过程产生的影响。
2.5 首次训练 MoE
Dense 模型对每个 token 都使用相同的 Feed-Forward Network(FFN)。而在 MoE 中,Router 会为每个 token 从 64 个较小的 Expert 中选择 8 个,使模型能够容纳远多于单个 token 实际使用的参数。
我们选择 Expert 的宽度,使得每个 token 选中的 8 个 Expert 所包含的 Feed-Forward 参数量,与它们所替代的 Dense Layer 完全相同。
最终得到一个总参数量为 6.86B、每个 token 激活参数量约为 1.22B 的模型。
额外的模型容量也带来了新的开销:token 必须被发送到选中的 Expert 所在位置,而 Expert 的输出也必须返回给需要它们的进程。
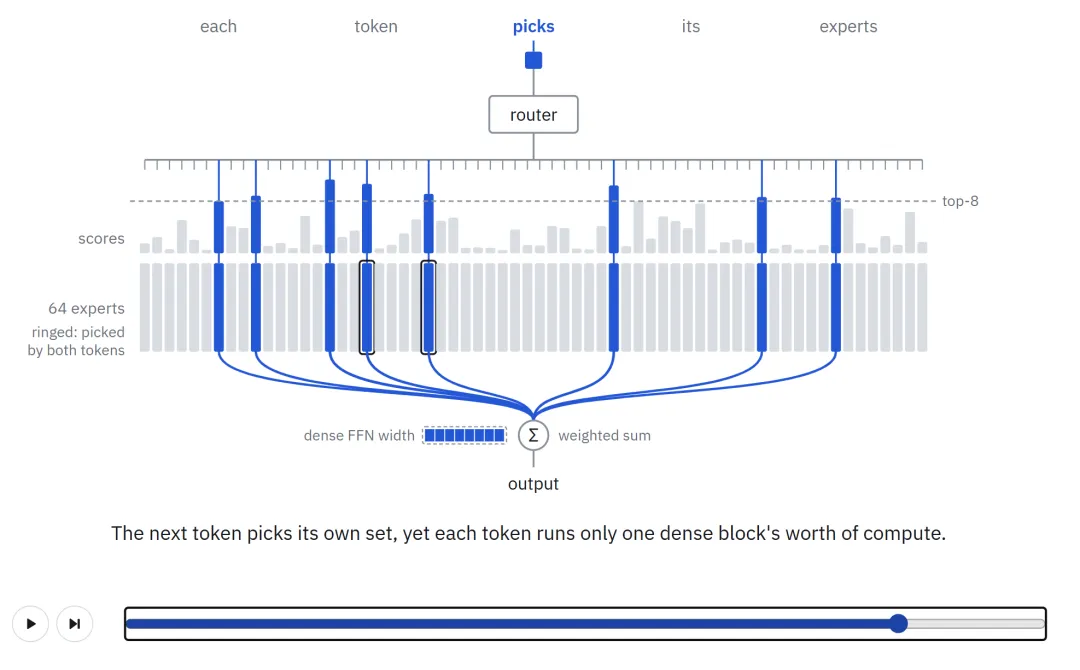
图 2.5.1
替换 Feed-Forward Layer
当启动脚本接收到 moe 参数时,就会选择 MoE 配置。
使用与 Dense 实验相同的环境变量和 GPU 分区提交任务,同时保持镜像、代码仓库、Tokenizer 和数据 Manifest 不变:
sbatch --partition="$GPU_PARTITION" scripts/first_run.sbatch moe
Expert Parallelism 从 1 增加到 8,将 64 个 Expert 分布到节点的八张 GPU 上。
每张 GPU 保存 8 个 Expert,而 Router 则从全部 64 个 Expert 中为每个 token 选择 8 个。
--expert-model-parallel-size 8 --expert-tensor-parallel-size 1
--num-experts 64 --moe-ffn-hidden-size 1024 --moe-router-topk 8
--moe-token-dispatcher-type alltoall --moe-grouped-gemm
--moe-router-load-balancing-type aux_loss --moe-aux-loss-coeff 1e-3
--moe-router-dtype fp32 --moe-per-layer-logging
alltoall 负责在不同 GPU 之间传输经过路由的 token,而 Grouped GEMM 则负责执行本地 Expert 的矩阵乘法。
Auxiliary Loss 鼓励 Router 将计算负载分配到不同 Expert 上,其系数设置为 1e-3。
此外,我们使用 fp32 计算 Router Logits,并启用逐层日志记录(Per-layer Logging)。这些配置和测量结果构成了第三章将要深入分析的初始设置与参考数据。
其他所有配置都保持公共设置不变,包括完整的 Activation Recomputation。
特别需要注意的是,Dense 模型的 --ffn-hidden-size 8192 仍然保留在脚本中,而 --moe-ffn-hidden-size 1024 则用于指定每个 Expert 的宽度。
计算激活参数量与总参数量
一个不带 Bias 的 SwiGLU Expert 包含三个权重矩阵。
当 Hidden Size 为 2,048、Expert Width 为 1,024 时,这三个矩阵的参数总量为:
因此,每个 token 选择 8 个 Expert 时,实际使用的 Feed-Forward 参数量为:
这与被替换的 Dense Layer 参数量完全相同:
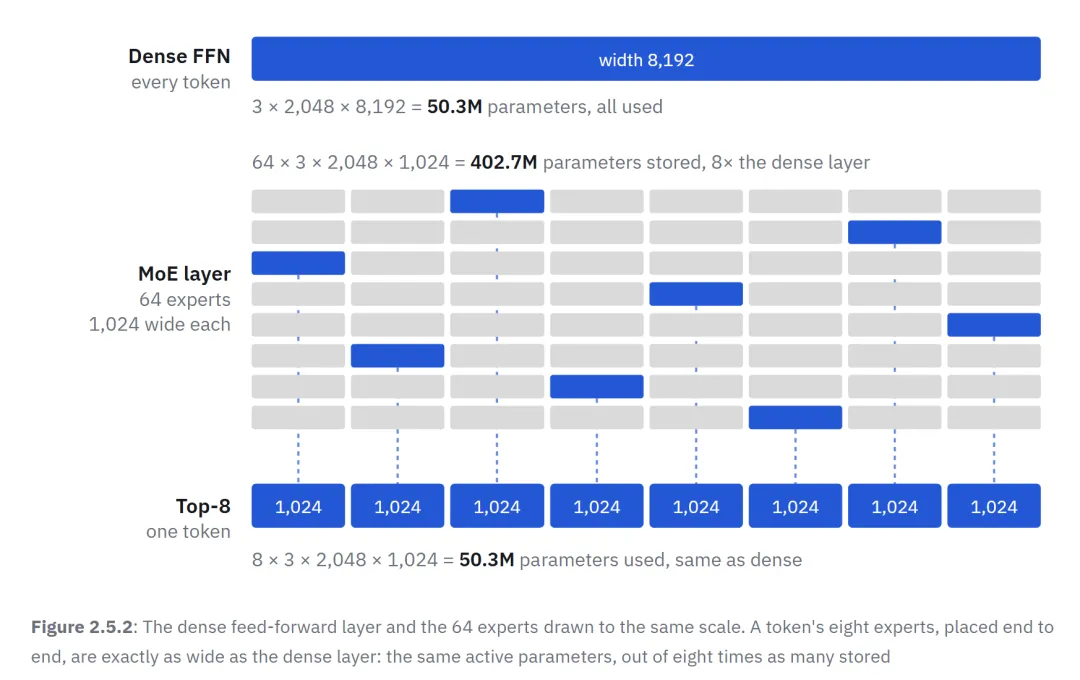
图 2.5.2: Dense Feed-Forward Layer 与 64 个 Expert 按照相同比例绘制。将一个 token 选择的 8 个 Expert 首尾相连,其总宽度恰好等于原来的 Dense Layer:两者具有相同的激活参数量,而 MoE 存储的参数量是 Dense Layer 的 8 倍。
64 个 Expert 的参数总量,是原 Dense Feed-Forward Layer 的 8 倍。
不过,整个模型的参数量增长倍数会更小,因为 Attention、Embedding 和其他非 Expert 参数的规模保持不变,同时每一层还会增加一个较小的 Router 矩阵。
将 16 层中的这些组件全部加总,最终得到:
MoE 总参数量:6.86B
MoE 每个 token 的激活参数量:1.221B
Dense 模型总参数量:1.219B
最终,MoE 的总参数量约为 Dense 模型的 5.6 倍,但两者的激活参数量几乎相同。
不过,激活参数量相同并不意味着每个训练 Step 的耗时也相同:将 token 分发到不同 Expert 会改变 GPU 的计算组织方式,同时引入额外的通信开销。
保留 Dense 参考基线
一个只有单个 Expert、采用 Top-1 Routing 的 MoE,与它所来源的 Dense 模型执行的是相同的函数,因此理论上也应该表现出相同的训练行为。
在我们的实验中,一个从 Dense Checkpoint 转换而来的单 Expert MoE,与 Dense 模型并行继续训练。在 15 个对齐的训练 Step 中,两者的 Loss 差异始终控制在 0.00087 以内。
如果改为从独立初始化开始训练 MoE,那么这种比较就没有太大意义,因为在第 4 次迭代时,两次运行的 Loss 已经相差 2.72。
MoE 一侧还记录到了恰好为 1 的负载均衡 Loss,以及约 32,770 个梯度为零的参数;相比之下,Dense 模型最多只有 17 个梯度为零的参数。
这些零梯度来自 Router 权重:当只有一个 Expert 时,Router 权重无法获得梯度。
这次用于验证一致性的实验采用了 Dense Checkpoint Upcycling。第三章 3.6 节还会再次讨论这一转换路径。
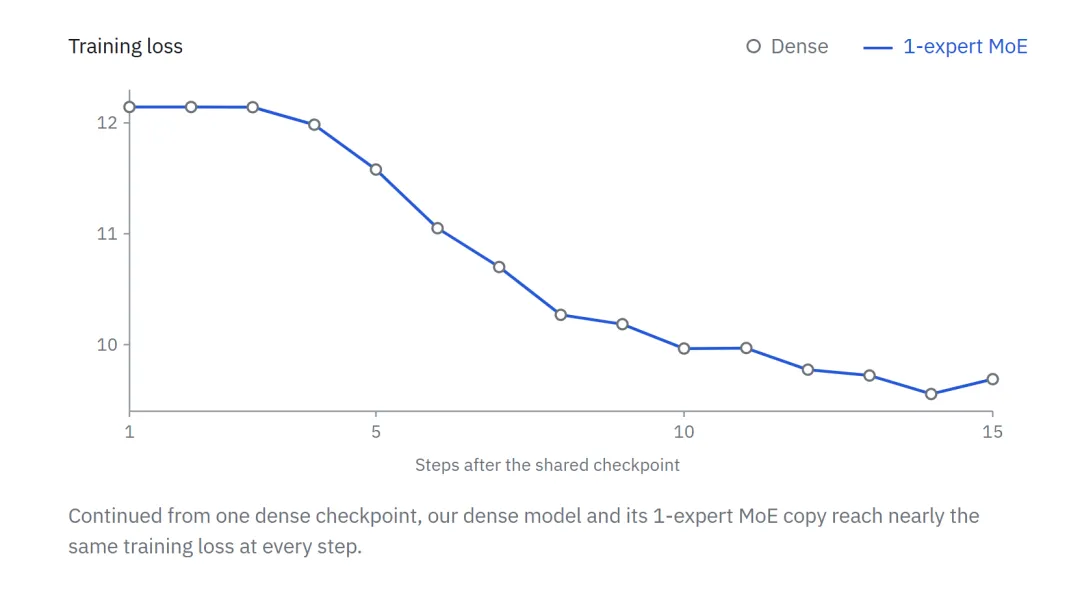
图 2.5.3
在当前固定的代码 Commit 下,这条 Upcycling 路径只有经过两处本地修改 training.py 才能正常运行。
第一处修改涉及向 Checkpoint Loader 传递 Dense 模型时使用的关键字参数。
当前代码将 Dense 模型通过关键字 model 传入 Checkpoint Loader,但 load_checkpoint 函数实际将这一参数命名为 ddp_model。
第二处修改涉及加载时构建的 Dense 模型。
Upcycling 代码会在 args 中切换 Dense 模型的形状配置,但模型构建器读取的是启动时保存的模型配置。因此,实际构建出来的模型仍然保留 MoE Layer 的布局,最终在加载过程中因为缺少 pre_mlp_layernorm 键而失败。
确定性模式(Deterministic Mode)可以让训练运行具备可重复性,从而使两次运行之间的差异具有实际意义。
在当前固定的代码 Commit 中,启用 --deterministic-mode 有以下要求:
必须关闭 Cross-Entropy Loss Fusion。
必须关闭 TP Communication Overlap。
必须关闭 Fused Auxiliary Loss Kernel。
NVTE_ALLOW_NONDETERMINISTIC_ALGO只能设置为0。
如果以下环境变量尚未设置,Deterministic Mode 会自动设置:
NCCL_ALGO=RingNCCL_EP_HT_EM_AG_SCAN_MODE=1NVTE_ALLOW_NONDETERMINISTIC_ALGO=0CUBLAS_WORKSPACE_CONFIG=:4096:8
2.4 节的启动脚本传入了 --cross-entropy-loss-fusion,并将 NVTE_ALLOW_NONDETERMINISTIC_ALGO=1 导出为环境变量,因此在添加 Deterministic Mode 之前,必须移除这两项设置。
在这些配置下,我们将该 MoE 的 Micro-batch Size 缩小至 2、Global Batch Size 缩小至 64,并运行 12 次迭代。
结果显示,两次运行在每一次迭代中的 LM Loss、Load-balancing Loss、Grad Norm 和 Gradient Zeros 都完全一致。
如果不启用这些确定性设置,从第一次迭代开始,LM Loss 就会出现差异,最大差异达到 0.00063。
因此,在比较两次训练运行或排查 NaN 问题之前,应当先启用 Deterministic Mode。
在开发 MoE 的过程中,始终保留 Dense 模型及其配置作为参考基线。
每当某项修改导致训练速度下降,或者 Loss 不再改善时,都应当回到 Trackio 中的 Dense 实验,比较相同 Batch Size 和 Sequence Length 下的 Step Time、Loss 和 Gradient Norm。
如果某个问题同时出现在 Dense 和 MoE 两次运行中,那么问题更可能来自它们共享的训练环境或配置。
如果问题只出现在 MoE 中,则有理由进一步调查 Routing 和 Expert Execution。
图 2.5.4: 使用合成的 Dense 和 MoE 训练运行数据展示 Trackio 界面。这些曲线仅用于说明界面功能,并不代表实际测得的训练性能。
Dense 参考基线能够帮助你判断应该从哪里开始排查问题。
第三章将逐步拆解 MoE Layer 的各个组成部分,并介绍理解其运行行为所需要的测量指标。
来源:human five