Motivation
几乎所有机器人部署任务在技术上都是可以实现的:只要投入足够的系统集成工作、数据和工程监督,就能够让机器人在范围明确的特定任务上实现可靠运行。
然而,达到这种可靠性所付出的成本,往往超过自动化本身创造的经济价值。毕竟,与机器人相比,人类在时间效率和数据效率方面仍然高出几个数量级。
在这篇博客中,我们将首次介绍一项探索性工作:如何借助仿真,为机器人学习建立一种更加高效的 Scaling Paradigm。
Accelerating Policy Development
传统流程通常是在目标机器人硬件上采集真实世界的遥操作数据,然后在真实环境中对 Policy Checkpoint 进行微调和评估。
我们提出了一种借助仿真加速 Policy 开发的流程:
校准仿真环境(Calibrate Simulation Environments):给定环境采集信息(图像、视频或点云)以及目标任务描述,通过物理精确的 World Modeling,生成与实际环境和任务相匹配的仿真环境。(具体细节参见 Evaluating 3D Simulation-ready Assets for Robotics 和 How to Close the Sim-to-Real Gap?)
在仿真中评估 Policy(Evaluate Policies in Simulation):给定一个机器人 Policy Checkpoint,在仿真环境中执行 Rollout,根据任务指标评估任务进展,并进行失败诊断。这有助于缩短 Policy 开发的迭代周期。要实现这一点,仿真环境必须提供我们所称的 L3 级别保证,即 Policy-level Guarantees(参见 Pushing the Frontier for Simulation Environment Generation)。
利用仿真改进 Policy(Improve Policies with Simulation):根据评估结果,利用 RL 或者在仿真中采集的机器人轨迹改进 Policy。与真实世界相比,仿真可以大规模改变任务中的相机、光照和物理条件,同时还能够提供特权信息(Privileged Information)。我们将介绍几种利用仿真改进 Policy 的方法。
迭代效率对比
仅使用真实环境(Only Real):
每次迭代约需 5.5 天。
任务定义:一次性完成,约 3 天。
采集真实数据:2 天。
Policy 改进与训练:12 小时。
真实环境评估:2 天。
Policy 诊断:人工完成,约 1 天。
仿真辅助(Simulation-enabled):
每次迭代约需 20 小时。
利用真实数据校准仿真环境:1 小时。
Policy 改进与训练:12 小时。
仿真评估:5 小时。
Policy 诊断:由 Agent 完成,约 3 小时。
迭代时间线
真实环境与仿真协同开发:
从一次任务定义出发,在真实机器人和仿真环境中并行推进开发。
真实环境流程: 任务定义 → 数据采集 → 训练 → 评估 → 诊断。
仿真流程: 校准仿真环境 → sim-v1 → sim-v2 → sim-v3 → sim-v4 → sim-v5 → sim-v6。
图示展示了第一周和第二周的迭代过程。
第一天:
真实环境:定义任务。
仿真环境:等待。
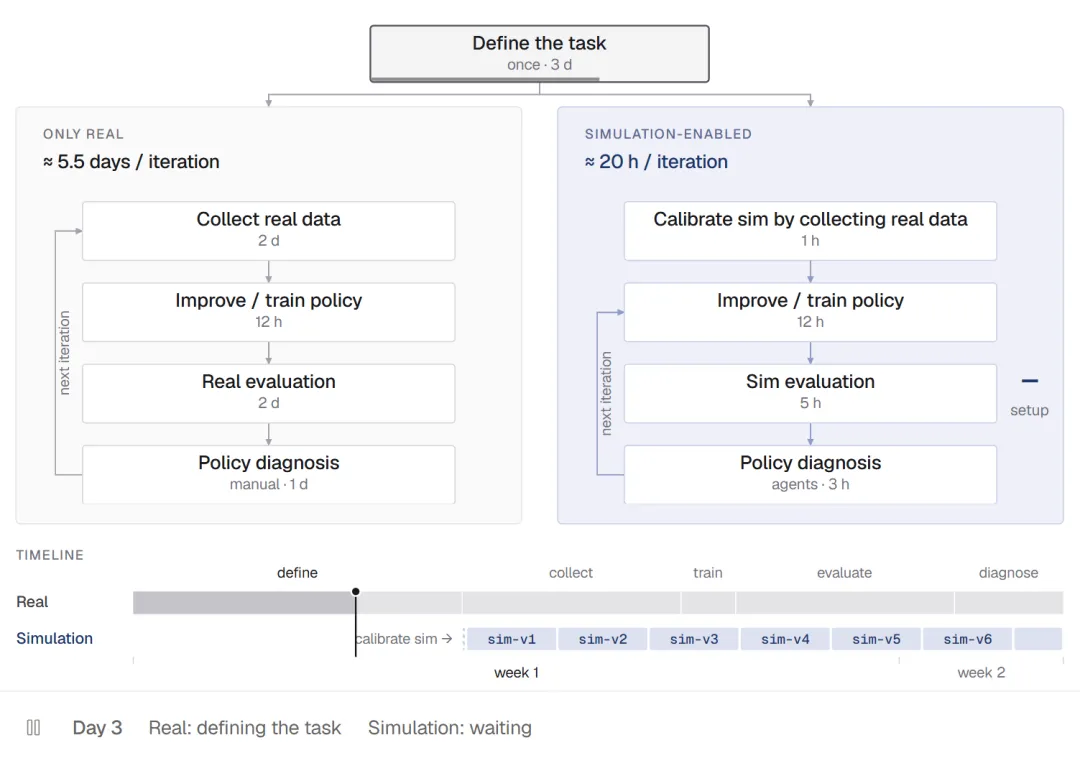
通过拖动时间线,可以逐步查看从任务定义出发,真实机器人和仿真环境如何并行推进开发。
Key Questions
在接下来的实验中,我们希望回答以下几个关键问题:
仿真中的性能与真实机器人上的性能具有多强的相关性?
如何有效利用仿真提升 Policy 性能?
通过仿真进行迭代,Policy 的改进速度能够提升多少?
实验涵盖三个双臂操作任务:
1. sort-from-tote
这是一个工厂场景中的高接触密集型(Contact-rich)操作任务。
一个灰色收纳箱位于左侧,里面装有多种工业零件,例如螺母、螺栓和轴承环。一台双臂 YAM 机器人需要将这些零件分类放入红色分拣器中。
由于零件尺寸较小,如果缺乏足够的操作精度和失败恢复能力,机器人很难成功抓取。其中,红色分拣器最右侧的槽位要求机器人对小型物体执行精确的双臂交接。
2. bottles-in-the-bin
这是一个基础的 Pick-and-Place 任务。
一台双臂 YAM 机器人需要抓取散落在桌面上的瓶子,并将其放入收纳箱中。
由于机器人的工作空间有限,为了成功抓取所有瓶子,机器人需要协调双臂,稍微移动收纳箱的位置。
3. mug-flipping
这是一个双臂交接任务。
桌面上随机摆放着多个不同姿态的杯子。双臂 YAM 机器人需要将所有未直立的杯子翻转至直立状态。
由于 YAM 的腕关节存在运动范围限制,单只手臂无法将已经抓住的杯子旋转所需的半圈,使其直立。因此,对于倒置的杯子,机器人必须通过双臂交接完成操作:一只手臂先抬起并倾斜杯子,另一只手臂随后抓住杯沿,将杯子直立放置。
Calibrate Simulation Environments
我们首先为上述三个任务分别生成仿真环境,然后利用少量真实世界的遥操作轨迹,对机器人、相机和环境物理属性进行校准。
其中,相机校准包括相机位置、镜头和曝光参数;环境物理属性校准则包括物体质量、摩擦力等。
关于如何结合物理引擎构建和校准资产、场景及其物理属性,可以参考 Evaluating 3D Simulation-ready Assets for Robotics 和 How to Close the Sim-to-Real Gap?
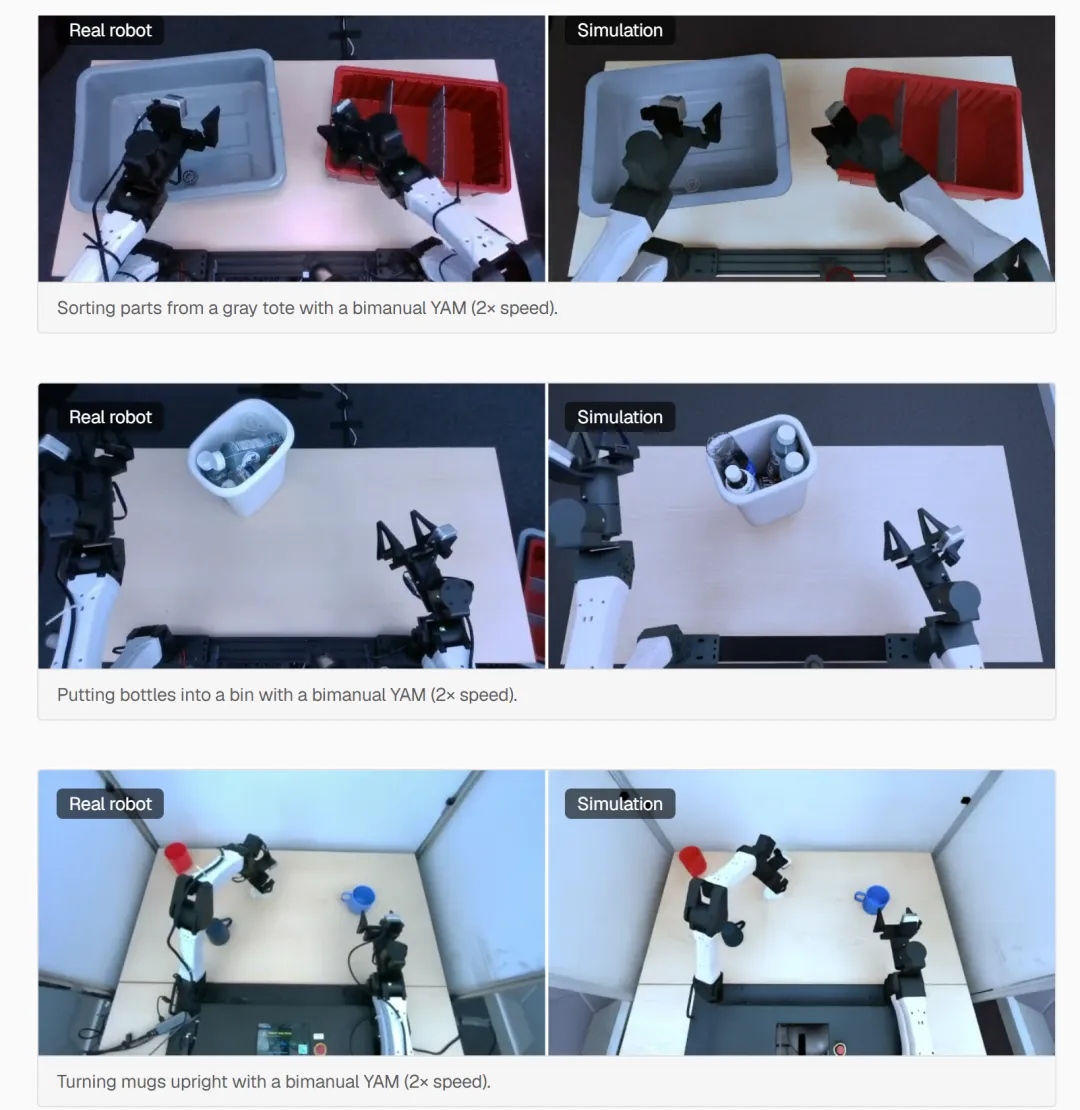
图示展示了三个任务在真实机器人与仿真环境中的执行效果:
双臂 YAM 从灰色收纳箱中分拣零件(2 倍速)。
双臂 YAM 将瓶子放入收纳箱(2 倍速)。
双臂 YAM 将杯子翻转至直立状态(2 倍速)。
Evaluate Policies in Simulation
在真实世界中评估 Policy 的成本很高。
每次真实世界的 Rollout 都需要有人重置场景、评估执行结果,并排查硬件问题。为了降低比较不同 Checkpoint 时的置信区间,通常还需要执行大量 Rollout。
我们认为,真实世界评估不可或缺,但仿真能够显著加快此前的迭代过程。它使我们能够:
对数据配方(Data Recipe)、数据过滤 Pipeline 和数据增强方案进行消融实验,找出最适合当前任务的配置。
比较不同 Base Model、超参数配置和训练方法的性能。
在训练过程中评估不同 Checkpoint,了解模型性能的变化趋势。
利用 Agent 自动探索最优 Policy 训练配方,无需人工干预。
Evaluation Protocol
为了确保后续实验的严谨性,我们对所有实验采用相同的评估协议,避免任务分布差异影响仿真与真实环境之间的相关性。
首先,我们以分层方式定义评估所关注的物体配置分布。
以 bottles-in-the-bin 为例:
第一层只有一个瓶子。
第五层包含 4–5 个瓶子,瓶子可能直立或横倒。
具体流程如下:
从目标分布中采样,在仿真环境中实例化对应场景,并记录每个样本的配置参数。
使用 Hash 固定最终配置集合,避免未经明确版本升级就修改配置。
在仿真 Rollout 中,直接加载第二步记录的配置参数。
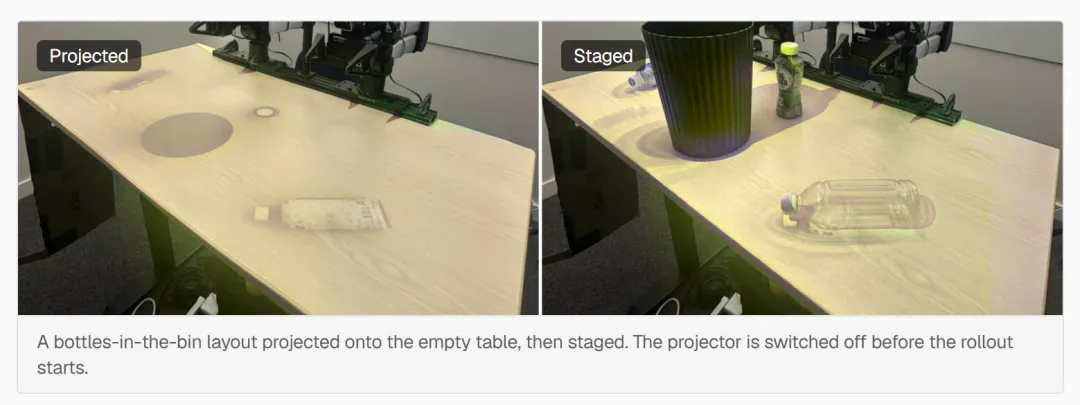
在真实机器人 Rollout 中,使用安装在工作台上方的投影仪,将物体配置投影到桌面上。投影仪经过桌面边缘校准,操作人员据此尽可能准确地摆放物体。
图示:bottles-in-the-bin 任务的物体布局首先被投影到空桌面上,然后由操作人员按照投影进行摆放。Rollout 开始前,投影仪会关闭。
对于真实世界 Rollout,为了减少操作人员的疲劳,每次评估 session 被设计为持续约 1–1.5 小时。
仿真 Rollout 则可以随着计算资源的增加而扩展,因此我们会对每种配置重复执行多次,以降低置信区间。
此外,为了确保结果具有可比性,我们对仿真和真实环境使用相同的 Episode 长度。
以下是三个任务的分层评估配置:
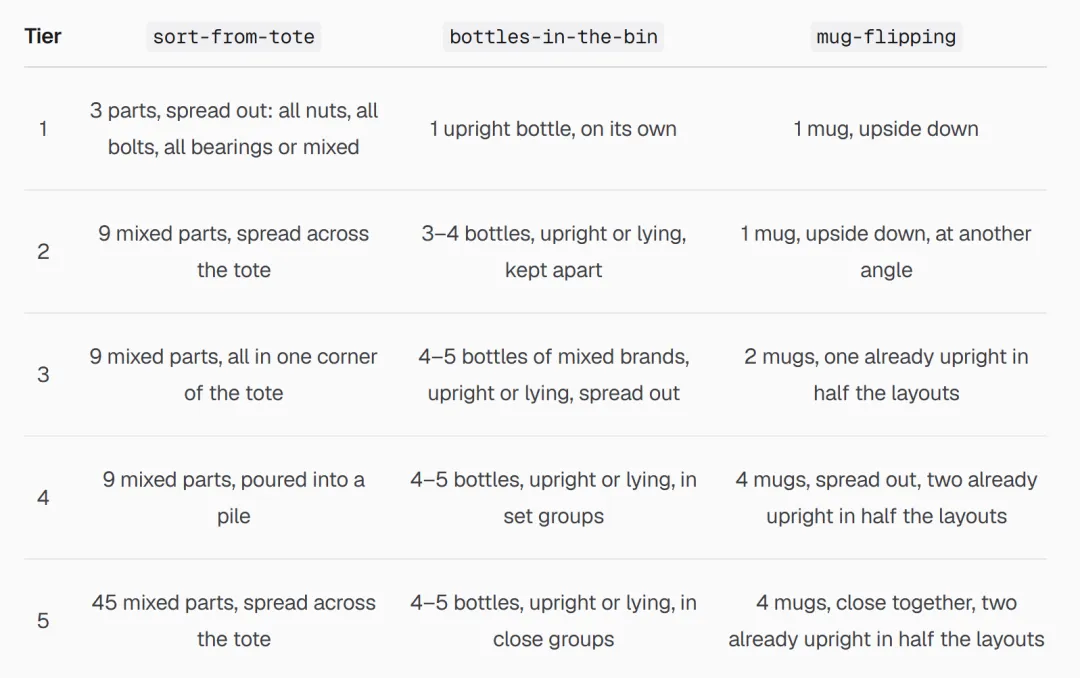
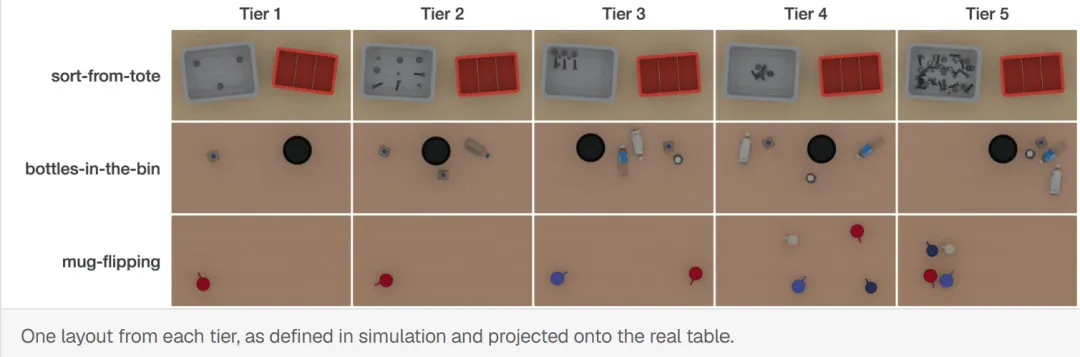
图示:每个 Tier 各选取一种布局,在仿真环境中定义,并通过投影仪映射到真实桌面上。
Sim-Real Correlation
如何确保在仿真环境中评估 Policy 所获得的经验,能够迁移到真实机器人上?
第一步是建立仿真与真实环境之间的相关性(Sim-Real Correlation),具体考察轨迹或 Policy 的执行结果。相关工作包括 SIMPLER、PolaRiS 和 SimFoundry。
为了建立这种相关性,我们针对 sort-from-tote 和 bottles-in-the-bin 任务采集了内部真实遥操作轨迹;对于 mug-flipping 任务,则使用了 ABC-130k 提供的开放真实世界轨迹。
对于每个任务,我们分别使用约 50、100、200 和 400 个 Episode 对 PI-0.5 Policy 进行微调。
最终得到 12 个 Policy,并分别在仿真环境和真实机器人上进行评估。随后,我们比较它们的任务进展(Task Progress)。
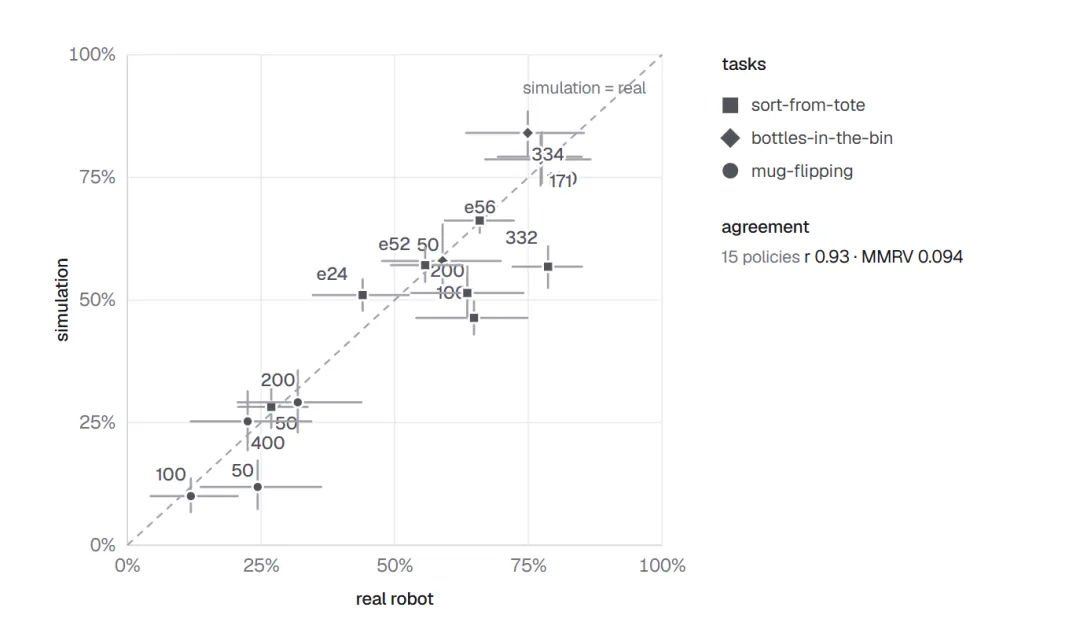
图示:15 个 Policy 在仿真和真实环境中的表现相关性,包含 95% 置信区间。数字表示训练 Episode 数量,e 表示 RL Epoch。
相关性指标:
Pearson 相关系数
平均最大排序违例(MMRV)= 0.094
上述指标基于 15 个 Policy 计算。
借助我们构建的仿真自动化研究系统(Simulation Autoresearch Stack),仿真环境与真实机器人上的任务进展在这 15 个 Policy 之间表现出高度一致性。
这让我们有信心提出:如果一个 Policy 在仿真中表现良好,那么它在真实机器人上也会表现良好;如果它在仿真中表现不佳,那么在真实机器人上同样不会有好的表现。
我们发现,相较于视觉因素,物理因素对实现较高的 Policy-level Sim-Real Correlation 具有更大的影响。
这包括以下细节:
为任务选择合适的 Solver 和 Kernel。
仅在不会影响 Policy-level 行为的前提下,对物理过程进行适当近似,以加速仿真。
根据物体在具体场景和任务中的使用方式,合理建模物体细节,例如精细化的碰撞代理(Fine-grained Collision Proxies)。
Policy Diagnosis
一旦建立了可信赖的仿真环境,我们就可以系统地诊断 Policy。
我们可以利用 Agent 在仿真环境中自主诊断 Policy,具体流程包括:
观察执行结果。
找出 Policy 行为中出现频率最高的失败模式。
由 Agent 自主更新仿真环境和测试用例,进一步验证这些失败模式。
以 bottles-in-the-bin 为例:在不同 Tier 的评估场景中测试 Policy 后,Agent 正确判断出,当瓶子排列得更加密集时,Policy 经常会将相邻的瓶子碰落桌面。
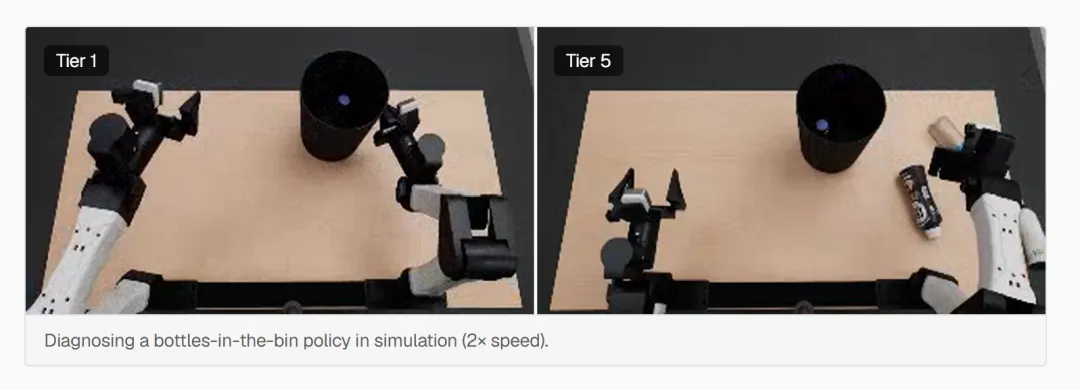
图示:在仿真环境中诊断 bottles-in-the-bin Policy(2 倍速),展示 Tier 1 至 Tier 5 的不同场景。
当我们能够有效诊断 Policy 后,接下来的问题就是:如何最好地利用仿真来改进 Policy?
Improve Policies with Simulation
下面,我们首先介绍 Guided Domain Randomization,然后针对接触密集型任务 sort-from-tote,探索 Rejection Fine-tuning 和 RL;针对 bottles-in-the-bin 和 mug-flipping,则探索 Privileged Policy Distillation。
对于需要精确控制的接触密集型任务,真实遥操作数据通常效果最好。
在 sort-from-tote 任务中,零件可能发生细微移动,Policy 必须及时感知这些变化才能成功抓取,因此我们选择基于现有遥操作数据进行训练。
而 bottles-in-the-bin 和 mug-flipping 任务可以通过 IK 和精心设计的轨迹规划来解决。因此,我们希望研究:仅使用仿真数据是否足够?
Guided Domain Randomization
Domain Randomization 是 Moonlake 当前利用仿真进行评估和训练的重要方式。
关键在于,随机化范围应由前面诊断出的失败模式指导,而不是对所有参数进行均匀随机化。
具体来说,Agent 会读取评估结果,识别 Policy 在什么条件下容易失败,然后利用仿真生成系统配置需要随机化的参数分布。
以 bottles-in-the-bin 为例:
由于 Policy 在瓶子密集排列时容易碰倒相邻瓶子,因此随机化会更多地集中在密集瓶子布局上,同时还会改变相机姿态、光照以及 Policy 敏感的物体属性。
随后,对改进后的 Policy 使用相同的 Tier 进行重新评估,从而形成闭环。
Domain Randomization 只是利用仿真改进 Policy 的一种方式,我们目前也在探索其他方法。
接下来的两个部分将介绍我们已经尝试过的方案:结合 RL 的 Rejection Fine-tuning,以及 Privileged Policy Distillation。
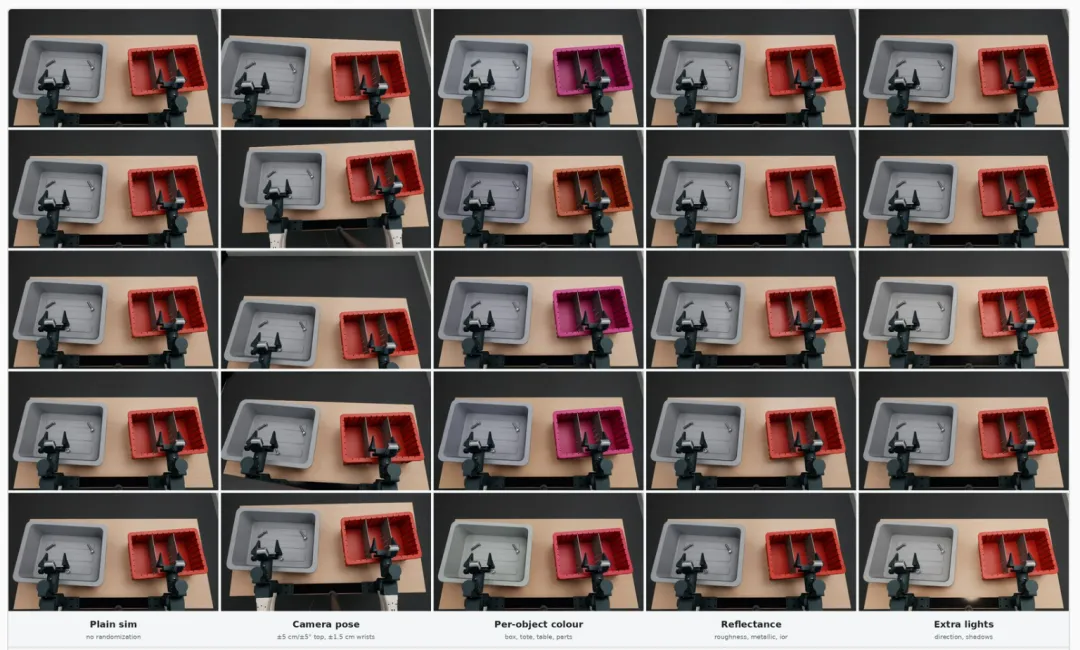
图示:通过改变相机姿态、物体属性、光照等因素进行 Domain Randomization。
Rejection Fine-tuning and RL
在这项实验中,我们使用 sort-from-tote 任务,并假设只能获得 50 个真实遥操作 Episode。
首先,我们使用这 50 个真实遥操作 Episode 对 PI-0.5 进行微调。
如下方图表的第一阶段所示,训练进行到约 40k Steps 后,Task Progress 不再继续提升。
随后,我们在仿真环境中改变多种条件,例如光照、相机姿态和零件颜色,对微调后的 Policy 进行 Rollout。
我们过滤出其中成功抓取的帧,并将少量真实数据与仿真中成功的 Rollout 结合起来,对 Policy 进行联合训练,即 Sim-and-Real Co-Training。
这一阶段采用 Rejection Fine-tuning。
额外训练 10k Steps 后,Task Progress 提升了 11 个百分点。
在仿真与真实环境联合训练的基础上,我们进一步使用 RL 训练 Policy,并行运行 384 个仿真环境。
Reward 直接采用任务指标:
- 每成功将一个零件放入正确槽位,奖励 +1。
- 每将一个零件碰出目标区域,奖励 -1。
- 不使用 Reward Shaping。
最终,Policy 在仿真环境中的表现进一步提升了 38 个百分点,在真实世界评估中的表现提升了 39 个百分点。
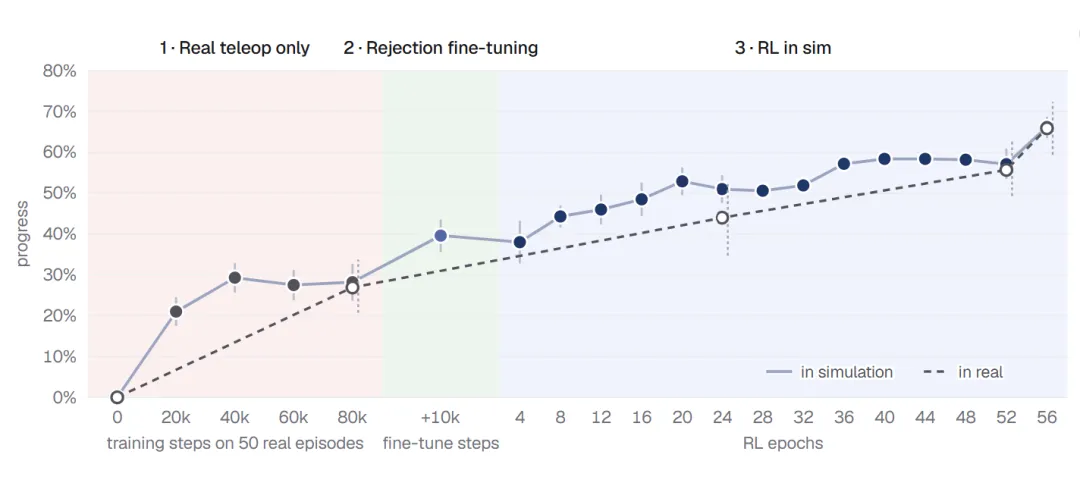
图表分为三个阶段:
仅使用真实遥操作数据(Real Teleop Only)
- 使用 50 个真实 Episode 训练。
Rejection Fine-tuning
- 额外进行 10k Steps 的微调。
仿真中的 RL
- 按照 RL Epoch 展示训练进展。
图示:sort-from-tote 任务在 Rejection Fine-tuning 和 RL 阶段的 Task Progress,每个 Checkpoint 均展示其 95% 置信区间。
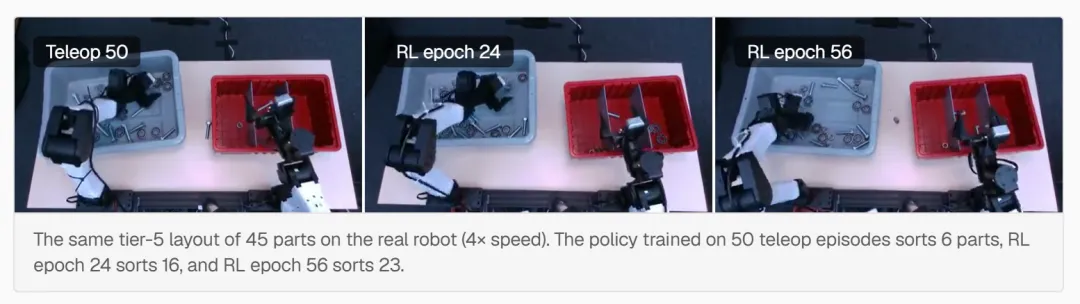
图示:真实机器人在相同的 Tier 5 布局下处理 45 个零件(4 倍速)。
使用 50 个遥操作 Episode 训练的 Policy:分拣 6 个零件。
RL Epoch 24:分拣 16 个零件。
RL Epoch 56:分拣 23 个零件。
此外,我们发现 Rejection Fine-tuning 阶段对于 RL 至关重要。
在 RL 阶段,每个仿真环境都会随机化相机姿态、颜色、反射率和光照。
如果没有这一阶段,单纯使用真实数据训练的 Policy,在这种随机化条件下能够分拣的零件数量会减少 3–4 倍,而且很少能够获得 Reward。
直接在这个 Checkpoint 上进行 RL 训练也无法带来改善。
相比之下,经过 Fine-tuning 的 Policy 已经从随机化 Rollout 中学习到了相关知识,因此从训练开始就能够获得 Reward,并在此基础上持续提升。
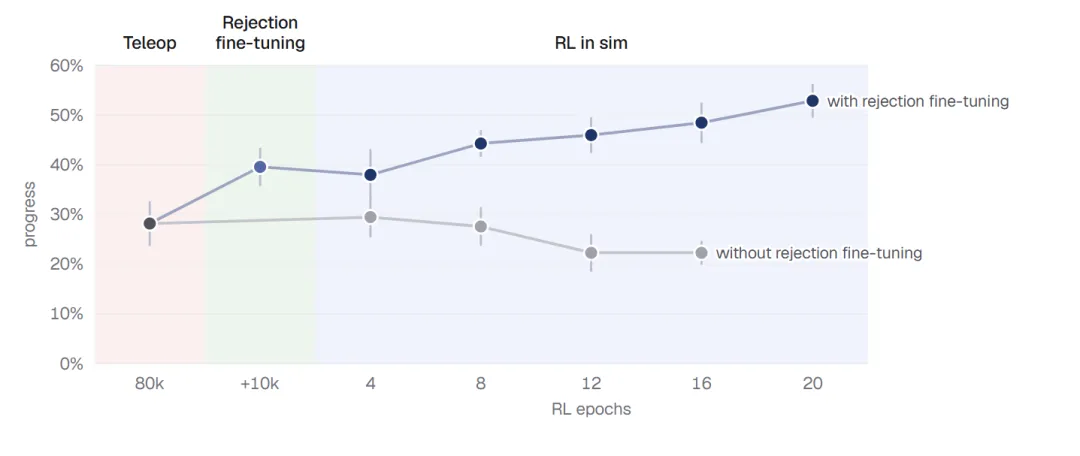
图示:采用相同 RL 配方,对比是否先进行 Rejection Fine-tuning 的训练结果。两组实验均展示各 Checkpoint 的 95% 置信区间。
当物理仿真足够准确时,仿真中的 RL 能够提升 Policy 在真实机器人上的表现,而且这种提升在接触密集型操作中尤为明显。
RL 前后的分层任务表现
以下是在真实环境中的 Task Progress:
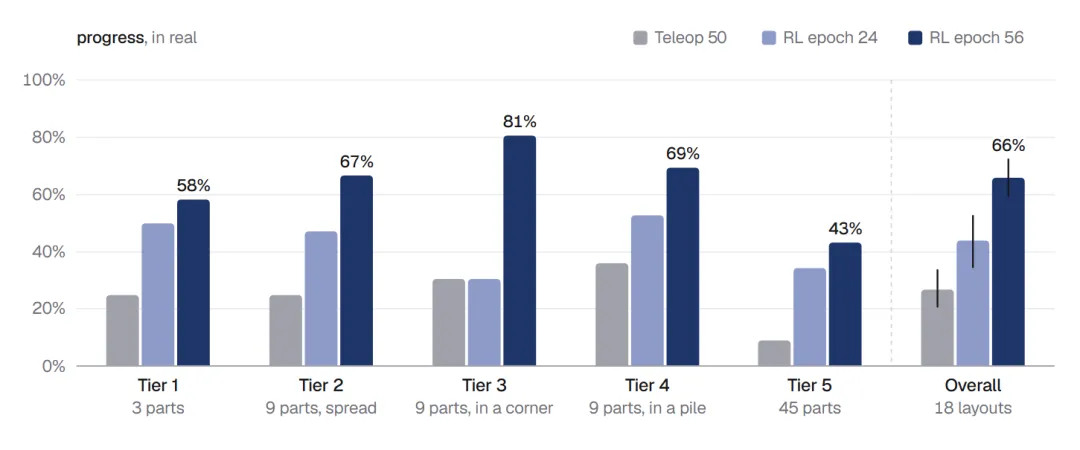
图表对比了 RL 前后的 sort-from-tote 分层任务进展。每种布局执行一个 Episode,Overall 数据包含 95% 置信区间。
行为指标变化:
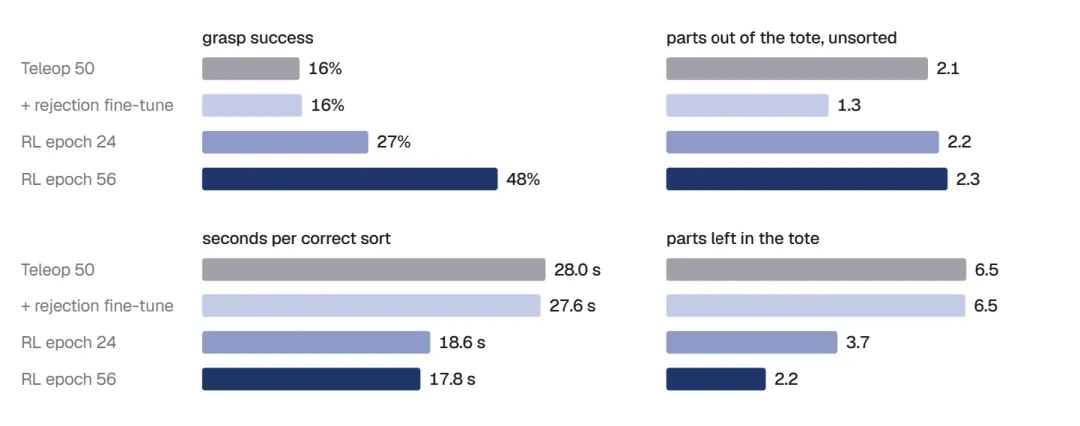
抓取成功率根据夹爪信号推断。未完成分拣的零件,是指已经离开收纳箱,但没有进入正确槽位的零件。
不同零件类型的分拣成功率:
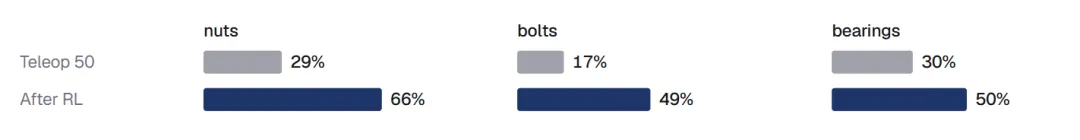
以上数据为仿真环境中的各类零件正确分拣比例,对比 RL 前后的表现。
Zero-Shot Transfer via Privileged Policy Distillation
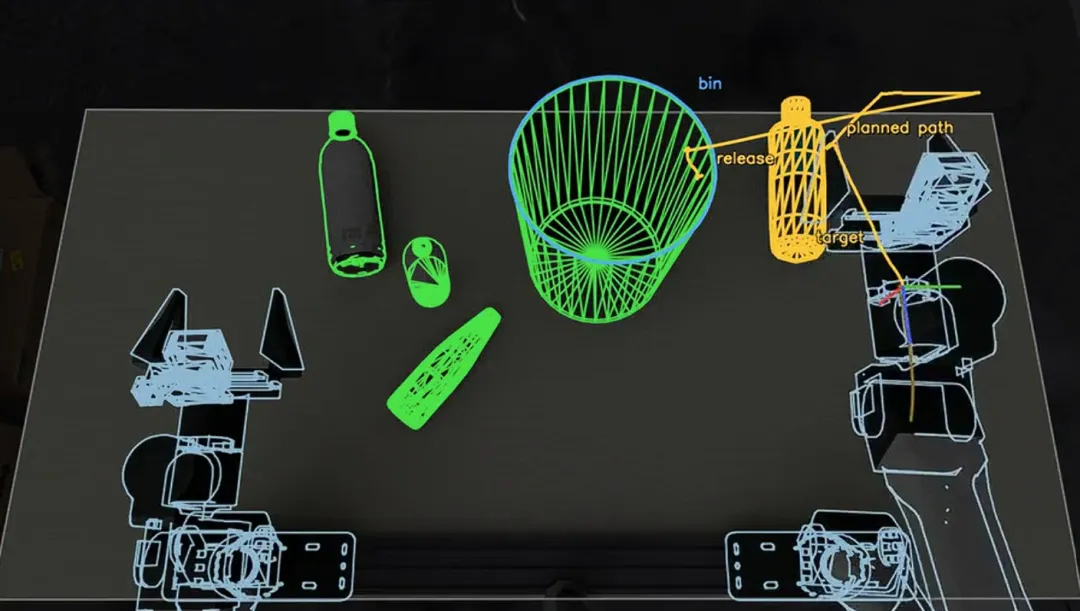
仿真有一个尚未被充分探索的优势:通过仿真引擎,我们能够直接获取关于世界状态的特权信息(Privileged Information)。
这些信息包括物体的位置、方向、速度、物理参数等真实世界状态。
在这项实验中,我们利用这些特权信息构建一个 Policy(称为 Privileged Policy),然后将其蒸馏为一个不依赖特权信息的版本,因为这些信息在真实世界中无法直接获取。
具体而言,我们将 Privileged Policy 实现为一个代码 Policy(Code as Policies),让它在仿真环境中执行 Rollout,并记录对应轨迹,包括视觉观测、机器人状态和动作。
随后,我们筛选出成功轨迹,并使用不同数量的仿真 Episode 对 Base Model 进行微调。本实验使用的 Base Model 是 PI-0.5。
最后,我们将这些 Policy 在真实机器人上的 Task Progress,与仅使用真实遥操作数据训练的 Policy 进行比较。
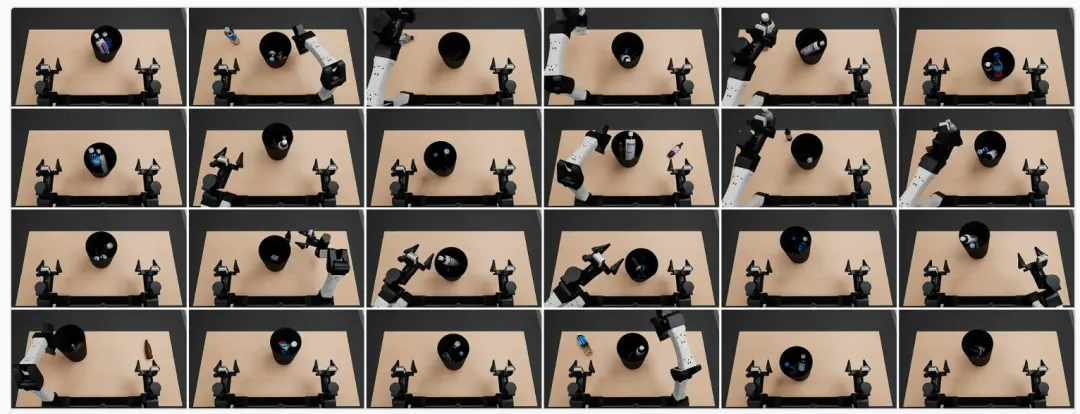
图示:从 400 个仿真 Episode 中抽取的 24 个 Episode,瓶子和收纳箱均采用随机摆放方式(2 倍速)。
bottles-in-the-bin
图表展示了不同训练数据规模下,Policy 在真实机器人上的 Task Progress。
横轴:训练 Episode 数量,分别为 0、50、100、200 和 400。
数据分为两组:
Real Teleop Data:真实遥操作数据。
Simulated Data:仿真数据。
不同训练规模下的图表结果包括:
真实遥操作数据:59.0%、77.5%、77.3%、74.9% 等。
仿真数据:25.7%、55.5%、59.5% 等。
mug-flipping
同样比较不同训练数据规模下的真实机器人表现。
横轴:训练 Episode 数量,分别为 0、50、100、200 和 400。
数据分为真实遥操作数据和仿真数据两组。
图表展示了不同数据规模下的 Task Progress,包括 24.4%、11.9%、31.9%、22.5%、19.4%、44.4%、38.8% 和 38.1% 等结果。
上述实验均在 80k Training Steps 后进行评估。每个结果基于 40 种布局计算,并展示 95% 置信区间,每种配置运行一次。
需要强调的是,这是一项 Zero-Shot Transfer 实验。
使用 Privileged Policy 仿真数据训练的 Policy 没有接触任何真实世界数据,唯一的例外是:在生成 Privileged Policy 所使用的仿真环境时,使用了一条真实遥操作轨迹进行环境校准。
最终,仅使用仿真数据训练的 Policy,也成功迁移到了真实机器人上,实现了 Zero-Shot Transfer。
Results
综合上述方法,我们希望回答一个问题:
在相同资源投入下,如果将 Policy 改进闭环放在仿真环境中运行,相较于完全依赖真实环境的流程,Policy 最终能够取得怎样的进展?
我们首先介绍如何衡量开发成本,然后给出三个任务的综合对比结果。
Characterizing Development Cost
我们比较两种开发流程:
Real-only:
在真实机器人上采集数据,并在真实硬件上进行训练和评估。
Sim-enabled:
将数据采集和评估环节转移到仿真环境中。
其中:
sort-from-tote 使用 Sim-and-Real Co-Training 和 RL。
bottles-in-the-bin 与 mug-flipping 使用 Zero-Shot Policy。
两种流程都最多进行四轮迭代,每轮包含数据采集、训练、评估和诊断,并且使用相同的任务布局。
我们以真实机器人上的 Policy Performance 为纵轴,以累计资源成本为横轴,绘制两种流程的性能变化曲线。更多细节见附录。
A Simulation-enabled Scaling Paradigm
如下方图表所示,对三个任务的结果取平均后,仿真辅助的 Scaling Paradigm 能够以显著更低的成本,达到与纯真实环境流程基本相同的任务进展。
图表说明:
纵轴:真实机器人上的 Policy Performance,三个任务取平均。
横轴:每个任务的累计资源使用成本,单位为美元,采用对数坐标。
Sim-enabled:仿真辅助流程。
Real-only:纯真实环境流程。
资源成本包括:
遥操作和机器人评估所消耗的操作人员时间与工程师时间。
用于仿真数据生成、仿真评估和 RL 的云端 GPU 资源。
由于两种流程的训练成本相同,因此图表中不计入训练成本。
Closing Remarks
在这篇文章中,我们展示了如何利用仿真加速 Policy 开发。
通过仿真迭代 Policy,只需要纯真实环境流程的一小部分资源,就能够达到相同水平的可靠性。
Moonlake's Environment Hub
本文展示的三个任务只是我们已经构建的仿真环境中的一小部分。
Moonlake 的 Environment Hub 包含大量经过校准的真实世界部署任务仿真环境。每个环境都经过专门构建,确保评估、数据生成和强化学习能够在同一个环境中运行。
团队可以利用这些环境:
在 Policy 接触真实机器人之前进行评估。
生成训练数据。
诊断 Policy 的失败原因。
References
Physical Intelligence. π0.5: Open-World Generalization.
Yilun Du. Generalization by Construction, 2026.
Moonlake. Evaluating 3D Simulation-ready Assets for Robotics.
Moonlake. How to Close the Sim-to-Real Gap?
Moonlake. Pushing the Frontier for Simulation Environment Generation.
Xuanlin Li, Kyle Hsu, Jiayuan Gu, et al. Evaluating Real-World Robot Manipulation Policies in Simulation (SIMPLER). CoRL 2024.
Arhan Jain, Mingtong Zhang, Kanav Arora, et al. PolaRiS: Scalable Real-to-Sim Evaluations for Generalist Robot Policies. RSS 2026.
Nadun Ranawaka, Josiah Wong, Wei-Lin Pai, et al. SimFoundry: Modular and Automated Scene Generation for Policy Learning and Evaluation, 2026.
Jacky Liang, Wenlong Huang, Fei Xia, et al. Code as Policies: Language Model Programs for Embodied Control. ICRA 2023.
Zheng Yuan, Hongyi Yuan, Chengpeng Li, et al. Scaling Relationship on Learning Mathematical Reasoning with Large Language Models, 2023.
Arthur Allshire, Himanshu Gaurav Singh, Ritvik Singh, et al. Scalable Behavior Cloning with Open Data, Training, and Evaluation (ABC-130K), 2026.
Abhiram Maddukuri, Zhenyu Jiang, Lawrence Yunliang Chen, et al. Sim-and-Real Co-Training: A Simple Recipe for Vision-Based Robotic Manipulation, 2025.
Appendix
Footnotes
1. Task Progress 的定义
一次运行的 Task Progress,是指已经完成的目标物体数量所占的比例。
对于 sort-from-tote,计算正确放入目标槽位的零件数量,占桌面上所有零件数量的比例。
对于 bottles-in-the-bin,计算成功放入收纳箱的瓶子数量,占目标瓶子总数的比例。
对于 mug-flipping,计算成功翻转至直立状态的杯子数量,减去被碰倒的原本直立的杯子数量,再除以初始状态下未直立的杯子数量。结果最低为零。
2. 相关性指标定义
表示图中各数据点的 Pearson 相关系数。
MMRV(Mean Maximum Rank Violation,平均最大排序违例)的计算方式是:对于每个数据点,找出所有被仿真评估排序相反的数据点,计算它们在真实机器人评估中的最大性能差距,然后对所有数据点取平均。
MMRV 为 0,意味着仿真对所有数据点的排序与真实机器人完全一致。
3. 资源成本计算
资源使用成本图表按照市场价格计算每轮迭代的资源消耗,包括:
遥操作和真实机器人评估所需的操作人员与工程师时间。
仿真数据生成、仿真评估和 RL 所使用的按需云端 GPU 资源。
每个数据点的资源成本,代表截至该轮迭代为止的累计资源消耗。
Citation
Moonlake AI. A Simulation-enabled Scaling Paradigm for Robot Learning. October 2026.
来源:human five