补一万条轨迹,不如换一个编码器?
——本文出自《具身智能基础》专栏-第16篇
现在很多团队在做机器人操作、世界模型时,都会优先试 DINOv3。
“同一只杯子,同一台机械臂,同一条轨迹。把白色桌布换成木纹,再关掉一半的灯,抓取成功率就掉一截”。
是数据不够吗?
这类“掉点”有个共同点:桌布颜色、灯光亮度变了,画面里物体的几何一点没变,但模型的判断却变了。
这说明它盯的是颜色和纹理,不是形状。如果不解决这件事,那再加数据,也只是让它在更多颜色的桌布上过拟合。
病根在编码器:它输出的特征里,颜色和纹理占了主导。
翻 2026 年相关机器人研究就可以发现,相当一批出现了同一个动作:把视觉编码器冻住,不训(换一个更看几何结构的骨干,而且冻住它,避免微调时又被这批数据拉回颜色、纹理上)。
它们选的也是同一个:DINOv3。
它正在成为具身智能里一款 “默认上手” 的视觉底座。
比如世界模型的目标,是预测动作带来的场景状态变化,而不是生成一张高清逼真的图片。比起像素纹理,它更关心 “物体是什么、在哪、会怎么变”。DINOv3 的特征天然偏向语义与物体结构,对光照、纹理扰动鲁棒性更强,非常适合用来做状态对比、时序跟踪、跨域对齐。
也正因如此,越来越多 WAM(World-Action Model)、操作仿真、模仿学习项目,把冻结的 DINOv3 作为视觉编码器,把特征 latent 送入世界模型做时序预测,而不是走像素重建路线。
但“冻住”只是用法,不是理由。
要回答这个问题,得先看一件更实际的事:一张图进去,它到底吐出什么?以及这套输出,为什么恰好是机器人需要的那种“看结构、不那么看颜色”的表征?
DINOv3 模型基础
输入与输出
DINOv3 原生接收单张 RGB 图像,无需目标框、标注掩码或深度图。
输入尺寸支持可变分辨率,常用尺寸如 512×512、896×896,最高可到 4096×4096。图像按patch大小16切分。
例如输入 896×896 图像,会被切分为 56×56 个 patch。
在具身任务里,工程上常会额外拼接深度图作为额外通道,但这不属于 DINOv3 原生输入,属于任务侧扩展。
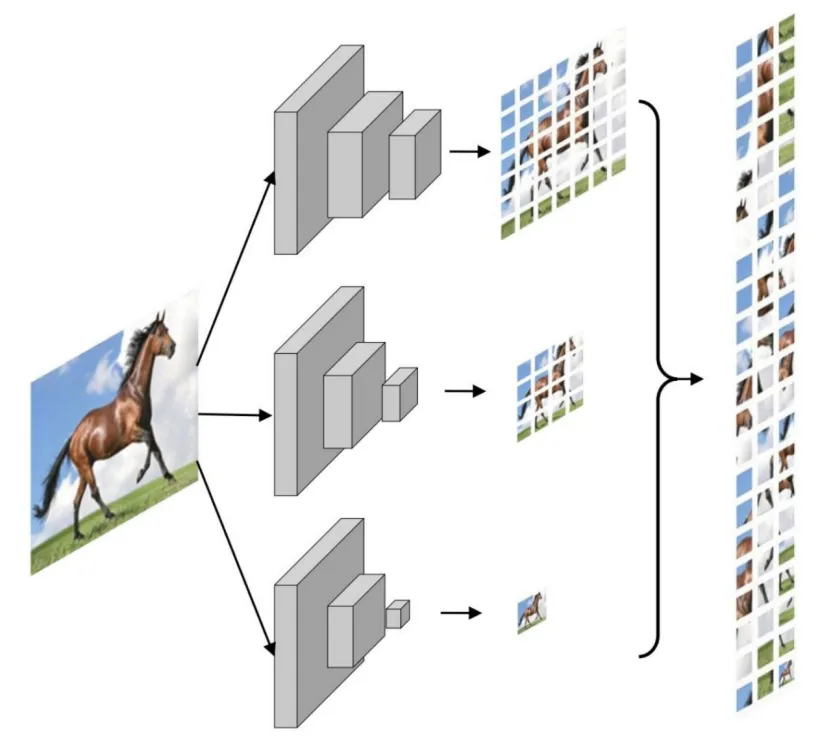
▲图 | patch天生来自DINO采用的ViT架构,ViT是DINOv3的核心骨干网络,DINOv3是基于ViT架构©【深蓝具身智能】编译
模型输出两类特征,也是具身智能研究中最常用的表征形式。
下面结合 512×512 像素桌面场景(画面包含左侧白色杯子、右侧金属罐头)举例说明:
全局 token(class token):
768 维向量(以 ViT-B/16 为例),用来概括整张图片的整体情况,适合判断两张图片的整体场景是否相似。
这组向量可以记住 “桌面上有杯子和金属罐头”,但是不会记住杯子在左边还是罐头在右边——位置信息丢失,一般不用来找物体局部位置。
密集 patch token(空间特征图):
二维网格形式的数字数组。图片会被切成很多 16×16 像素的小方块,ViT-B/16 模型会给每一个小方块,单独输出一串包含 768 维向量。
对于 512×512 输入图像,按照 patch 尺寸 16 像素划分,可得到 32×32 共 1024 个小方块,输出就是 32×32×768 的整套数字。
每个 768 维向量是模型对这块小区域“结构特征”的自学习编码——它不表示颜色,也没有人工预定义含义,但遵循一条规律:
视觉结构相近的区域,编码在高维空间中距离更近。
这里所说的 “结构相近” 重点看轮廓、曲面起伏,而不是颜色。
例如罐头侧壁相邻的两个小方块,都是圆柱曲面,二者数字就很接近;哪怕换一张图片里别的金属罐,只要同样是圆柱侧面,数字也会比较接近。杯身曲面虽然也是弯曲表面,但弯曲程度不同,数字就和罐头有差异。
哪怕两块区域颜色完全一样,如果一个是平面、一个是曲面,它们的数字也会相差明显。
这套编码不带任何文字标签,使用方式靠相似度对比:提前提取已知罐头侧壁 patch 的编码作为模板,新 patch 与模板算距离,距离小即判定结构接近。
机器人据此可以分辨哪几块 patch 属于同一个物体。
需要注意的是,DINOv3原生不会直接输出坐标、物体掩码、抓取位姿、深度,它只输出特征数字。
想要得到坐标、掩码这类结果,需要在 DINOv3 后面额外加简单网络层做转换。
DINOv3 定位能力:精确对位还是大致位置?
这是使用 DINOv3 时最需要想清楚的问题。
因为原生 DINOv3 特征只能提供大致位置与物体边界感知;搭配轻量解码器 / 任务头后,可以做到亚像素级精确对位,但精度有上限,不能媲美专门的位姿估计算法。
原生冻结骨干、不加任务头:只有大致位置。
patch 粒度 16 像素决定了直接匹配的精度上限就是 16 像素——能区分物体在哪个区域、识别轮廓和大致中心,适合粗定位、目标检索和导航(判断目标在左/右/前方),但无法分辨微小偏移,不能直接用于毫米级插装、拧螺丝这类精细操作。
适用场景包括机器人粗导航,找到目标物体所在区域;判断场景是否发生变化;图像 goal 匹配。
局限是无法区分物体微小偏移,不能直接用于机械臂毫米级精细插装、拧螺丝这类高精度操作。
冻结骨干+挂载轻量任务头:图像平面内精确对位。
在冻结 DINOv3 密集特征之上,训练少量参数的解码器,把 patch 特征上采样回原图分辨率,可以预测物体掩码、关键点、抓取中心点、物体 2D 轮廓。此时定位精度可以突破 patch 粒度,达到亚像素级别,满足桌面抓取、放置这类操作任务。
这是靠DINOv3 学到物体结构、边缘、部件之间相对关系,任务头学习把这些结构特征映射到像素坐标。
但同时存在两个上限:
其一,这是 2D 图像平面上的精确对位,不是 3D 空间下的毫米级位姿。2D 像素坐标无法直接转化为真实世界三维坐标,还需要相机内参、深度信息或者多视图三角化。
其二,DINOv3 本质是自监督视觉表征,不是专门的高精度位姿估计器。它适合桌面物体抓取、物体放置、简单对齐,厘米级空间操作;但不适合无额外深度 / 点云辅助下,独立完成精密装配、微小零件对位这类毫米级高精度操作。
DINOv3 核心原理
DINOv3 是 Meta 在 2025 年推出的第三代 DINO 自监督视觉 Transformer 模型,训练数据集为 LVD-1689M,包含约16.89亿张无标注互联网图像。
和传统需要人工打标签的监督学习模型不一样,DINOv3 训练全程不需要告诉模型 “这是杯子、这是罐头”,依靠自监督学习,从图片本身寻找学习信号。
前面我们提到了,DINOv3 输出的特征本身不带人类可读的语义。主要有两种用法:
直接做相似度匹配(零训练)
提前保存好目标物体参考 patch 的数字数组,新图片提取 patch 数组之后,计算两组数组之间的距离。距离近,就判定图像区域结构接近。
比如机器人要找罐头,就拿罐头的参考数组在整张特征网格里逐个比对,找到匹配的 patch 簇,定位罐头在图片中的大致区域。
这个方式只有粗定位能力,无法区分精细类别。
接一个轻量任务头网络,给特征赋予语意(少量训练)
我们标注少量图片(标记哪里是物体、抓取点、掩码),训练一层简单网络。这层网络学习一个映射关系:把 DINOv3 输出的无语意数字数组,翻译成我们想要的结果,例如物体掩码、抓取坐标、物体类别。
举个简单类比:
DINOv3 像色盲画家,能准确分辨物体轮廓、曲面起伏,但叫不出物体名字,画家画出素描(也就是这套数字数组);我们另外找一个解说员(任务头),看着素描说出物体名称和位置。
素描本身没有文字,解说员负责解读含义。
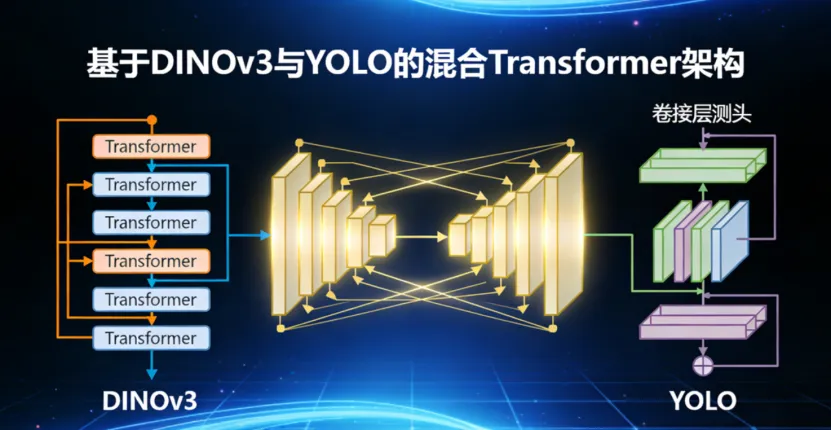
▲图 | YOLO可以给DINO当解说员,增加语意©【深蓝具身智能】编译
训练
整个训练采用师生双模型自蒸馏框架,同时融合 iBOT 掩码预测、KoLeo 特征扩散、Gram 锚定损失多重目标协同训练。
师生双模型自蒸馏框架
训练时会对同一张原始图片做两种不同的随机变换,分别生成全局视图(裁剪图片较大区域)和局部视图(裁剪图片一小块区域)。
分别送入 Teacher 教师模型,和 Student 学生模型。教师模型输出的特征作为软目标,引导学生模型学习。教师模型不参与反向梯度更新,它的权重只通过学生模型权重缓慢平滑更新,保证输出特征稳定。
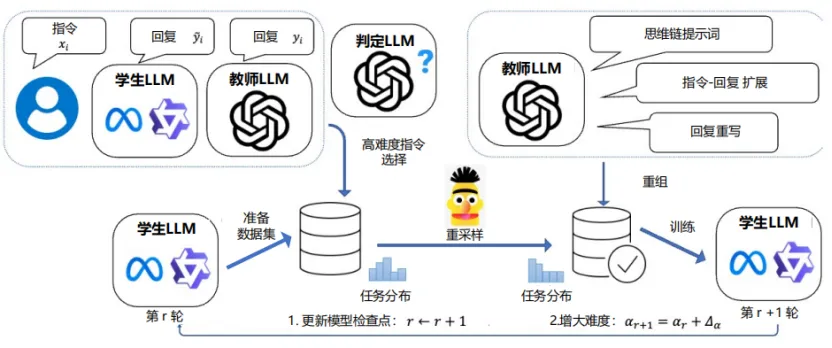
▲图 | 自蒸馏就像酿酒,越酿越浓体积越小但更浓郁©【深蓝具身智能】编译
iBOT 掩码预测
在自蒸馏之外,iBOT 模块会随机遮盖图片里一部分 patch,要求模型根据剩下可见 patch,预测被遮盖 patch 对应的特征。这个过程类似完形填空,迫使模型主动学习物体局部结构、边缘连续性和物体部件之间的关联,而不是只记住表面颜色纹理。这也是 DINOv3 密集patch token能够捕捉曲面、轮廓这类几何信息的关键。
KoLeo 特征扩散、Gram 锚定损失
KoLeo 特征扩散和 Gram 锚定损失进一步约束特征空间,解决DINOv2存在的问题:当图像分辨率拉高之后,密集patch特征容易出现退化,不同空间位置的 patch 特征变得趋同,丢失空间区分能力。
通过这两项约束,DINOv3在高分辨率输入下依旧能保持每个patch 特征的独特性,相邻但属于不同物体的 patch 不会轻易混在一起。
轴向旋转位置编码(轴向 RoPE)
网络结构层面,DINOv3 使用轴向旋转位置编码(轴向 RoPE),替代早期 DINO 系列使用的可学习绝对位置编码。绝对位置编码是一组固定数字,图片尺寸一旦改变就会失效。
轴向 RoPE 则是在计算注意力的时候,直接把 patch 的空间坐标信息旋转嵌入到特征向量内部。不管输入图片尺寸怎么调整,模型都能理解每一个 patch 在画面里的相对位置。
这一特性对机器人任务非常重要:机载相机画面的远近和裁剪范围经常变化,RoPE 保证空间信息稳定,也支撑了最高 4096×4096 的输入。
推理
模型前向推理阶段,也就是我们输入桌面照片得到 patch token 的过程,不再进行训练更新权重。输入图片按固定 16 像素切分成 patch,每一块 patch 先做线性投影,转成固定维度向量,再送入多层 Transformer。Transformer 依靠多头注意力机制,让每一个 patch 都可以和画面内其他所有 patch 互相交换信息:杯身 patch 会和相邻的轮廓 patch、桌面 patch 产生交互,理解物体和背景的边界关系。
最后输出两类结果:代表整张图片摘要的 class token,以及保留空间网格结构的全部 patch token。
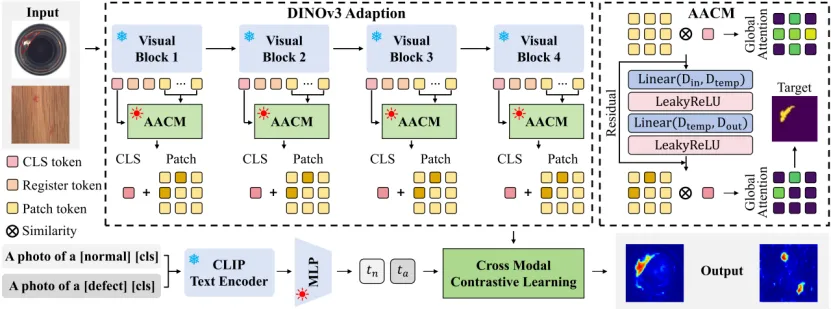
▲图 | DINOv3结构图,其中AACM是AD-DINOv3框架中提出异常感知校准模块(Anomaly-Aware Calibration Module)©【深蓝具身智能】编译
DINOv3最核心特性是密集语义表征,也就是图像被切分为 16×16 的 patch,每个 patch 独立输出特征向量。这些向量优先编码物体形状、曲面、轮廓、部件相对位置这类结构信息,弱化颜色、光照、纹理变化带来的干扰。
这带来一种异于传统监督训练模型的性质——结构不变性。
光照明暗变化、物体表面纹理磨损,只要物体本身几何结构不变,patch 特征相似度就能维持稳定。当物体被抓取、推动,局部几何结构发生改变时,对应的 patch 向量也会随之变化。
这种 “结构不变、交互变化敏感” 的特性,正好满足机器人持续感知环境状态变化的需求。
DINOv3如何解决具身智能痛点
具身智能核心是感知 - 推理 - 动作闭环。DINOv3 恰好对准了四个传统痛点:
真实机器人数据采集成本高。
物体抓取位姿、交互状态标注工作量巨大,仿真数据和真实场景存在域间差异,仿真训练的策略直接部署到实体机器人容易失效。
DINOv3 依托海量互联网无标注图片预先学习通用空间结构知识,骨干权重可以冻结,仅需要少量机器人交互数据微调任务头,减少演示轨迹的需求量,提升模型跨场景泛化能力。
像素空间存在信息冗余。
早期世界模型直接预测未来帧 RGB 图像,模型大量算力消耗在渲染无关纹理细节。机器人真正关心的只有物体位置、姿态变化,不需要逼真画面。
DINOv3 提供语义潜空间,世界模型不再预测像素图,转而预测 DINOv3 特征的变化,把算力集中建模物体交互与状态变迁,降低计算开销,提升物理因果推理能力。
视觉分布偏移问题。
机器人工作场景光照、桌面背景、物体颜色经常变动,基于监督学习的 ResNet 等模型容易被颜色、纹理干扰。DINOv3 学习优先提取物体结构信息,弱化颜色纹理带来的影响,光照和背景变化时特征依旧稳定,提升零样本迁移能力。
空间位置建模需求。
机器人抓取、导航都依赖空间定位。轴向 RoPE 让 DINOv3 的 patch token 自带空间坐标关联,输出的密集特征图可以映射回原图,方便后续网络完成障碍物分割、抓取点检测。
DINOv3 在具身智能中的典型应用方向
视觉动作策略(操作机器人)
视觉动作策略接收相机图像与机器人本体感知数据,输出机器人关节动作序列。
DINOv3-Diffusion Policy 是代表性方案
使用冻结或微调后的 DINOv3 作为 Diffusion Policy 的视觉编码器,在 Push-T、Lift、Can、Square 等机器人操作基准任务上对比 ResNet 编码器,部分任务成功率最高提升约 10%。消融实验证明,即使冻结 DINOv3 骨干权重,密集特征依旧具备优秀迁移能力,提升扩散策略的样本效率与鲁棒性。
在抓取检测任务中,ViT-B/16 作为骨干,搭配反卷积上采样任务头,可以输出逐像素抓取置信度、抓取角度、抓取宽度图。仅依靠单张 RGB 图像就可以预测抓取位姿,用于机械臂规划,在桌面物体操作场景稳定实现厘米级对位操作。
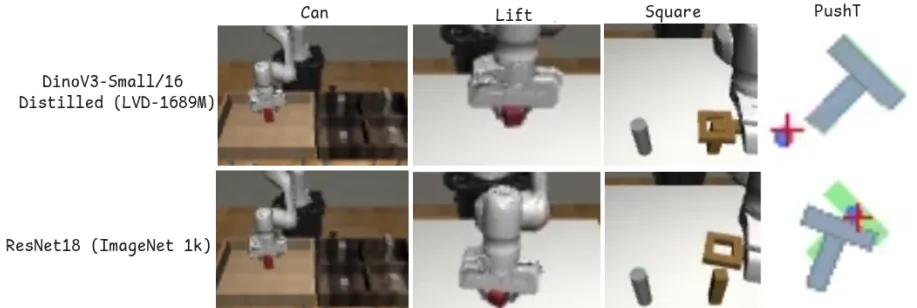
▲图 | 从10,000次优化步骤的模拟滚动中可以看出,DINOv3模型始终比ResNet18变体更快、更简洁。©【深蓝具身智能】编译
隐空间世界模型(World Model)
世界模型是具身智能的重要分支,目标是让机器人在脑中 “推演” 执行动作后的环境变化,用于动作预规划和风险评估。近来很多世界模型不再以 RGB 图像作为预测目标,而是选用 DINOv3 特征空间。
CLWM(DexWorldModel) 因果隐空间世界模型是这一路线的代表:以 DINOv3 特征为生成目标,把交互语义与视觉噪声解耦。
LiLa-WAM 则证明了这条路线的轻量可行性:
冻结 DINOv3 提取视觉潜特征,学习动作到特征变化的因果模型。模型预测下一时刻 DINOv3 密集特征图,推演物体被推动、抓取之后的状态变化,而不是生成图片。这种方式剥离无关纹理噪声,降低了计算量。
世界模型场景大多只需要物体大致位置与状态变化趋势,不需要像素级高精度对位,原生 DINOv3 密集 patch 特征就可以满足需求。
机器人视觉导航
图像目标导航任务要求机器人根据一张目标参考图像,在未知环境移动到目标位置,属于粗定位任务,DINOv3 的场景布局与几何特征正好够用。
▲图 | 机器人在判定不同目标,来自网络©【深蓝具身智能】编译
AstraNav-Memory 的思路极具代表性
该方案在冻结 DINOv3 基础上增加轻量 token 压缩模块,压缩视觉特征,把多帧历史场景信息存入大语言模型上下文窗口,构建长期场景记忆。不需要构建显式地图,将感知、记忆、语言指令、决策整合为端到端系统。
视觉 - 语言具身智能
DINOv3 密集patch token可以和视觉语言模型(VLM)结合。DINOv3 负责提取细粒度空间物体特征,VLM 负责高层语义理解,解析人类自然语言指令。DINOv3 输出的 patch token 送入多模态大模型,机器人可以理解 “把红色杯子放到抽屉里” 这类开放式指令,同时定位目标物体。
这类场景一般为粗定位,只需要找到目标物体所在区域。
当前局限
DINOv3 为机器人视觉感知带来显著提升,但也不是万能的,仍然存在明显短板。
原生 DINOv3 属于 2D 视觉表征,不具备显式三维几何建模能力。
虽然特征隐含部分深度、空间结构信息,但不是严格三维重建。遇到物体遮挡、多层物体堆叠场景,单张 RGB 输入会产生空间歧义,通常需要搭配深度相机或者多视图融合。即便任务头实现 2D 像素级对位,也不能直接换算真实三维空间坐标。
大尺寸 DINOv3(ViT-7B)推理开销大。
人形机器人、移动机器人机载边缘算力有限,7B 版本很难实时运行,工程落地一般选用 ViT-B/16、ViT-L/16,代价是特征性能下降。模型轻量化、量化、稀疏注意力是重要优化方向。
DINOv3 预训练数据以互联网静态图片为主,缺少机器人动态交互数据。
模型擅长静态物体、场景结构识别,但对物体摩擦、碰撞、软体形变这类物理动态规律没有先天认知。世界模型需要额外机器人交互数据集,在 DINOv3 特征空间学习物理变化规则。
极端场景容易失效。
透明物体、镜面反射这类样本在预训练数据中占比很低,这类物体对应的 patch 特征容易发生漂移,需要在线自适应调整
总结
作为具身智能的“标配视觉底座”,DINOv3 提供了一套低成本、高鲁棒、带空间信息的通用视觉描述语言:
机器人不必为每类物体单独训练识别模型,也不必耗费算力渲染像素,而是在特征空间分析物体状态变化。
它已成为机器人操作、导航、世界模型研究的主流视觉骨干,但只是感知层的基础组件,完整系统还需要时序记忆、因果推理、物理动力学与运动控制的协同。
原生特征只能判断大致位置;挂任务头可实现图像平面内的 2D 精确对位;三维空间的高精度对位必须额外搭配深度或三维感知模块。
随着轻量化、时序建模与三维融合的推进,基于这类自监督表征的机器人方案,有望从仿真实验逐步走向真实场景落地。
编辑|咖啡鱼
审编|具身君
来源:深蓝具身智能