值得关注的研究主题
今年的会议日程中贯穿着以下几个研究方向:
VLA 与生成式策略的 RL 微调。这是 LLM 领域 RLVR/GRPO 研究在机器人领域的对应方向。可以从 RL Token、EXPO-FT 和 Flow Policy Gradients 开始,再阅读研究机群规模 RL 的 Learning While Deploying,以及对 VLM 推理器进行 RL 训练的 Training Robots to Reason in Natural Language。
世界动作模型。这类策略建立在视频扩散骨干网络之上,能够在预测动作的同时预测未来。可以从 DreamZero(World Action Models are Zero-shot Policies)开始,再阅读 TAPESTRY、W2A 和 FACT;其中,FACT 让模型学习错误动作会造成什么后果。
将世界模型作为 RL 的仿真器。SafeDojo、WoVR 和 MERL 都试图使基于想象 rollout 的 RL 更加可信;Training Controllable World Models 则展示了为什么在成功数据上训练的世界模型会忽略动作。
大规模人类视频。EgoScale 发现了一条适用于第一视角人类数据的对数线性 Scaling Law;Ego2Robot 和 Being-H0.5 将数万小时的人类数据用于 VLA 预训练。LAPT-Scale 和 ELA 则从视频中学习潜在动作。
进度奖励。WARP-RM、TOPReward 和 RARM 均可在不依赖手工设计奖励的情况下,产生稠密的任务进度信号。
这份清单是如何制作的
我使用一个反映个人研究兴趣的模型对论文进行排序,再对排名靠前的论文进行分组和概述。
我从全部 687 篇被接收的论文及其标题和摘要出发。
模型仅使用我个人的数据进行训练:我的已发表论文,以及过去六个月中我添加到个人文献库的论文。模型将这些论文与近期 arXiv 论文和 CoRL 会议论文作为背景进行对比,使每篇论文都能与一篇典型的 CoRL 论文进行比较。该模型结合了 arXiv Sanity 风格的线性支持向量机(SVM)和 TPMS 风格的相关性,即经典的审稿人匹配分数。
排名前 101 的论文构成了这份清单,并按排名分为 P0、P1 和 P2。随后,我按主题对论文进行分类,并使用 LLM 根据摘要起草每篇论文的一句话概述。
清单中的每篇论文都链接到其 OpenReview 页面,页面上可以找到论文 PDF。如果你正在 Austin 参加 CoRL 2026,并且研究兴趣与这些方向有所重叠,希望这份清单能为你节省一些筛选时间。
信息来源
CoRL 2026 接收论文:会议官方日程,提供论文标题、OpenReview 链接、Oral 和 Spotlight 场次,以及海报场次和编号。
CoRL 2026 论文清单:由社区维护,包含每篇被接收论文的作者和摘要,并通过 OpenReview ID 与会议日程进行匹配。
CoRL 2026 Workshop 日程:提供 Workshop 的时间和地点。
关于筛选的一点说明:这份清单基于我个人的研究兴趣,而非对论文质量的评判。CoRL 2026 的各个方向都有优秀论文,许多出色的工作没有出现在这里,仅仅是因为它们不属于我所在研究组的研究领域。
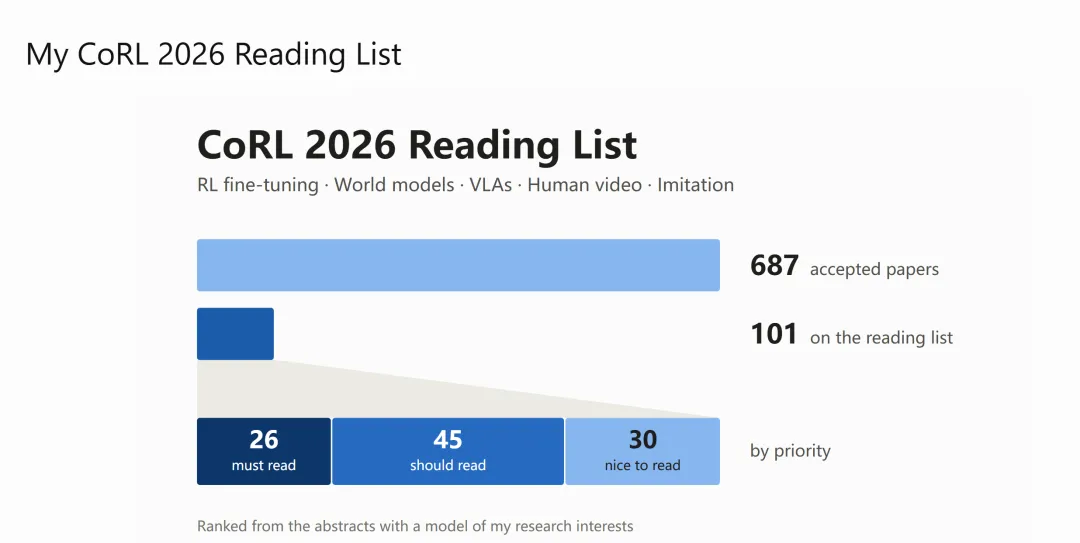
从 CoRL 2026 接收的 687 篇论文中筛选出 101 篇,列入阅读清单:其中 26 篇必读、45 篇应读、30 篇有余力可读。
在 Austin 举办的 CoRL 2026 共接收了 687 篇论文。没有人能把它们全部读完,因此我根据所在研究组的研究方向对论文进行了排序,保留了排名前 101 的论文。这些方向包括:机器人策略的 RL 微调、世界模型与世界动作模型、VLA、从人类视频中学习,以及模仿学习。我在这里分享这份清单,希望能对参加会议的其他人有所帮助。
论文被分为 P0(必读,26 篇)、P1(应读,45 篇)和 P2(有余力可读,30 篇)。每个条目都包含一段根据摘要撰写的一句话概述、论文的 OpenReview 链接、该论文的 Oral 或 Spotlight 报告信息,以及海报信息:海报场次、编号和展厅。
Oral 和 Spotlight 报告在 Hilton Austin 举行。海报场次在 JW Marriott 举行:1–116 号海报位于 Lone Star 展厅(3 楼),117–232 号海报位于 Griffin 展厅(2 楼)。
清单中有 11 篇 Oral 论文和 13 篇 Spotlight 论文。周一的场次已经结束,但所有论文都可以在 OpenReview 上找到。
可以下载 BibTeX 格式的清单,并导入 Paperpile、Zotero、Mendeley 或其他文献管理器:全部 101 篇论文、P0 必读论文、P1 应读论文、P2 有余力可读论文。每个条目都包含摘要、OpenReview 链接、arXiv ID(如有),以及报告场次和海报的详细信息。
P0——必读
VLA 与生成式策略的 RL 微调
EXPO-FT: Sample-Efficient Reinforcement Learning Finetuning for Vision-Language-Action Models
作者:Dong、Hung、Gao 等
OpenReview
海报场次 1,98 号海报:11 月 9 日周一下午 5:00–6:30,JW Marriott,Lone Star 展厅(3 楼)
对预训练 VLA 进行稳定、样本效率高的真实世界 RL 微调,使其在高难度操作任务中达到可部署水平的成功率。
Flow Policy Gradients for Robot Control
作者:Yi、Choi、Singh 等
OpenReview
Oral O4:11 月 10 日周二上午 9:00–9:30,Hilton Austin
海报场次 2,63 号海报:11 月 10 日周二下午 5:00–6:30,JW Marriott,Lone Star 展厅(3 楼)
使 Flow Matching 策略梯度能够实际用于训练表达能力强的策略,既支持从头训练,也支持微调,并在两个 Humanoid 上实现 Sim-to-Real 迁移。
RL Token: Bootstrapping Online RL with Vision-Language-Action Models
作者:Xu、Springenberg、Equi 等
OpenReview
Oral O4:11 月 10 日周二上午 9:00–9:30,Hilton Austin
海报场次 2,64 号海报:11 月 10 日周二下午 5:00–6:30,JW Marriott,Lone Star 展厅(3 楼)
从 VLA 中提取紧凑的“RL token”,并以 VLA 为锚点,在该 token 上训练一个小型 Actor-Critic 模型,实现小时级的真实世界 RL。
Scaling Sim-to-Real VLA Reinforcement Learning with Generative 3D Worlds
作者:Choi、Wang、Su 等
OpenReview
海报场次 1,99 号海报:11 月 9 日周一下午 5:00–6:30,JW Marriott,Lone Star 展厅(3 楼)
在生成的多样化 3D 仿真场景中对 VLA 进行 RL 微调,避免真实世界 RL 中的场景过拟合,并实现 Sim-to-Real 迁移。
RoboFFT: Finetuning generative robot policy via online reinforcement learning with forward process
作者:Li、Hu、Wang 等
OpenReview
海报场次 3,66 号海报:11 月 11 日周三上午 10:30–中午 12:00,JW Marriott,Lone Star 展厅(3 楼)
通过前向加噪过程和策略比率的加权 Flow Matching 代理目标,对扩散策略和 Flow 策略进行在线 RL 微调。
RL 算法与探索
Learning Object Manipulation from Scratch via Contrastive Interaction
作者:Shen、Chuck、Feng 等
OpenReview
海报场次 1,138 号海报:11 月 9 日周一下午 5:00–6:30,JW Marriott,Griffin 展厅(2 楼)
研究表明,交互引起的模式变化会使对比式 RL 在操作任务中失效;通过交互加权重采样解决这一问题,实现从头学习。
Efficient On-policy Visual-RL via Stochastic Decoupled Policy Gradient
作者:You、Liu、Zong 等
OpenReview
海报场次 3,61 号海报:11 月 11 日周三上午 10:30–中午 12:00,JW Marriott,Lone Star 展厅(3 楼)
一种 On-policy 视觉 RL 方法,通过带扰动的 rollout 估计策略梯度,在单张 GPU 上用数小时训练视觉运动策略,并实现 Sim-to-Real 迁移。
FlashRFCL: Demonstration-Efficient Sparse Reward RL via Reverse-Forward Curriculum Learning in High-Throughput GPU Simulation
作者:Choi、Tao、Christensen
OpenReview
海报场次 1,96 号海报:11 月 9 日周一下午 5:00–6:30,JW Marriott,Lone Star 展厅(3 楼)
结合反向—正向课程学习和高吞吐量 GPU 仿真,仅使用一条示范实现稀疏奖励 RL。
Play2Perfect: What Matters in Dexterous Play Pretraining for Precise Assembly?
作者:Lum、Kedia、Liu 等
OpenReview
Oral O5:11 月 10 日周二上午 10:30–11:00,Hilton Austin
海报场次 2,126 号海报:11 月 10 日周二下午 5:00–6:30,JW Marriott,Griffin 展厅(2 楼)
针对多指手进行与任务无关的 RL 探索预训练,并研究探索过程中的哪些因素对精密装配至关重要。
Learning Loco-Manipulation From SMPC Demonstrations With Sparse Offline-to-Online RL
作者:Schuck、Sorokin、Manni 等
OpenReview
Spotlight S7:11 月 11 日周三上午 9:00–9:30,Hilton Austin
海报场次 3,201 号海报:11 月 11 日周三上午 10:30–中午 12:00,JW Marriott,Griffin 展厅(2 楼)
通过仿真中基于采样的模型预测控制(MPC)生成离线数据,使 Off-policy RL 能够仅依靠稀疏奖励学习移动操作,无需奖励塑形。
HARBOR: A Harness Framework for Agentic Robot Reinforcement Learning
作者:Li、Jin、Liu 等
OpenReview
海报场次 1,106 号海报:11 月 9 日周一下午 5:00–6:30,JW Marriott,Lone Star 展厅(3 楼)
一个面向 Agent 的 Harness 框架,可自动化机器人 RL 工作流,涵盖环境设置、奖励设计、调参和 Sim-to-Real 训练。
世界模型与世界动作模型
SafeDojo: Safe Reinforcement Learning for VLA via Interactive World Model
作者:Tang、Jia、Chu 等
OpenReview
海报场次 3,28 号海报:11 月 11 日周三上午 10:30–中午 12:00,JW Marriott,Lone Star 展厅(3 楼)
在交互式视频世界模型中,对 VLA 进行基于模型的安全 RL,使用想象得到的进度奖励和一个学习得到的安全预测头。
Large Video Planner Enables Generalizable Robot Control
作者:Chen、Zhang、Geng 等
OpenReview
海报场次 1,57 号海报:11 月 9 日周一下午 5:00–6:30,JW Marriott,Lone Star 展厅(3 楼)
一个基于互联网规模视频预训练而非 VLM 构建的机器人基础模型,在视频空间中进行规划,并泛化到新任务。
World Action Models are Zero-shot Policies
作者:Ye、Ge、Zheng 等
OpenReview
Oral O2:11 月 9 日周一上午 11:00–11:30,Hilton Austin
海报场次 1,51 号海报:11 月 9 日周一下午 5:00–6:30,JW Marriott,Lone Star 展厅(3 楼)
DreamZero 是一个基于视频扩散骨干网络的世界动作模型,能够联合预测视频和动作,在新任务上的泛化能力达到 VLA 的两倍。
VLA 与通用策略
Improving Robotic Generalist Policies via Flow Reversal Steering
作者:Tang、Chen、Wagenmaker 等
OpenReview
海报场次 2,39 号海报:11 月 10 日周二下午 5:00–6:30,JW Marriott,Lone Star 展厅(3 楼)
将次优动作反演为其潜在噪声,再将其映射到 Flow Matching 通用策略附近的其他模式,引导策略产生更好的行为。
RoboTTT: Context Scaling for Robot Policies
作者:Jiang、Chebotar、Zheng 等
OpenReview
Oral O1:11 月 9 日周一上午 10:30–11:00,Hilton Austin
海报场次 1,47 号海报:11 月 9 日周一下午 5:00–6:30,JW Marriott,Lone Star 展厅(3 楼)
测试时训练将策略上下文扩展至 8K 个时间步,且不引入额外延迟,使策略能够从人类视频中进行上下文内模仿并实现自我改进。
从人类视频中学习
LAPT-Scale: Scaling Embodied Policies with Latent Action Pre-Training on Human Videos
作者:Xiang、Liu、Li 等
OpenReview
海报场次 2,60 号海报:11 月 10 日周二下午 5:00–6:30,JW Marriott,Lone Star 展厅(3 楼)
利用第一视角人类视频上的连续潜在动作模型,为 VLA 提供预训练监督,随后进行本体对齐和后训练。
ELA: End-to-End Latent Action Policy Learning from Video Demonstrations
作者:Hsu、Stone
OpenReview
海报场次 1,16 号海报:11 月 9 日周一下午 5:00–6:30,JW Marriott,Lone Star 展厅(3 楼)
联合训练潜在动作模型、潜在策略和动作解码器,使从视频示范中学习到的潜在动作针对控制目标进行优化。
EgoScale: Scaling Dexterous Manipulation with Diverse Egocentric Human Data
作者:Zheng、Niu、Xie 等
OpenReview
Oral O5:11 月 10 日周二上午 10:30–11:00,Hilton Austin
海报场次 2,54 号海报:11 月 10 日周二下午 5:00–6:30,JW Marriott,Lone Star 展厅(3 楼)
使用 20,854 小时第一视角人类视频训练 VLA;研究发现,一条对数线性 Scaling Law 可以预测真实灵巧操作机器人的性能。
EgoEngine: From Egocentric Human Videos to High-Fidelity Dexterous Robot Demonstrations
作者:Liu、Cheng、Yin 等
OpenReview
海报场次 2,57 号海报:11 月 10 日周二下午 5:00–6:30,JW Marriott,Lone Star 展厅(3 楼)
将第一视角人类视频转换为机器人观测视频和可执行的灵巧动作轨迹,用于策略训练。
Imitation from Heterogeneous Demonstrations using Grounded Latent-Action World Models
作者:Wang、Lei、Watson 等
OpenReview
海报场次 3,30 号海报:11 月 11 日周三上午 10:30–中午 12:00,JW Marriott,Lone Star 展厅(3 楼)
通过潜在动作世界模型将动作锚定到预测过程中,使包含部分无动作标注数据在内的异构数据共享同一种动作表示。
模仿学习与数据质量
Scalable Behavior Cloning with Open Data, Training, and Evaluation
作者:Allshire、Singh、Singh 等
OpenReview
海报场次 1,113 号海报:11 月 9 日周一下午 5:00–6:30,JW Marriott,Lone Star 展厅(3 楼)
一套完全开源的行为克隆技术栈,包括 3,500 小时双臂遥操作数据、硬件、训练,以及对 DiT 和 VLA 训练方案进行相关性分析的仿真与真实评测。
奖励与进度模型
Online World Modeling Enables Real-World Inverse Reinforcement Learning from Observation
作者:Han、Nemekhbold、Shen 等
OpenReview
海报场次 3,32 号海报:11 月 11 日周三上午 10:30–中午 12:00,JW Marriott,Lone Star 展厅(3 楼)
首次在真实世界中仅从观测进行逆向 RL:只使用视频,不使用动作或奖励,通过在线世界模型从头学习视觉操作。
跨本体与机器人设计
Morphology-Conditioned World Model for Cross-Embodiment Quadrupedal Locomotion
作者:Danesh、Li、Abyaneh 等
OpenReview
海报场次 3,156 号海报:11 月 11 日周三上午 10:30–中午 12:00,JW Marriott,Griffin 展厅(2 楼)
以尺度不变的形态特征作为条件,构建一个世界模型并在其中训练策略,使策略能够零样本迁移到未见过的四足机器人。
Shape Your Body: Value Gradients for Multi-Embodiment Robot Design
作者:Bohlinger、Peters
OpenReview
Spotlight S5:11 月 10 日周二下午 2:30–3:00,Hilton Austin
海报场次 2,115 号海报:11 月 10 日周二下午 5:00–6:30,JW Marriott,Lone Star 展厅(3 楼)
训练一个多本体价值函数,再将其梯度作为可微分的代理信号优化机器人设计,无需重新运行 RL 训练循环。
MorFiC: Fixing Value Miscalibration for Zero-Shot Quadruped Transfer
作者:Mishra、Raj、Xiao 等
OpenReview
海报场次 3,155 号海报:11 月 11 日周三上午 10:30–中午 12:00,JW Marriott,Griffin 展厅(2 楼)
共享 Critic 会对不同四足机器人形态之间不相容的价值目标取平均;修正由此产生的价值估计校准偏差,即可实现零样本迁移。
P1——应读
VLA 与生成式策略的 RL 微调
Training Robots to Reason in Natural Language via Reinforcement Learning
作者:Wu、Qu、Hu 等
OpenReview
海报场次 1,101 号海报:11 月 9 日周一下午 5:00–6:30,JW Marriott,Lone Star 展厅(3 楼)
训练 VLM 使用自然语言进行推理,以引导底层操作策略:先进行推理轨迹中期训练,再进行 RL 后训练。
Optimal Transport Q-Learning for Flow Policy Steering and Acceleration
作者:Sochopoulos、Whitammer、Tsagkas 等
OpenReview
海报场次 3,67 号海报:11 月 11 日周三上午 10:30–中午 12:00,JW Marriott,Lone Star 展厅(3 楼)
使用优势加权的条件最优传输 Flow Matching,对次优 Flow 策略进行 RL 微调和加速。
Learning While Deploying: Fleet-Scale Reinforcement Learning for Generalist Robot Policies
作者:Wang、Li、Xie 等
OpenReview
海报场次 1,85 号海报:11 月 9 日周一下午 5:00–6:30,JW Marriott,Lone Star 展厅(3 楼)
利用自主 rollout 和人类干预数据,通过机群规模的 Offline-to-Online RL 持续后训练通用 VLA。
X-NavDP: Generalizing Navigation Diffusion Policy to Novel Behavior and Embodiments with Group Q-score Reweighted Matching
作者:Yang、Zeng、Cai 等
OpenReview
海报场次 1,174 号海报:11 月 9 日周一下午 5:00–6:30,JW Marriott,Griffin 展厅(2 楼)
使用基于组 Q 分数重新加权的匹配方法,对导航扩散策略进行 RL 后训练,使其能够泛化到新的机器人本体和行为。
RL 算法与探索
A Balanced Data Diet: Addressing the Exploration Bottleneck in Mega-Scale RL for Robot Control
作者:Zhang、Castro、Yin 等
OpenReview
海报场次 1,105 号海报:11 月 9 日周一下午 5:00–6:30,JW Marriott,Lone Star 展厅(3 楼)
基于成功情况对重置配置进行引导采样,使超大规模并行 RL 始终处于能力边界,从而让回报持续随规模增长。
Combining Constrained Sampling and Reinforcement Learning for Manipulation
作者:Toussaint、Braun、Jordana 等
OpenReview
Spotlight S4:11 月 10 日周二下午 2:00–2:30,Hilton Austin
海报场次 2,167 号海报:11 月 10 日周二下午 5:00–6:30,JW Marriott,Griffin 展厅(2 楼)
在受约束流形上采样状态用于环境重置,增强目标条件 RL 在接触丰富的非抓取操作任务中的探索能力。
Emergent Control via Prior-Based Free Energy Minimization
作者:Kolachalam、Malhotra
OpenReview
Spotlight S6:11 月 11 日周三上午 8:30–9:00,Hilton Austin
海报场次 3,72 号海报:11 月 11 日周三上午 10:30–中午 12:00,JW Marriott,Lone Star 展厅(3 楼)
通过最小化状态与期望状态先验之间的偏离,即自由能,实现控制,而非最大化奖励;同时涵盖基于模型和无模型的方法。
世界模型与世界动作模型
Trust-Calibrated VLA Policy Post-Training with Evolving Imagination
作者:Li、Qin、Zhou 等
OpenReview
海报场次 1,35 号海报:11 月 9 日周一下午 5:00–6:30,JW Marriott,Lone Star 展厅(3 楼)
使用持续更新的世界模型和奖励预测头,对 VLA 进行 RL 后训练,并根据信任程度按比例使用想象得到的 rollout。
Chunk-wise Model-based Policy Optimization
作者:Song、Wang、Li
OpenReview
Spotlight S2:11 月 9 日周一下午 2:30–3:00,Hilton Austin
海报场次 1,109 号海报:11 月 9 日周一下午 5:00–6:30,JW Marriott,Lone Star 展厅(3 楼)
一种基于模型的 RL 方法,使用以动作块为单位的世界模型作为分块 Actor 的可微分评估器,避免循环 rollout 和通过时间反向传播(BPTT)。
Training Controllable World Models via Action Influence Maximization
作者:Bateman、Yin、Zheng 等
OpenReview
海报场次 3,37 号海报:11 月 11 日周三上午 10:30–中午 12:00,JW Marriott,Lone Star 展厅(3 楼)
仅在成功轨迹上训练的世界模型会忽略动作;通过动作影响力(Empowerment)目标恢复模型的可控性。
WoVR: World Models as Reliable Simulators for Post-Training VLA Policies with RL
作者:Jiang、Zhou、Jiang 等
OpenReview
海报场次 3,25 号海报:11 月 11 日周三上午 10:30–中午 12:00,JW Marriott,Lone Star 展厅(3 楼)
通过约束策略使用不完美想象 rollout 的方式,使基于世界模型的 VLA RL 训练更加可靠。
Coupled Local and Global World Models for Efficient First Order RL
作者:Amigo、Khorrambakht、Mansard 等
OpenReview
海报场次 3,27 号海报:11 月 11 日周三上午 10:30–中午 12:00,JW Marriott,Lone Star 展厅(3 楼)
一种一阶 RL 方法:使用大型世界模型进行前向 rollout,使用轻量级潜在空间代理模型计算梯度,并应用于真实机器人。
PlayWorld: Learning Robot World Models from Autonomous Play Data
作者:Yin、Mei、Zheng 等
OpenReview
海报场次 3,26 号海报:11 月 11 日周三上午 10:30–中午 12:00,JW Marriott,Lone Star 展厅(3 楼)
使用自主探索数据训练机器人世界模型,相比使用示范数据或策略 rollout 训练,能够减少接触幻觉。
Hierarchical Planning with Latent World Models
作者:Zhang、Terver、Zholus 等
OpenReview
海报场次 3,1 号海报:11 月 11 日周三上午 10:30–中午 12:00,JW Marriott,Lone Star 展厅(3 楼)
基于在多个时间尺度上学习到的视觉潜在世界模型进行分层 MPC,实现长时程零样本控制。
Light-WAM: Efficient World Action Models with State-Fusion Action Decoding
作者:Li、Cheng、Wang 等
OpenReview
海报场次 1,55 号海报:11 月 9 日周一下午 5:00–6:30,JW Marriott,Lone Star 展厅(3 楼)
一种轻量级世界动作模型,利用未来视频的潜在表示进行监督,并使用状态融合 Action Expert,实现高效的闭环控制。
PLaW-VLA: Predictive Latent World Modeling for Vision-Language-Action Policies
作者:Liu、Guo、Huang 等
OpenReview
海报场次 3,2 号海报:11 月 11 日周三上午 10:30–中午 12:00,JW Marriott,Lone Star 展厅(3 楼)
一种 VLA,在预训练潜在空间中预测未来世界状态,而非预测像素;整个过程在一个 Mixture-of-Transformers 中完成。
VLA 与通用策略
ELASTIC: Efficiently Learning to Adaptively Scale Test-Time Compute for Generative Control Policies
作者:Li、Swamy、Bisk 等
OpenReview
海报场次 2,3 号海报:11 月 10 日周二下午 5:00–6:30,JW Marriott,Lone Star 展厅(3 楼)
针对扩散和 Flow VLA 策略,为每个状态学习如何在增加去噪步数和增加并行采样数量之间分配测试时计算量。
MAESTRO: Orchestrating Robotics Modules with Coding Agents for Zero-Shot Generalist Robots
作者:Shi、Yang、Chao 等
OpenReview
海报场次 1,203 号海报:11 月 9 日周一下午 5:00–6:30,JW Marriott,Griffin 展厅(2 楼)
使用 VLM 编程 Agent 协调感知、规划和控制工具,无需新的遥操作数据,即可在零样本条件下达到与 VLA 相当的表现。
OmniGuide: Universal Spatial Guidance Fields for Enhancing Generalist Robot Policies
作者:Song、Le、Park 等
OpenReview
海报场次 1,32 号海报:11 月 9 日周一下午 5:00–6:30,JW Marriott,Lone Star 展厅(3 楼)
将 3D、语义和人体姿态引导表示为可微分能量场,在测试时引导 VLA 的动作采样。
PRTS: A Primitive Reasoning and Tasking System via Contrastive Representations
作者:Zhang、Zhao、Fan 等
OpenReview
Spotlight S1:11 月 9 日周一上午 9:00–9:30,Hilton Austin
海报场次 1,14 号海报:11 月 9 日周一下午 5:00–6:30,JW Marriott,Lone Star 展厅(3 楼)
将 VLA 预训练构建为目标条件对比式 RL:语言目标与状态—动作共享一个近似表示目标占据概率的嵌入空间。
FTP-1: A Generalist Foundation Tactile Policy Across Tactile Sensors for Contact-Rich Manipulation
作者:Yuan、Zhang、Zhou 等
OpenReview
海报场次 2,142 号海报:11 月 10 日周二下午 5:00–6:30,JW Marriott,Griffin 展厅(2 楼)
一种通用触觉策略,在来自 21 种传感器的 3,000 小时数据上预训练,并使用形态感知 token 实现跨传感器迁移。
Being-H0.5: Scaling Human-Centric Robot Learning for Cross-Embodiment Generalization
作者:Luo、Wang、Zhang 等
OpenReview
Oral O1:11 月 9 日周一上午 10:30–11:00,Hilton Austin
海报场次 1,67 号海报:11 月 9 日周一下午 5:00–6:30,JW Marriott,Lone Star 展厅(3 楼)
一种以人为中心的跨本体 VLA,在来自人类和 30 台机器人的 35,000 小时数据上预训练,并使用统一动作空间。
MolmoAct2: Action Reasoning Models for Real-World Deployment
作者:Fang、Duan、Clay 等
OpenReview
Spotlight S1:11 月 9 日周一上午 9:00–9:30,Hilton Austin
海报场次 1,28 号海报:11 月 9 日周一下午 5:00–6:30,JW Marriott,Lone Star 展厅(3 楼)
一个为实际部署构建的完全开源动作推理 VLA,包括具身推理 VLM 骨干网络、新数据集和低成本平台。
π0.7: a Steerable Generalist Robotic Foundation Model with Emergent Capabilities
作者:Ai、Amin、Aniceto 等
OpenReview
Oral O1:11 月 9 日周一上午 10:30–11:00,Hilton Austin
海报场次 1,63 号海报:11 月 9 日周一下午 5:00–6:30,JW Marriott,Lone Star 展厅(3 楼)
π0.7 使用多样化的上下文条件,包括策略、元数据和子目标图像,使通用模型可被引导,并能够利用次优数据。
从人类视频中学习
Ego2Robot: Scalable Robot Data Synthesis from Egocentric Human Data
作者:Wang、Lin、Chen 等
OpenReview
Spotlight S3:11 月 10 日周二上午 8:30–9:00,Hilton Austin
海报场次 2,55 号海报:11 月 10 日周二下午 5:00–6:30,JW Marriott,Lone Star 展厅(3 楼)
将第一视角人类视频转换为涵盖 15 种本体形态的 18,561 小时机器人数据,用于大规模 VLA 预训练。
Monkey See, Can Monkey Do? A Benchmark for Evaluating Robot Skill Learning by Observation
作者:Gu、Gupta、Sah 等
OpenReview
海报场次 2,106 号海报:11 月 10 日周二下午 5:00–6:30,JW Marriott,Lone Star 展厅(3 楼)
RoboReel 是一个统一的真实世界 Benchmark,用于评估从人类视频中学习的策略。
Counterfactual Video Generation Enables Scalable Humanoid Loco-Manipulation
作者:Wang、Wu、Abbeel 等
OpenReview
海报场次 2,184 号海报:11 月 10 日周二下午 5:00–6:30,JW Marriott,Griffin 展厅(2 楼)
将少量人类视频扩充为大量反事实交互视频,再通过 Real-to-Sim 进行动作重定向,用于训练 Humanoid 的移动操作能力。
WAM-TTT: Steering World-Action Models by Watching Human Play at Test Time
作者:Feng、Han、Lyu 等
OpenReview
海报场次 3,7 号海报:11 月 11 日周三上午 10:30–中午 12:00,JW Marriott,Lone Star 展厅(3 楼)
在测试时使用人类第一视角探索数据训练世界动作模型,以应对分布外的物体配置。
LUCID: Learning Embodiment-Agnostic Intent Models from Unstructured Human Videos for Scalable Dexterous Robot Skill Acquisition
作者:Gupta、Shi、Yuan
OpenReview
海报场次 3,54 号海报:11 月 11 日周三上午 10:30–中午 12:00,JW Marriott,Lone Star 展厅(3 楼)
从非结构化互联网人类视频中学习与本体无关的意图,再通过在仿真中训练的跟踪策略执行。
ACE-Ego: Unifying Egocentric Human and Robotic Data for VLA Pretraining
作者:Li、Zhao、Liu 等
OpenReview
海报场次 2,61 号海报:11 月 10 日周二下午 5:00–6:30,JW Marriott,Lone Star 展厅(3 楼)
在机器人数据和带伪标签的第一视角人类视频上预训练 VLA,通过相机坐标系下的动作和形态 token 统一两类数据。
HARP-VLA: Human-Robot Aligned Representation Learning for Vision-Language-Action Model
作者:Zhu、Yuan、Liu 等
OpenReview
海报场次 1,17 号海报:11 月 9 日周一下午 5:00–6:30,JW Marriott,Lone Star 展厅(3 楼)
利用少量配对示范对齐人类和机器人的视觉表示,使从人类视频中学习到的潜在动作能够迁移至 VLA。
HuRo: Robotizing Human Videos for Scalable VLA Pretraining
作者:Jeong、Joo、Kang 等
OpenReview
海报场次 2,59 号海报:11 月 10 日周二下午 5:00–6:30,JW Marriott,Lone Star 展厅(3 楼)
将异构人类视频中的视觉内容和动作轨迹“机器人化”,作为可扩展的 VLA 预训练数据来源。
The Imitator Game: Benchmarking Robot Imitative Ability Beyond Action Prediction
作者:Zhou、Cai、Wang 等
OpenReview
海报场次 2,88 号海报:11 月 10 日周二下午 5:00–6:30,JW Marriott,Lone Star 展厅(3 楼)
一个四级 Benchmark,用于测试机器人是否模仿了人类示范的意图,而非仅仅重放其轨迹。
模仿学习与数据质量
Q-OIL: Optimistic Exploration in Learning from Human Interventions
作者:Teegavarapu、Poddar、Qi 等
OpenReview
海报场次 1,103 号海报:11 月 9 日周一下午 5:00–6:30,JW Marriott,Lone Star 展厅(3 楼)
真实的人类操作者会在任务进展停滞时介入,且给出的纠正可能并非最优;该方法结合基于进度的干预模型与乐观探索。
Ambient Diffusion Policy: Imitation Learning from Suboptimal Data in Robotics
作者:Wei、Pfaff、Cohn 等
OpenReview
海报场次 3,77 号海报:11 月 11 日周三上午 10:30–中午 12:00,JW Marriott,Lone Star 展厅(3 楼)
通过将低质量示范限制在高、低两个扩散噪声水平上,实现从次优数据中进行模仿学习。
奖励与进度模型
WARP-RM: A Warp-Augmented Relative Progress Reward Model for Data Curation
作者:Yu、Goldberg、Kondap 等
OpenReview
海报场次 3,68 号海报:11 月 11 日周三上午 10:30–中午 12:00,JW Marriott,Lone Star 展厅(3 楼)
基于经过时间扭曲的示范数据训练自监督相对进度奖励模型,用于筛选和加权质量参差不齐的遥操作数据。
Sim-to-Real、灵巧操作与数据生成
Dex4D: Task-Agnostic Point Track Policy for Zero-Shot Dexterous Manipulation
作者:Kuang、Park、Fragkiadaki 等
OpenReview
海报场次 3,118 号海报:11 月 11 日周三上午 10:30–中午 12:00,JW Marriott,Griffin 展厅(2 楼)
一种从任意姿态到任意姿态的灵巧点轨迹策略,在包含数千种物体的仿真环境中训练,并通过零样本重新组合应用于真实任务。
ExpertGen: Scalable Sim-to-Real Expert Policy Learning from Imperfect Behavior Priors
作者:Xu、Gong、Minniti 等
OpenReview
海报场次 3,85 号海报:11 月 11 日周三上午 10:30–中午 12:00,JW Marriott,Lone Star 展厅(3 楼)
在并行仿真中,通过针对初始噪声的 RL 引导扩散行为先验,无需人类示范即可生成专家数据。
Object-Centric Residual RL for Zero-Shot Sim-to-Real VLA Enhancement
作者:Kim、Saito、Kim 等
OpenReview
海报场次 3,65 号海报:11 月 11 日周三上午 10:30–中午 12:00,JW Marriott,Lone Star 展厅(3 楼)
在仿真中训练基于物体位姿的残差 RL,以零样本方式提升冻结 VLA 在真实机器人上的操作精度。
TacCoRL: Integrating Tactile Feedback into VLA via Simulation
作者:Ma、Liang、Yu 等
OpenReview
海报场次 2,149 号海报:11 月 10 日周二下午 5:00–6:30,JW Marriott,Griffin 展厅(2 楼)
通过仿真—真实数据联合训练,以及聚焦于临近失败的接触状态的仿真 RL,为 VLA 引入触觉。
Learning Dexterous Manipulation Using Contact Wrench Guidance From Human Demonstration
作者:Zhu、Liu、Jain 等
OpenReview
海报场次 3,47 号海报:11 月 11 日周三上午 10:30–中午 12:00,JW Marriott,Lone Star 展厅(3 楼)
从人类示范中提取以物体为中心的接触力与力矩引导,使灵巧操作 RL 能够扩展,并提出一个包含 4,739 项任务的双臂 Benchmark。
规划与组合泛化
What Do You Need for Compositional Generalization in Diffusion Planning?
作者:Clark、Shkurti
OpenReview
海报场次 2,20 号海报:11 月 10 日周二下午 5:00–6:30,JW Marriott,Lone Star 展厅(3 楼)
平移等变性和局部感受野解释了通过行为克隆训练的扩散规划器在何种情况下能够拼接和组合子轨迹。
Long-Horizon Multi-Object Rearrangement via Distilled Tree Search over Continuous Actions
作者:Saha、Hong、Li 等
OpenReview
Oral O6:11 月 10 日周二上午 11:00–11:30,Hilton Austin
海报场次 2,176 号海报:11 月 10 日周二下午 5:00–6:30,JW Marriott,Griffin 展厅(2 楼)
将 GPU 并行仿真中针对连续动作的蒙特卡洛树搜索(MCTS)蒸馏到策略中,用于长时程多物体重排。
Leave It Better Than Found: Value-Guided Cooperation in Sequential Tasks
作者:Andreu、Amir、Marino 等
OpenReview
Spotlight S3:11 月 10 日周二上午 8:30–9:00,Hilton Austin
海报场次 2,171 号海报:11 月 10 日周二下午 5:00–6:30,JW Marriott,Griffin 展厅(2 楼)
价值引导的临时协作:机器人离开工作空间时,会使其保持在下一个未知机器人能够继续工作的状态。
Recover, Discover, Plan: Learning Skills and Concepts from Robot Failures
作者:Li、Mishra、Liu 等
OpenReview
海报场次 2,94 号海报:11 月 10 日周二下午 5:00–6:30,JW Marriott,Lone Star 展厅(3 楼)
通过 RL 学习恢复技能,并从失败—恢复经验中发现关系谓词,以支持抽象规划。
P2——有余力可读
VLA 与生成式策略的 RL 微调
Beyond Imitation: Reinforcement Learning-Based Sim-Real Co-Training for VLA Models
作者:Shi、Chen、Gao 等
OpenReview
海报场次 3,64 号海报:11 月 11 日周三上午 10:30–中午 12:00,JW Marriott,Lone Star 展厅(3 楼)
进行仿真—真实联合训练,在仿真中使用 RL,并在真实数据上使用监督损失,而不是只通过 SFT 进行联合训练。
CounterAlign: Counterfactual Supervision for Vision-Language-Action Models
作者:Kondoh、Ota、Kanezaki 等
OpenReview
海报场次 2,31 号海报:11 月 10 日周二下午 5:00–6:30,JW Marriott,Lone Star 展厅(3 楼)
仅使用专家数据对 VLA 进行离线 RL,并通过指令重标注创建反事实负向监督。
RL 算法与探索
Tactile Curiosity Drives Robot Interaction
作者:Iten、Proshkin、Sukhija 等
OpenReview
海报场次 3,148 号海报:11 月 11 日周三上午 10:30–中午 12:00,JW Marriott,Griffin 展厅(2 楼)
使用触觉作为不确定性驱动探索的信号,使 RL Agent 探索接触,而非自由空间。
ENPIRE: Agentic Robot Policy Self-Improvement in the Real World
作者:Xiao、Xie、Zhang 等
OpenReview
海报场次 1,202 号海报:11 月 9 日周一下午 5:00–6:30,JW Marriott,Griffin 展厅(2 楼)
一个面向编程 Agent 的 Harness 框架,可在真实世界中运行策略自我改进循环:重置、执行、验证、改进。
世界模型与世界动作模型
Scaling World Model for Hierarchical Manipulation Policies
作者:Qian、Wang、Song 等
OpenReview
海报场次 3,17 号海报:11 月 11 日周三上午 10:30–中午 12:00,JW Marriott,Lone Star 展厅(3 楼)
一种分层 VLA:预训练世界模型生成子目标图像,再由 VLA 执行,以提高分布外泛化能力。
FACT: Failure-Aware Causal Training for World-Action Models
作者:Peng、Liang、Yan 等
OpenReview
海报场次 3,4 号海报:11 月 11 日周三上午 10:30–中午 12:00,JW Marriott,Lone Star 展厅(3 楼)
一种以动作为条件的世界动作模型,从失败 rollout 中学习,从而预测错误动作的后果。
SuperMimic: Scaling Humanoid Whole-Body Control with One Differentiable World Model
作者:Liao、Shao、Long 等
OpenReview
Oral O7:11 月 10 日周二上午 11:30–中午 12:00,Hilton Austin
海报场次 2,217 号海报:11 月 10 日周二下午 5:00–6:30,JW Marriott,Griffin 展厅(2 楼)
使用一个具有解析梯度的共享动力学可微世界模型,在单张 GPU 上用 3 小时训练出 Humanoid 全身动作跟踪器。
World-Language-Action Model for Unified World Modeling, Language Reasoning, and Action Synthesis
作者:Yang、Liu、Kou 等
OpenReview
海报场次 1,56 号海报:11 月 9 日周一下午 5:00–6:30,JW Marriott,Lone Star 展厅(3 楼)
一种自回归的世界—语言—动作模型,联合预测文本子任务、子目标图像和动作。
W2A: Distilling World Priors into Action Models for Real-Time Robotic Control
作者:Zhang、Yongjin、Weng 等
OpenReview
海报场次 2,4 号海报:11 月 10 日周二下午 5:00–6:30,JW Marriott,Lone Star 展厅(3 楼)
在训练时将视频扩散模型的特征蒸馏到动作模型中,使模型在测试时无需生成视频。
Targeting World Models to Compromise Robot Learning Pipelines
作者:Rathbun、Agha、Mahmud 等
OpenReview
Spotlight S2:11 月 9 日周一下午 2:30–3:00,Hilton Austin
海报场次 1,54 号海报:11 月 9 日周一下午 5:00–6:30,JW Marriott,Lone Star 展厅(3 楼)
研究表明,机器人学习 pipeline 中学得的世界模型会形成隐蔽的攻击入口,可能导致下游策略受到攻击。
TAPESTRY: A Single Backbone for Video Generation and Robot Control
作者:Collins、Lee、Wachakorn 等
OpenReview
海报场次 3,6 号海报:11 月 11 日周三上午 10:30–中午 12:00,JW Marriott,Lone Star 展厅(3 楼)
将动作视为单个视频 patch token,把预训练视频扩散 Transformer 改造为策略模型。
MDF++: Visuo-Tactile World Action Model with End-to-end Representation Learning
作者:Huang、Yu、Charlick 等
OpenReview
海报场次 2,158 号海报:11 月 10 日周二下午 5:00–6:30,JW Marriott,Griffin 展厅(2 楼)
一种视觉—触觉世界动作模型,以端到端方式学习与控制相关的表示,避免特征坍塌。
VLA 与通用策略
APT: Action Expert Pretraining Improves Instruction Generalization of Vision-Language-Action Policies
作者:Xu、Zhu、Chen 等
OpenReview
海报场次 2,21 号海报:11 月 10 日周二下午 5:00–6:30,JW Marriott,Lone Star 展厅(3 楼)
将 VLA 的 Action Expert 预训练为与语言无关的视觉—动作先验,以抑制视觉捷径并提高指令泛化能力。
SERF: Spatiotemporal Environment and Robot Feature Map for Long-Horizon Mobile Manipulation
作者:Kim、Pak、Long 等
OpenReview
Spotlight S5:11 月 10 日周二下午 2:30–3:00,Hilton Austin
海报场次 2,173 号海报:11 月 10 日周二下午 5:00–6:30,JW Marriott,Griffin 展厅(2 楼)
以场景和机器人本体的在线时空神经点地图作为 VLA 的条件,用于长时程移动操作。
Learning What to Say to Your VLA: Mostly Harmless Vision Language Action Model Steering
作者:Jeong、Swamy、Bajcsy
OpenReview
Spotlight S1:11 月 9 日周一上午 9:00–9:30,Hilton Austin
海报场次 1,64 号海报:11 月 9 日周一下午 5:00–6:30,JW Marriott,Lone Star 展厅(3 楼)
搜索能够提高冻结 VLA 闭环成功率的语言,并将其蒸馏为测试时语言反馈策略。
从人类视频中学习
EgoWAM: World Action Models Beyond Pixels with In-the-Wild Egocentric Human Data
作者:Li、Yin、Lin 等
OpenReview
海报场次 2,62 号海报:11 月 10 日周二下午 5:00–6:30,JW Marriott,Lone Star 展厅(3 楼)
通过受控研究,探究哪种世界预测目标最有利于世界动作模型迁移真实自然场景中的第一视角人类数据。
模仿学习与数据质量
FlowDAgger: Human-in-the-Loop Adaptation of Generative Robot Policies in Latent Space
作者:Murray、Chen、Bagaria 等
OpenReview
Spotlight S3:11 月 10 日周二上午 8:30–9:00,Hilton Austin
海报场次 2,29 号海报:11 月 10 日周二下午 5:00–6:30,JW Marriott,Lone Star 展厅(3 楼)
通过将专家动作反演为潜在噪声,利用人类干预数据适配冻结的 Flow 策略和扩散策略。
SynthICL: Scalable In-context Imitation Learning with Synthetic Data
作者:Qian、Fan、Ren 等
OpenReview
海报场次 3,79 号海报:11 月 11 日周三上午 10:30–中午 12:00,JW Marriott,Lone Star 展厅(3 楼)
完全使用仅含 RGB 信息的合成数据训练上下文内模仿策略,并结合子目标预测。
Graph-Reweighted Behavior Cloning with Human Interventions for Precise Robotic Manipulation
作者:Li、Yang、Hu 等
OpenReview
海报场次 2,65 号海报:11 月 10 日周二下午 5:00–6:30,JW Marriott,Lone Star 展厅(3 楼)
根据动作块在目标可达性图中减少剩余步数的程度对其加权,用于 VLA 的精密操作后训练。
Diversity You Can Actually Measure: A Fast, Model-Free Diversity Metric for Robotics Datasets
作者:Sirigiri、Lara、Agia 等
OpenReview
Oral O3:11 月 9 日周一上午 11:30–中午 12:00,Hilton Austin
海报场次 1,199 号海报:11 月 9 日周一下午 5:00–6:30,JW Marriott,Griffin 展厅(2 楼)
使用路径签名核熵衡量轨迹数据集的多样性,为筛选示范数据提供一种快速、无模型的方法。
Progress-Guided Preference Generation for Aligning Generative Control Policies
作者:Luu、Ton、Nguyen 等
OpenReview
海报场次 2,30 号海报:11 月 10 日周二下午 5:00–6:30,JW Marriott,Lone Star 展厅(3 楼)
根据相对于少量专家示范的任务进度生成无监督偏好标签,无需人工标注即可微调生成式策略。
MIRROR: Reflecting Hidden Symmetries from Offline Robot Interaction Data
作者:Liu、Yao、Huang 等
OpenReview
海报场次 3,116 号海报:11 月 11 日周三上午 10:30–中午 12:00,JW Marriott,Lone Star 展厅(3 楼)
从离线数据中发现对称群如何作用于像素观测和动作,用于对称性感知的策略学习。
奖励与进度模型
HiRE: Hindsight Reward Editing for Policy Finetuning
作者:Niu、Han、Ji 等
OpenReview
海报场次 1,97 号海报:11 月 9 日周一下午 5:00–6:30,JW Marriott,Lone Star 展厅(3 楼)
一种无需训练的奖励编辑方法,通过事后对比成功与失败轨迹,校准基础模型生成的奖励。
TOPReward: Token Probabilities as Hidden Zero-Shot Rewards for Robotics
作者:Chen、Harrison、Lee 等
OpenReview
海报场次 1,94 号海报:11 月 9 日周一下午 5:00–6:30,JW Marriott,Lone Star 展厅(3 楼)
从视频语言模型的 token 概率中获取零样本稠密进度奖励,无需训练奖励模型。
RARM: Confidence-Gated Progress Reward Modeling for RL in Manipulation
作者:Yang、Wang、Jing 等
OpenReview
海报场次 1,95 号海报:11 月 9 日周一下午 5:00–6:30,JW Marriott,Lone Star 展厅(3 楼)
仅使用一条示范构建以参考示范为锚点、由置信度门控的进度奖励模型,对失败情况和奖励投机具有鲁棒性。
Sim-to-Real、灵巧操作与数据生成
HumanoidMimicGen Data Generation for Loco-Manipulation via Whole-Body Planning
作者:Lin、Mandlekar、Garrett 等
OpenReview
海报场次 2,185 号海报:11 月 10 日周二下午 5:00–6:30,JW Marriott,Griffin 展厅(2 楼)
采用 MimicGen 风格的数据生成方法,结合规划从少量示范中适配全身技能,为 Humanoid 移动操作生成数据。
Assembling Two Parts in One Hand
作者:Pei、Wu、Zhang 等
OpenReview
海报场次 3,121 号海报:11 月 11 日周三上午 10:30–中午 12:00,JW Marriott,Griffin 展厅(2 楼)
使用 RL 实现单只灵巧手对两个零件进行手内装配,结合基于功能的奖励和 Sim-to-Real 迁移。
Building Scalable Real-World Robot Data Generation via Compositional Simulation
作者:Qin、Ma、Kang 等
OpenReview
海报场次 3,86 号海报:11 月 11 日周三上午 10:30–中午 12:00,JW Marriott,Lone Star 展厅(3 楼)
在 Real-Sim-Real 闭环中结合经典仿真与神经仿真,生成大规模、与真实世界一致的动作—视频数据集。
Dex-X: Learning Visual-Tactile Dexterous Manipulation From Human Demonstration with Simulated Interaction
作者:Chen、Ruan、Cao 等
OpenReview
海报场次 2,151 号海报:11 月 10 日周二下午 5:00–6:30,JW Marriott,Griffin 展厅(2 楼)
通过在仿真中重建人类视频示范,恢复其中的触觉信号,再学习视觉—触觉灵巧操作策略。
跨本体与机器人设计
Transformer Transformer: A Unified Model for Motion-Conditioned Robot Co-design
作者:Ha、Liu、Song
OpenReview
海报场次 2,116 号海报:11 月 10 日周二下午 5:00–6:30,JW Marriott,Lone Star 展厅(3 楼)
一种基于统一的本体、状态和动作 token 的扩散 Transformer,可针对目标运动生成机器人设计。
Workshop
CoRL 2026 共有 32 场 Workshop 和教程,均于 11 月 12 日周四在 JW Marriott 和 Hilton Austin 举行。以下是与 RL、世界模型、从人类视频中学习以及预训练策略适配最相关的活动。
上午场:8:30–12:30
R2RL: Roadmap to Sample-Efficient Real-World Reinforcement Learning
JW Marriott,213 号会议室——Workshop 页面Continually Self-Improving Robots (CSIR-2026)
JW Marriott,202 号会议室——Workshop 页面Learn@Deploy: Robot Learning at Deployment
JW Marriott,205 号会议室——Workshop 页面Learning from Corrections and Interventions
JW Marriott,305 号会议室——Workshop 页面
Do Robots Need World Models? A Debate on Dynamics Learning, Planning, and End-to-End Robot Learning
JW Marriott,Brazos——Workshop 页面Scaling H2R: Scaling Laws and Diversity in Human-to-Robot
JW Marriott,301–302 号会议室——Workshop 页面Compositional Generalization for Real-World Robot Learning
JW Marriott,310–311 号会议室——Workshop 页面From GPU-Accelerated Simulation to Scalable and Generalizable Real Robot Policy Learning
JW Marriott,212 号会议室——Workshop 页面
下午场:2:00–6:00
Pretrain to Adapt: What Makes a Pretrained Policy Adaptable?
JW Marriott,301–302 号会议室——Workshop 页面Modeling Uncertainty in Robotic World Models
JW Marriott,310–311 号会议室——Workshop 页面Bringing Physics Simulation and World Models Together for Robotic Manipulation
JW Marriott,Brazos——Workshop 页面The Action Gap: Large Generative Models (Video, Image, 3D) Learn Rich Knowledge
JW Marriott,208 号会议室——Workshop 页面“Oops, I Erred”: Collecting, Curating and Using Imperfect Data for Realistic Scenarios
JW Marriott,305 号会议室——Workshop 页面Sim-to-Real-to-Field (SRF): The Science of Transfer
Hilton,Salon E——Workshop 页面From Human Videos to Dexterous Robot Capability: A Hands-on Tutorial
Hilton,Salon D——教程页面Workshop on Agentic Robotics
JW Marriott,203–204 号会议室——Workshop 页面
Workshop 与论文之间的联系
R2RL、CSIR、Learn@Deploy 和 Pretrain to Adapt 对应上文关于 RL 微调的部分。
Do Robots Need World Models?、Modeling Uncertainty in Robotic World Models、Physics Simulation and World Models 和 The Action Gap 对应世界模型部分。
Scaling H2R 和人类视频教程对应从人类视频中学习的论文。
Learning from Corrections and Interventions 和 “Oops, I Erred” 对应模仿学习与数据质量相关论文。
其他活动请参阅完整的 Workshop 日程。
来源:human five