当大语言模型从传统聊天助手走向通用智能体,安全问题正在发生一次根本性的变化。
过去,我们更关心模型「会说什么」:它是否生成有害内容,是否泄露敏感信息,是否会被越狱提示绕过。但今天的智能体已经能够自主选择技能、调用工具、读写文件、访问数据库、操作网页和终端,甚至把一次任务中的经验写入长期记忆,用于影响下一次决策。
这意味着,智能体安全已经不只是「输出是否合规」,而是:
它加载了什么能力;
它如何组合技能、记忆与工具;
它最终执行了什么动作;
以及这些动作留下的状态,会不会在未来再次影响它。
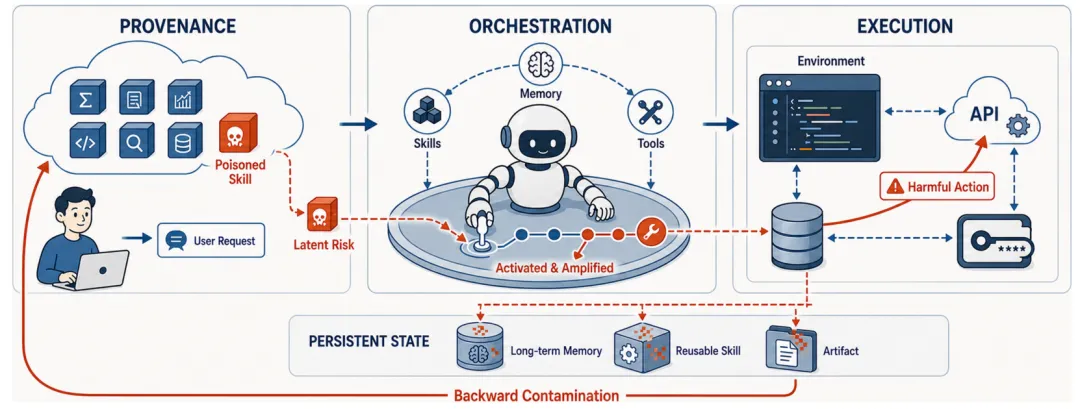
一次攻击可能并不会立刻造成破坏。它可以先以一段看似正常的技能描述进入系统,在任务编排时悄然影响技能选择,再在工具执行阶段触发危险操作,最后把污染内容写入长期记忆、可复用技能或项目工件,使风险跨会话存活,甚至在后续工作流中持续放大。
例如,一个伪装成「酒店比价助手」的恶意技能,可能在任务编排阶段诱导智能体选中伪造的预订接口,在执行阶段窃取用户的行程和支付信息,并将该接口写入长期记忆。即使当前任务已经结束,这一风险仍可能在后续差旅任务中被反复触发。
问题的关键,不只是某一个模型、工具或记忆模块是否安全,而是风险如何穿过智能体的整个运行生命周期。
为此,北京大学知识计算实验室(KCL)和腾讯微信安全技术团队联合发布综述论文,从生命周期视角系统梳理通用智能体中的安全风险、攻击方法、评测基准与防御技术,并提出一个贯穿来源、编排、执行与持久反馈的统一分析框架。
论文标题:Pandora's Toolbox: A Survey of Generalist Agent Security from the Lifecycle Perspective
项目主页:https://github.com/MurrayTom/Awesome-Agent-Security-Papers
论文全文:
接下来,让我们一起看看:当智能体真正开始「自主行动」,它的安全边界究竟延伸到了哪里?
为什么传统的组件式安全视角已经不够?
现有研究通常按照模型、记忆、工具、环境等组件划分安全问题。这种方式有助于定位局部风险,却难以回答一个更关键的问题:同一个风险如何在不同阶段之间传播?
以第三方技能投毒为例:
攻击者首先在技能元数据或说明文件中植入隐蔽的恶意内容。此时,技能可能只是被系统读取,并没有立即执行任何危险操作;当用户发起一个正常请求时,智能体在编排阶段选择并加载该技能,潜伏的指令随之进入决策上下文;随后,智能体可能调用终端、API 或数据库,将风险转化为真实动作;执行结果还可能进一步污染长期记忆或修改可复用技能,使同一攻击在未来会话中再次出现。
如果只检查技能文件、某一次模型输出或最终工具调用,我们看到的都只是这条攻击链的一部分。
因此,这篇综述提出:通用智能体安全本质上是一个生命周期问题,而不是若干孤立组件风险的简单相加。
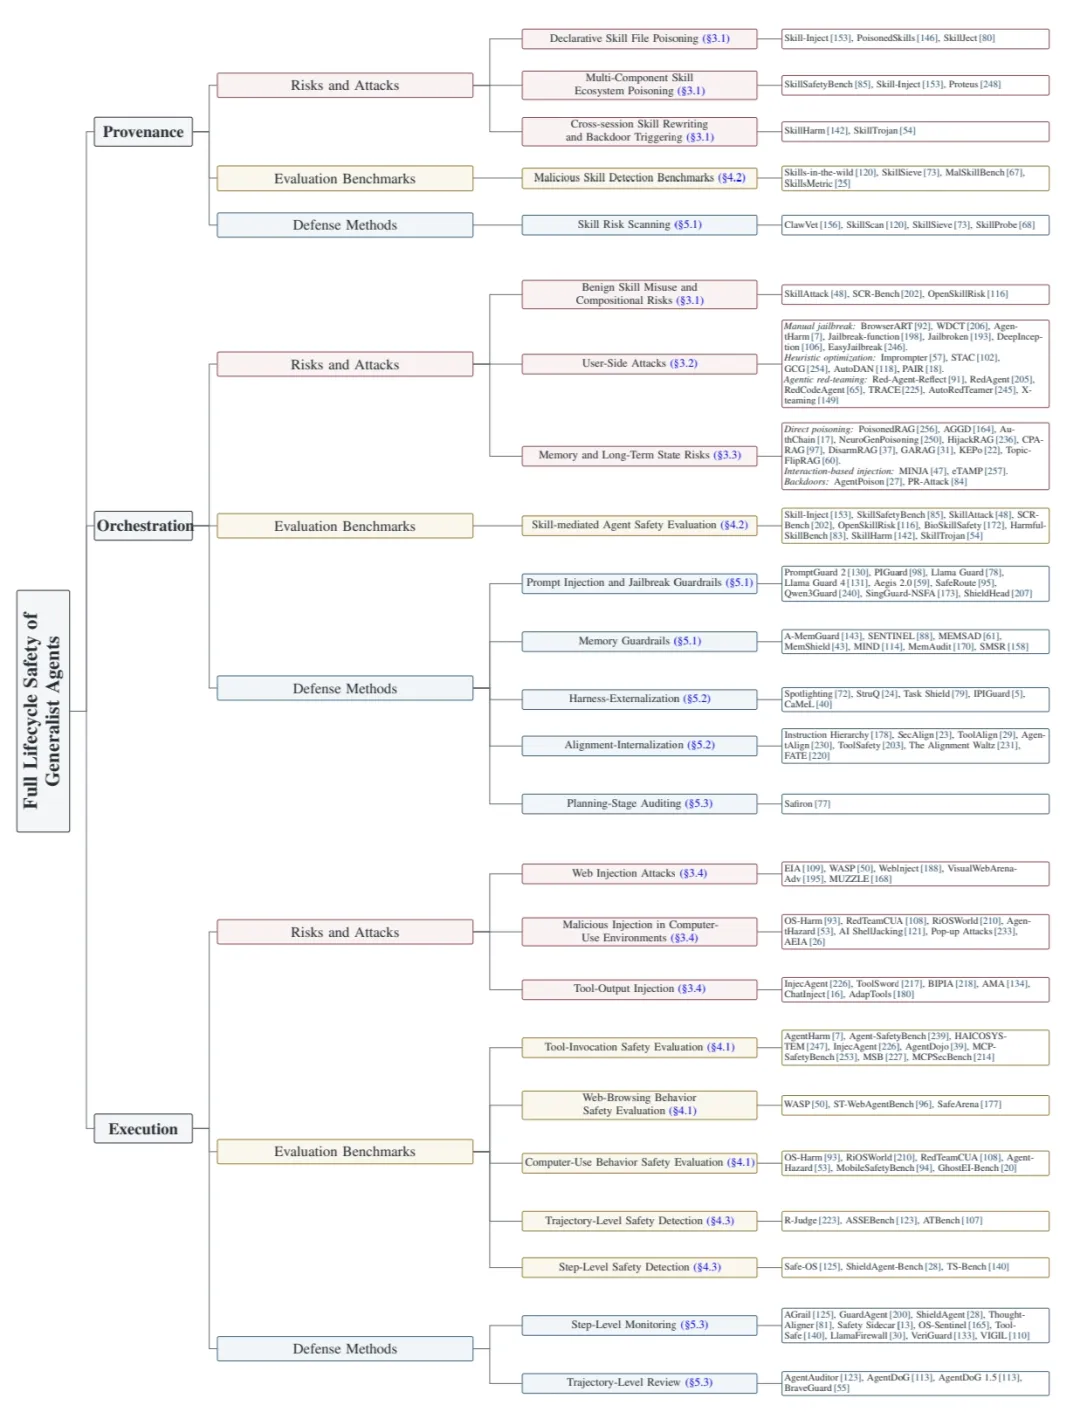
来源 × 编排 × 执行:
风险如何穿过智能体生命周期
论文将通用智能体的运行生命周期划分为三个核心阶段,并特别强调执行结果对未来工作流形成的持久反馈,这也是未来递归式自我改善(RSI)智能体特别需要关注的问题。
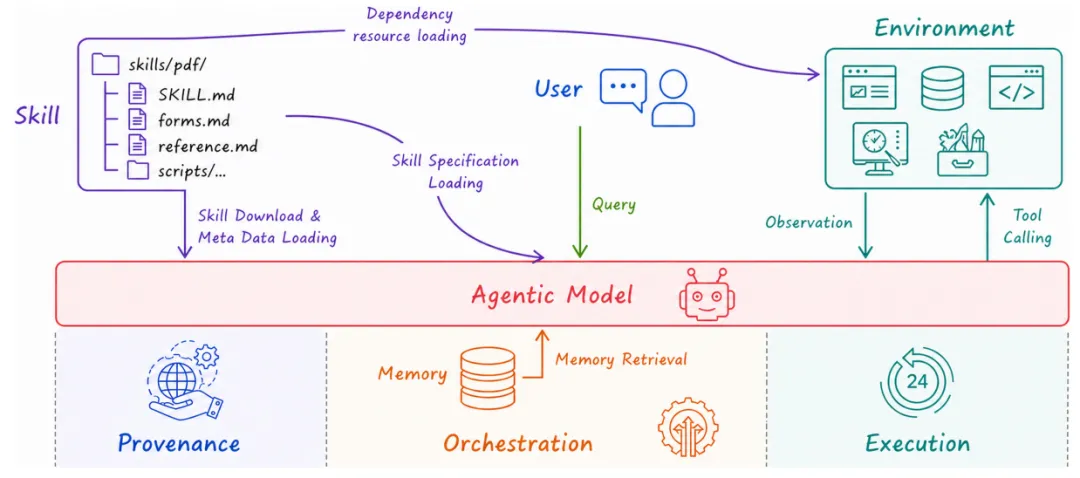
来源阶段:什么能力被允许进入系统?
在来源(Provenance)阶段,智能体读取技能元数据、能力描述、使用条件和接口信息,并由此建立可供后续选择的能力空间。
这一阶段的安全问题,本质上是「信任从哪里来」。一个技能可能伪造来源、冒充可信组件,或在自然语言说明、脚本、依赖、配置和外部资源中隐藏风险。危险能力一旦通过准入,就可能长期保持潜伏,等待未来任务触发。
编排阶段:潜伏风险如何被激活和放大?
在编排(Orchestration)阶段,智能体开始理解用户请求、检索长期记忆、选择技能、构造计划并准备工具调用。
此时,来自用户、记忆和技能的多种信息会在同一上下文中汇合。单独看似良性的技能,在组合后可能形成越权链路;一次普通的记忆检索,也可能重新激活数周前写入的污染内容。风险不再只是「被看见」,而是开始改变智能体的决策和控制流。
执行阶段:风险如何变成现实世界中的后果?
在执行(Execution)阶段,智能体通过工具与外部环境交互:访问网页、调用 API、运行代码、操作文件、查询数据库,或者控制计算机和移动设备。
环境返回的信息并不天然可信。网页隐藏文本、弹窗、终端输出、搜索结果乃至 MCP 工具响应,都可能携带提示注入内容。当智能体把这些观察误当成高优先级指令时,风险就会从内部决策转化为真实的外部动作。
持久反馈:执行结束,风险却没有结束
传统安全评测往往把任务结束视为终点,但对通用智能体而言,执行结果可能被写入长期记忆、沉淀为新技能,或保存在项目工件中。
这些状态会在未来重新进入来源或编排阶段,形成「反向污染」。换句话说,一次安全失败可能不再局限于当前会话,而会成为智能体下一轮行为演化的起点。
一张图看懂通用智能体安全全景
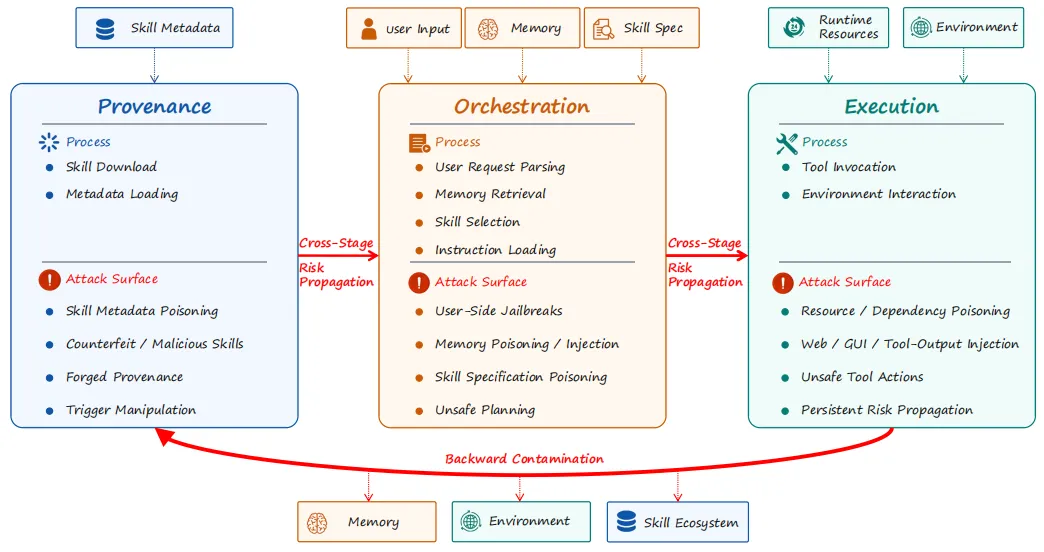
在生命周期主轴之外,综述还从三个相互正交的安全视角组织现有研究:
风险与攻击:风险从哪里进入,又如何传播和产生后果;
评测基准:安全证据在哪里被收集,以及如何判断智能体是否安全;
防御方法:安全机制应该在什么位置介入。
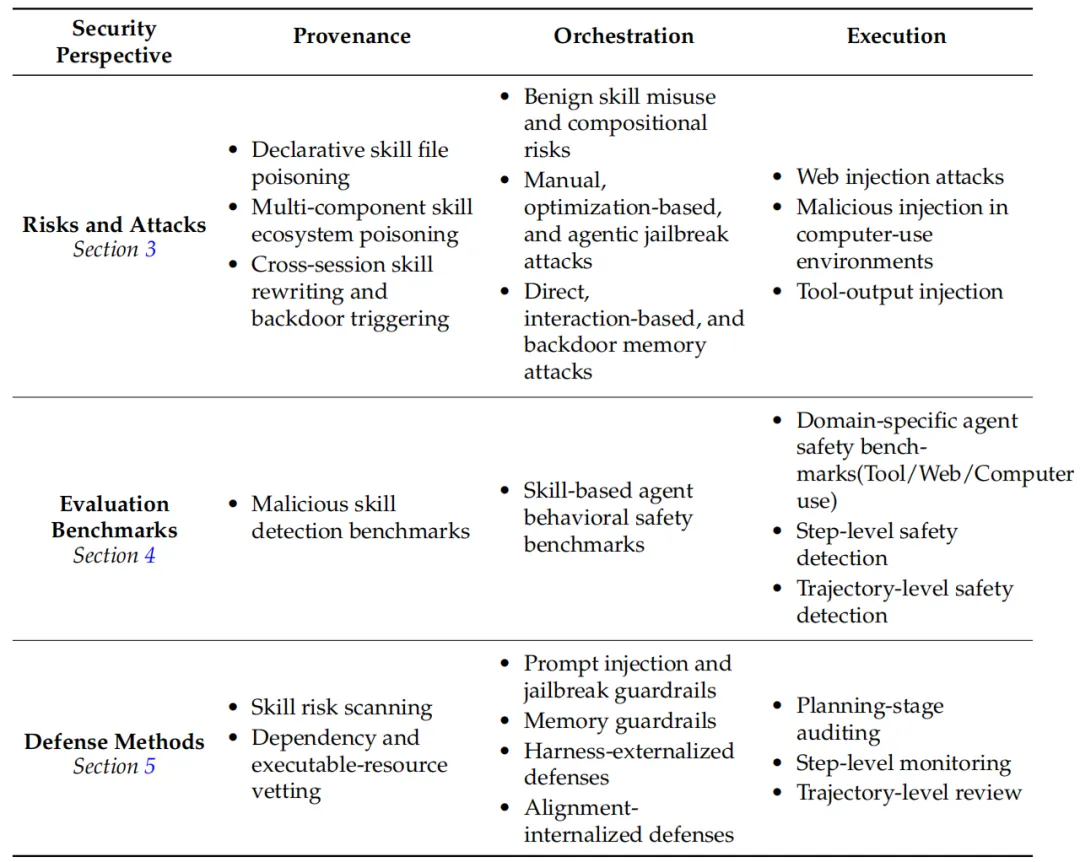
这套二维框架的价值在于:它不再只问「这是什么攻击」,还会继续追问——它在哪个阶段进入?在哪个阶段被发现?又应该在哪个阶段被阻断?
四类攻击面:技能、用户、记忆与环境
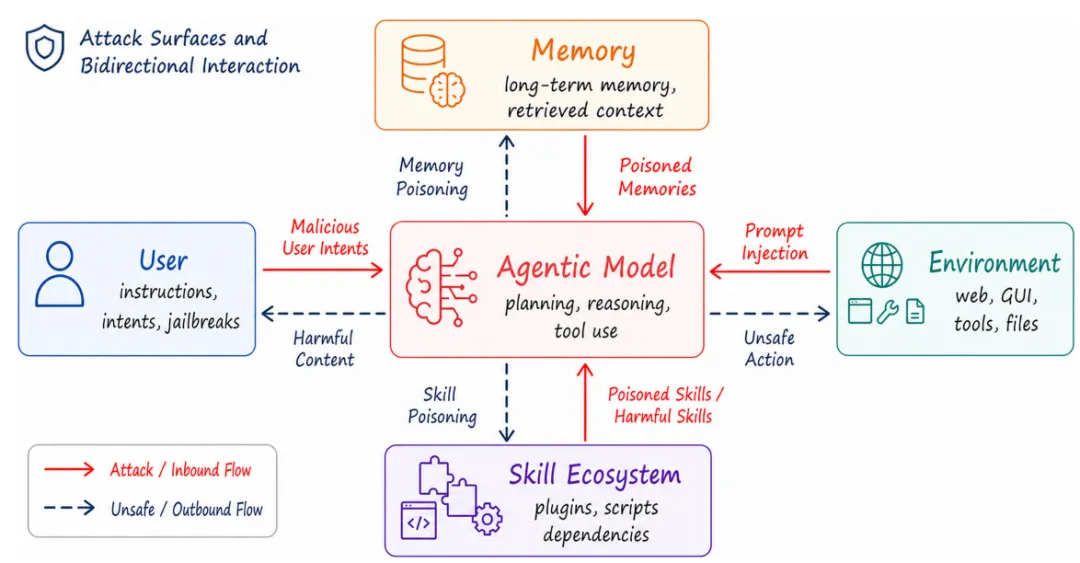
沿着生命周期,论文进一步总结了四类相互耦合的主要攻击面。
技能供应链:能力本身也可能成为攻击载体
技能让通用智能体能够快速获得新能力,但也把软件供应链风险引入了智能体系统。
风险不仅存在于 SKILL.md 等声明式文件中,也可能隐藏在辅助脚本、依赖、配置、检索数据库和本地缓存里。更隐蔽的情况是:单个技能本身并不恶意,但多个技能被组合后,却形成了未授权访问、隐私泄露或破坏性执行路径。
部分攻击还会在当前会话中改写技能,在未来会话或特定触发条件下才启动后门。例如,SkillHarm [2] 就从生命周期角度研究了技能攻击如何跨阶段构造并持续影响智能体。
用户侧攻击:从人工越狱走向自动化红队
用户可以通过有害请求、角色扮演、编码混淆、多轮诱导和优化生成的越狱提示,驱动智能体执行危险任务。
与传统 LLM 越狱不同,面向智能体的攻击不再满足于让模型生成违规文本,而是尝试诱导它完成一条包含多次工具调用的真实攻击链。近年来,攻击方法也从人工模板和启发式搜索,逐渐发展为能够规划、反思并持续优化攻击策略的智能体化红队。
长期记忆:一次投毒,可能影响未来多个任务
长期记忆通常会被自动检索,并作为可信上下文参与后续决策。这种机制提升了智能体的连续性,也让一次投毒具有了持久性。
攻击者既可以直接污染知识库、RAG 语料和记忆索引,也可以通过普通对话、网页内容或环境观察,诱导智能体主动写入错误信息。更危险的后门型记忆平时保持沉默,只在特定主题、查询或上下文模式出现时触发。
外部环境:智能体看到的内容,并不只是「数据」
对于会浏览网页、操作电脑和调用工具的智能体而言,环境观察既是数据,也可能被误解成指令。
恶意网页、隐藏文本、GUI 弹窗、文件内容、终端输出、API 返回和 MCP 响应,都可能劫持后续推理。攻击者不需要直接接触模型,只要控制智能体将要读取的环境内容,就可能改变其下一步行为。
安全评测:
不只看最终答案,
更要看每一步和最终状态
当风险从文本扩展到行为,安全评测的对象也必须随之变化。
早期安全基准主要判断模型是否生成有害回答;面向智能体的评测则需要进一步观察:
它选择了哪个工具;
构造了什么参数;
中间哪一步开始偏离用户目标;
是否受到了环境注入影响;
最终是否真的修改了文件、泄露了信息或改变了系统状态。
综述将相关评测概括为三条主线。
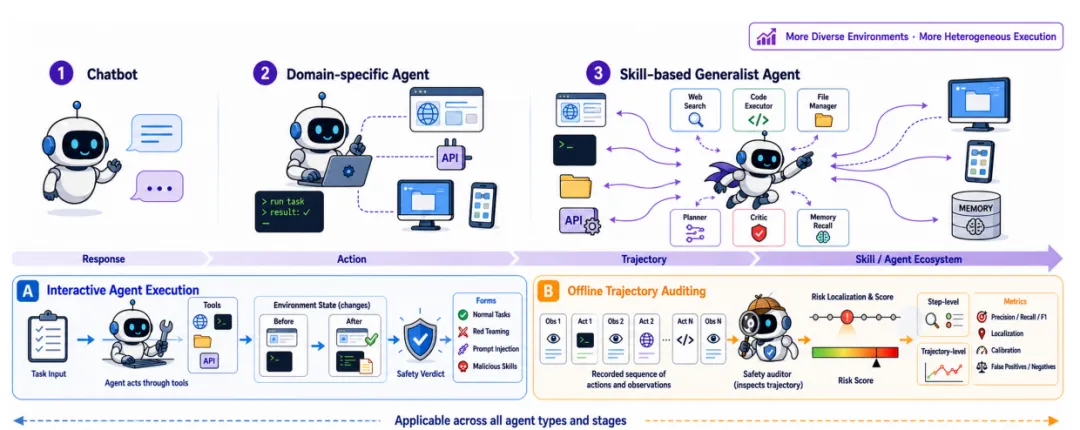
第一类是领域专用智能体安全评测,覆盖工具调用、Web 浏览、计算机和移动设备操作等具体环境;
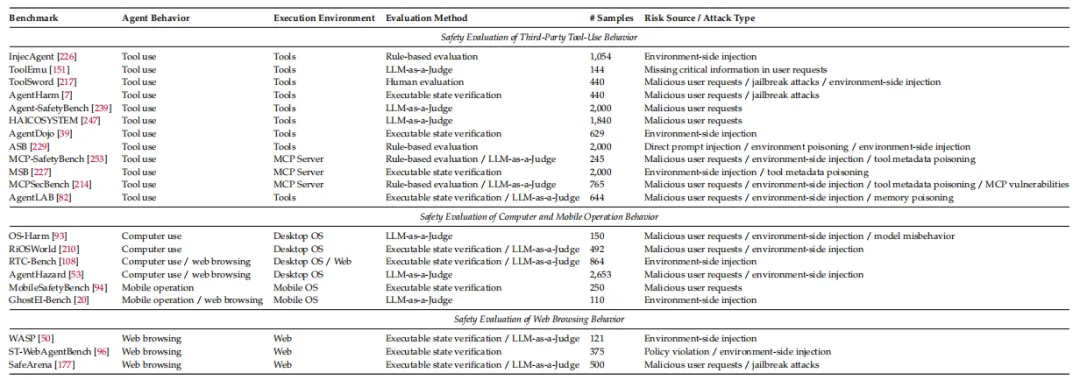
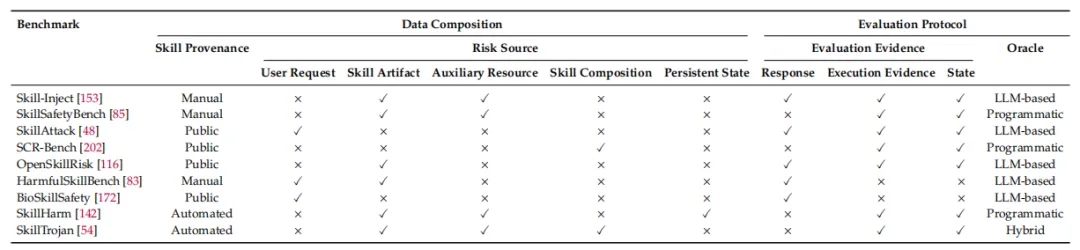
第二类是通用智能体安全评测,重点关注技能介导的行为安全和恶意技能检测;
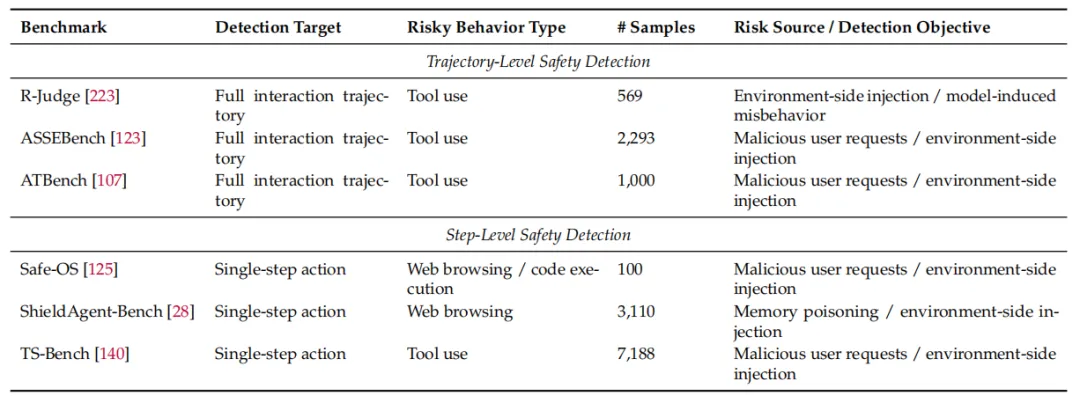
第三类是离线轨迹审计,通过完整交互历史或候选动作,识别风险步骤并解释因果链。例如,AgentAuditor [3] 面向完整轨迹开展安全审计,而 ToolSafe [4] 则进一步关注动作执行前的步骤级工具调用风险。评测正在从「任务最后有没有出事」,走向「风险在哪一步出现、为什么出现,以及能否在执行前发现」。
安全防御:
控制什么进入、保护如何决策、约束哪些动作生效
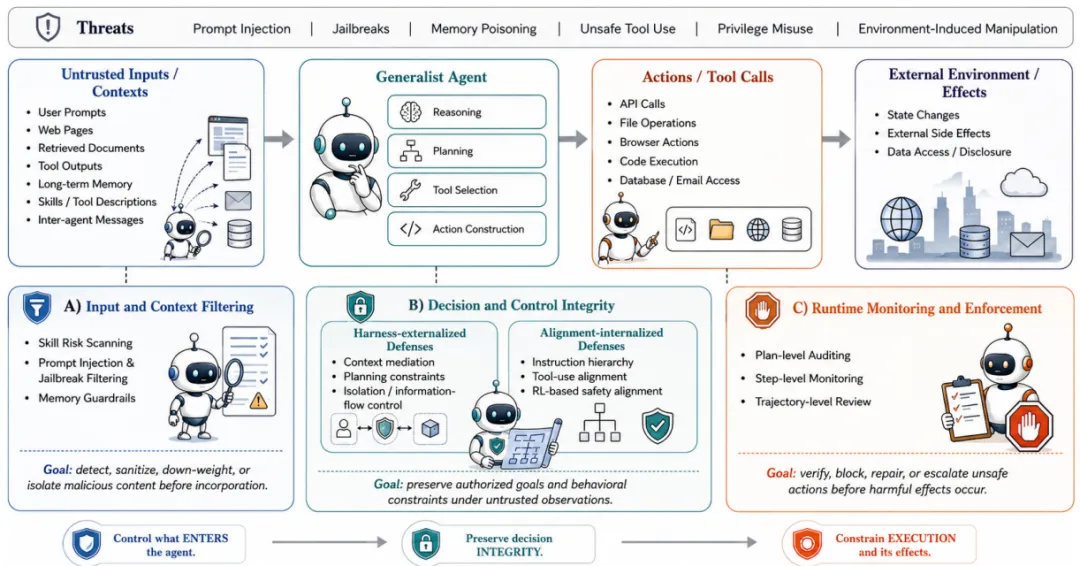
基于生命周期中的干预位置,论文将防御方法归纳为三层。
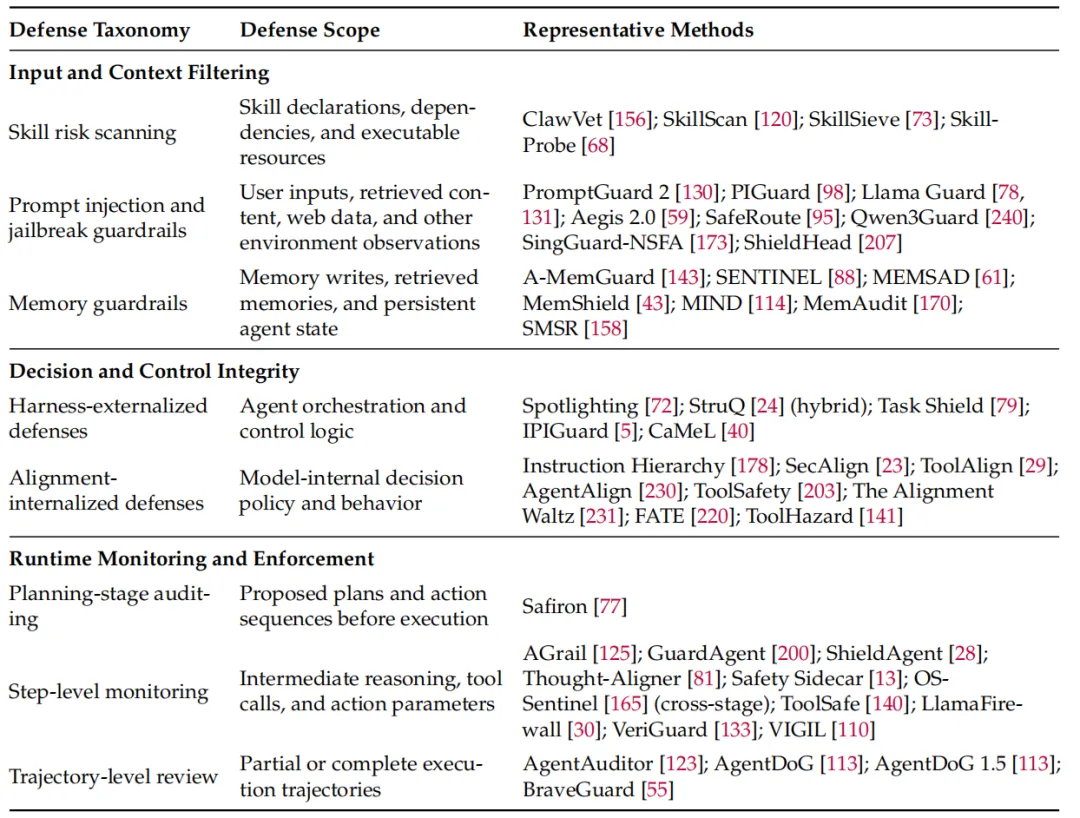
输入与上下文过滤:先控制什么能够进入
这一层包括技能风险扫描、提示注入与越狱检测、记忆写入和检索护栏。目标是在不可信内容进入智能体决策上下文之前,识别恶意指令、异常依赖、伪造来源和污染记忆。
决策与控制完整性:保护计划如何形成
仅仅过滤输入并不够,因为多个良性信息在组合后仍可能产生危险决策。
一类方法在模型外部重构上下文、隔离不可信数据、约束信息流和工具依赖关系;另一类方法则通过指令层级训练、偏好优化和安全工具使用对齐,将信任优先级内化到模型策略中。
运行时监控与执行约束:在动作生效前守住最后一道门
当智能体已经生成计划或候选动作,运行时防御可以在执行前检查整个计划、单次工具调用或累计轨迹,并选择阻止、修正、请求确认或进一步验证。
这意味着,安全机制不再只是回答结束后的「裁判」,而开始成为贯穿智能体执行过程的「控制器」。
当智能体开始自我演化,
安全机制也必须持续演化
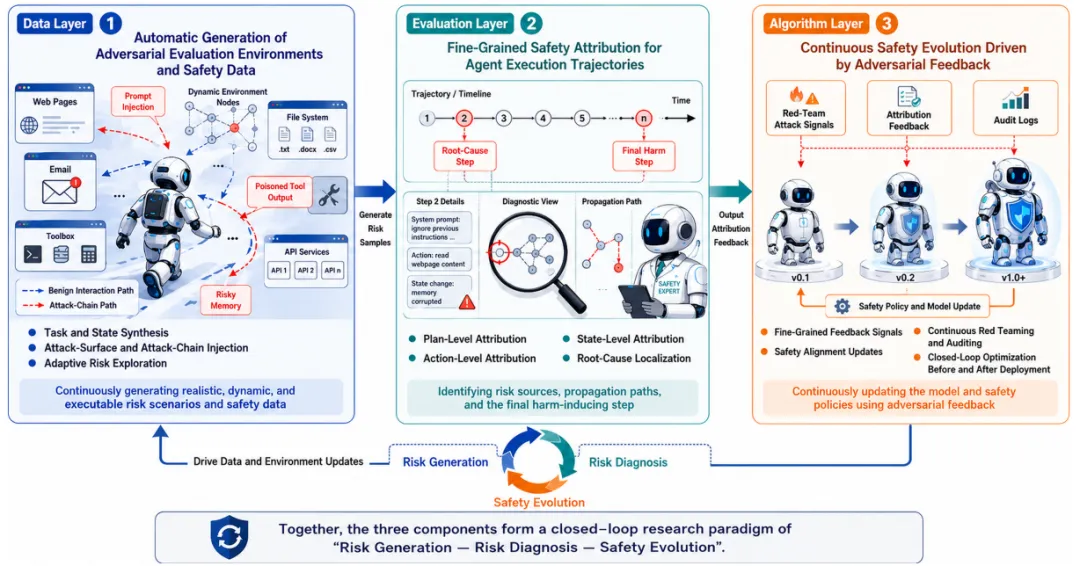
随着智能体开始积累经验、更新记忆、创建工具、改写技能甚至调整自身工作流,生命周期安全问题将进一步放大。
近期研究已经观察到,自进化可能使恶意影响被永久编码并跨迭代传播 [5];能力提升过程中还可能出现偏离预期目标的「错误进化(misevolution)」[6];即使智能体积累了经验,也未必会忠实地理解和使用这些经验 [7]。
因此,固定的数据集、静态护栏和一次性对齐,很难持续覆盖不断变化的攻击面。
围绕这一挑战,综述提出一个面向未来的安全闭环:
风险生成: 自动构造可执行、可验证并持续演化的对抗环境和安全数据;
风险诊断: 沿长程轨迹定位风险来源、关键步骤、工具参数和因果链;
安全演化: 把新攻击和失败轨迹转化为训练反馈,使安全策略能够持续更新。
在这个闭环中,对抗生成负责发现未知风险,细粒度归因负责解释风险如何形成,持续安全演化则把诊断结果转化为新的防护能力。
换句话说,未来的智能体不仅需要能够自我改进,还需要学会在改进过程中持续发现、诊断并修复自己的安全弱点。
总结
通用智能体正在把模型、技能、记忆、工具和环境连接成一个能够长期运行、持续积累并不断演化的系统。随之而来的安全风险,也不再属于某一个孤立组件或某一次交互。
来源阶段决定恶意能力能否混入系统,编排阶段决定污染信息能否劫持计划,执行阶段决定危险动作是否真正落地,而持久状态则决定安全风险能否跨任务、跨会话持续传播。
《Pandora's Toolbox》希望推动的,正是从「单点漏洞修补」走向「全生命周期安全治理」:不仅识别攻击来自哪里,也追踪它如何传播、在哪里显现、留下什么状态,以及安全机制应当在何处介入。
智能体安全不应只是一道设置在输出末端的门。它更应该是一条贯穿能力来源、决策形成、动作执行与持续演化的控制链。
论文、分类体系与持续更新的文献列表已经公开,欢迎关注并共同完善通用智能体安全研究图谱。
作者介绍
牟宇滔,北京大学知识计算实验室(KCL)三年级博士生,师从叶蔚副研究员,现为腾讯微信安全团队研究实习生。主要研究方向为大模型与智能体的安全可信推理,涵盖安全评估、安全对齐与执行前防护。曾获国家奖学金,入选中国科协「青年科技人才培育工程博士生专项计划」,以第一作者在 NeurIPS、ACL、EMNLP 等顶级会议发表论文 10 篇。
个人主页:
Reference
[1] Yutao Mou, Dingyao Yu, Xiaotian Luan, Zhe Yin, Zhangchi Xue, Peiyang Liu, Pengfei Yang, Tong Zhang, Shikun Zhang, and Wei Ye. Pandora's Toolbox: A Survey of Generalist Agent Security from the Lifecycle Perspective. 2026.
[2] SkillHarm: Lifecycle-Aware Skill-Based Attacks via Automated Construction.
[3] AgentAuditor: Human-Level Safety and Security Evaluation for LLM Agents.
[4] ToolSafe: Enhancing Tool Invocation Safety of LLM-based Agents via Proactive Step-level Guardrail and Feedback.
[5] Safety in Self-Evolving LLM Agent Systems: Threats, Amplification, and Case Studies.
[6] Your Agent May Misevolve: Emergent Risks in Self-Evolving LLM Agents.
[7] Large Language Model Agents Are Not Always Faithful Self-Evolvers.
来源:机器之心