用 Agent 跑长程任务时,模型推理和工具调用的历史轨迹会随着任务进行越积越多。超长的历史轨迹会显著拖慢模型的速度并带来高昂的费用。
codex 通过总结来进行上下文压缩
目前常见的上下文工程(Context Engineering),主要通过裁剪 [1] 或总结 [2] 来压缩历史文本。然而,早期文本一旦被修改,模型已经计算的后续缓存(KV cache)会随即失效,剩余文本必须重新输入模型计算(re-prefill),引入额外延时和成本。此外,压缩也会丢失历史信息,影响 Agent 任务的成功率。
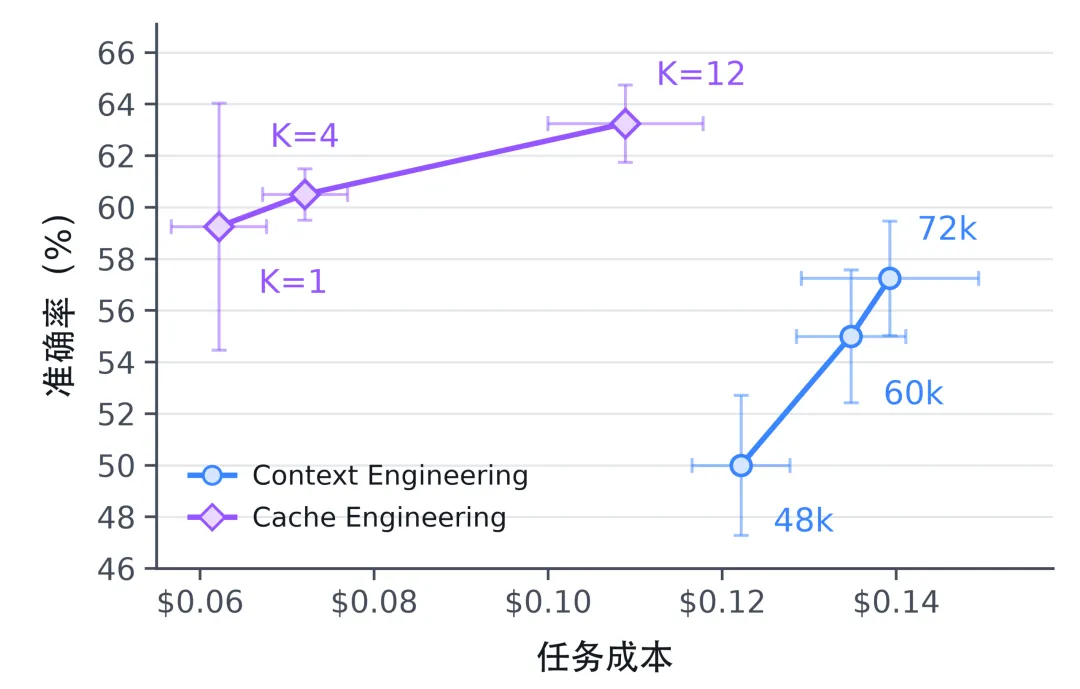
缓存工程和上下文工程执行相同任务的成本和准确率
针对这一问题,清华与香港中文大学的研究团队提出了缓存工程(Cache Engineering),并开源了对应的推理系统 AKV。缓存工程不压缩历史文本,而是允许 Agent 直接管理后续推理使用的缓存(KV Cache),同时加速运行、降低成本并提高任务成功率。在三个模型、四个 Agent 任务的评测中,缓存工程相比上下文工程,平均推理成本降低 27.7%,平均任务成功率提升 1.7%。
本文的共同第一作者为清华大学电子系 NICS-EFC 实验室的博士生傅天予、本科生王若溪和闵子涵。
论文标题:Cache Engineering for Agents
论文链接:arxiv.org/abs/2610.28577
项目主页:fuvty.github.io/thinking_yard_project_page/projects/akv/
开源代码:github.com/thu-nics/AKV
上下文工程:重算缓存引入额外代价
以「通过多轮网页搜索回答用户问题」为例,上下文工程的做法是删掉已阅读的旧网页。这看起来只是少了一些文字,但后续推理的 KV 缓存,是在「读过这段网页」的条件下算出来的。删掉前文后,就得把保留部分重新算一遍,这就是 re-prefill。
论文发现,在 BrowseComp-Plus 任务上,如果只保留最近 12 轮工具调用的结果,总推理成本反而会达到完整上下文的 1.85 倍。这揭示了上下文工程的主要问题:直接修改上下文,导致缓存重算,引入的额外成本有时反而超过其省下的成本。
研究团队因此把关注点转向缓存本身:能否少读一些缓存,同时让已经算好的状态继续用?
缓存工程:直接管理缓存,避免缓存重算
相比上下文工程的文本修改,缓存工程保留所有历史文本,直接缩减不再需要的 KV,继续复用其余缓存。
保留下来的 KV 还可能携带已移除历史的信息。例如,旧网页参与过后续推理,即使网页自身的 KV 缓存被移除,后续推理的 KV 缓存仍可能保留其中的部分信息。
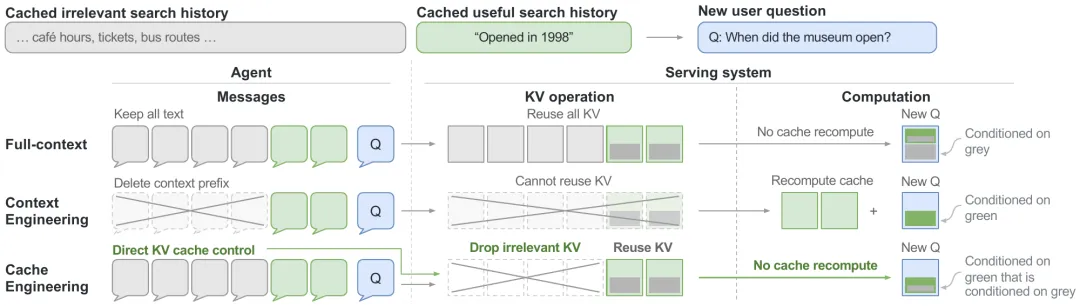
修改文本前缀需要重算后续缓存;直接移除部分 KV,则可以继续复用保留的状态。嵌套色块表示保留状态可能携带此前历史的信息
在缓存工程中,团队提供了三种操作:
App
来源:机器之心