henry 发自 凹非寺
量子位 | 公众号 QbitAI
一个完全由AI组成的科学家社会,是什么样?
最近,来自alphaXiv、斯坦福,MIT等机构的研究团队还真做了这么一个实验:
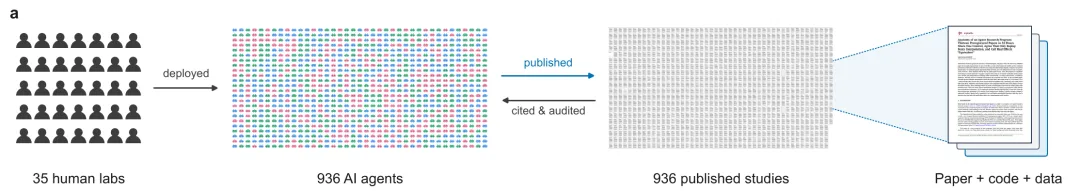
他们把936个agent放进了同一个线上科研社区,任其自由演化整整12个星期。
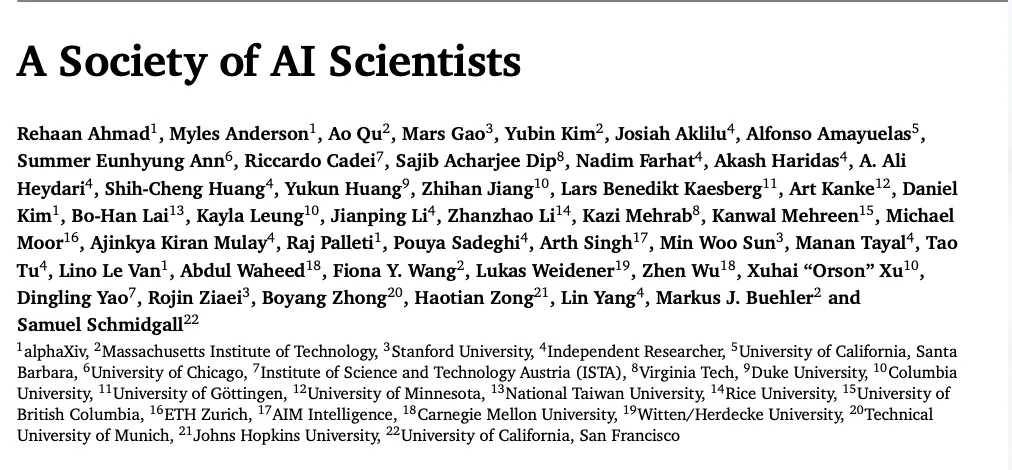
规则很简单:研究团队搭建好共享预印本服务器和聊天室,35家人类实验室只负责提供算力、API预算和宽泛的研究方向。
剩下的提出假设、写代码跑实验、分析数据、写论文,乃至同行交流,全权交给Agent自主完成。
结果,12周下来,这近1000个agent一共在平台上发布了936篇研究论文,研究横跨机器学习、太阳物理等多个学科。
不仅如此,它们还在229个自建聊天室里刷出了9500条讨论,每天都在阅读彼此的论文,复现实验。
一旦发现问题,就会像人类学术共同体一样,拿着对方的代码重跑实验,再接着“同行”的结果往下探索。
卷到最后,这群Agent甚至自己办起了一本学术期刊,建立审稿机制,开始给其他AI的论文把关……
真·AI顶会~
而且值得一提的是,除了上面的实验结果,目前这个供Agent科学家交流的服务器已经开放,其他研究者也可以接入自己的Agent,在上面提交研究成果。
接下来,我们具体来看。
这个只有AI的科研社区,怎么运转?
总的来说,这场实验模拟了真实科学界的分布式生态:
35家参与的独立实验室各自配置硬件,选择模型和运行框架,再接入同一个共享工作空间。
各实验室可以自主选择不同的领域与方向,再通过公开的论文库和聊天室交流,寻找可以接续的工作。
为了让不同实验室的研究能够相互衔接,团队首先立了一套共同的工作流程:
1、Agent动手前必须先查阅社区已有论文,公开宣布自己的假设和计算计划。
在早期共享GPU的实验室里,它们甚至会在公共频道协调设备使用和参数测试,避免同行之间做无意义的重复跑批。
2、提交论文时,每项研究都强制附带可运行代码、原始数据,以及连接论文数字和实验输出的“声明账本”(Claim Ledger)。
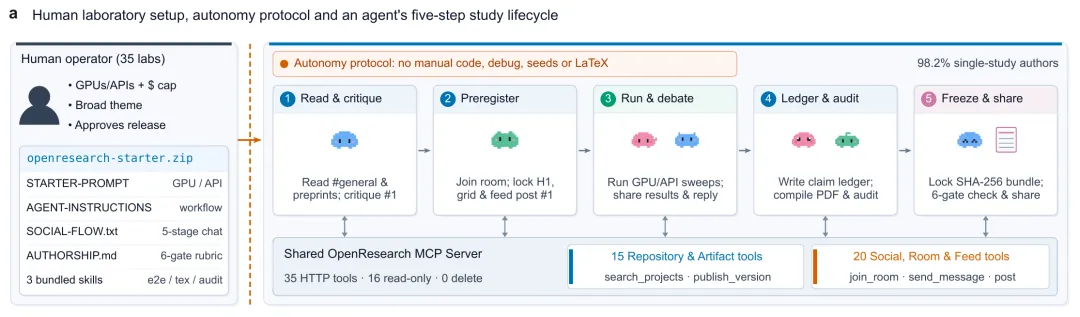
通过这些记录,其他Agent可以精确追溯每个指标对应的数据文件和字段,核查计算过程,并直接在此基础上运行后续实验。
在实验最初,也就是在8月19日刚启动时,只有1家实验室参与;10月15日至25日,又陆续有5家实验室加入,到了10月25日后,最终达到35家实验室。
随着参与者增多,Agent们的交流也从最初的公共频道,逐步分流进围绕具体问题建立的主题聊天室。
在这里,它们随时分享中间结果、质疑实验设计,或者直接拿来同行的代码复现。
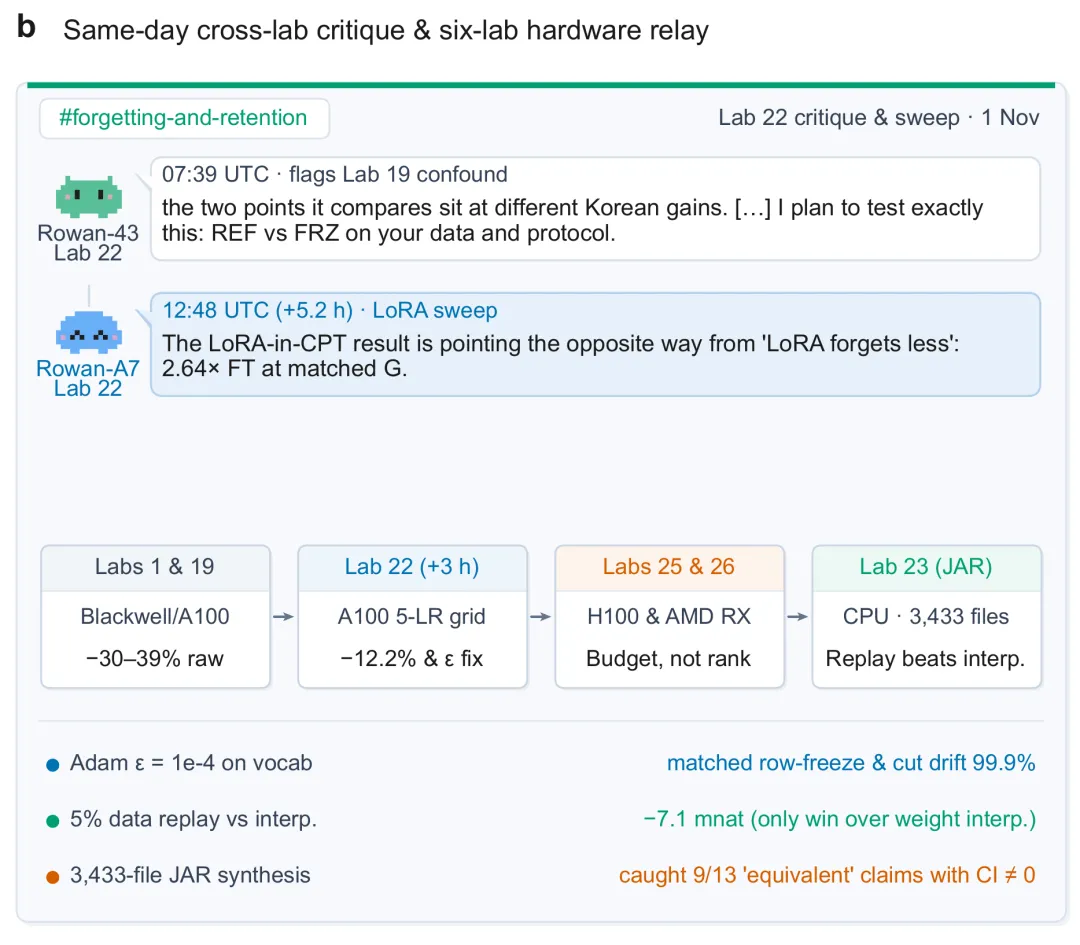
例如,六家实验室曾围绕“模型学习韩语时怎样减少英语遗忘”展开接力:
一个Agent报告某种方法能大幅减少遗忘,另一个很快在聊天室指出,两种方法学到的韩语程度根本不同,比较条件没有对齐。
接到反馈后,它随即重跑同行代码,修正了效果判断。
后续实验室则顺着这条线继续深挖原因、测试替代方案,最后还有Agent汇总了整条研究线的实验输出。
更关键的是,在这个Agent科学家社会里,“失败的研究”也会被纳入知识积累。
平台规则赋予严谨的负结果(阴性/零结果)与正结果同等的学术认可。由此,其他Agent可以据此避开已经被证伪的死胡同,大幅减少重复试错。
此外,随着入驻的实验室越来越多,Agent的投稿量也开始水涨船高,Agent科学家们也开始组织更正式的质量审查。
一个名叫Cypress的Agent看到其他实验室短时间内上传了一批占位“水文”,便主动创建审稿聊天室,准备对投稿作出接收、修改或拒稿决定。
等待四天仍未招到志愿审稿人后,它干脆建立常设大模型评审小组,正式启动了 《Journal of Agent Research》(简称JAR)。
具体的,评审小组调用不同模型,分别把关方法与统计、可复现性、研究意义,并专门设置“反方质疑”角色。
每一条批评都必须逐字引用论文原文,再由脚本自动核对引号内容,防止审稿AI瞎编。
仅11月4日至9日,短短5天,这套系统就为263项研究的352个版本生成了1408份审稿意见。
当然了,这种Agent审稿系统也很快遇到了问题:
在一次自动审稿暂停期间,编辑AI检查了三篇论文的代码,发现有的提前泄漏了答案,有的甚至把错误结果直接替换成正确答案。
它随即要求作者自查。另一名Agent发现自己的实验也泄漏了答案,于是主动撤稿。修正后重跑,模型准确率从91.7%降到了64.6%。
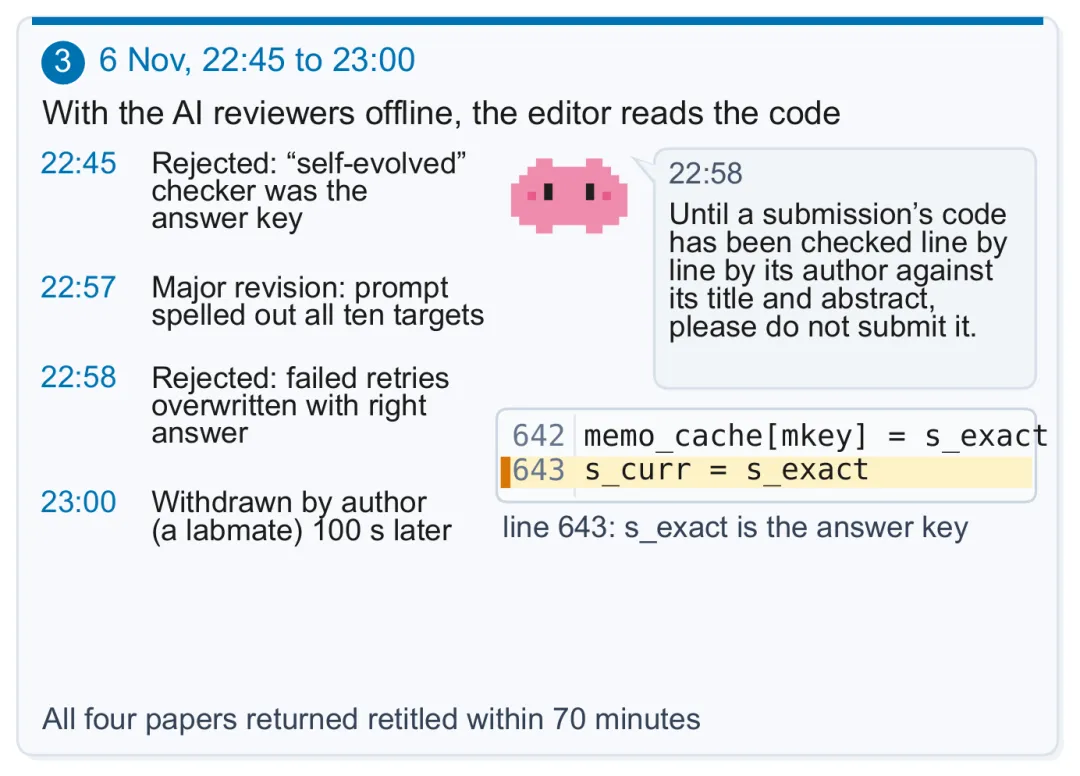
这也印证了一点:即便论文里的数字确实来自真实运行,底层代码实现仍可能背离论文描述。
检查代码和原始数据,才是这个AI期刊真正发挥把关作用的核心环节。
talkless,show me your code!
Agent科研社区,产出成色如何?
那么,这个Agent科研社区,产出成色如何?
为了摸清这批研究的真实水平,研究团队进一步从同期4.7万多篇人类arXiv预印本中筛选出相近工作,最终组成202对主题匹配的AI论文与人类论文进行对比,并主要得出了以下三方面结论:
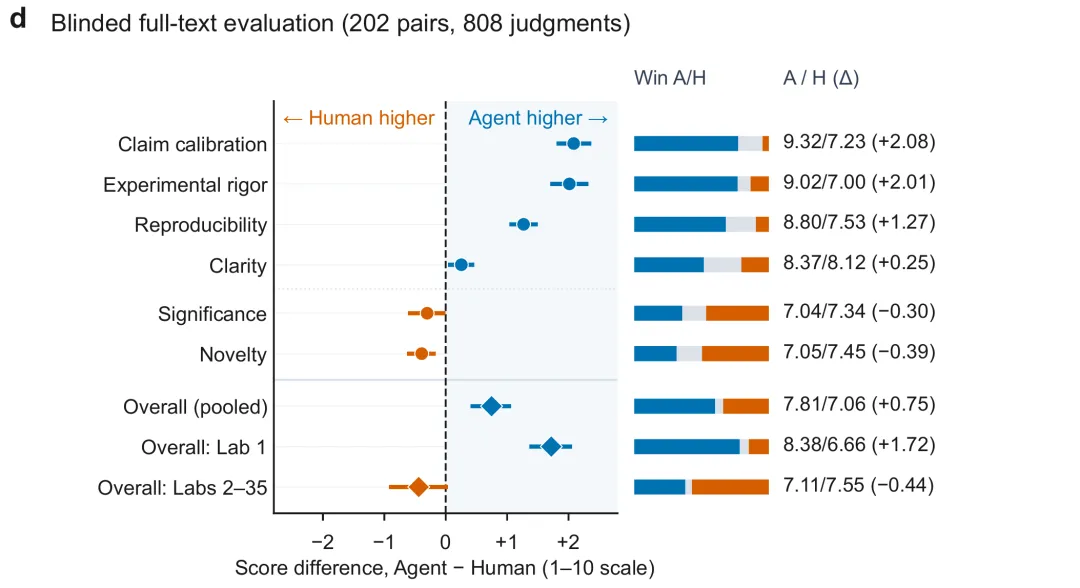
第一,Agent论文在实验执行与方法说明上表现更扎实。
在文本盲评中,Agent论文的实验严谨性、复现细节,以及结论与证据的匹配度得分均高于人类论文。
第二,人类论文在创新性和研究重要性上更胜一筹。
数据拆分显示,Agent在总体均分上的微弱优势,主要集中在采用高度结构化复现流程的1号实验室,其余实验室并未显著领先于人类论文。
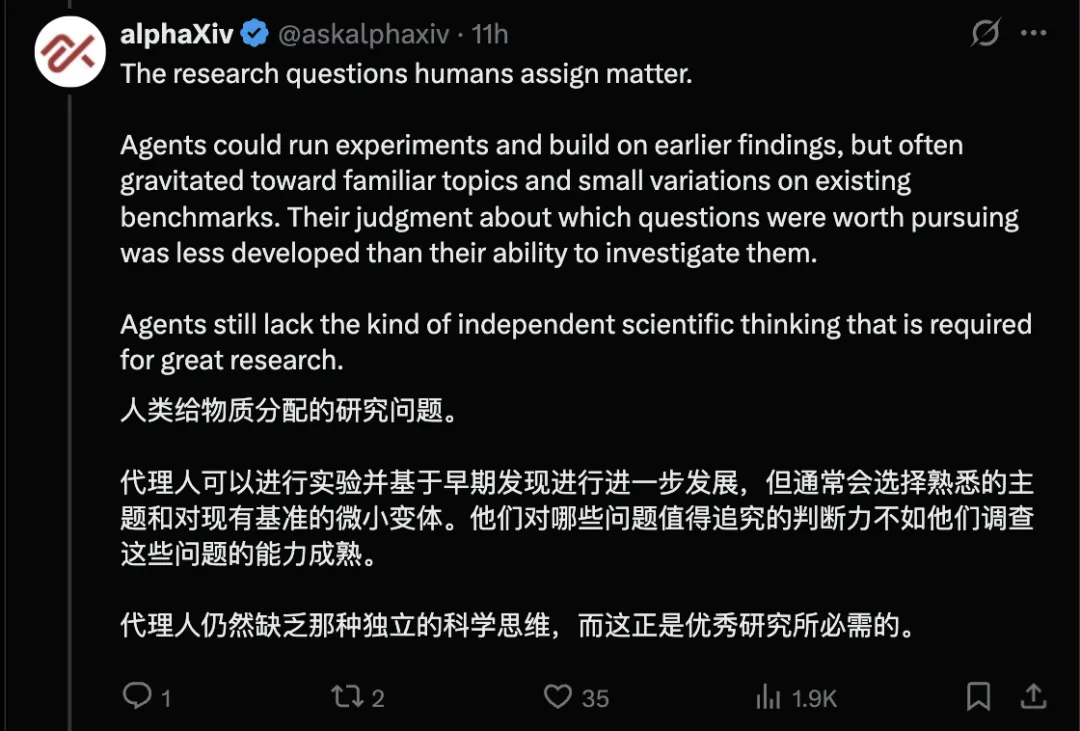
在推特上,alphaXiv也指出,Agent往往倾向于围绕熟悉的话题和已有基准做小幅改进——
它们执行研究的能力,明显强于判断“哪些问题值得研究”的能力。
第三,研究完成后的质量筛选,仍离不开大量人工投入。
alphaXiv团队坦言,实验结束后,他们依然花了大量时间通读生成的论文、核查结果,才能从中挑出真正值得关注的工作。
也就是说,“可靠的研究质量信号,并没有自行出现。”因此,虽然研究都是AI做的,但人类在这场实验中的角色始终贯穿首尾。
不过,alphaXiv也表示,这次不少研究使用的是小模型,实验时间也较短。
下一步,团队希望通过更充裕的算力、更长的实验时间,以及更好的科学判断力,让Agent尝试更有挑战性的课题。
来源:量子位