走向物理 AI 时代,构建一个能真正统一语言与视觉的多模态基座模型是关键一步。然而,语言本质上是有序的 Token 序列,视觉则是连续的高维像素分布,两者在信息结构上存在天然的鸿沟。如何在一个模型内统一这两种截然不同的分布,一直是一个备受争论的话题。
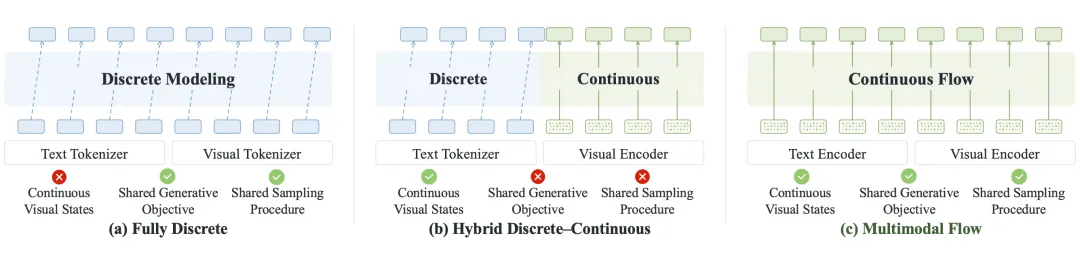
目前,主流的解法主要有两条。一条是全离散路线(如 Chameleon、Emu3),它把图像也量化成离散 Token,与语言拼在一起做自回归建模。但这种方法受限于视觉 Tokenizer,图像的高频细节在量化过程中极易丢失。另一条是混合离散 - 连续路线(如 Transfusion、JanusFlow),文本走离散预测,图像走连续扩散。虽然避开了量化瓶颈,但一个模型里得同时维护两套截然不同的目标函数和采样流程,不仅工程实现复杂,联合优化的难度也很大。
既然两条路都有妥协,有没有第三种解法?
近日,华中科技大学王兴刚团队与地平线机器人等机构合作,提出了 Multimodal Flow,给出了第三条路线:全连续。在这个架构下,语言和视觉各自保留在原有的连续嵌入空间中,但共享同一个 Flow Matching 目标。这意味着,模型无需强行将视觉翻译成语言,也不用维护割裂的两套系统,仅用一个 Flow 模型就能统一建模两者的联合分布。实验表明,Multimodal Flow 不仅展现出了强大的多模态泛化能力,混合预训练阶段学到的知识也能高效迁移至下游任务;在同等数据与参数预算的受控对比中,它的表现更是全面超越了混合式和全离散架构。
论文标题:MULTIMODAL FLOW: UNIFIED FLOW MODELING OF LANGUAGE AND VISION IN EMBEDDING SPACES
1.6B 模型,展现了什么信息
在谈理念之前,我们先看干货数据。团队实例化了主模型 MF-1,仅有 1.6B 参数,并且是从零开始预训练,仅消耗了 150B Tokens。相比当前动辄上万亿 Token 的大模型,这个数据量相当克制,但成绩却十分亮眼。
在文本生图方面,MF-1 在 GenEval 综合得分上拿到了 0.821,DPG-Bench 长提示词对齐得分为 83.44。尤其在 GenEval 的 Counting(计数)维度上,它达到了 0.73,大幅领先同等规模的统一模型。而在多模态理解方面,它的 VQAv2 得分 72.6,MMBench 得分 67.2,POPE 得分 86.1,三项平均得分达到 75.3,甚至超越了部分用预训练 LLM 初始化的同体量模型。
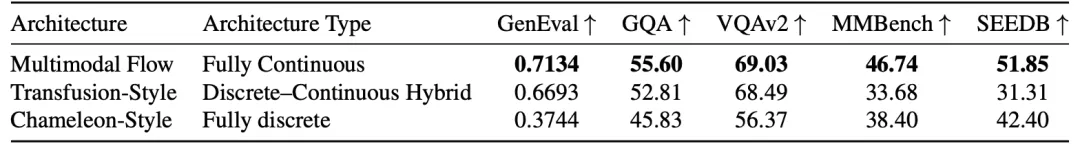
更重要的是,在同等数据、同等参数预算、同等优化配置的受控对比下,Multimodal Flow 在 GenEval、GQA、VQAv2、MMBench 等各项指标上,全面超越了 Transfusion 式的混合架构和 Chameleon 式的全离散架构。这说明全连续架构并非为了不同而不同,它是实打实能打的新范式。
如何把语言和视觉放进同一个 “流” 里?
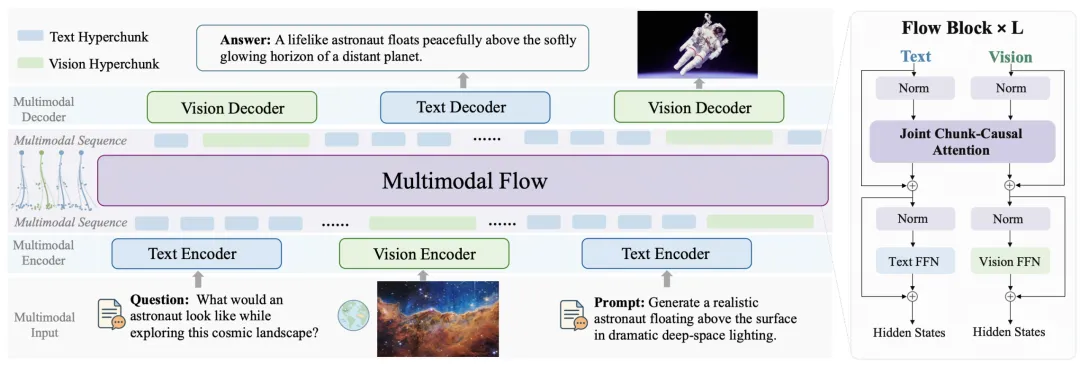
既然成绩这么好,那这套全连续架构究竟是怎么运转的?核心在于他们提出的超块(Hyperchunk)设计。
既然语言和视觉的结构不同,团队干脆让它们各自保留原生形态。文本被划分为每 8 个 Token 一块,经过冻结的 T5-small 编码器变成连续的文本超块;图像则经过冻结的 SigLIP2 编码器,提取出 16×16 的空间网格特征,变成一个视觉超块。这些超块按照任务设定的顺序排成一条多模态序列,直接送入共享的 Chunk-Causal Flow 骨干网络。
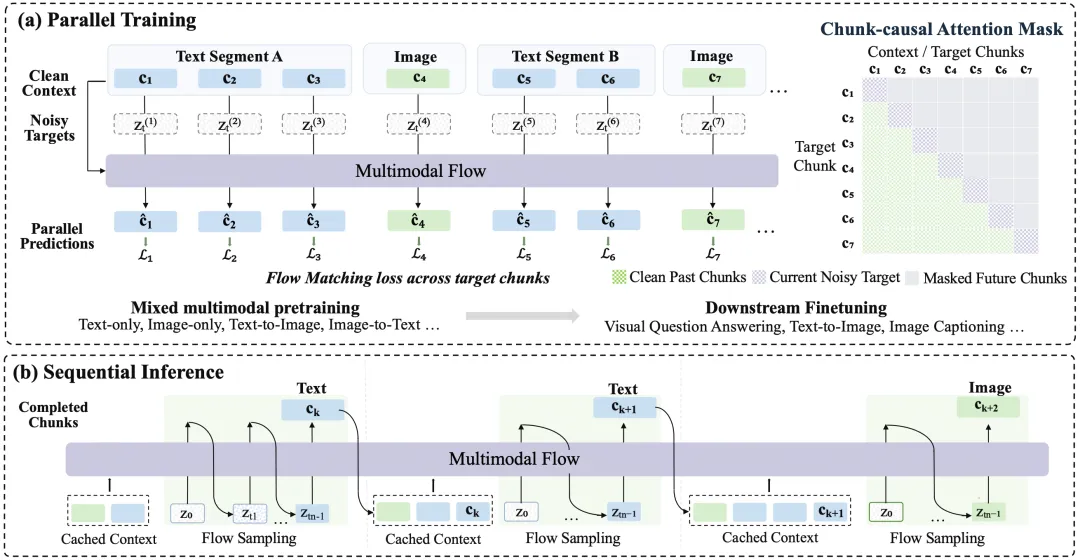
这个骨干网络的设计非常巧妙。在注意力机制上,它采用了 Chunk-Causal 掩码:当模型在预测第 k 个超块时,前面的所有超块是完全可见的,当前超块内部的位置联合建模,而未来的超块则被遮蔽。这既保证了因果性,又允许当前块内的信息充分交互。与此同时,网络在计算时采用了 “联合注意力 + 模态特定 FFN” 的混合策略:注意力层共享,以促成语言和视觉的跨模态交互;而 FFN 层则保持独立,因为语言和视觉的表示统计差异太大,强行共享反而会适得其反(论文消融实验也证实了这一点)。
在训练和推理机制上,这套架构也展现出了极高的效率。训练时,模型可以同时并行预测多个目标超块,每个超块独立采样 Flow 时间步;而在推理时,则按顺序逐块生成,已完成生成的超块 KV 缓存会被直接复用,大大加速了生成过程。
这套设计带来的一个非常优雅的结果是:只要改变超块的排列顺序和目标方向,同一套网络参数就能无缝切换任务。 无论是纯文本生成、文生图、图生文,还是 VQA,都可以被统一表达为 “超块序列的条件生成”。任务定义和生成建模在这一刻被彻底解耦了。
混合预训练:全连续架构的基座价值
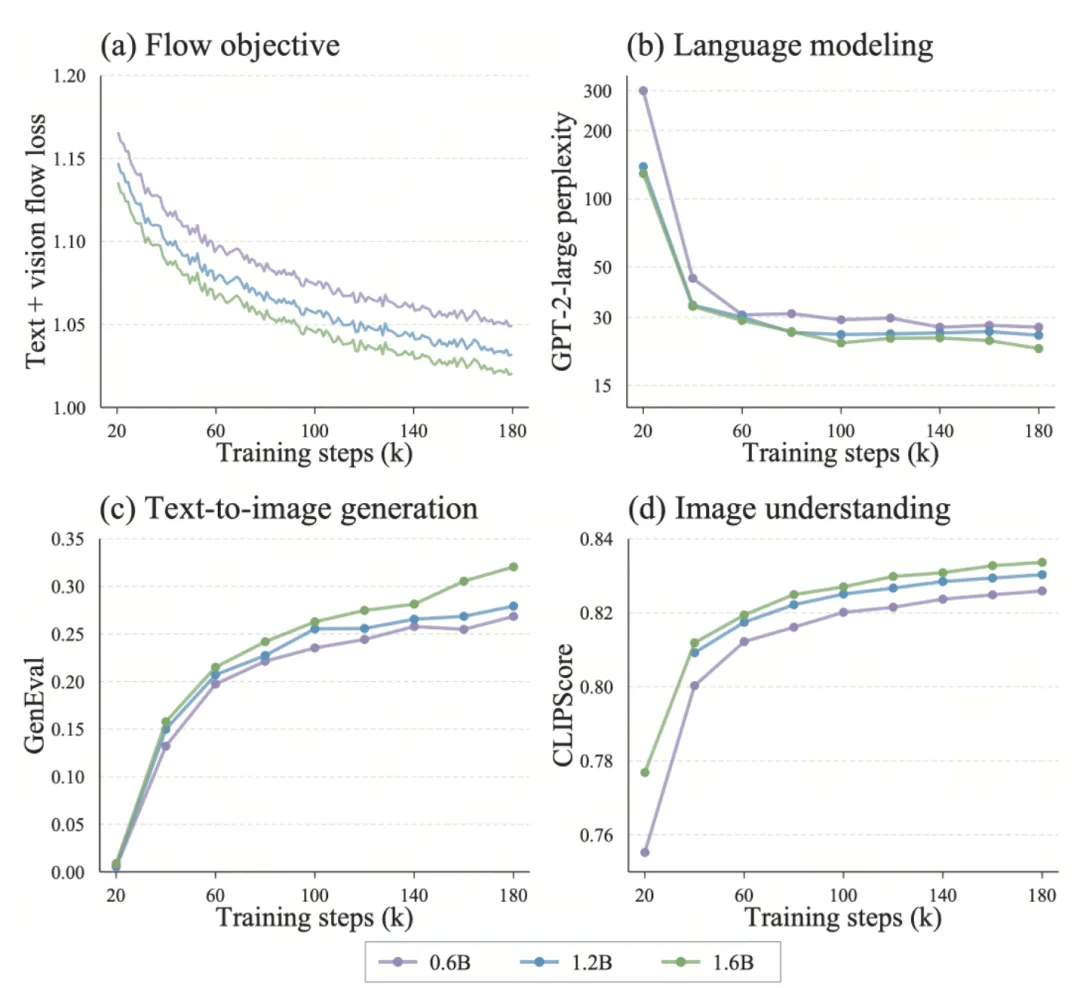
既然选择了从零预训练,团队自然要验证多模态混合预训练的实际价值。首先看规模扩展(Scaling)。团队训练了 0.6B、1.2B 和 1.6B 三个尺寸的模型,在相同的混合预训练协议下观察它们的演进轨迹(Figure 4)。结果展现出了健康的初步扩展趋势:随着模型变大、训练步数增加,Flow Matching 的目标损失和语言建模的困惑度(PPL)都在稳定下降;与此同时,文生图的 GenEval 和图生文的 CLIPScore 指标则在稳步上升。特别是 1.6B 模型,在训练后期展现出了最强的综合性能。
再看迁移,他们对比了 “随机初始化直接下游微调” 和 “先混合预训练再微调” 两个模型。结果很显著:GenEval 从 0.527 提升至 0.821,SEED-Bench 从 31.6 跃升至 62.4,MMBench 从 36.0 提升到 67.2。
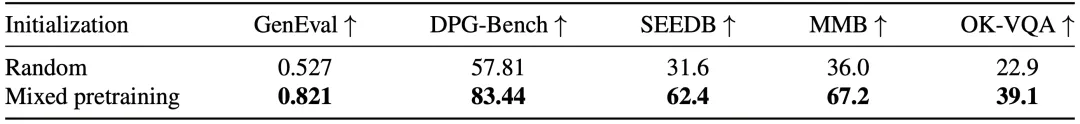
这组数据有力地证明了,在统一的 Flow Matching 目标下,模型在混合预训练阶段所习得的文本、图像、图文对联合表示,能够高效地迁移到下游任务中。Multimodal Flow 不仅仅是一个多模态生成器,它更展现出了作为一个优秀多模态预训练底座的巨大潜力。
消融实验里的两个发现
在验证设计合理性的过程中,团队做了大量细致的消融实验,其中有两点发现非常值得关注。
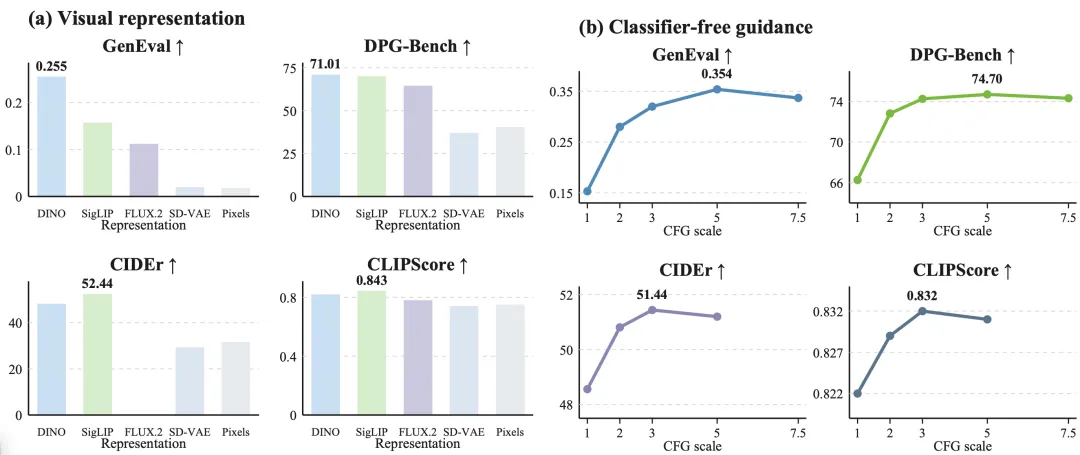
第一,模型到底需要什么样的视觉表示? 团队对比了 SigLIP2、DINOv2 这类语义特征,以及 FLUX.2 VAE、SD-VAE 潜变量和原始像素。结果是,在相同的训练预算下,SigLIP2 和 DINOv2 在生成和描述任务上整体表现更好,而面向重建的 VAE 潜变量反而落了下风。这给未来的多模态生成提供了一个重要暗示:对于统一生成模型而言,富含语义的特征往往比单纯的像素重建保真度更重要。
第二,同一个 CFG 可以双向生效。 传统上,Classifier-Free Guidance(CFG)主要用在视觉生成里。但得益于统一的 Flow Matching 目标,Multimodal Flow 里的同一个 CFG 机制可以同时作用于文本和图像。实验表明,图生文任务的最佳 Guidance Scale 在 3 左右,文生图任务在 5 左右。一套机制,双向引导,再次印证了全连续共享生成过程的简洁与通用。
更简单的模态,更长远的未来
Multimodal Flow 和 MF-1 展现了一种可能:我们不需要把视觉强行翻译成语言,也不需要维护两套割裂的生成目标。在连续的嵌入空间里,语言和视觉可以用同样的动力学系统来建模,同时保留各自的结构特性。
目前的 1.6B 模型和 150B Tokens 只是一个起点。作者在结论中也指出,未来将把该框架扩展到更长的交错图文序列、视频以及其他结构化模态,连续统一多模态模型的想象空间,或许才刚刚打开。
© THE
来源:机器之心