“ 建了就上。
国内机器人数据采集行业,正在进入一个没有人愿意公开承认的阶段。
不是撤,也不是停。是犹豫。
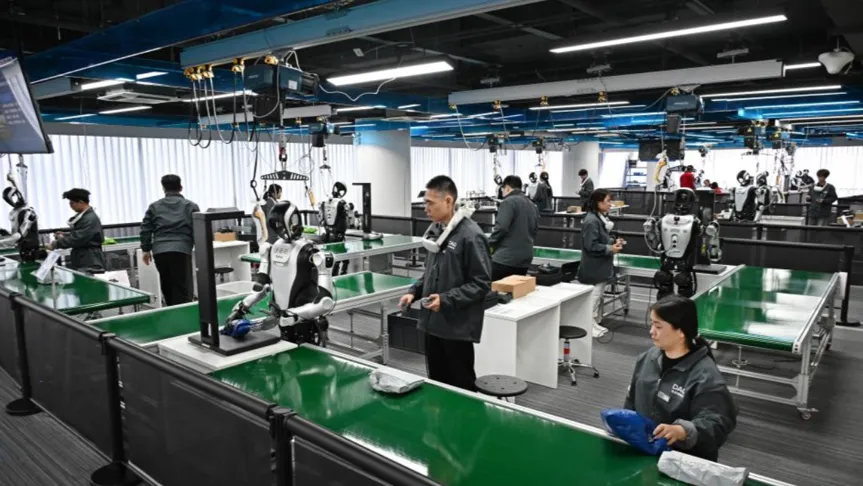
2025年春天到2026年春天,全国集中式具身智能数采中心从冷启动一路拉到月均7个以上的开工节奏,建设高峰出现在2026年一季度。据机器人大讲堂不完全统计,截至2026年8月,已公开披露的集中式数采中心共106个,84家已经投入运营,占比接近八成。
数字上,这轮建设潮已经跑完了。但投运两个字和转起来之间,如今却依然隔着一道没有人算清楚的账。9月份被媒体曝出关联交易后,更是让许多地方都在犹豫,这个模式到底要不要继续上。数采厂模式罕见进入一种犹豫期。
01.
让数据流出来难
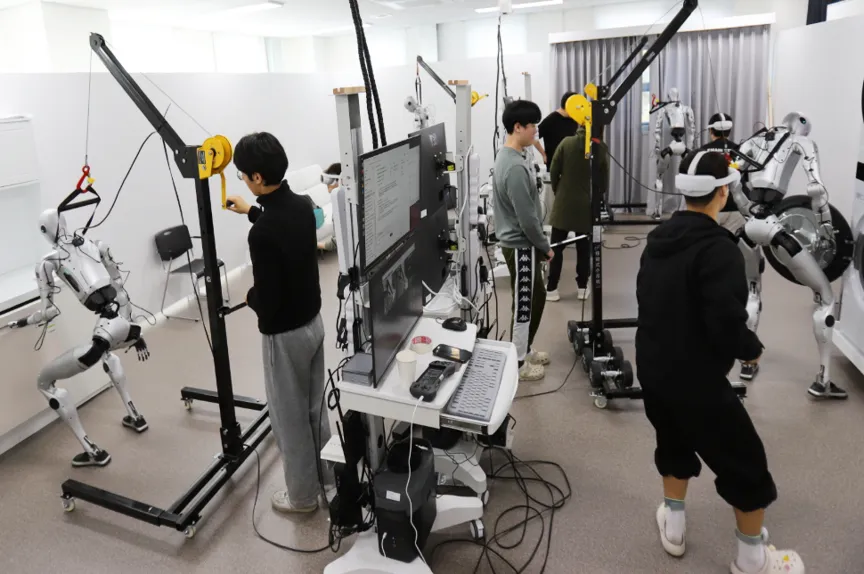
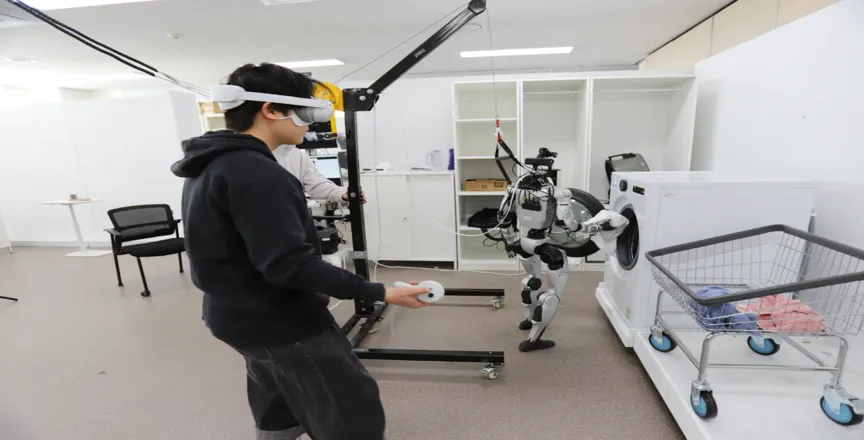
机器人大讲堂粗略统计来看,106家数采厂里,能确认存在实际数据采集活动的只有67个,另有23个主要做训练、测试或验证,27个仍处于规划或建设阶段。
换句话说,挂上牌子和产出有效数据是两个完全不同的状态,而行业统计长期把这两件事混在一起。
即便在真正运转的中心里,产出的性质也有所不同。
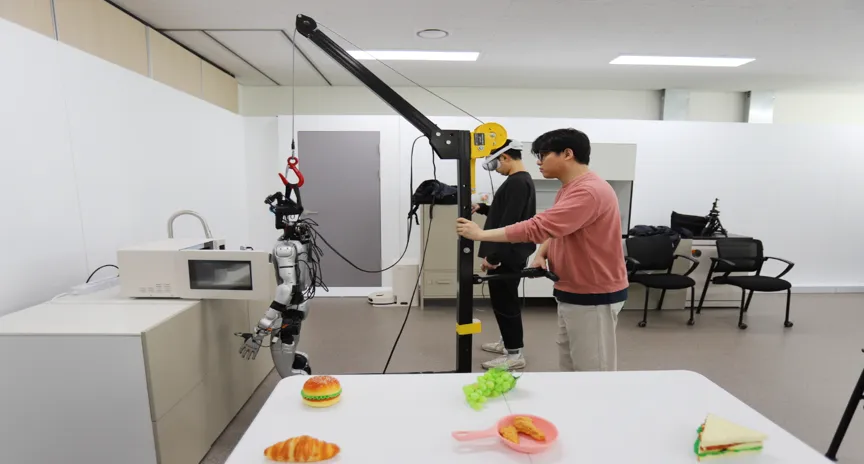
2026年上的大部分数采工厂,单台人形机器人本体成本60万到70万元,一名熟练遥操员一天工作8小时,最终能产出的有效训练数据只有两到三个小时,其余是复位、标注、空转和低质量轨迹。
叠加上场地、折旧、算力和存储,真机数据每小时的硬成本落在数百元到上千元区间。
问题不在于这个单价高低,而在于买方按有效数据付费,卖方按在场小时投入,中间那五到六个小时的差额,没有任何一方愿意认领。
这就是犹豫期的第一层原因。
数采中心建成了,机器人在岗了,但数据从投入端到收入端的转化率,低到让运营方不敢继续踩油门,也不敢直接踩刹车。
02.
格局的分化背后
第二层原因更加隐秘。
因为106间数采中心不是同一种东西。
我们按建设主体拆开,认为大致三类。
一种是机器人本体企业或数据公司自建,直接服务自身模型迭代;第二种是高校和高职院校的实训基地,兼顾教学与采集;第三种,也是数量最多的是政企共建项目,地方出场地、资金和政策,企业出机器人、技术和运营团队。
三类主体如今的犹豫程度完全不同。
自建基地有模型训练需求托底,数据采出来内部消化,账算的是模型能力提升,不是数据销售收入。
高校基地有教学经费和实训预算打底,数据是副产品。
压力最大的是政企共建型,因为地方要产业落点,企业要装机量,两边在建设期高度一致;但进入运营期,数据卖给谁、按什么价格卖、谁来持续付费,这三个问题如今依然没有现成答案。
这里又绕不开一个被反复提起、却此前一段时间经常被媒体讲歪的问题:数据工厂和具身智能企业之间的关联交易。
有媒体此前曝出,不少数采中心的机器人来自关联本体企业,运营方和供货方在股权、团队或地方项目上存在千丝万缕的联系;数据采出来之后,又可能以数据采购模型服务的名义回流到同一体系。
于是外界很容易把这件事一句话定性成为左手卖设备,右手买数据,闭环自嗨。一度影响了部分头部公司的IPO进程。
这个判断下得太快了。买设备本身无可厚非。
数采中心要建,你的机器人就得买;本体企业有产品,数采中心有需求,供货、部署、运维、升级,这是正常的产业分工。
不能因为双方有关联关系,就把设备采购污名化。
人形机器人本体单价高、定制化强、售后依赖深,开源数据集绑定本体,数采中心从熟悉、本土的本体企业采购,甚至在建设期就绑定技术路线,本身是理性的工程选择。
设备是真实资产,机器人是真在数采中心里跑,关节是真在转,这些成本省不掉。
真正需要关注的,我们认为不是有没有关联交易,其实是关联交易里卖的是什么、按什么定价、最后谁买单。
设备采购计入当期营收,数据采购则应该对应数据的长期价值。
如果数采中心买设备是一次性的资本开支,采数据是持续性的运营投入,那么账至少应该分两本。
一本是设备账,按资产折旧、按利用率、按运维成本算;一本是数据账,按有效数据小时、按跨本体复用价值、按外部买方愿意支付的价格算。
两本账混在一起,就容易出现一种看起来很美、实际上悬空的虚假商业闭环。
设备销售确认了收入,数据采购确认了流水,地方项目确认了投资,但最终为数据买单的外部需求始终没有出现。
关联交易的风险不在交易本身,而在于用数据采购的名义,把设备销售的成本转嫁给地方预算或补贴,而数据没有经过外部定价的检验。
买设备是产业行为,买数据才是商业模式。设备可以靠建设期预算推起来,数据只能靠真实场景里的失败、复位和长尾一分钟一分钟攒出来。
买设备无可厚非,但买设备不能替代买数据,因为设备卖出去不等于数据被验证,机器人到岗不等于马上能上岗。
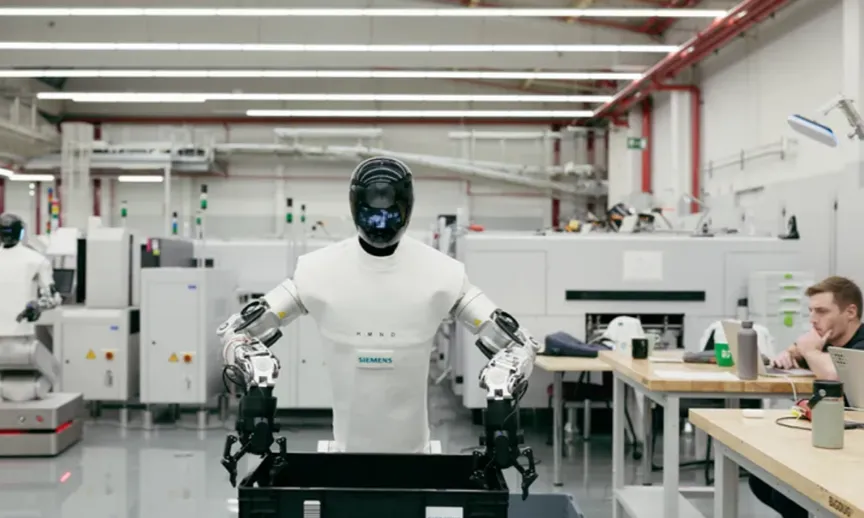
所以对关联交易,更准确的问法不是该不该有关联,而是三个问题:设备价格是否经得起同类产品比价?数据采购是否按有效数据而非在场小时计价?采出来的数据,除了关联方,还有没有第二个愿意持续付费的买家?
这三个问题回答不了,关联交易就会从产业协同滑向内部循环;回答得了,关联交易就是数采中心早期最现实的冷启动方式。
因为具身智能行业就跟AI行业类似,设备是资产,数据是能力。资产可以关联交易,能力不能内部循环。
03.
跨本体复用:第二个没人算的账
数采中心的价值,其实还是需要计算数据跨本体复用的结构性成本。
全国数采中心部署的机器人总量超过5000台,但65.96%的中心采用单一品牌,不同机器人之间的数据格式互不兼容。同一项任务换一台本体,往往需要重新采集。
这意味着,每一间数采中心采出来的数据,很大程度上只对一种身体有用。身体可以快速量产,但数据的通用性远远落后于身体的产能曲线。
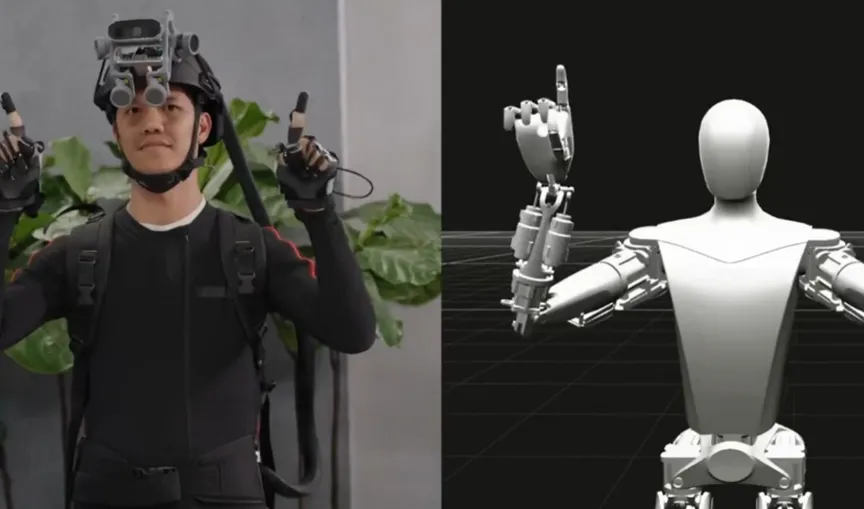
这也解释了为什么行业正在从集中式遥操真机向两条替代路径分流。
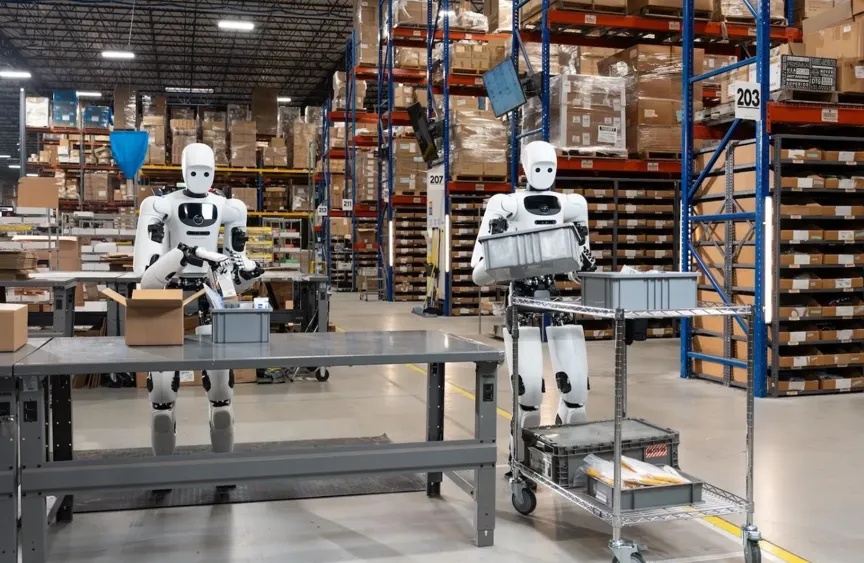
第一条路的轻量化人类视角采集让一线工人在真实作业中佩戴设备,边干活边采,边际成本远低于部署机器人;第二条路的真实场景部署,把机器人放进酒店、车间、仓库,在产线上采失败和复位,而不是在恒温恒湿的样板间里采规整轨迹。
前者降低的是在场成本,后者提升的是数据的真实密度。
04.
海外在买的是另一种东西
根据机器人大讲堂的调研,中国的真机数据并没有卖不出去,它在海外有价差。
国内真机数据价格在500元到1000元人民币每小时,而海外同类数据在600美元每小时以上,差距接近10倍。海外企业倾向于直接购买数据而不是自建中心,部分海外AI公司已经在采购中国人形机器人训练数据。
这说明供给端的数据本身有价值,问题出在国内的需求结构。
头部本体企业多自建采集体系,中小企业缺乏长期采购数据的预算,按小时计价的模式又让买方高度关注数据吃了到底长不长能力。需求没有以可定价的数据订单的形式出现,而是以自用、补贴、关联交易的形式在内部循环。
海外之所以还在建,除了有数据局最近出台政策,让数据不能出海的规定之外,还因为它们算的是另一本账。
例如韩国的数据工厂是财团形式挂进国家AI框架其实在变相支持存储等行业,美国Apptronik的Robot Park有Google的基础模型需求托底,意大利和日本的数据设施带有产业公地色彩。
它们买的是数据到位的时间点和国家能力,不是当期的数据销售收入。
国内第一轮数采中心的建设节奏,用的是产业园区的速度;但运营节奏,面对的是模型训练的慢变量。
05.
犹豫期的下一步:分化,而不是集体退场
106间数采中心不会同时消失。更可能发生的是分层。
有模型训练需求托底的自建基地,会继续运转,数据内部消化,账算在模型能力上。有稳定终端场景和订单的第三方中心,会从卖数据小时转向交付可验证的作业能力,数据是交付物的附属品。
而依赖一次性建设资金、没有持续数据买家的中心,会在运营成本持续发生、收入端迟迟不来的夹缝中,进入事实上的停滞。不宣布关停,但采集活动收缩,机器人利用率下降,团队转向其他业务。
这是犹豫期的第二层含义:不是不知道要不要继续,而是知道继续的方式必须换,但换法的代价还没有人愿意先付。
数据不会消失。会消失的,是那些在样板间里采出来、没有真实失败、没有跨本体价值、也没有人真正买单的数据。
106间数采中心建起来只用了一年半,但让数据从数采中心里流出来、流到愿意持续付费的人手里,需要的时间不以建设周期计。
海外在剪彩的那间数采中心,赌的正是这段时间差。
国内在犹豫的这批数采中心,真正需要回答的只有一个问题:你采出来的数据,除了你自己,还有谁愿意为它定价。
来源:机器人大讲堂