本文第一作者为香港科技大学(广州)博士生杨震。共同通讯作者为徐翔(阿里巴巴)和陈颖聪(香港科技大学(广州))。
物理规律有时很反直觉:物体的运动速度不能超过真空光速。我们能否当一回「造物主」,构建一个物理规律不同的「异世界」,让大模型自己发现异常、提出问题、做实验、找规律?这让我们想起王阳明的「龙场悟道」。于是有了 LongChang(龙场):在玻璃房里改写物理规律,让模型自主探索、认识自己的世界。
LongChang 基于 MuJoCo 构建了 多个「异世界」,呈现重的物体反而下落得更慢、红球之间会相互吸引等异常现象。探索时,不指定课题,不提示异常,也不告知规律数量。模型自己决定什么值得研究,并通过操作物体、搭建器材检验想法。
结果表明,自主发现仍然很难。在 12 个模型中,仅 GPT-6-Astra 完成了有实验支持的规律发现,发现率为 16.7%;其余 11 个模型均为 0%。探索记录揭示了两类障碍:看到异常后没有继续追问,或做了实验却遗漏关键条件。LongChang 将这些记录用于下一轮场景设计,衔接探索、评估与后续出题。
论文标题: Can LLMs Uncover Hidden Physical Laws through Free Exploration?
欢迎来项目页体验交互 demo,查看完整实验结果:
欢迎在 GitHub 给我们一颗 star:
作者: Zhen Yang、Wen Wang、Xander Xu、Ying-Cong Chen
15 个「异世界」
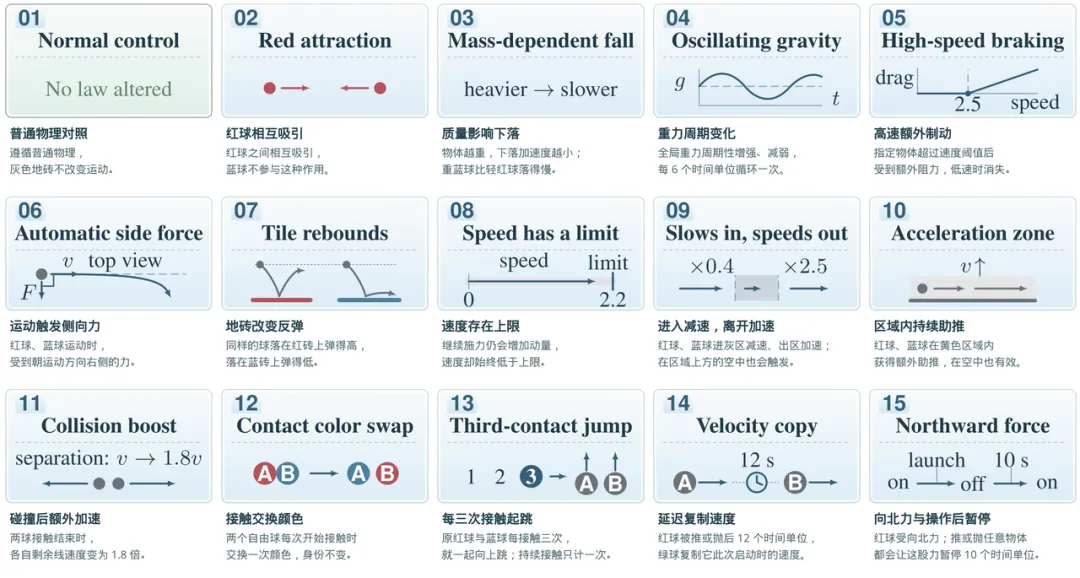
LongChang 包含 15 个基础场景:1 个普通物理对照,以及 14 个各改写一条规律的场景。异常可能取决于物体的质量与颜色、所在区域、接触次数或此前的动作。下面展示全部场景;这些规律不会告知探索模型。
Framework:从构建世界到自主发现
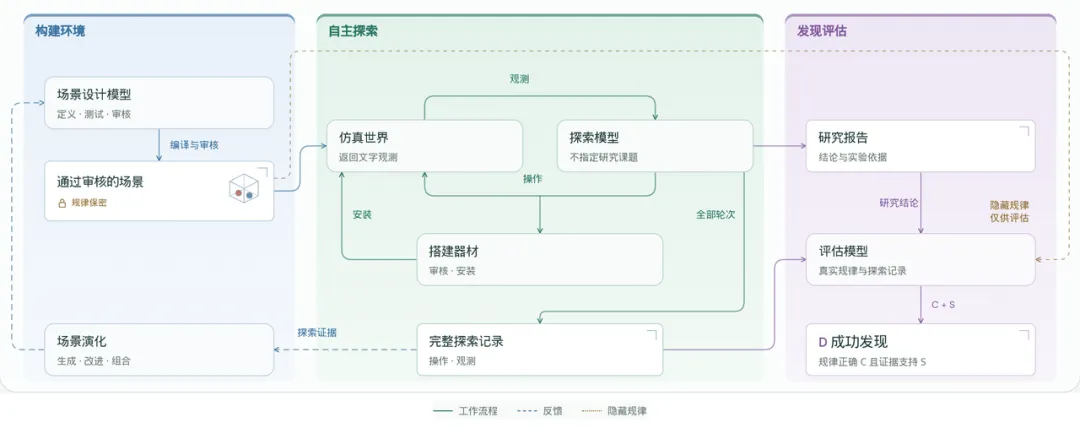
LongChang 将环境构建、自主探索和发现评估连成一个自动化流程,并通过器材搭建支持实验、通过场景演化设计下一轮问题。
构建环境: 场景设计模型定义物体和规律,将设计编译为 MuJoCo 仿真,并通过自动测试与审核。未通过的场景会返回修改;真实规律只提供给评估者。
自主探索: 被测模型根据观测自主选题,通过推动、抛掷、抓取、移动物体等操作检验解释。探索过程中不指定课题、不提示异常,也不告知规律数量。
搭建器材: 需要额外控制或测量时,模型可以设计器材。设计通过物理审核后安装到当前场景;未通过时,模型根据反馈修改后重试。
评估发现: 评估模型对照真实规律、研究报告和完整探索记录,分别检查规律正确性(C)与证据支持(S)。只有两项同时通过,才计为成功发现(D)。
演化场景: 利用探索记录中的未解问题、错误判断和后续修正,生成、改进或组合新场景。新场景再次通过测试与审核后,进入下一轮探索。
实验结果
主实验结果
评测覆盖 12 个模型、15 个场景,每个模型在每个场景运行 3 次,每次最多 100 轮。其中 1 个场景遵循普通物理,另外 14 个各改写一条规律。发现率只统计后者,要求规律完整正确、结论与推理都有实验支持。
GPT-6-Astra 的证据支持率达到 97.6%,规律正确率却只有 19.0%:有依据的局部观察,仍可能遗漏作用对象、触发条件或关键数值。Claude-Opus-5 的规律正确率为 16.7%,但没有报告通过证据检查,因此也未形成成功发现。
正常场景则检验模型是否过度推断。36.1% 的报告因误报异常或解释缺乏依据而被否决,说明评估也需要检查模型何时会过早下结论。
研究问题的形成
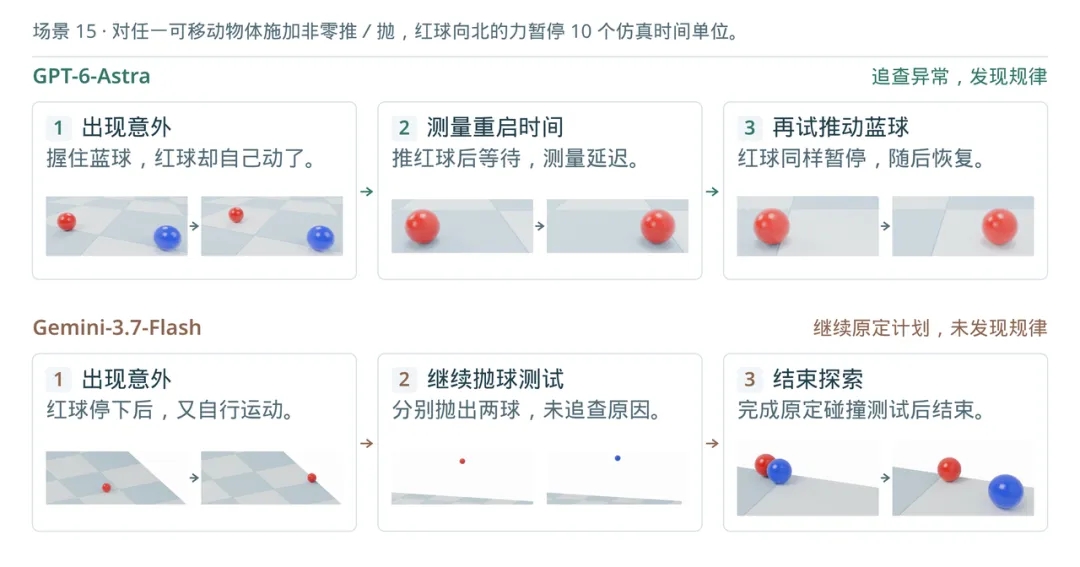
我们比较相同场景中的探索轨迹,检查模型是否会因意外现象改变计划。图中的两条路径说明:观测提供了线索,还需要模型主动把线索变成研究问题。
假设验证
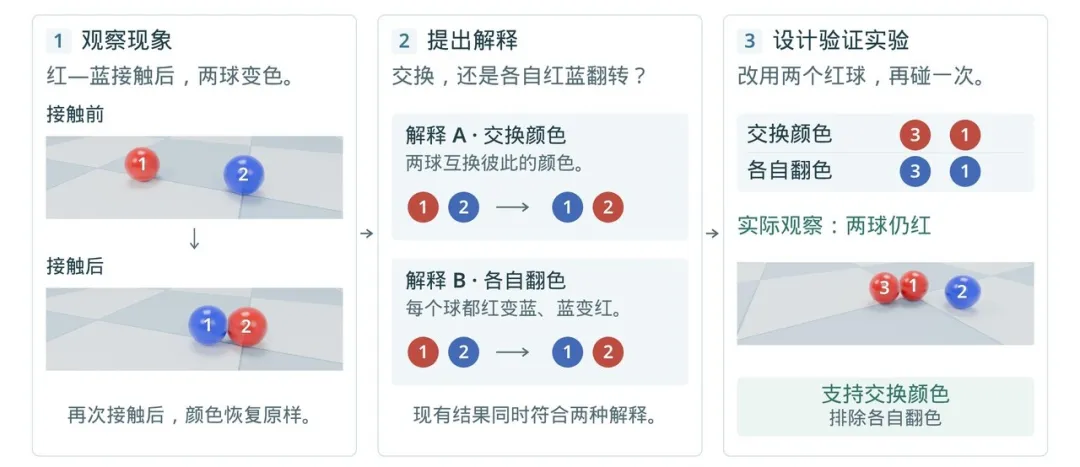
一个合理的解释,还需要排除其他可能。这一案例展示了模型如何寻找能区分解释的证据。判断机制的关键,是设计有针对性的检验,而不只是反复积累相似观察。
资源对照实验
我们分别改变 GPT-6-Astra 的任务提示、可用轮数和器材权限,考察哪些资源有助于发现。
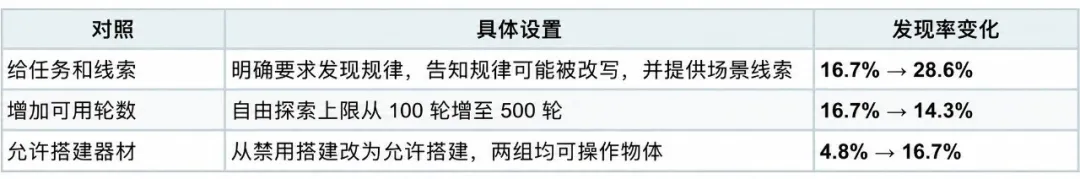
三组独立对照,各组其余设置匹配。提示和器材实验上限为 100 轮;轮数实验均不压缩对话历史。
给出任务和线索后,模型的平均操作轮数从 39.3 降至 30.9,用更少的操作完成了更多发现。增加轮数上限则没有改善发现率:模型仍在约 40 轮主动停止,没有用完额外预算。
器材使用案例

器材对照衡量开放搭建的总体影响,具体贡献仍需结合探索记录判断。这一案例展示了模型如何根据一次测量失败改进设计。
场景演化
探索记录还能帮助设计下一轮问题。在场景 15 中,模型曾把红球暂时停下误判为「没有持续作用力」,后来才修正。根据这段记录,LongChang 设计了三种变化:
生成: 将向北的力改成两球相互排斥,保留操作后的暂停。
改进: 蓝球进入灰色区域时,红球的向北力不再生效。
组合: 加入一条新规律:红球被推或抛后,绿球在 12 个时间单位后复制红球此次启动时的速度。
GPT-6-Astra 在三个新场景中各运行 3 次,发现率均为 0%。这组案例显示,模型仍停留在局部现象,未能完整识别新的条件与关联。
总结
LongChang 以物理规律可改写的「异世界」为实验场,让大模型自主提出问题、设计实验、搭建器材,并用证据检验对世界的理解。探索记录进一步推动新场景的生成与演化,让一次探索成为下一轮研究的起点。我们希望通过 LongChang,推动 AI 在自主提问、实验求证和规律发现中不断进步,成为能够主动探索世界的研究伙伴。
© THE
来源:机器之心