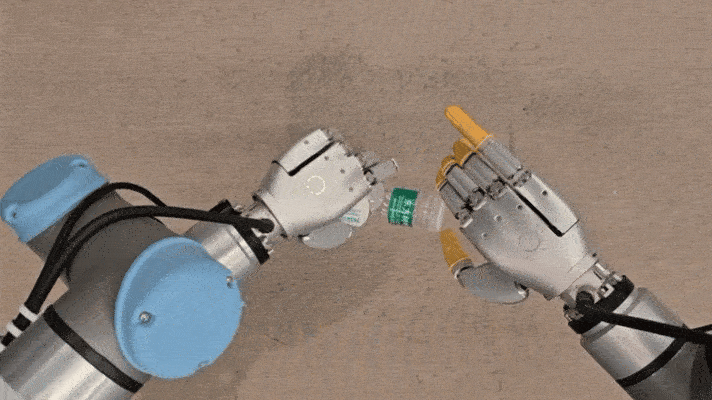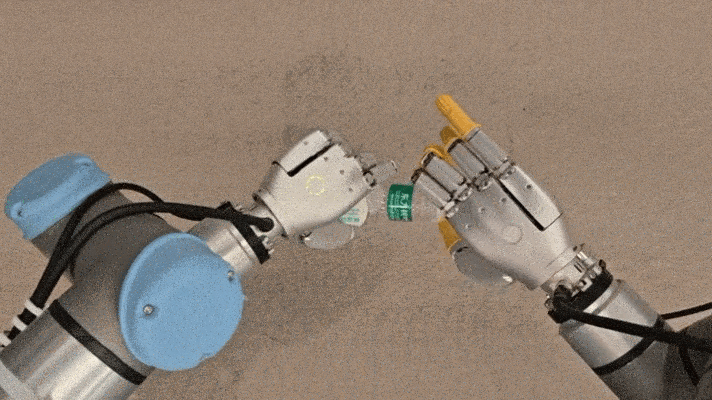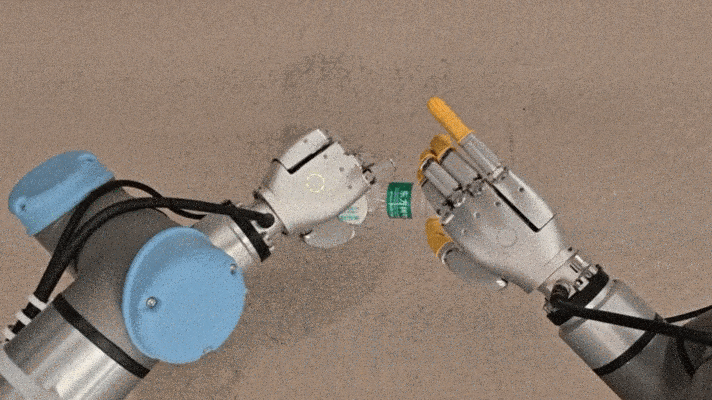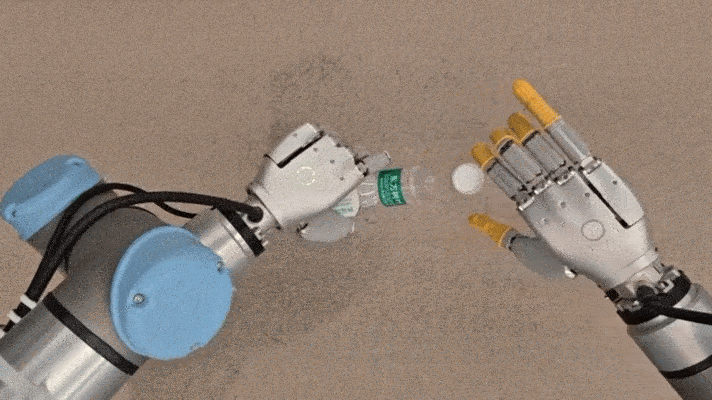
触觉:它在动作生成那一刻才真正有用
——把触觉做成速度场修正
在之前的很多篇分享中,我们都提到过“把触觉直接塞进大模型里,效果经常是负的”。
于是越来越多团队开始研究同一件事:怎么更好的「接入」触觉。
最近,浙江大学、上海创智学院等团队的 TF²-Steering ,提出了一个新的切入点:让触觉在动作被生成的那一刻改方向。
触觉专家在流匹配的每一步预测一个速度增量,把动作专家的速度场"掰"向接触正确的方向。
在基于 Sharpa 灵巧手的真机实验中,平均进度成功率 71.5%,较 T-Rex 的 62.4% 高 9.1 个百分点;插孔任务从 56% 提升至 94%。
问题是"接在哪"
两个一直没有被认真回答的问题
研究开篇提了两问:
第一,怎么把触觉塞进一个视觉主导的基础策略里?
触觉信号在时间上极稀疏(接触只发生在任务的某一小段),数据量也远小于视觉。直接拼进输入,模型要么忽略它,要么被它带偏。
第二,触觉只当反馈,还是也要拿来预测?
人做精细操作其实两条都用:看着物体就能预判该用多大力、什么握姿;真接触上之后,再靠手上的感觉在线微调。现有工作要么只做反应式反馈(T-Rex 那一路),要么只做未来触觉预测,两者很少被塞进同一个因果链条里。
TF²-Steering 的回答是:两个都要,而且都要接到"动作是怎么被生成的"这一步上。
已有的两种接法各有短板
现在主流的隔离手段是残差通路和门控。
残差通路的问题是,它只能在动作已经生成完之后再改,没法把一条本身就走错的动作序列拉回来;
门控保住了主干,但学出来的门可能在触觉特征到达动作头之前就把它衰减掉了,触觉的贡献变得很弱、也不稳定。
相关实验显示同样的架构,只是把修正挪到生成之后,平均从 72.3% 掉到 61.3%,和不加触觉的 61.7% 基本持平。
等于白装。
把触觉做成速度场上的一个偏移量
不换发动机,只调方向
流匹配的动作生成,本质是沿着一个速度场从噪声积分到动作。TF²-Steering 的做法可以一句话概括:
最终速度 = 原速度 + 触觉给的修正量。
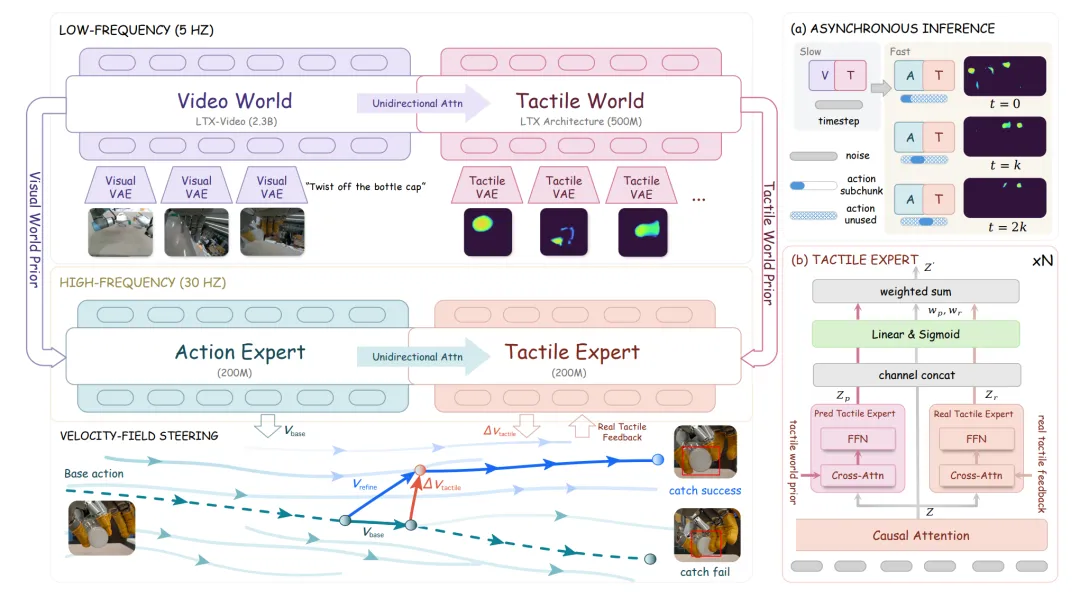
▲图 | TF²-Steering 架构总览。视频与触觉世界模型提供低频规划先验,动作与触觉专家通过学习到的速度增量在高频上完成动作精修;单向注意力使原始世界-动作主干与触觉输入解耦。 ©【深蓝具身智能】编译
换句话说,基础策略还是那个基础策略,它输出的"大致该往哪走"不变;触觉只负责在这个方向上叠加一个局部偏移。
这个设计的直接好处是动作专家可以完全不知道触觉的存在——没有触觉传感器时,只跑 v_base 就行,模型照常可用。这在工程上比"必须带触觉才能跑"重要得多。
训练上有两个关键约束,都是为了让"改方向"不变成"改能力":
单向注意力:触觉专家能看动作专家的特征,反过来不行。视觉—动作主干永远看不到触觉。
停梯度:触觉修正的损失不回传去更新动作专家;动作专家只由自己的动作损失训练。
同时,修正头的输出被零初始化——训练开始时修正量恰好是 0,不会一开始就把预训练策略搅乱。
触觉专家:两路子专家,权重不归一
触觉专家内部是个小型 MoE:
一路处理预测的未来触觉,一路处理实时触觉,各自独立过 FFN,再用 sigmoid 加权融合,两个权重不要求和为 1。
这个细节是有意的:两路信息不是“二选一”,而是可以同时满权重生效,也可以同时被压低。
触觉世界模型:只借特征,不解码图
触觉世界模型建在 LTX-Video 上,约 500M 参数,砍掉多视角交叉注意力、只留约三分之一层数,输入是当前触觉图、预测未来触觉。VAE 先在触觉视频上微调过,所以触觉图有合适的潜空间表达。
有意思的是推理时它不解码出触觉图,而是直接把最后一层的特征交给触觉专家。
这是因为解码既费时又丢信息,而下游要的是"任务相关的接触上下文",不是一张好看的预测图。
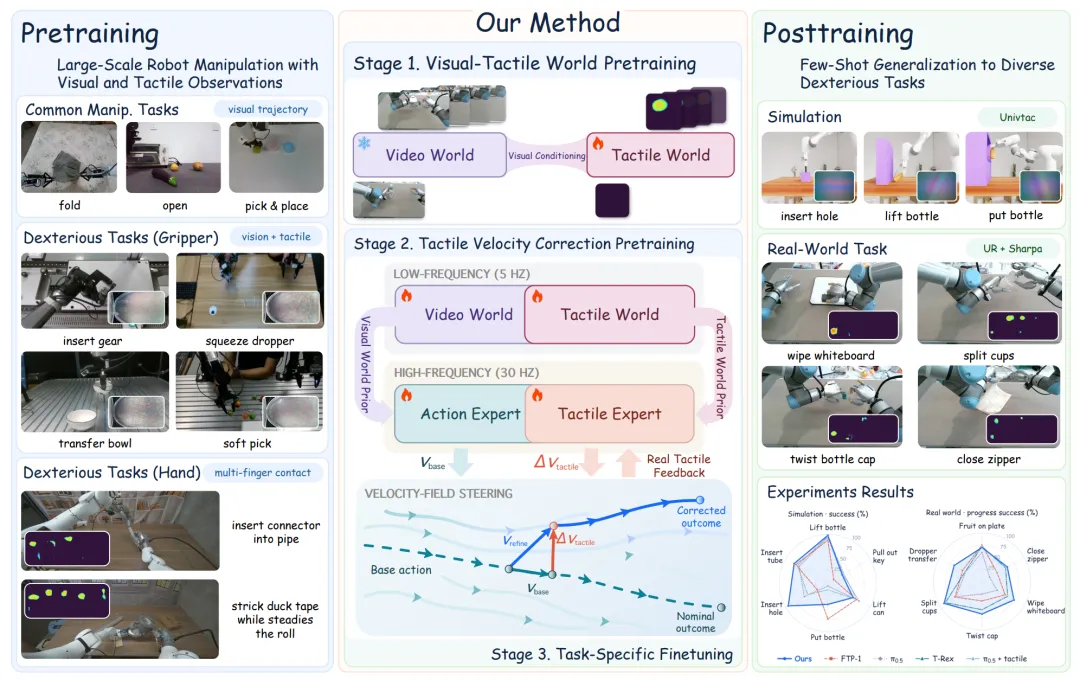
▲图 | 左:纯视觉与视觉–触觉预训练数据。中:触觉专家使用触觉世界模型缓存的预测与实时触觉反馈预测速度增量,修正动作专家的流匹配速度场;视频世界模型与动作专家在没有触觉输入时仍可独立使用。右:任务相关的后训练,以及在仿真与真实世界中的评测©【深蓝具身智能】编译
双速率:5 Hz 想,30 Hz 改
一套系统,两个频率
低频(5 Hz):
视频世界模型(LTX-Video,2.3B)+ 触觉世界模型(500M),负责长时程的视觉与触觉先验,一个动作块只推理一次,之后在整个执行过程中固定不动。
高频(30 Hz):
动作专家(200M)+ 触觉专家(200M),每执行 k 步就拿最新触觉反馈重新生成剩下的动作,已执行的丢掉。
真机实验中,这套高频触觉反馈来自搭载于双 UR5e 机械臂上的 22 自由度 Sharpa 灵巧手,视觉观测由顶部 D455 与腕部 D405 提供。
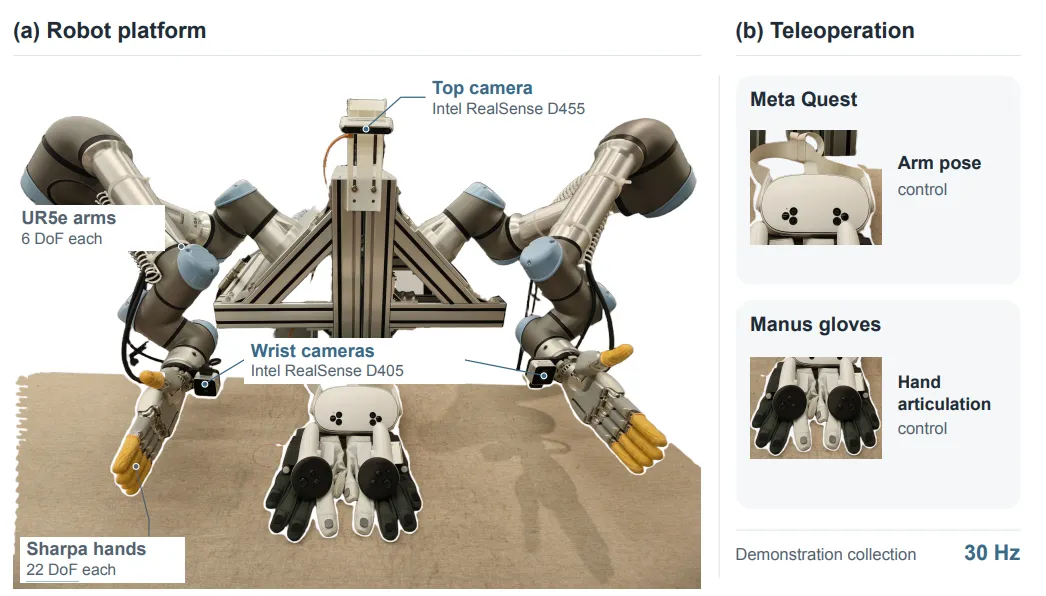
▲图 | 真实机器人平台与演示采集。©【深蓝具身智能】编译
训练时会随机采一个延迟 d(模拟触觉反馈到达的滞后),只在 d 之后的一段窗口内计算修正损失,并给每个动作一个相对时间编码 ρ=i−d,让触觉反馈和"它该修正哪几步"对上号。
推理时 k 可调——这就是响应速度与计算开销之间的那个旋钮。
另外,视频模型训练时把流匹配噪声比设为 1,等价于单步去噪,推理只需一次前向;一个动作块在单张 RTX 4090 上 240 ms 出结果。
三阶段,缺一不可
触觉世界模型预训练:OpenNeoData(30%)+ T-REX(40%)+ FTP-1-Sharpa(30%),5 万步,batch 1024。视觉流冻结,只训触觉模型。
触觉速度修正预训练:四模块 + Q-Former 端到端联训,触觉数据占 90%,另混 10% 无触觉样本保住主干的泛化。
任务后训练:仿真与真机数据上做任务适配。
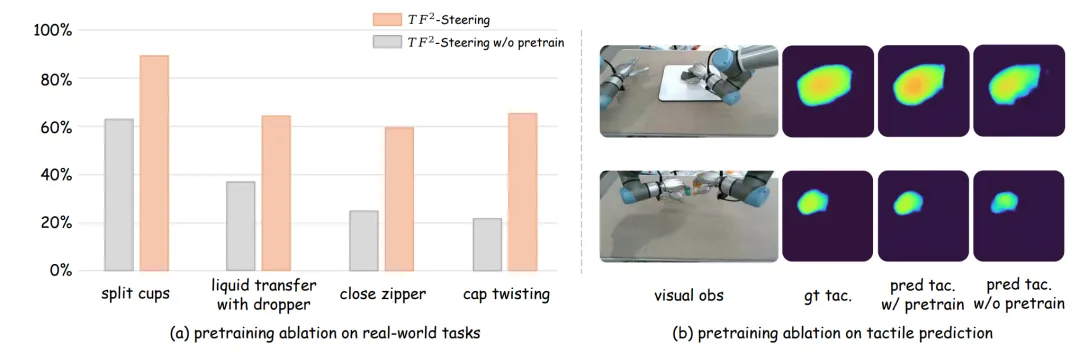
▲图 | 触觉预训练的作用。(a) 四个真实操作任务在有/无触觉预训练下的进度成功率。(b) 触觉预测的定性对比:从左到右依次为视觉观察、真值触觉观测,以及有/无触觉预训练的模型给出的触觉预测 ©【深蓝具身智能】编译
预训练这一项不是可选项。跳过两阶段触觉预训练、直接从世界-动作主干做任务后训练,四个真机任务的成功率全部下降。
实验结果
仿真:均值涨了,但涨幅高度集中
下表里平均 68.3%,比最强的 FTP-1(57.7%)高 10.6 个百分点(论文中写作 10.7,四舍五入差异)。
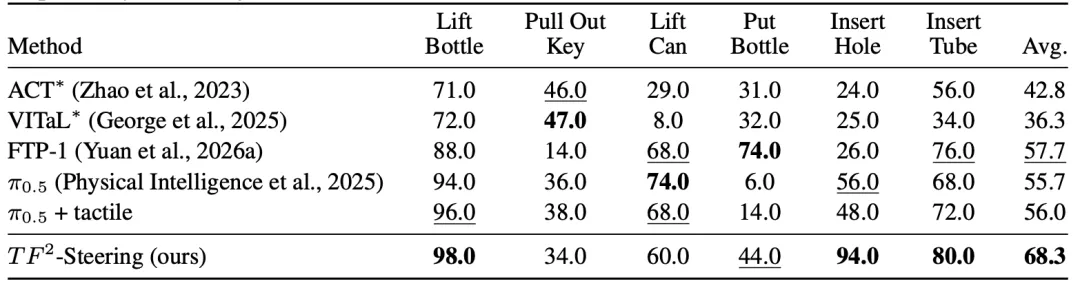
▲表 | UniVTAC 仿真结果。六个任务的成功率(%),Avg. 为宏平均;加粗与下划线分别为每列最优与次优(含并列)。ACT 与 VITaL 的结果取自 UniVTAC ©【深蓝具身智能】编译
增益几乎全部来自 Insert Hole:94.0% 对 56.0%,一个任务贡献了 38 个点。Insert Tube 也从 68 提到 80。
反过来,Put Bottle 只有 44.0%,FTP-1 是 74.0%;Pull Out Key 34.0%,还不如 ACT 的 46.0 和 VITaL 的 47.0;Lift Can 60.0,低于 π0.5 的 74.0。
这说明触觉修正擅长的是“接触几何决定成败”的插入类任务,对以抓取—搬运为主的任务并不占优,甚至因为修正项干扰了原本正确的动作而后退。
均值掩盖了这种任务类型上的偏科。
真机 71.5%,但不是"成功率"
整套真机实验平台搭载 Sharpa 触觉灵巧手,搭配两台 UR5e 机械臂完成全部六项操作。
其中,灵巧手内置的布式触觉传感,能够持续输出高密度接触信号,支撑这类精细、持续接触的灵巧交互;以及 22 个主动自由度和 1:1 人手比例,也为拧瓶盖、拉拉链这类多指协同任务提供了操作空间。
基于这一平台的真机实验结果显示,六个任务的平均进度成功率为 71.5%,较 T-Rex 的 62.4% 高出 9.1 个百分点。
分任务看:拧瓶盖 67 对 58、滴管转移 66 对 46、擦白板 76 对 61、拉拉链 60 对 56、分杯 90 对 87;

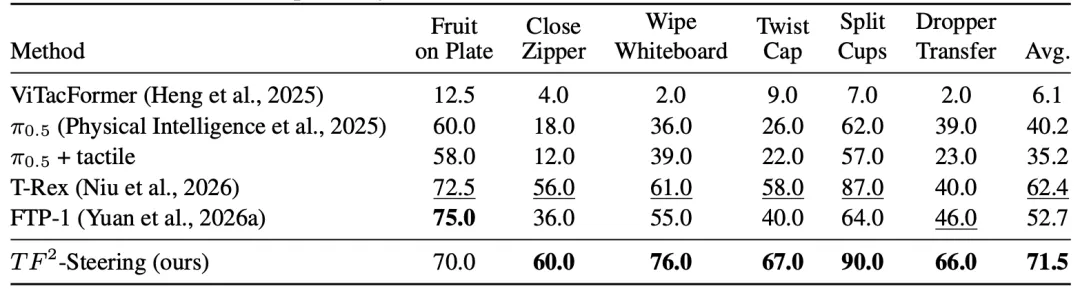
▲表 | 真实世界结果。每个任务 20 次试验的进度成功率(%),Avg. 为六个任务的宏平均 ©【深蓝具身智能】编译
唯独水果装盘 70.0 低于 T-Rex 的 72.5 和 FTP-1 的 75.0。
原因在于:装盘靠的是抓取与放置,触觉的边际价值本来就低。
这里真机用的是进度成功率(PSR),每 20 次试验按里程碑给 0–1 的分,所以 71.5% 不等于"71.5% 的试验完成了任务",它更像"平均完成了任务的七成"。比二值成功率细,但不能和别处的成功率直接横比。
比如拉拉链:提起袋子 0.2、开始拉但未拉完 0.6、完全拉上 1.0,取平均。
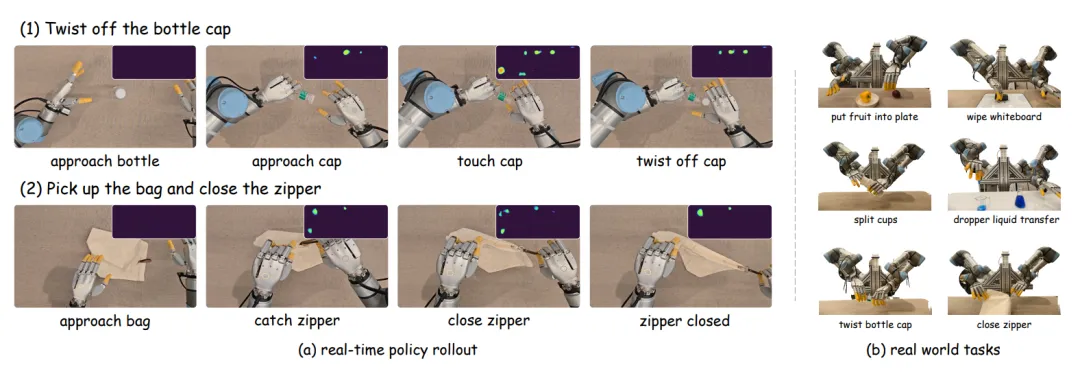
▲图 | 真实世界操作任务与示例执行序列。(a) 拧瓶盖与拉拉链,插图为触觉可视化。(b) 水果装盘、擦白板、分开杯子、滴管转移液体、拧瓶盖、拉拉链六个任务的场景 ©【深蓝具身智能】编译
消融里三个反直觉的结论
在三个真机上做,完整模型平均 72.3%。
▲表 | 模型设计消融。三个操作任务上的真实进度成功率(%),∆Avg. 为相对完整模型的变化(百分点)©【深蓝具身智能】编译
实时反馈比预测更值钱:去掉实时只剩预测,63.0%(-9.3);去掉预测只剩实时,69.7%(-2.7)。预测的作用是"提前准备",反馈的作用是"当场纠错",后者不可替代。
在生成过程中改 > 在生成之后改:动作空间残差 61.3%,和不加触觉(61.7%)几乎一样。同一套触觉信息,接的位置不对,收益归零。
隔离机制不能省:同时去掉注意力掩码和停梯度,掉到 62.7%,接近"没有触觉"的水平。这说明若不隔离,联合优化时动作专家那套大预训练表征会直接压过触觉信号。
"看不见"和"不更新"是触觉能说话的前提。
另外,去掉异步推理后拧瓶盖从 67 掉到 56,说明接触密集的任务确实依赖“高频刷新”。
写在最后
触觉的价值不在“多看一路信号”,而在“在动作被生成的那一刻改变它的走向”
——这是这篇工作给出的接入位置判断。
顺带它也提供了一个反面教材:π0.5 加触觉反而掉点这件事。视觉主导的大模型有很强的表征惯性,新模态如果只是被"看到",而没有一条能真正作用于输出的路径,它大概率会被忽略,甚至成为噪声。
但同时 TF²-Steering 现在仍然是"每个任务 100 条示教 + 后训练",触觉的通用性还依附在视觉主干上。
编辑|小小怪博士
审编|具身君
Ref
论文标题:TF²-Steering: Action Refinement with Tactile Forecasts and Feedback via Velocity-Field Steering
项目链接:https://yiming-cc.github.io/tf2-steering/
文章链接:
来源:深蓝具身智能