演讲者:Qiayuan Liao,UC Berkeley
论文:
大家好,我是来自 UC Berkeley 的 Qiayuan。今天介绍我们的工作 SuperMimic。
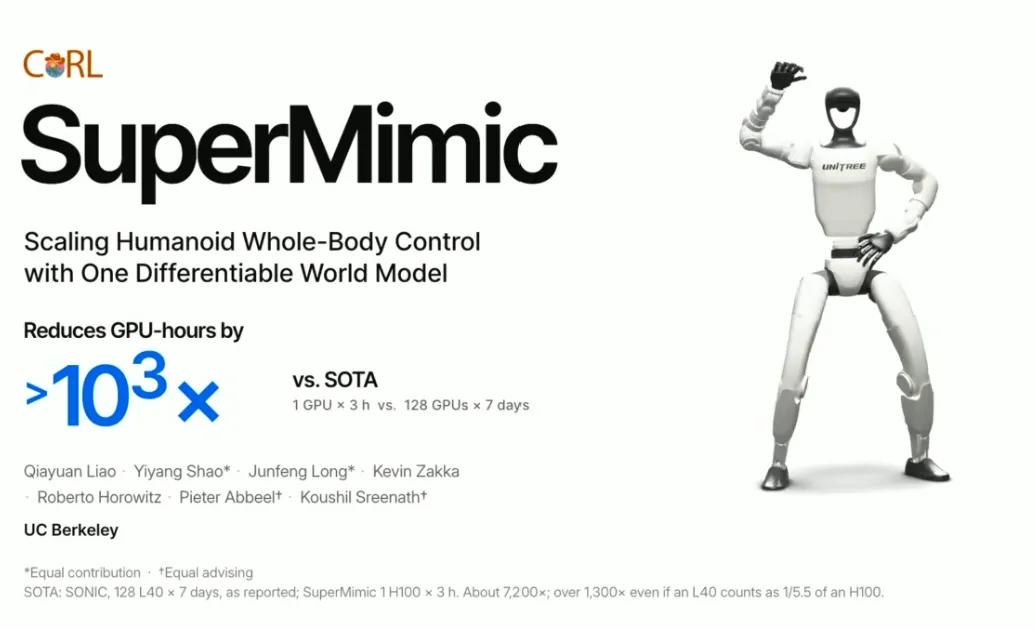
相比当时最先进的方法,我们将训练所需的 GPU 小时数降低了三个数量级。每次我这么说,大家都会听成“三倍”,连我的导师也不例外。所以我想说清楚:是一千倍,不是三倍。
大家看到的这些精彩机器人视频,很多都是通过动作跟踪实现的。不过,它们大多使用的是 specialist policy,也就是针对单个动作训练的专用策略。单独训练一支舞蹈,其实没有那么大的意义。
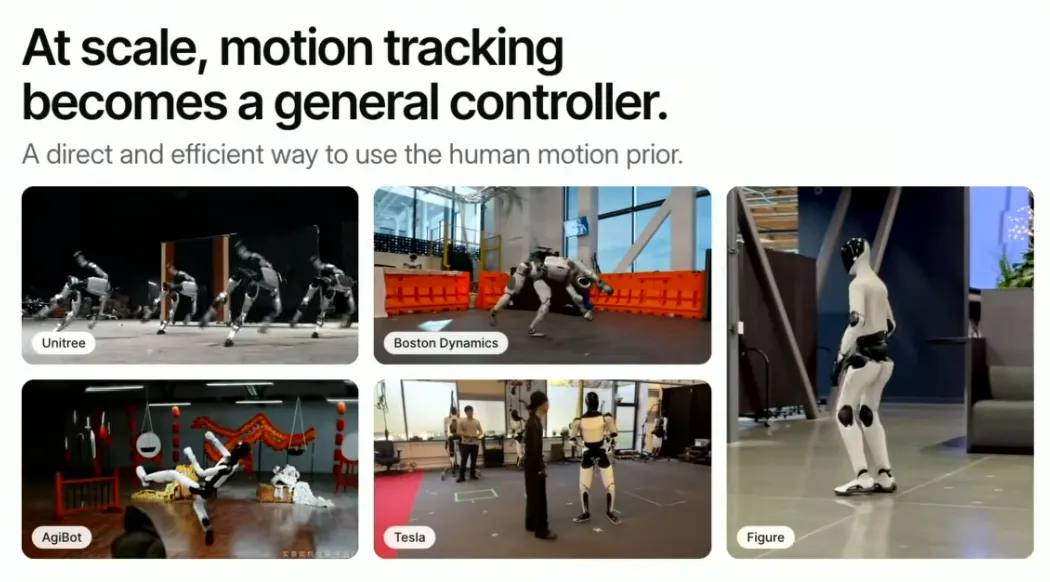
当训练规模扩大时,动作跟踪有望成为训练通用 Humanoid 底层控制器的一条路径。问题是,怎么把规模做上去?
这里有三个问题需要解决。
第一是数据。计算机视觉社区已经解决了这个问题。
第二是需要一种适用于各种动作的训练方法。我们去年的工作 BeyondMimic 解决了这个问题。
第三是怎么解决算力问题。
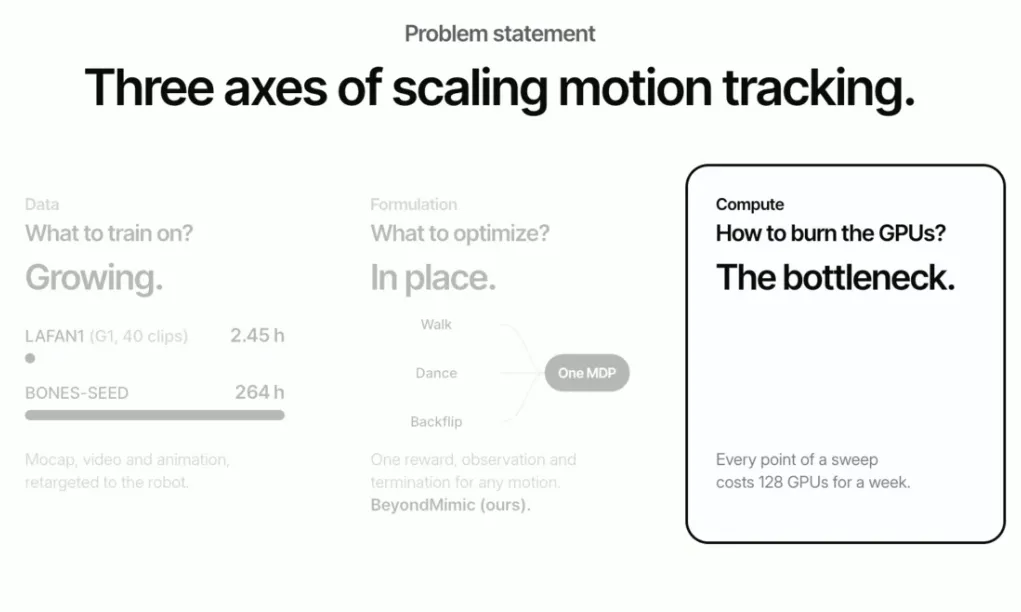
一种做法是先为不同动作训练专家策略,再将它们蒸馏到一个策略中;另一种做法是使用大型 GPU 集群,直接训练一个通用策略。而算力正是扩大规模的瓶颈。接下来的演讲会介绍我们如何移除这个瓶颈。
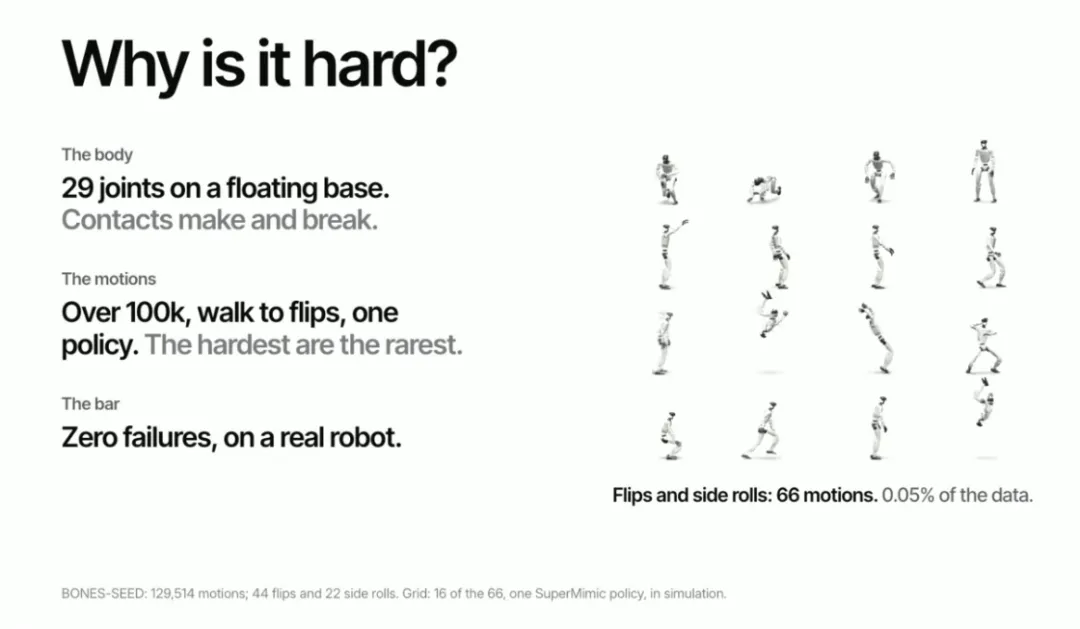
为什么这件事这么难?Humanoid 是一个复杂系统,动作数据规模大、分布不均衡,我们希望策略尽可能不失败,最终还要把它部署到真实机器人上。
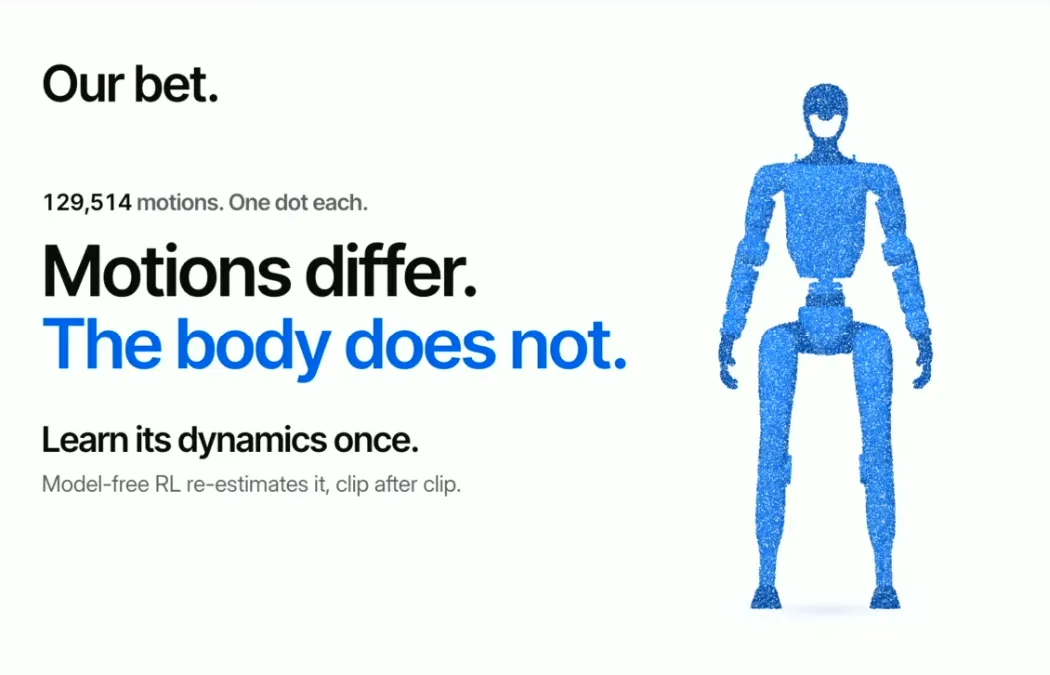
这里展示了大量不同的人类动作。它们差异很大,但执行这些动作的身体没有改变,它们共享同一套动力学。
所以,我们的想法是:能不能用一个模型学习这些共享的动力学?希望这个模型的一些良好性质能够帮助我们扩大训练规模。
这并不是一个全新的想法。此前已经有很多基于模型的方法沿着这个方向探索。这些方法需要决定前向计算在哪里进行、反向传播在哪里进行,以及如何更新策略。最后一列是真实机器人,它还涉及自身的不确定性和部分可观测性,这对部署非常重要。
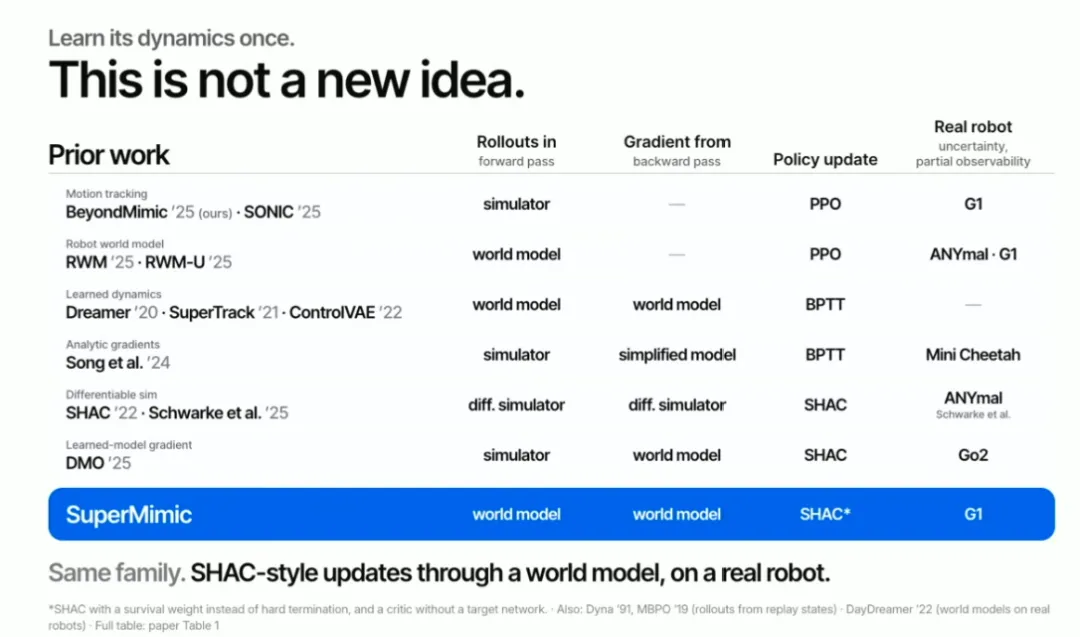
SuperMimic 的前向和反向计算都在学习得到的世界模型中进行,使用 SHAC 更新策略,并且可以在真实的 Unitree G1 上运行。
你们现在看到的不是仿真器,而是在浏览器中运行的世界模型。我们可以拖动机器人身体的一部分,通用动作跟踪策略会尝试让机器人重新保持平衡。
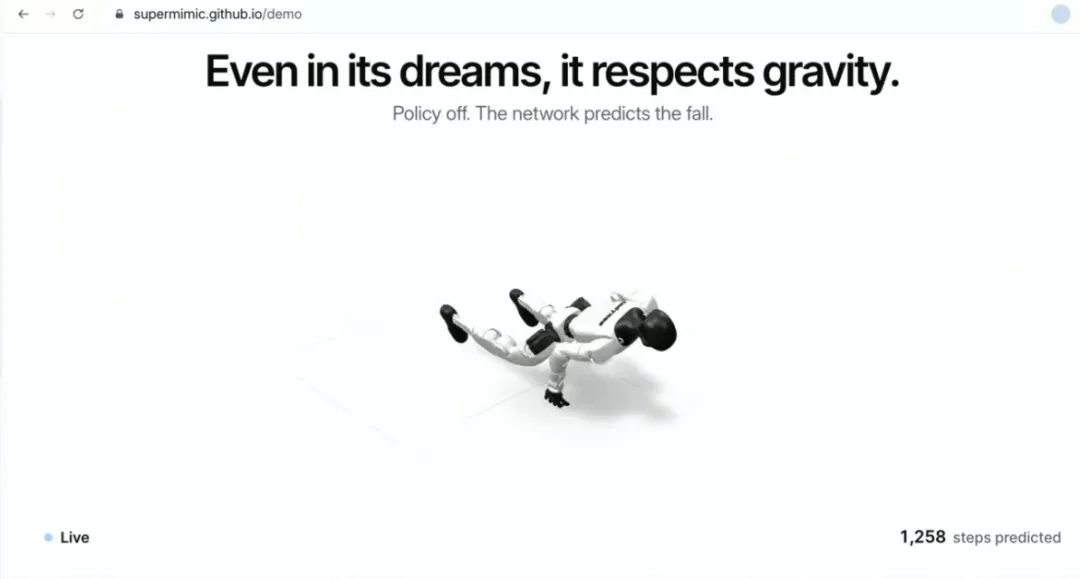
但我们怎么知道,这个世界模型不是仅仅记住了策略的行为?
如果我关闭策略,世界模型会预测机器人摔倒在地。即使它从未使用零动作的数据进行训练,它仍然能够预测这种情况。
那么,我们如何训练世界模型和动作跟踪策略?
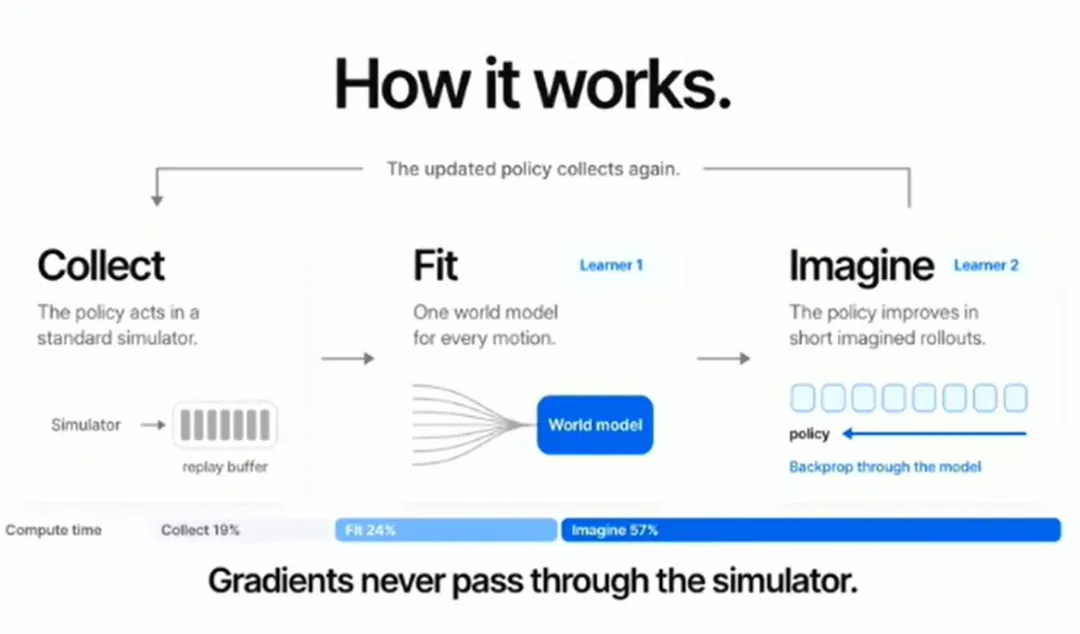
首先,让策略在仿真器中运行并收集数据;然后,用这些数据拟合一个世界模型;接着,让策略在世界模型中进行“想象”,通过反向传播穿过世界模型来改进策略。Critic 负责估计后续回报。这个过程循环进行。
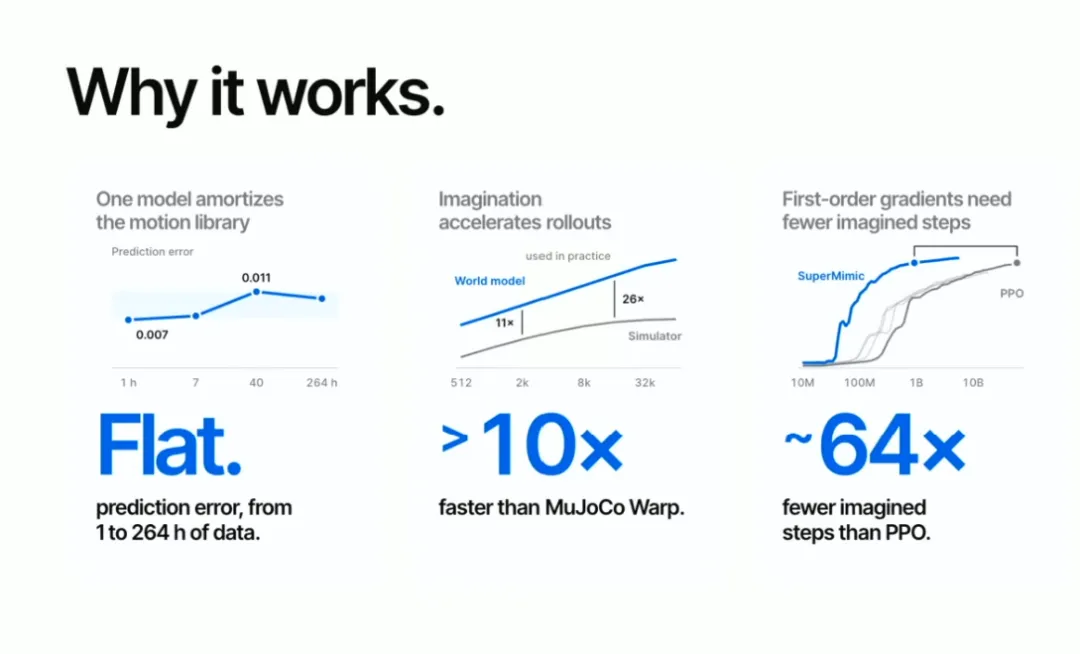
整个想法很简单,但效率非常高。为什么有效?主要有三个原因。
第一,一个世界模型可以在所有动作之间复用。随着动作数据增加,模型的预测误差基本保持稳定。
第二,世界模型中的想象 rollout 比仿真器中的 rollout 快十倍以上。
第三,一阶梯度非常有效。即使使用同一个世界模型,PPO 也需要更多步才能达到相同回报。
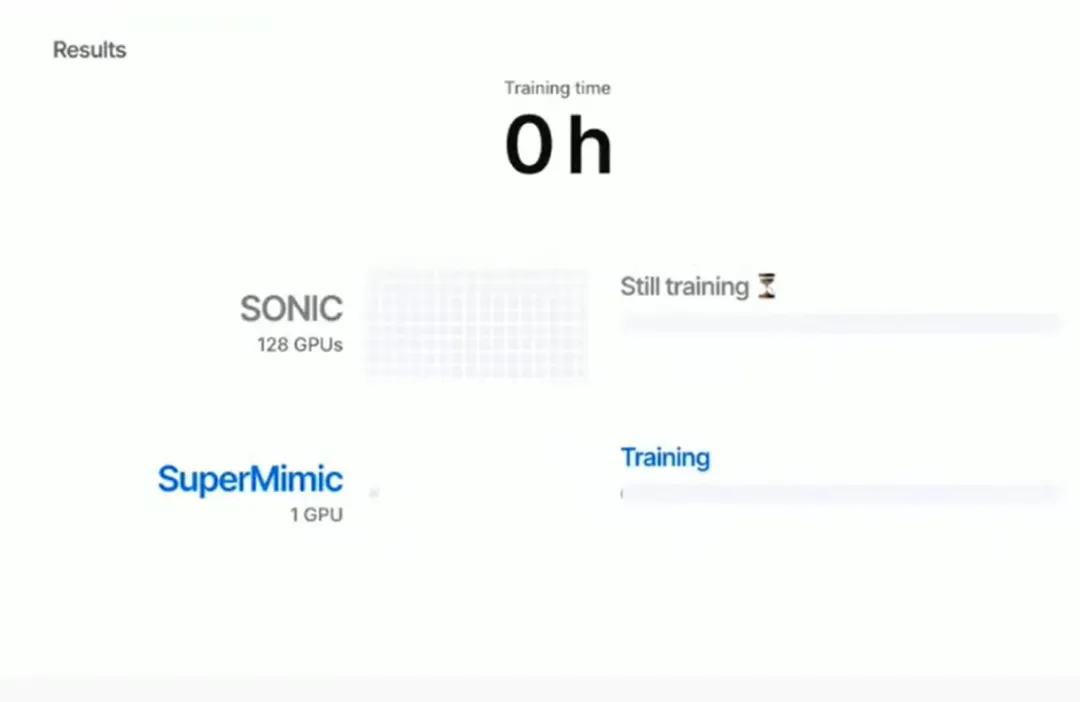
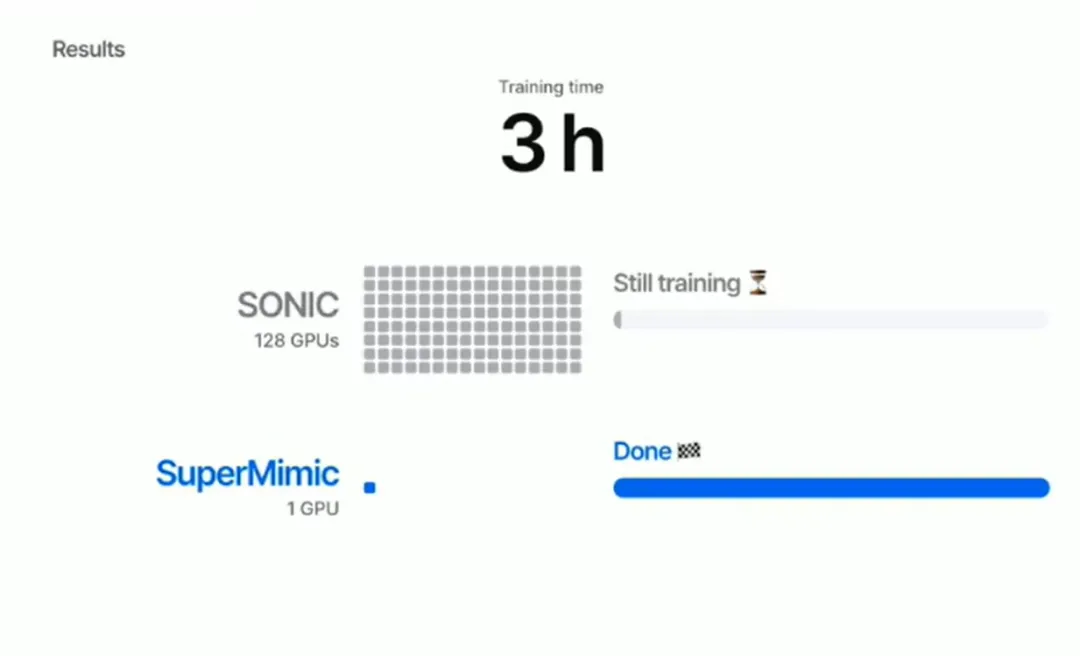
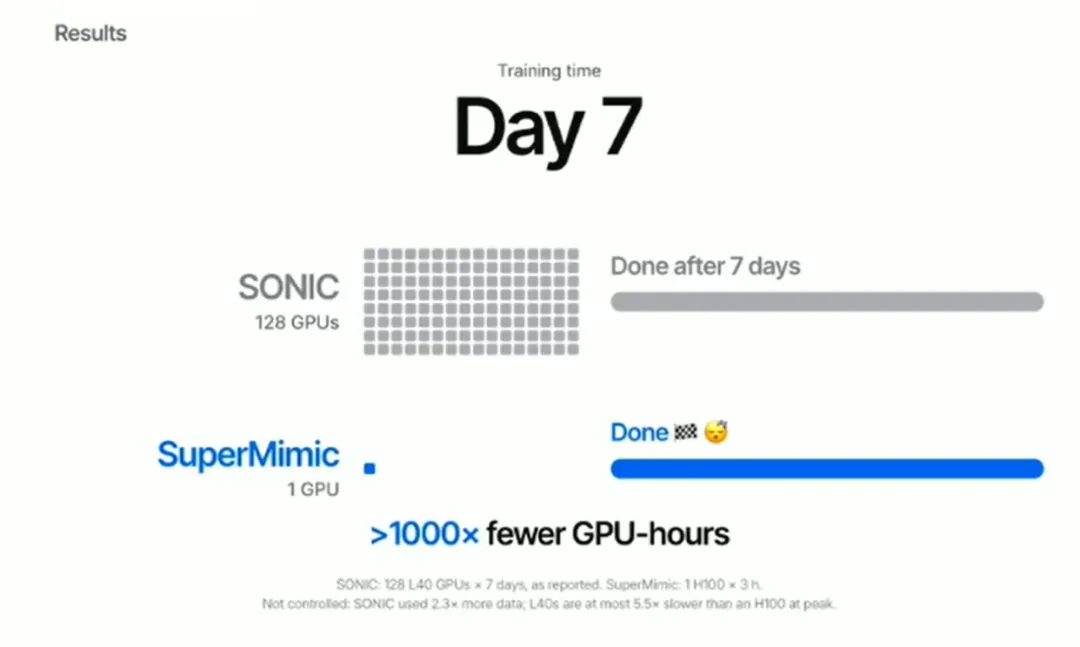
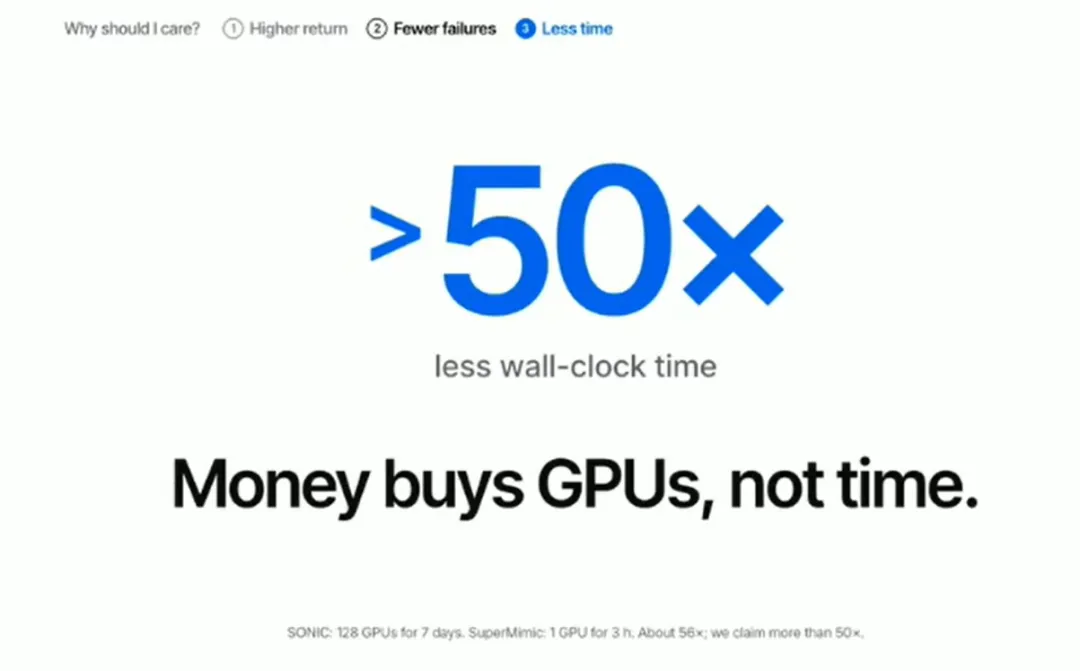
因此,SuperMimic 可以在一张 GPU 上用三个小时完成训练,而 SONIC 使用超过一百张 GPU 训练了一周。
公平地说,我们使用的数据集更小,GPU 也更快。但这不足以解释一千倍的差距。
我经常被问到另一个问题:假设我来自一家 GPU 公司,或者一家不缺算力的大型科技公司,为什么还要关心这个结果?
有三个原因。
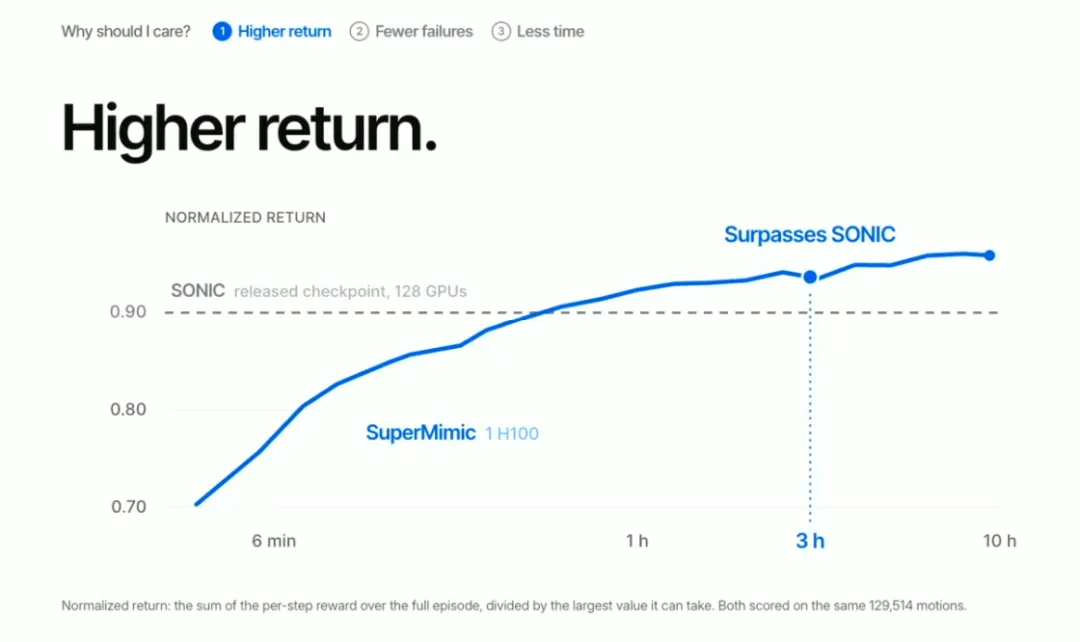
第一,回报更高。SuperMimic 在不到三个小时内就超过了 SONIC 的回报。
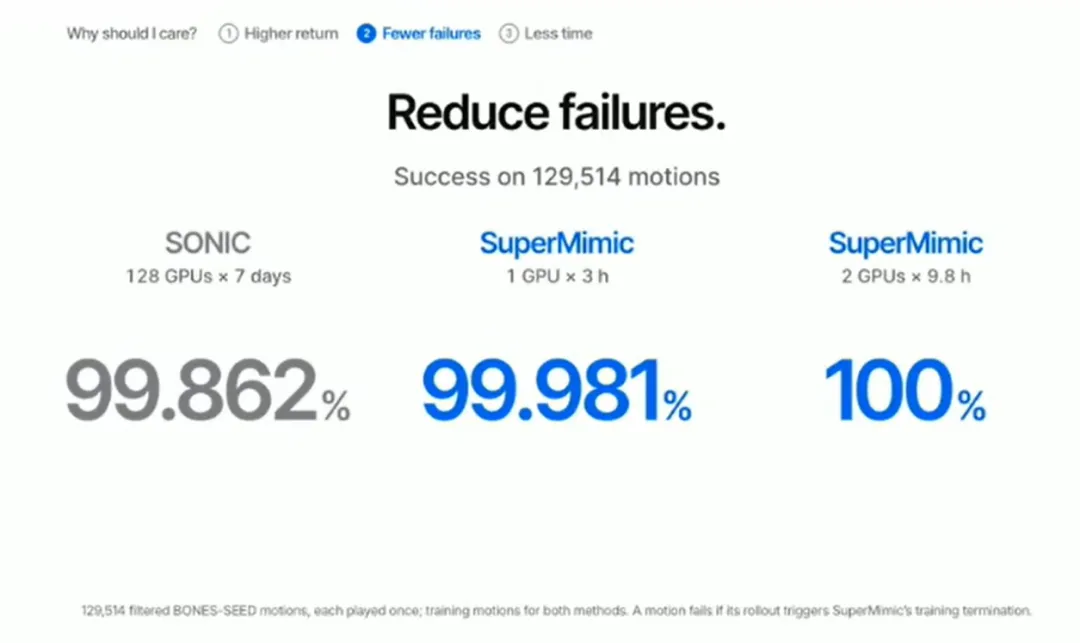
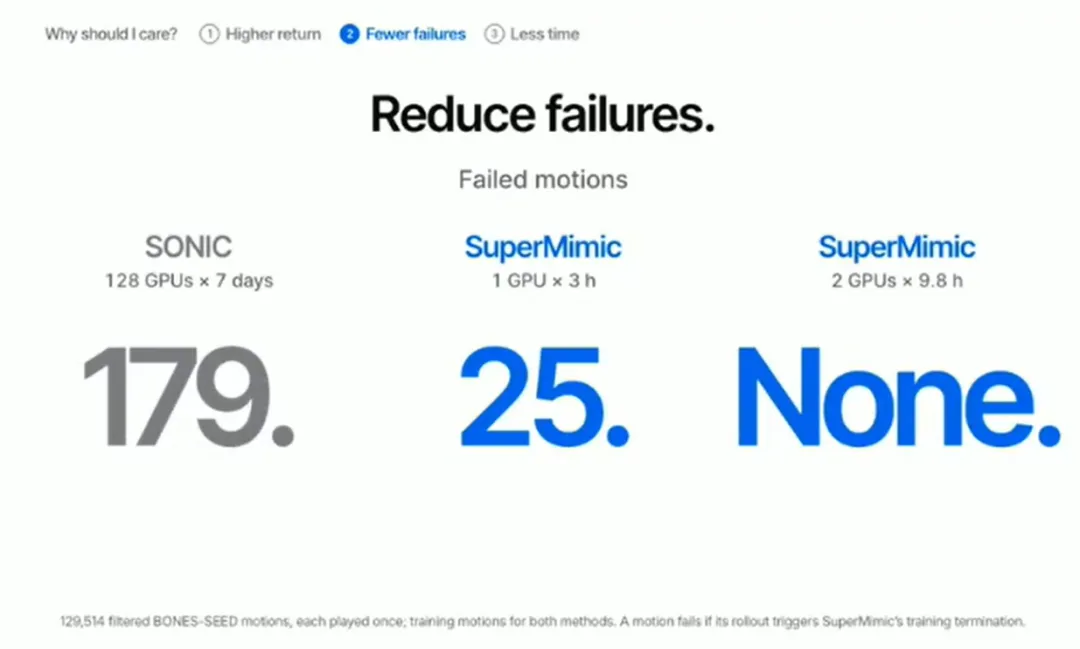
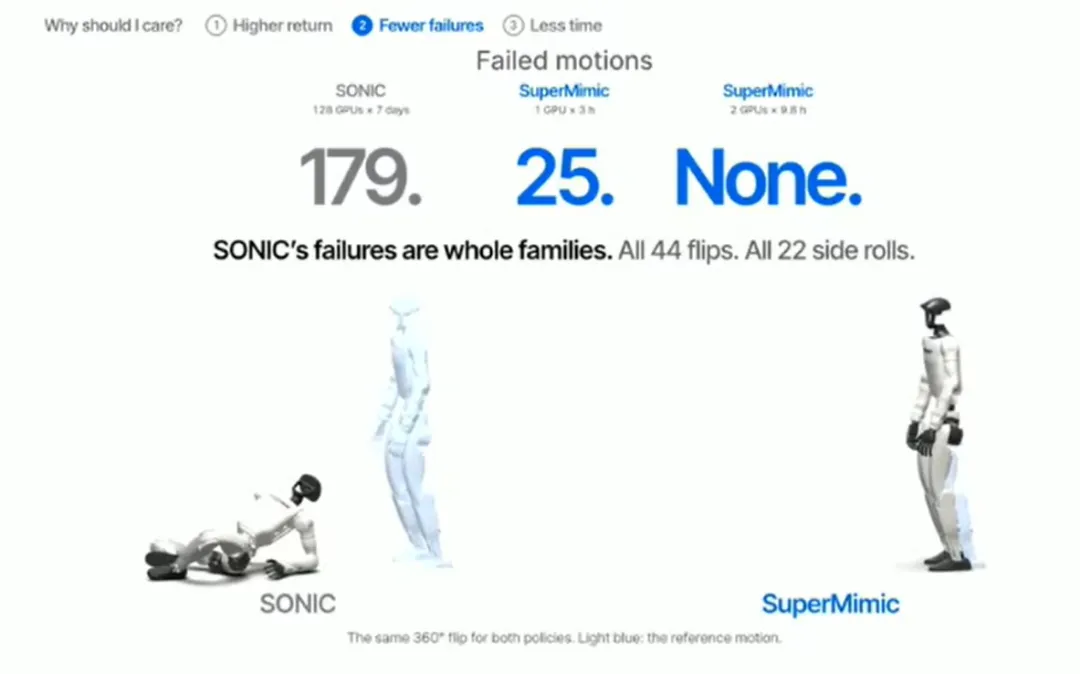
第二,失败更少。大家经常谈论 99.9% 的成功率,但在一个规模很大的数据集上,这仍然意味着一百多次失败。SuperMimic 训练三个小时后,失败动作少于 30 个。如果继续训练,我们可以在超过十万个动作上实现零失败。
第三,训练速度更快意味着可以更快地迭代。
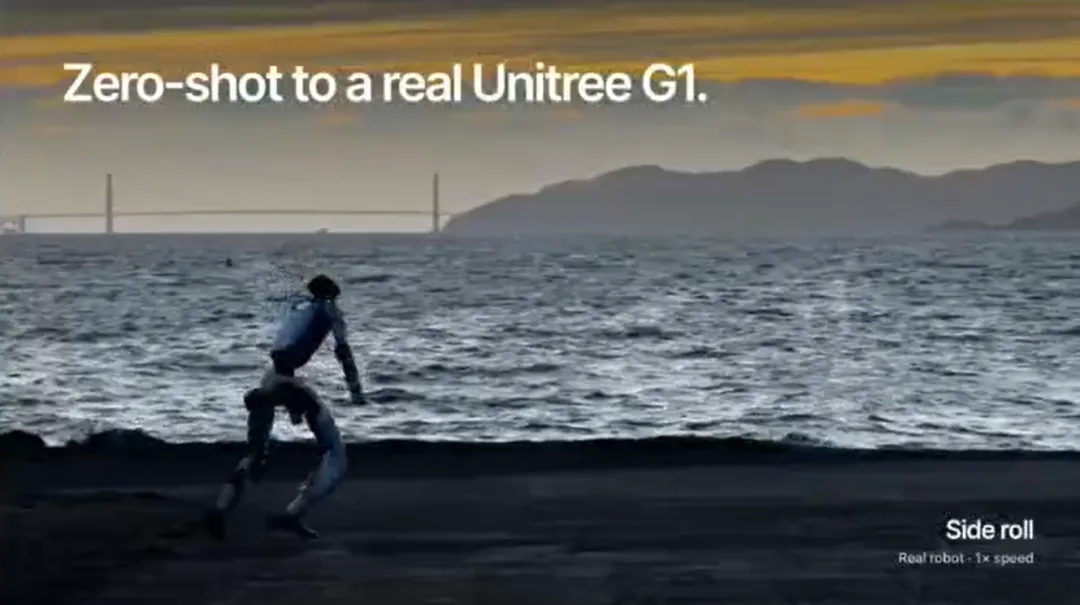
此外,即使这个通用动作跟踪策略完全是在世界模型的“想象”中训练的,它仍然可以迁移到真实机器人上。这里展示的所有视频,都来自同一个通用动作跟踪策略。
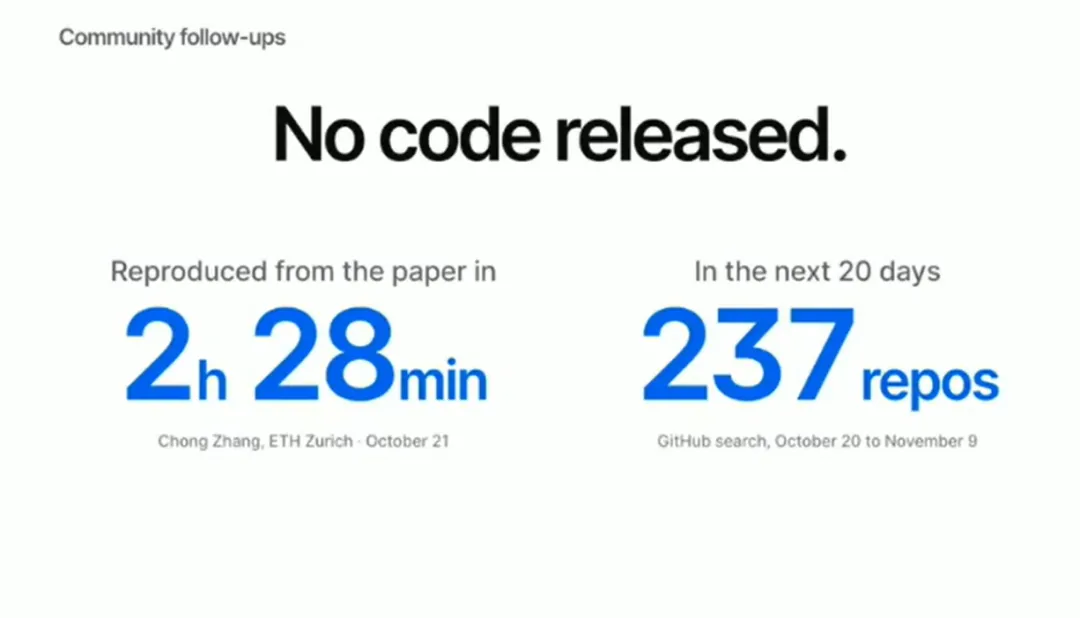
我们还没有发布代码时,有人告诉我,我们给出的细节太多了:一位学生只用了两个半小时就完成了复现。论文发布后的二十天里,社区还出现了“over 200 posts follows”。
我们来看看大家做了什么。
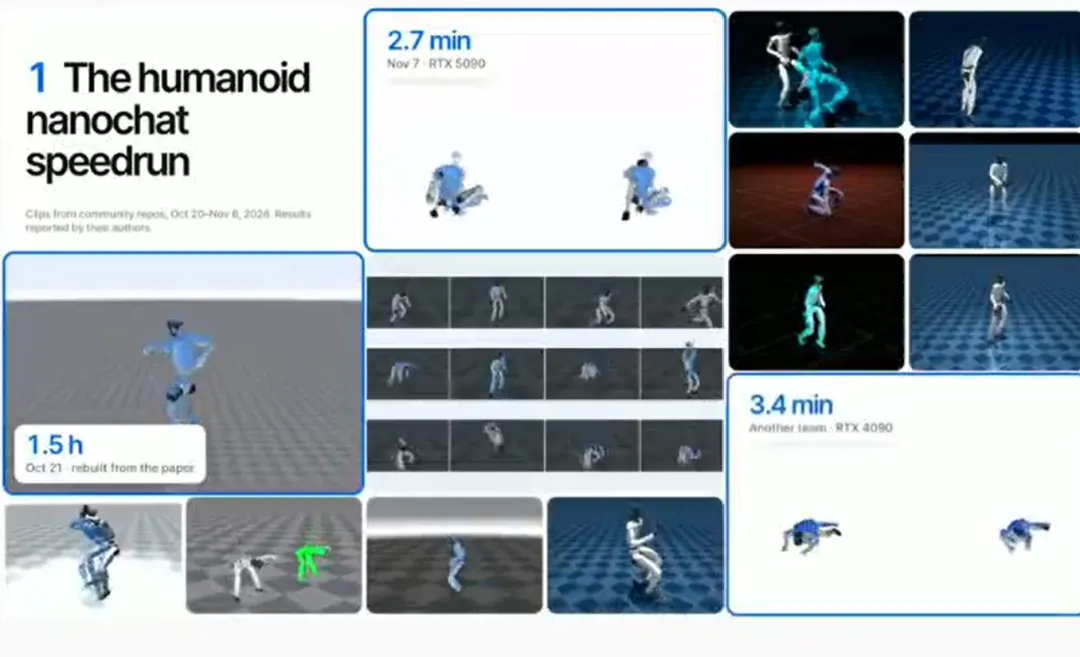
有人把它当成了一个“速通”挑战,类似 Karpathy 的 nanochat,在 PH 1 数据集上,训练时间不到三分钟。这个数据集包含约两小时的动作数据。
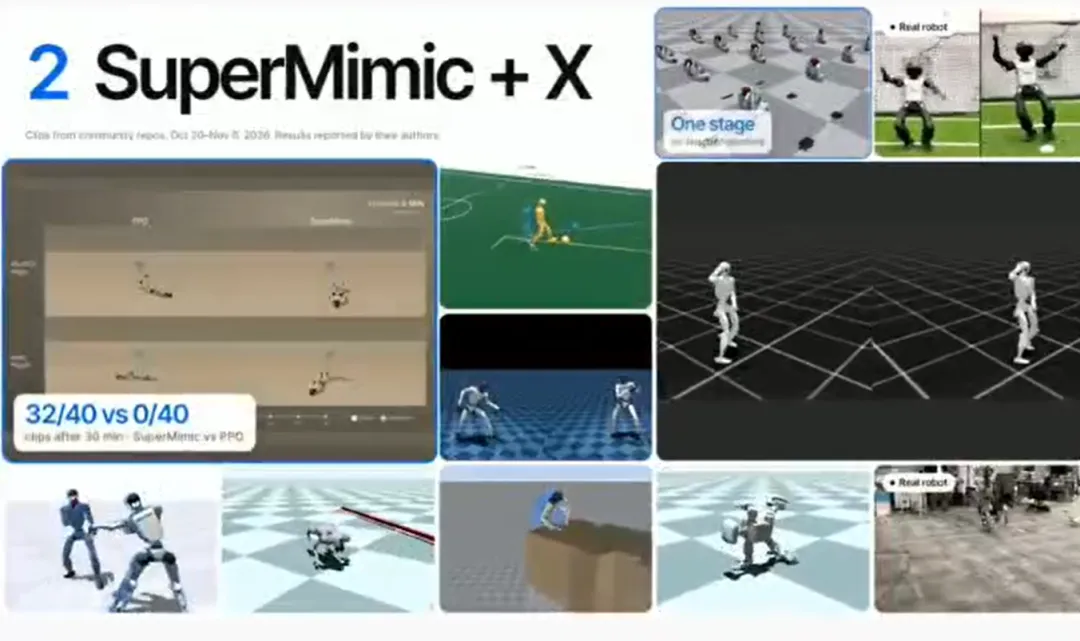
你还可以把 SuperMimic 接入其他方法,进行参数网格搜索,甚至省去 teacher-student 训练。
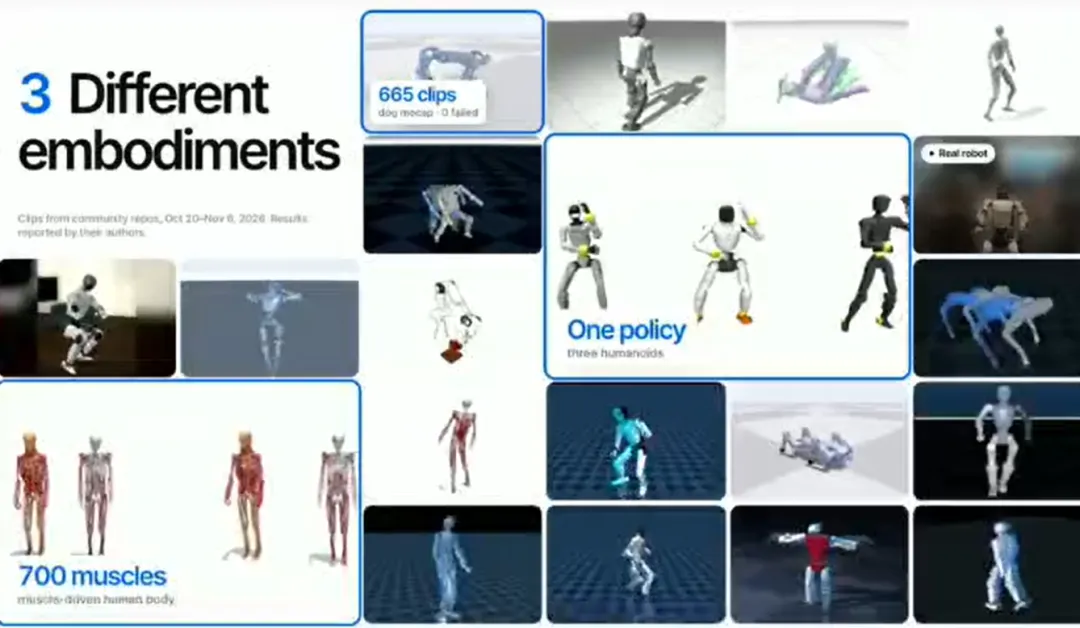
由于这个方法的计算效率很高,你可以将它应用到新的身体上,甚至是一个拥有 700 块肌肉的类人模型。
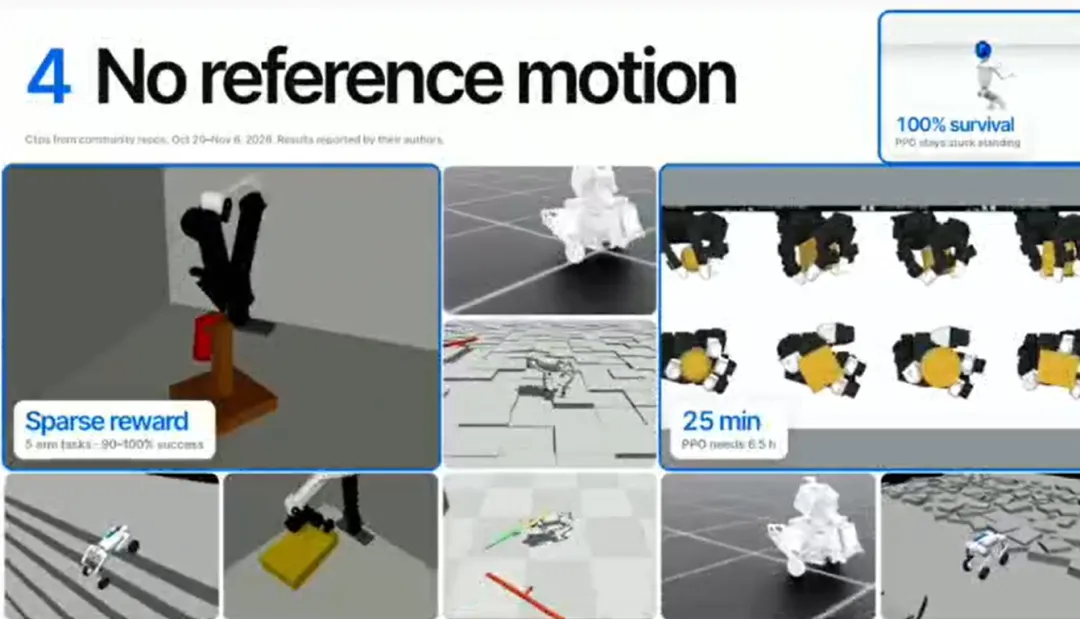
更让我惊讶的是,有人去掉了参考动作,发现它仍然可以用于稀疏奖励下的操作任务。
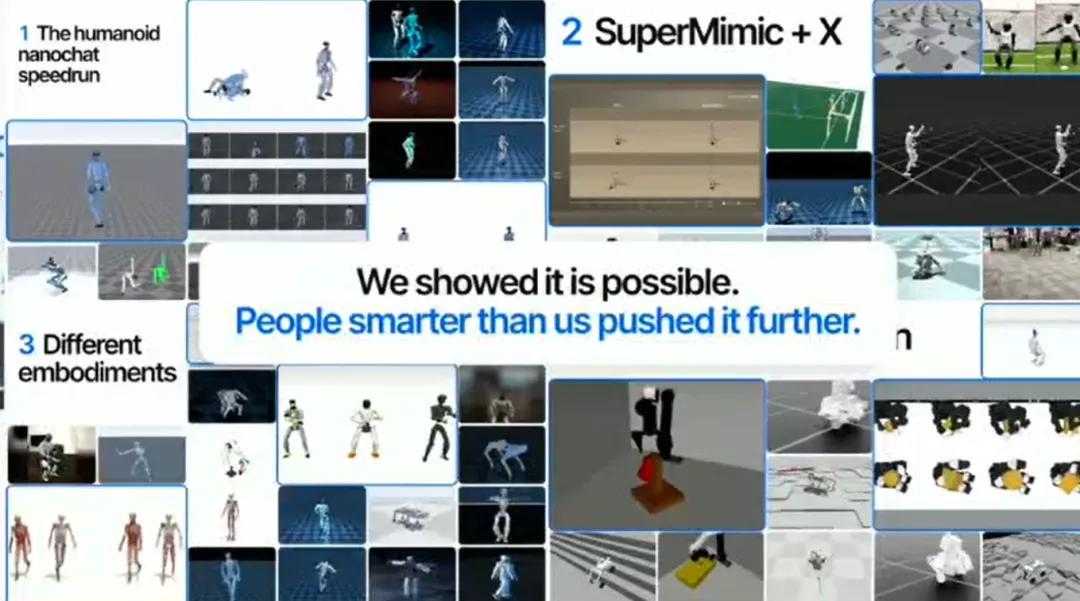
我们展示了这件事是可能的,而其他研究者把它推进得更远。
接下来分享一些实验室里的工作。
我们可以让全尺寸 Humanoid 使用灵巧手搬运物体。我们也可以让一个策略和一个模型处理一百种物体。
我们可以比较容易地更换策略,因为这里不需要计算策略的 likelihood。
我们还可以将安全问题写成 constrained RL 问题,并使用高层优化方法处理。
对于没有视觉输入的机器人,模型还可以用于估计机器人自身状态和地形。世界模型可以作为一个快速、可微的动力学先验。
最后,还有人在基于 SuperMimic 构建一项新工作。
回到最开始提出的三个问题:我们解决了算力问题。现在已经没有瓶颈了。
还有一件事:代码现在已经开源了,完整的提交历史也包含在内。大家可以去试试。
你们还可以看到我去年没有使用 coding agent 时是怎么写代码的。
谢谢大家。
问答
提问:使用可微世界模型,相比直接使用可微仿真器,有什么优势?
Qiayuan:可微仿真器需要付出很高的计算成本,尤其是在反向传播时。相比之下,世界模型只是一个简单的 MLP,可以更容易地进行反向传播。
提问:如果你很有钱,拥有一千台真实 Humanoid,你认为能不能直接在真实世界中学习一个可微世界模型?或者,先在仿真中学习一个模型,再用真实数据微调?
Qiayuan:如果你真的有一千台 Humanoid,还有一千套动作捕捉系统来获得特权信息,那么你就可以尝试把这个方法应用到真实世界中。
提问:现在你们有了一个能够跟踪很多动作的策略。但在新的部署场景中,机器人可能遇到分布外的状态。例如,它在操作过程中进入了未见过的身体配置,原来的策略可能会失去平衡。你们怎么看待这个问题?
Qiayuan:很多泛化能力来自 actor 的设计和网络架构。SuperMimic 与这些方法并不冲突。
例如,有研究者已经把鲁棒的通用动作跟踪方法和 SuperMimic 结合起来。你可以将提高鲁棒性或泛化能力的方法接入 SuperMimic 框架。
来源:human five