PTDG团队 投稿
量子位 | 公众号QbitAI
工业推荐的优化重心,已经从单一交互指标转向整体eCPM(每千次曝光收益)。
一次曝光之后,用户可能点击、下载、付费、关注……这些目标分布在一条“转化漏斗”上,越往下越稀疏,但往往越值钱。
业界的标准做法是多任务学习(MTL):让这些目标共享表示、一起训练。
论文《Personalized Task Dependency Graphs for Mitigating Signal Erosion in Multi-Task Recommendation》则关注一个具体问题:
沿着固定漏斗逐级传递信息时,信号会一层层衰减,最需要帮助的深层稀疏任务反而拿到最弱的信号。
论文把这种现象叫作“信号侵蚀”(signal erosion),并提出PTDG(Personalized Task Dependency Graphs)来对其进行缓解。
问题:同一条漏斗,不同物品的依赖强度并不一样
MMoE、AITM这类常用架构,大多默认一个前提:漏斗里任务之间的依赖强度,对所有流量都一样。
论文举了一个例子:
- 重度游戏往往走一条强因果链:点击→下载→付费;
- 轻量工具的用户经常跳过中间步骤,点击之后直接付费,“下载”这一环的依赖就弱得多。
物理上的先后顺序(先点击才可能付费)是必须遵守的,但相邻任务之间的关联强度会随物品而变。把所有样本都塞进同一个固定拓扑,一方面限制了模型的表达能力;另一方面,信息必须一级一级往下传,深层任务拿到的信号已经被中间环节稀释了。
已有工作也关注任务关系,但各有局限:PMTRec个性化的是优化权重,没有刻画任务间的结构差异;MIT的任务关系全局共享;CSRL学习因果结构,但迭代搜索代价达到O(T²)甚至更高,难以满足工业时延要求。
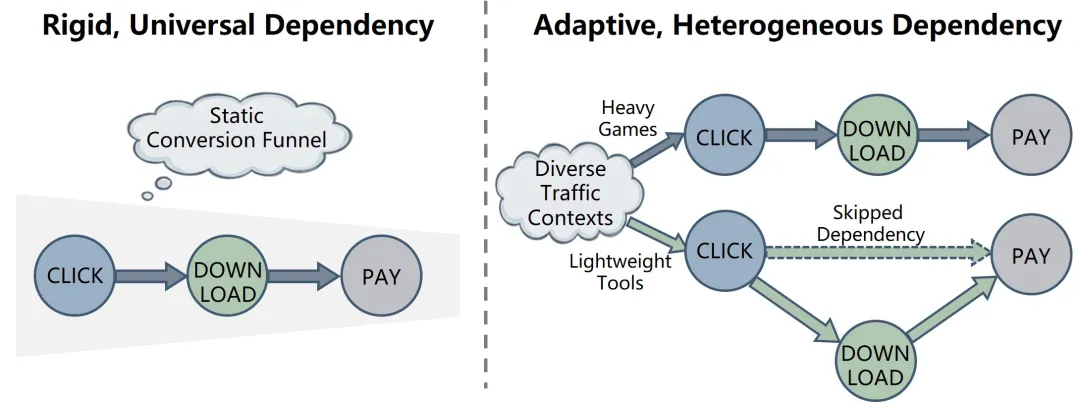 △左为统一、固定的依赖;右为依赖强度随实例变化的个性化依赖图。
方法:PTDG的三个部件
PTDG的核心思路,是把任务依赖看作一张动态、可学习的拓扑,而不是写死的链条。对应论文总结的三点创新:动态拓扑学习,按实例构造依赖强度;可控传播,用带硬因果掩码的GCN建立自适应捷径;自适应优化,用结构化掩码从参数层面缓解梯度冲突,同时降低计算复杂度。
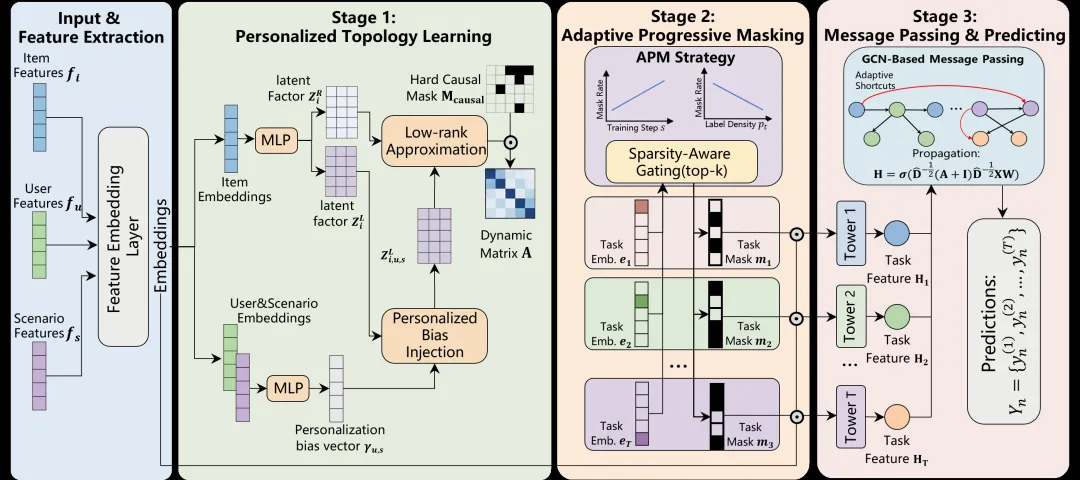 △PTDG分三个阶段,即个性化拓扑学习、自适应渐进掩码、消息传递与预测。
个性化拓扑学习:每个物品一张低秩依赖图
PTDG不直接学一个完整的T×T邻接矩阵(T是任务数),而是从物品embedding(由DeepFM或MLP这类骨干模型提取)生成两组低秩因子,相乘得到物品级的依赖矩阵。低秩分解在这里起结构正则的作用:工业交互数据噪声大,直接学满秩矩阵容易拟合到虚假相关。低秩形式还让依赖图计算和GCN消息传递的开销都随任务数T线性增长。
在此基础上,模型再用用户和场景特征生成一个“个性化偏置向量”,去调制物品级的低秩因子。这样,同一个物品在不同用户、不同场景下,依赖强度也可以不同。
硬因果掩码+GCN消息传递:允许“抄近路”,但不允许“倒流”
得到动态依赖矩阵后,PTDG先乘上一个硬因果掩码,保证信息只能沿行为顺序传递,防止“付费→点击”这样的语义倒流;然后在任务节点上做GCN传播。
和固定链条相比,关键差别在于:依赖图可以在相关性强的任务之间建立自适应捷径,比如让“点击”的信息直接到达“付费”,不必经过冗余的中间节点。论文认为,这正是缓解信号侵蚀的地方。
自适应渐进掩码(APM):按任务稀疏度决定共享多少参数
任务之间传递信息,也可能加剧梯度冲突。PTDG的做法不是在梯度层面做投影或重加权,而是给每个任务学一个二值掩码,只让它看到共享参数里的一部分:
- 掩码率由任务的正样本率决定:稠密任务对应r_min=0.2,稀疏任务对应r_max=0.7(论文在0到0.9范围内实验后的最优设置);
- 训练初期用线性warm-up逐步提高掩码率,稳定训练;
- 掩码在训练结束后固定,不带来推理开销。
与PCGrad这类需要O(T²)次梯度投影的方法不同,APM带来的训练开销可以忽略。此外,各任务的损失权重用“任务损失/其指数滑动平均”来归一,把不同任务拉到同一量级。
实验:先看稀疏深层任务
数据:公开数据集KuaiRand1K(840万样本,6个任务,正样本率0.02%–37.9%),以及一个工业数据集(1320万样本,7个任务)。每个设置用20个随机种子重复,报告均值。对比方法包括MMoE、PLE、STEM、MoCoGrad、PMTRec、MIT。
两个数据集上的平均AUC如下表:
 △两个数据集上的平均AUC。
两个数据集上,PTDG的平均AUC都是最高的;论文还报告,PTDG的平均表现比MoCoGrad高1.59%。优势在稀疏的深层任务上尤为明显:
- 工业数据集上稀疏的Task 3:PTDG 0.8872,比PMTRec(0.8745)高1.45%;
- KuaiRand1K的Follow任务:PTDG 0.9193,比线上基线MMoE(0.9033)高1.77%;
- 工业数据集上的关键深层转化任务Task 6:PTDG 0.8993,比MIT(0.8899)高1.05%。
(以上百分比都是论文正文的原始表述,每个都对应特定任务和特定对比方法。)
在点击这类稠密浅层任务上,PTDG与各基线保持相当水平。论文据此指出,个性化图拓扑在缓解深层节点信号侵蚀的同时,不损害头部任务的表现。
消融实验在工业数据集上进行,指标为平均AUC:
△消融实验(工业数据集,平均AUC)。每个部件都有明确贡献。按论文正文的表述:去掉个性化依赖图,平均AUC下降1.21%;GCN换成简单拼接下降0.93%,说明图上的消息传递更能保住信号;去掉APM下降0.59%。
低秩维度:q从1调到7,q=2时最好,说明低秩近似用比满秩邻接矩阵更少的参数,有效控制了过拟合。论文给出的经验值是q≈T/3。
线上A/B
PTDG被部署为一个主流应用分发平台的排序模型,该平台日活超过1亿。线上A/B持续两周:基线桶和实验桶各占10%流量,其余80%仍走原线上模型;基线是当时线上的MMoE(也就是离线对比里的同一个MMoE)。论文对每个桶的日级指标做双样本t检验(p<0.05),核心业务指标的提升在统计上显著:
- CVR +1.2%
- eCPM +1.9%
项目价值
面向工业约束:计算随任务数线性增长,线上端到端延迟相比MMoE基线只增加8 ms,在服务SLA之内;APM掩码训练后固定,不增加推理开销。
收益落在最难的目标上:提升集中在稀疏、高价值的深层转化任务,同时保持稠密任务的精度。
线上验证:在日活超过1亿的平台上取得统计显著的CVR和eCPM提升,论文认为这体现了PTDG作为多任务学习框架在真实推荐系统中带来稳定收益的工业可行性。
适用场景与未来方向
最适合的场景:深层转化稀疏、不同物品转化路径差异明显的业务,正是PTDG收益最集中的地方。
在因果约束内个性化:依赖图的个性化始终在硬因果掩码允许的范围内进行,从结构上避免了语义倒流。
更大规模与跨域:论文提到,下一步将扩展到更大的任务集合,以及跨域场景。
论文标题:Personalized Task Dependency Graphs for Mitigating Signal Erosion in Multi-Task Recommendation
收录会议:CIKM 2026(罗马)
论文(arXiv):
DOI:10.1145/3799682.3839876
来源:量子位