Runway 是一家总部位于纽约的生成式 AI 公司,因 Gen 系列视频生成模型而为人熟知。公司成立于 2018 年,由 Cristóbal Valenzuela、Anastasis Germanidis 和 Alejandro Matamala Ortiz 共同创立。三位创始人相识于纽约大学的 Interactive Telecommunications Program,背景横跨机器学习、设计与创意技术。
过去几年,Runway 持续吸引资本关注。2025 年 4 月,公司完成超过 3 亿美元的 D 轮融资;2026 年 2 月,又宣布完成 3.15 亿美元 E 轮融资,由 General Atlantic 领投,NVIDIA、Adobe Ventures、AMD Ventures 等参投。据媒体报道,这一轮融资对 Runway 的估值达到 53 亿美元。
虽然 Runway 最早因视频生成工具受到广泛关注,但公司的研究目标早已不止于生成视频。Runway 将 General World Models 作为长期研究方向,希望训练能够理解和模拟视觉世界及其动态变化的模型。对于机器人而言,这意味着视频模型不仅可以生成画面,还可能被用于预测动作后果、评估策略,乃至直接生成机器人动作。
在 Praxis-1 之前,Runway 已经开始探索世界模型与机器人学习的结合。2025 年底,Runway 推出 GWM-1 和面向机器人应用的 GWM-Robotics;2026 年 2 月,团队进一步展示了在世界模型中评估机器人策略的研究,并与 NVIDIA、Berkshire Grey 等合作探索相关应用。
Praxis-1 将这条路线向前推进了一步:从利用世界模型预测和评估机器人行为,走向利用视频预训练直接构建机器人控制策略。
Praxis-1 基于 Runway 的 270 亿参数视频基础模型,先通过具身视频进行中期训练,再引入 Action Expert,与视频预测联合学习动作。模型每次同时预测一小段未来视频和对应的动作,可以适配单臂、双臂和移动操作机器人等不同本体。
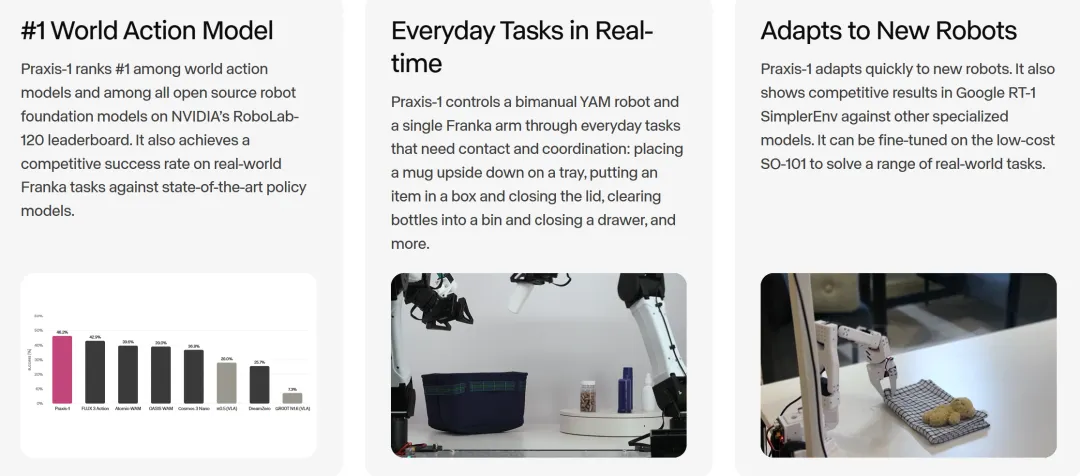
在 NVIDIA RoboLab-120 仿真评测中,Praxis-1 在 1,200 次测试中取得 46.2% 的成功率,位列文章发布时榜单上的世界动作模型和开源机器人基础模型第一。在真实 Franka 机械臂的 10 项任务中,Praxis-1 完成了 100 次测试中的 88 次。Runway 已以 Apache 2.0 许可证开放模型权重,并提供代码与微调工具。
1. 引言
机器人部署反复遇到同一个问题:真实世界的机器人数据稀缺,而采集足够的数据来训练通用策略成本高昂。一些实验室选择增加遥操作数据,另一些则选择增加第一视角视频。我们认为,最具扩展性的数据来源是通用视频,也就是人们已经在日常生活中拍摄的视频。经过视频预测训练的模型能够学习物体如何运动、手如何移动,以及任务进行到中途时是什么样子。机器人可以在这些知识的基础上进一步学习。
通过 Praxis-1,我们将一个 270 亿参数的视频基础模型转变为开放权重的世界模型,以短片段的形式预测未来。一个小型 Action Expert 在视频模型想象接下来会发生什么时,读取其内部状态。机器人每次执行动作时,Praxis-1 都会同时预测场景将呈现的样子,以及使场景达到该状态所需的运动。
在 DROID 上微调后的 Praxis-1 是 RoboLab-120 排行榜上排名最高的世界动作模型,也是排名最高的开源机器人基础模型。在真实的 Franka 机械臂上,与此前最先进的世界动作模型相比,它取得了具有竞争力的成功率。
Praxis-1 可以适配多种机器人本体,从单臂、双臂机器人到移动操作机器人。我们展示了多种日常任务,例如将马克杯倒扣在托盘上、将物品放入盒子并盖上盖子、将瓶子收进箱子或关上抽屉。该模型还可以适配训练数据中未曾见过的机器人本体。下文将通过 Google 的 RT-1 和 SO-101 详细说明这一点。
2. 模型架构
Praxis-1 由三个部分组成。视频主干网络预测场景接下来会是什么样子,Action Expert 读取预测视频的特征,推断产生该场景所需的运动。每种机器人各自配备轻量级投影层,将其位姿和动作转换为共享格式,因此一个模型可以控制不同的机器人本体。
每次调用时,模型接收一条指令、最新的相机画面和机器人的当前位姿。模型返回一个未来视频片段,以及 1.6 秒的动作:以 15 Hz 输出的 24 行动作。机器人执行该动作片段,返回相机观测到的画面,然后再次调用模型。
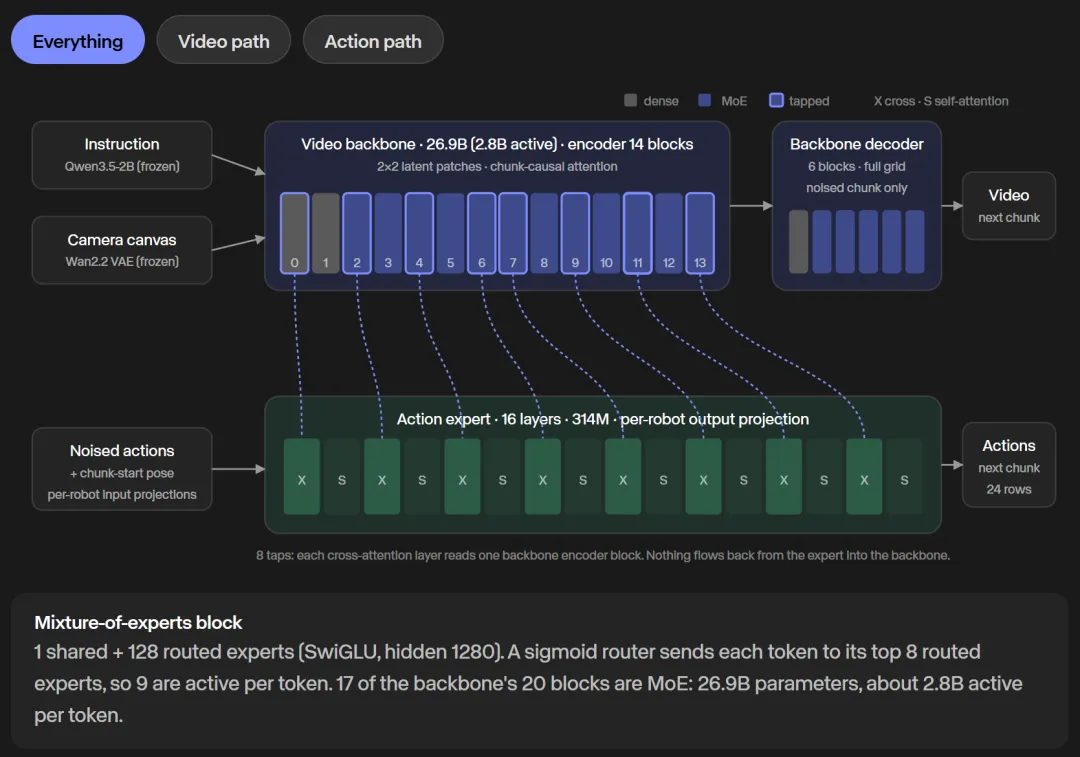
图 1:backbone与 Action Expert
视频和动作均以块为单位逐次预测:每个动作块包含 24 行动作,在 15 Hz 下对应 1.6 秒。每种机器人拥有各自的轻量级输入和输出投影层;主干网络和 Action Expert 在不同机器人之间共享。下文将分别介绍这些组件。
2.1 视频backbone
Praxis-1 基于 Runway 的视频基础模型构建:它是一个扩散 Transformer,被拆分为条件编码器和速度解码器,即 Wang 等人于 2025 年提出的 DDT 结构。该模型在冻结的 Wan2.2 VAE 潜在空间中运行,并通过冻结的 Qwen3.5-2B 文本编码器读取指令。其 20 个前馈层中有 17 个采用混合专家模型(MoE);只有编码器的前两个 block 和解码器的第一个 block 保持为稠密结构。
每个 MoE 层包含一个所有 token 共享的专家,以及 128 个较小的路由专家,每个 token 从中选择 8 个。一个 token 经过的 9 个专家,其宽度之和相当于一个稠密层的宽度。因此,尽管该层包含相当于 129 个专家的参数量,每个 token 的计算量仍与稠密 block 大致相同。整个主干网络共有 26.9B 参数,其中每个 token 激活约 2.8B 参数。
专家负载均衡采用 DeepSeek-V3 的方法:使用不依赖辅助损失的路由偏置,同时加入一个较小的序列级辅助损失。
基础模型最初经过训练,可以一次性生成完整视频片段,其中每一帧都能看到其他所有帧,包括未来帧。机器人无法看到未来,因此在中期训练期间,我们将注意力机制改为块级因果形式:模型以每块 1.6 秒、包含 6 个潜在帧的方式沿时间推进,每个块只能看到之前的块。
每个块从各自的噪声水平开始去噪,同时关注自身和之前各块的干净副本。训练时,前面的块来自真实视频,而非模型自身的预测。这种设置称为 teacher forcing,使我们能够通过一次并行前向计算同时训练 4 个块。
推理时,模型按照相同规则逐块处理。默认情况下,它从机器人读取前一个块的真实相机画面,因此看到的是与训练时相同类型的干净上下文。下图同时展示了主干网络和 Action Expert 的注意力掩码。
2.2 Action Expert
Action Expert 是一个稠密的 16 层 Transformer,隐藏层宽度为 1024,包含约 314M 参数。其设计理念与 DeVA 最为接近:DeVA 同样采用独立的 Action Expert,读取视频模型不同深度的特征。
Action Expert 的各层在对主干网络执行交叉注意力和执行自注意力之间交替。每个交叉注意力层读取主干网络编码器的一个 block,共读取从浅层到深层分布的 8 个 block。共享归一化层和一个 的投影层,将主干网络特征转换为与 Action Expert 相同的宽度。
对于每个块,Action Expert 包含:
1 个绝对位姿 token;
8 个可学习的“未来”token;
6 个动作 token,每个动作 token 对应 4 行动作。
第 个块的查询可以看到第 个块之前的干净主干网络帧,以及主干网络中第 个块自身的加噪帧。因此,Action Expert 读取的是主干网络正在想象的未来。
主干网络不会读取 Action Expert 的信息,但动作损失仍会通过交叉注意力的读取过程训练主干网络。
我们还尝试过将动作 token 放入主干网络内部,即采用 mixture-of-transformers 结构。在我们的离线代理评估中——进行短时双臂微调,并根据动作误差评分——这种结构与独立 Action Expert 相比没有明显差异,误差仅相差 厘米,但计算成本更高。因此,我们保留了独立的 Action Expert,将其他架构留作未来研究。
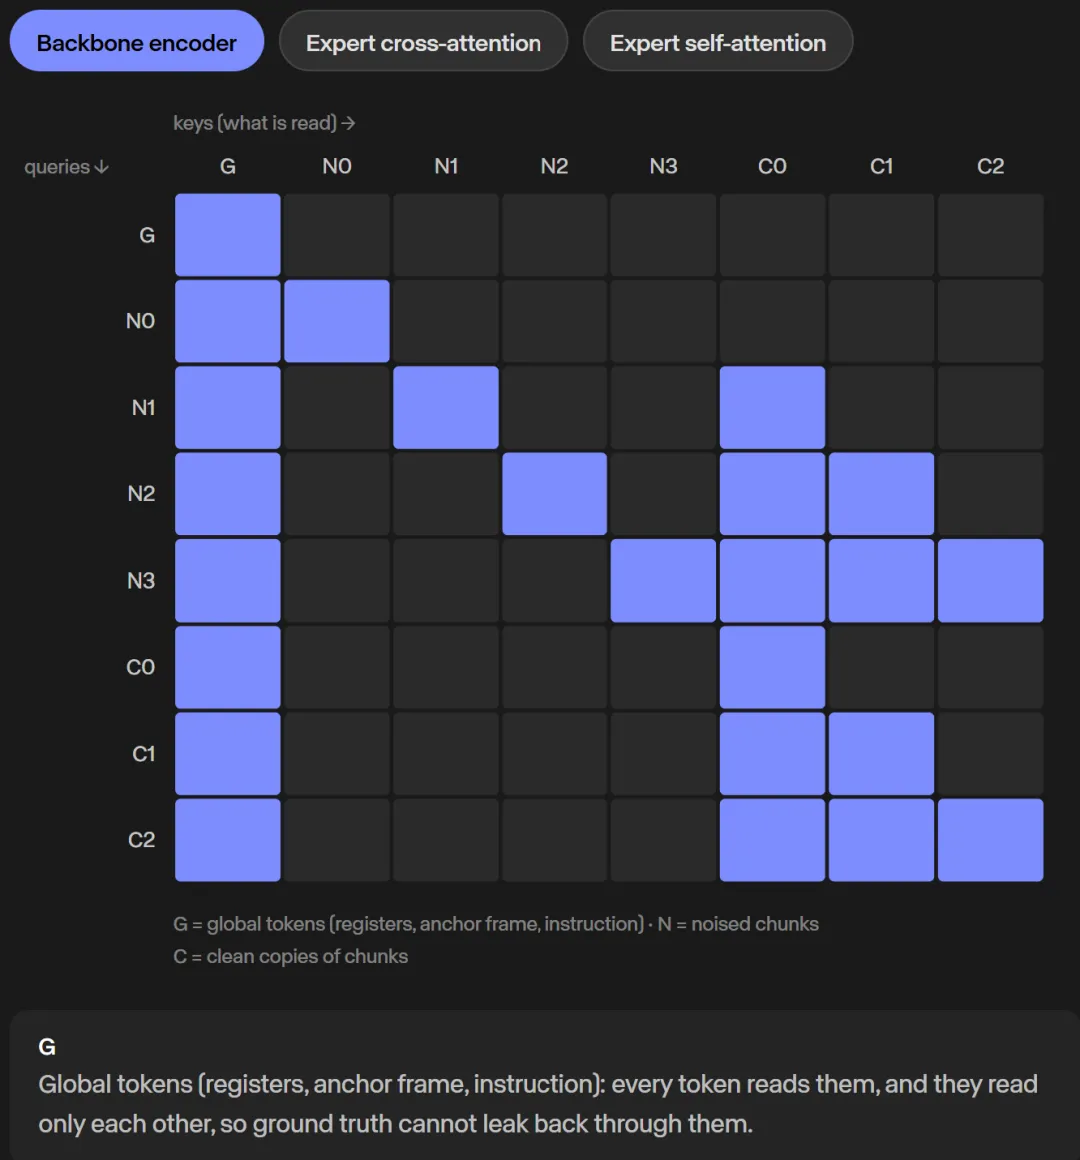
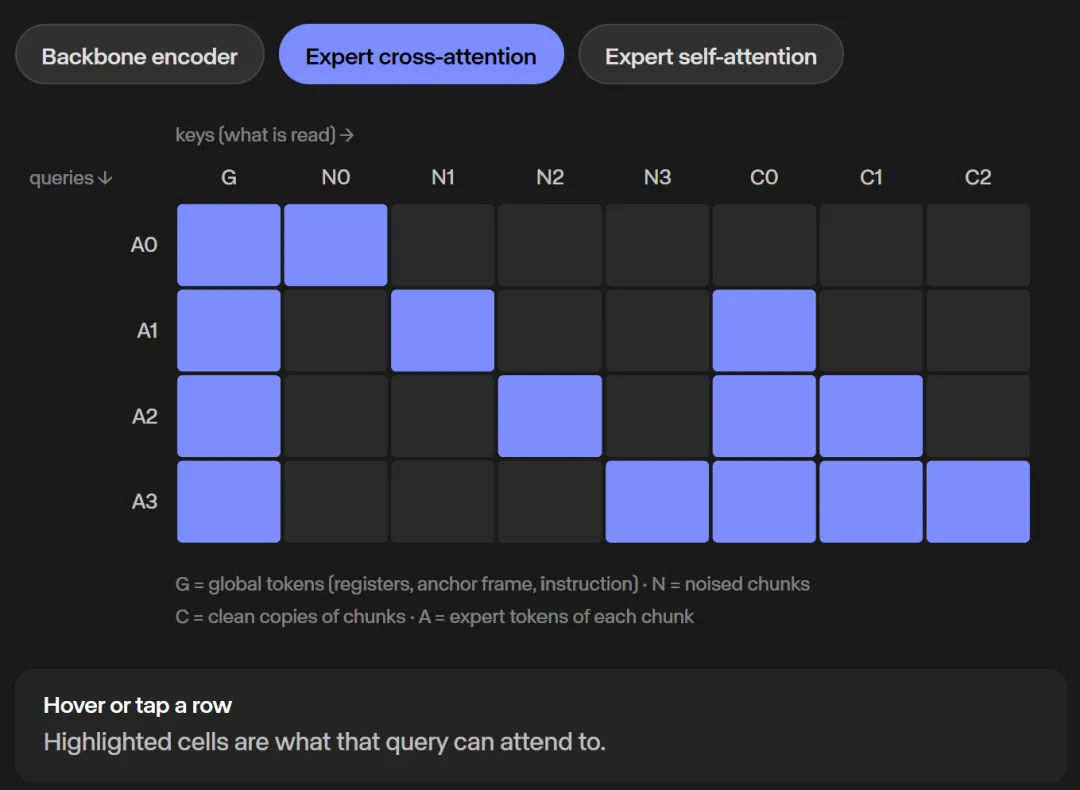
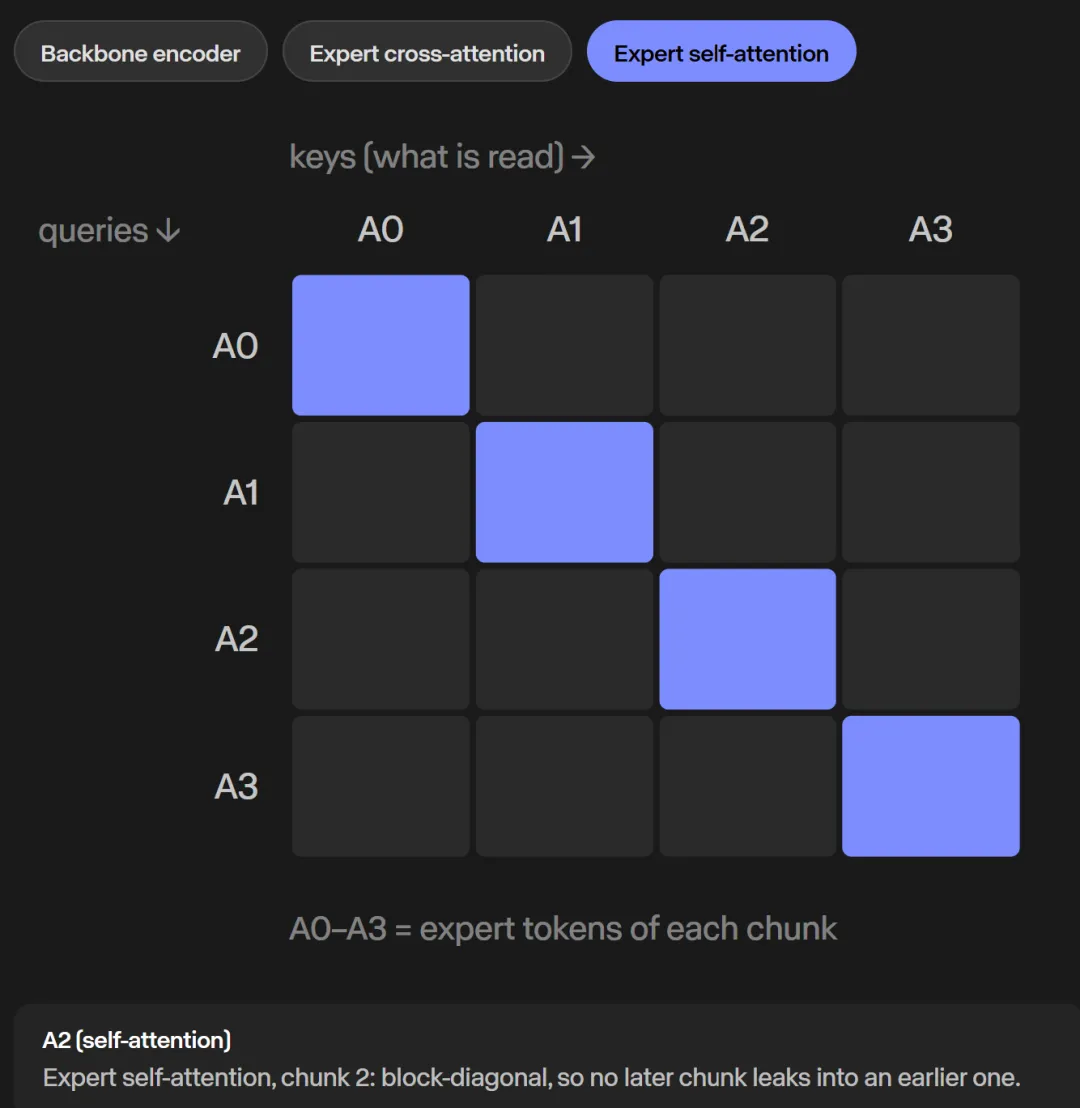
图 2:Action Expert 关注的内容
图中分别展示主干网络编码器、Action Expert 交叉注意力和 Action Expert 自注意力的注意力关系。
:全局 token,包括 register、锚帧和指令。
:加噪块。
:各块的干净副本。
:每个块对应的 Action Expert token。
横轴为被读取的 key,纵轴为 query。高亮单元格表示相应 query 可以关注的内容。
2.3 输入与采样
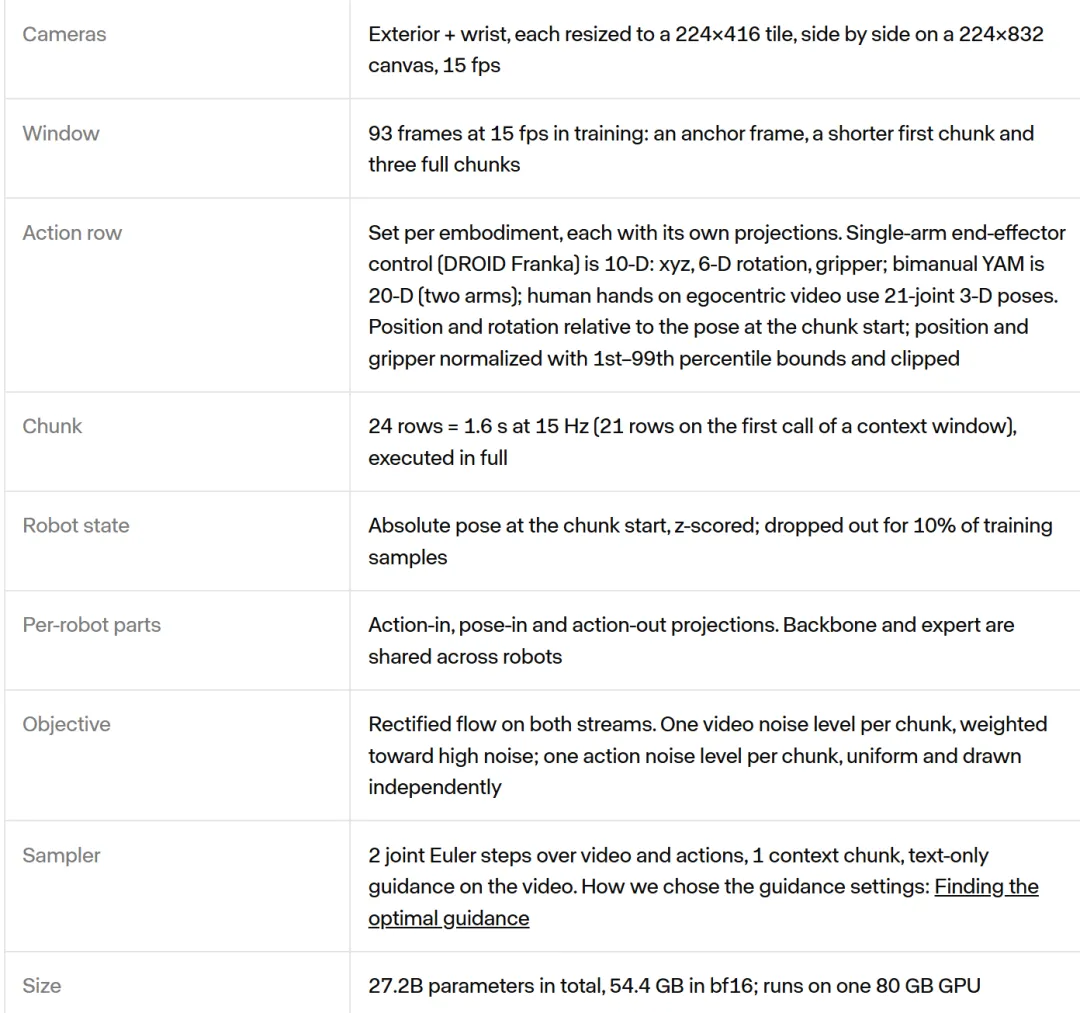
| 项目 | 设置 |
|---|---|
| 相机 | 外部相机和腕部相机的画面各自缩放为 ,并排拼接成 的画布,帧率为 15 fps |
| 时间窗口 | 训练时使用 93 帧,帧率为 15 fps:包括一个锚帧、一个较短的首块和三个完整块 |
| 动作行 | 按本体分别设置,每种本体拥有自己的投影层。单臂末端执行器控制(DROID Franka)为 10 维:、6 维旋转和夹爪;双臂 YAM 为 20 维;第一视角视频中的人手使用 21 个关节的三维位姿。位置和旋转均相对于块起始时的位姿表示;位置和夹爪使用第 1 至第 99 百分位数边界进行归一化并裁剪 |
| 动作块 | 24 行,在 15 Hz 下对应 1.6 秒;上下文窗口的首次调用返回 21 行。整个动作块会被完整执行 |
| 机器人状态 | 动作块开始时的绝对位姿,经过 z-score 标准化;训练时对 10% 的样本丢弃该状态 |
| 机器人专属组件 | 动作输入、位姿输入和动作输出投影层。主干网络和 Action Expert 在机器人之间共享 |
| 训练目标 | 视频流和动作流均采用 Rectified Flow。每个块对应一个视频噪声水平,采样偏向较高噪声;每个块对应一个动作噪声水平,独立均匀采样 |
| 采样器 | 对视频和动作进行 2 步联合 Euler 采样,使用 1 个上下文块,仅对视频应用文本引导。引导设置的选择过程见“寻找最优引导设置” |
| 模型规模 | 总计 27.2B 参数;使用 bf16 时占用 54.4 GB;可在一张 80 GB GPU 上运行 |
3. 训练阶段
Praxis-1 先学习世界如何运作,然后再学习如何行动。训练分为四个阶段,每个阶段都从上一阶段的权重开始,视频预测始终是训练目标的一部分。引入动作后,模型在学习视频预测的同时学习动作,而不是用动作预测取代视频预测。每个阶段都在现有 GPU 数量的基础上,通过梯度累积达到相应的有效 batch size。
3.1 视频预训练
backbone以 Runway 的视频基础模型为起点。这是一个在 12 种生成任务上预训练的统一模型:根据文本生成图像、视频、音频或带音频的视频;以及在文本之外,额外以最多三个参考图像、视频片段或声音为条件,生成上述相同类型的内容,例如根据图像和文本生成视频。
模型在通用视频数据上进行训练,使用全序列注意力,训练视频片段最长为 20 秒。
3.2 具身视频mid-training
主干网络切换为块级因果注意力,并在 15 fps 的具身视频上进行训练,这些视频记录了人手和机器人执行各种活动的过程。
数据主要是人类第一视角视频,涵盖烹饪、清洁、组装、打包等活动,同时还包含机器人视频、通用视频和少量游戏画面。
训练序列最长为 20 秒,采用 teacher forcing:模型根据前面各块的干净副本预测当前块。
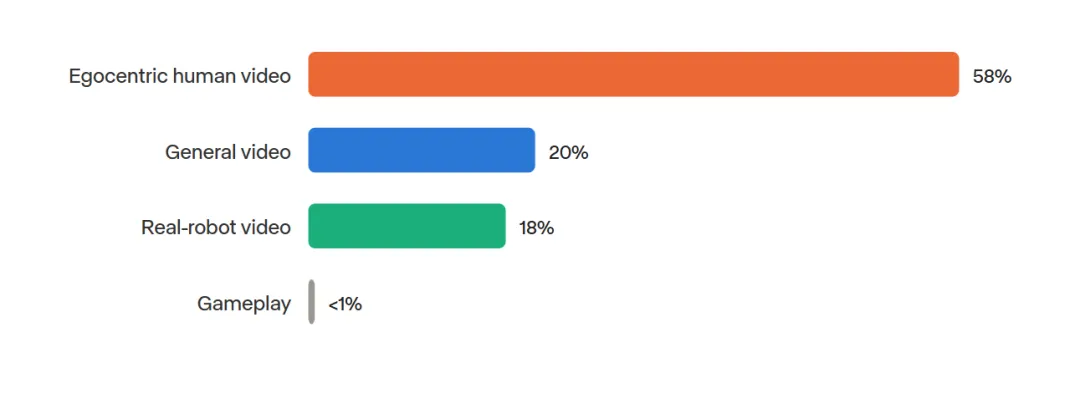
图 3:中期训练数据构成
对于本次发布模型微调所使用的起始 checkpoint,图中展示了中期训练 token 按视频类型划分的占比。
3.3 视频与动作联合中期训练
训练组件:主干网络 + Action Expert
接入一个以全新权重初始化的 Action Expert,并为机器人数据窗口加入动作目标。数据涵盖单臂、双臂以及低成本双臂机器人,每种本体均通过各自的投影层接入。
为了保护视频模型,在最初 1,500 次参数更新中,Action Expert 的学习率倍数以及从动作损失传入主干网络的梯度缩放系数,都从 0 逐步增加至 1。
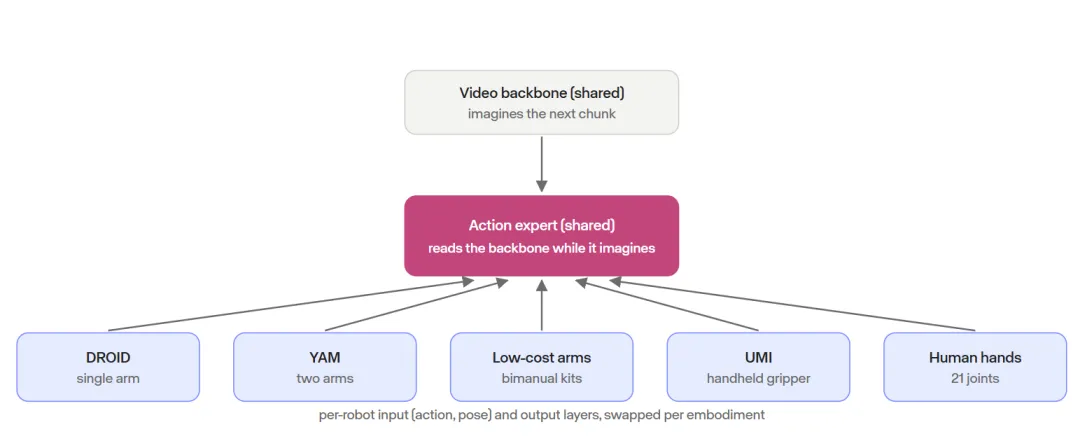
图 4:一个 Action Expert,可切换的机器人专属输出头
每种机器人本体使用各自的输入层(动作、位姿)和输出层,并根据本体进行切换。
主干网络和 Action Expert 在不同机器人之间共享;每种机器人只需增加自己的轻量级输入层和输出层。图中展示的是中期训练混合数据中的部分示例。
损失函数是视频速度损失和动作速度损失的等权重之和。视频和动作的噪声水平独立采样,因此动作噪声水平不受视频干净程度的限制。
Muon 负责优化大多数权重矩阵;AdamW 负责优化 embedding、输出头、输入和输出投影层以及路由器。梯度裁剪阈值为 1.0,只有文本编码器和 VAE 保持冻结。
在这一阶段,我们仍保留约 30% 从第二阶段延续的纯视频任务,使视频模型能够继续在没有动作目标的视频数据上训练。
3.4 特定本体微调
训练组件:backbone + Action Expert + 本体专属输出头
最后一个阶段针对目标机器人微调整个经过中期训练的模型。本文中的其他微调实验,即双臂 YAM 和 RT-1,也遵循相同的训练配置。
backbone和 Action Expert 原样加载中期训练结束时的权重,只有该机器人专属的输入和输出投影层从头开始训练。除冻结的编码器外,其余部分均参与训练,同时保留视频损失。
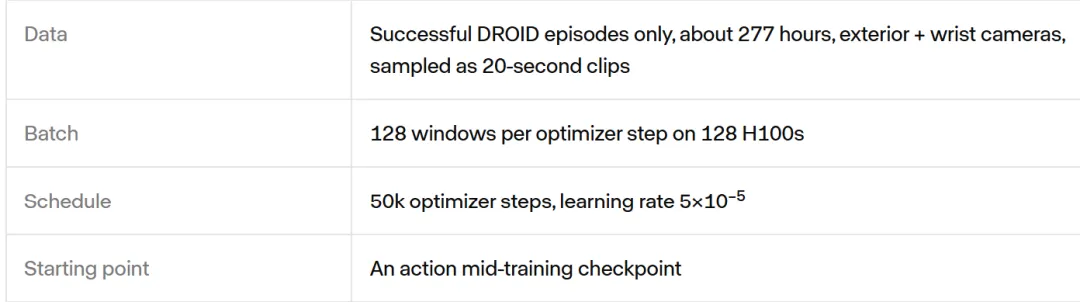
表格列出了本文所用示例的具体设置:在 DROID 上微调单臂 Franka。DROID 是一个公开的真实世界 Franka 机器人示范数据集。
4. 中期训练的算力 Scaling
我们预计,增加中期训练算力可以为微调提供更强的基础模型。我们在两种机器人上验证了这一点:Franka 出现在 DROID 中期训练数据混合集中;RT-1 则是一个全新的机器人本体,从未出现在任何预训练或中期训练阶段。
每个数据点都是同一次中期训练运行中的一个 checkpoint,横坐标为到达该 checkpoint 所花费的总计算量,包括视频预训练。由于较晚的 checkpoint 会重复使用相同的中期训练数据,这里衡量的是增加训练计算量的效果,而不是增加数据量的效果。
在对两种机器人本体进行的实验中,更多的中期训练确实带来了更好的微调结果。我们从视频与动作联合中期训练过程中选取了 5 个 checkpoint,使用相同的训练计划在 DROID 上进行微调。在 RoboLab-120 上,所有数据点使用相同的采样器设置,前 4 个 checkpoint 的成功率依次提升,为 25.5%、35.2%、39.2% 和 41.2%;第 5 个 checkpoint 稳定在 41.2%。
RT-1 不在中期训练数据中,因此可以让我们在未见过的机器人上检验同一个问题。我们使用相同的训练配置,将 5 个中期训练 checkpoint 在 RT-1 上进行微调。SimplerEnv 成功率从最早 checkpoint 的 56.3% 提升至最新 checkpoint 的 80.0%,但并非每一步都单调提升,如图 6 所示。
我们在训练中见过和未见过的两种本体上都观察到了闭环性能提升的趋势,但两者之间的精确关系仍需进一步研究。
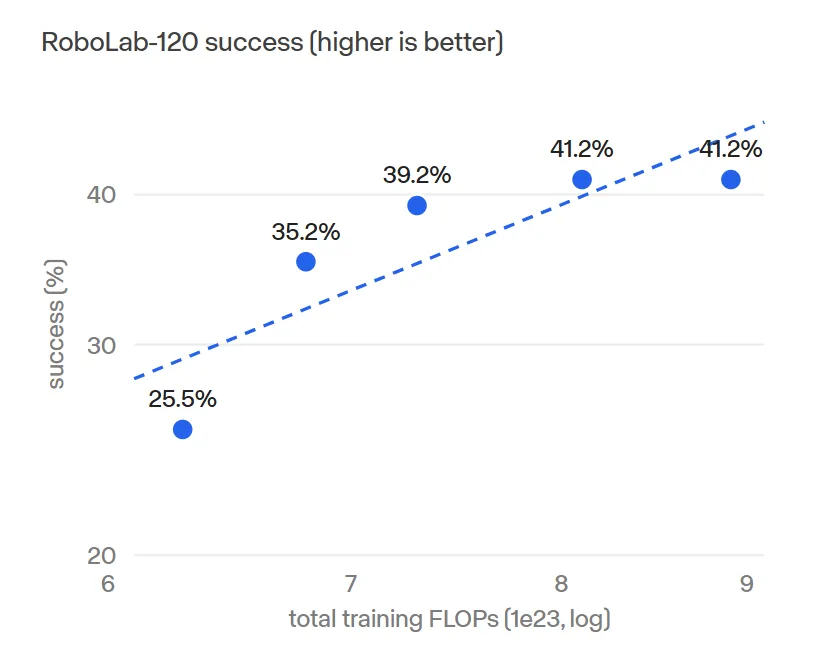
图 5:微调效果与总训练计算量的关系——DROID(见过的本体)
RoboLab-120 成功率。DROID 包含在中期训练数据中。每个数据点都对应从一个中期训练 checkpoint 出发、在 DROID 上微调得到的模型。图中使用双对数坐标;虚线是对 5 个数据点拟合出的趋势,仅供参考,并不代表某种定律。
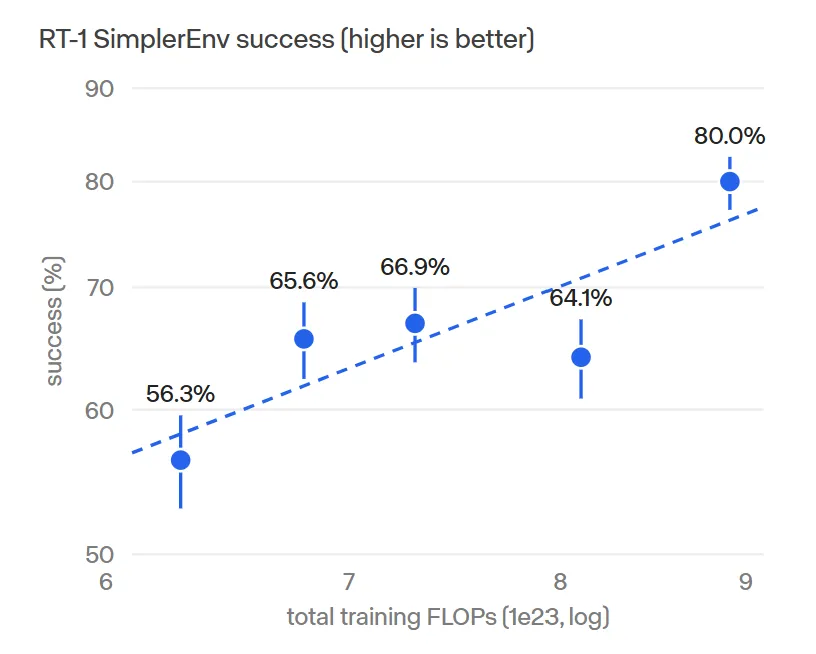
图 6:微调效果与总训练计算量的关系——RT-1(未见过的本体)
SimplerEnv 成功率,使用 Google 机器人视觉匹配设置;包含 4 个任务,每个数据点评估 864 个 episode,每个模型均微调 30,000 步。误差条表示 95% 区间。图中使用双对数坐标;虚线为拟合趋势,仅供参考,并不代表某种定律。
5. 推理
我们的模型逐块预测动作:机器人执行完整的动作块,返回观测到的画面,然后通过同一个 WebSocket 再次调用模型。
每次策略调用以 15 Hz 返回 24 行动作,即 1.6 秒的运动。动作与想象的视频一起,通过 2 步联合 Euler 采样进行去噪。上下文窗口的首次调用仅返回 21 行,因为 6 个潜在帧中的第一帧只覆盖当前帧,而不是 4 帧。
在单张 H100 服务器上,采用默认的分块执行方式时,一次调用的往返耗时约为 0.55–0.6 秒,约为返回的 1.6 秒动作时长的三分之一。默认情况下,我们以串行方式运行视频的无分类器引导(classifier-free guidance,CFG)。
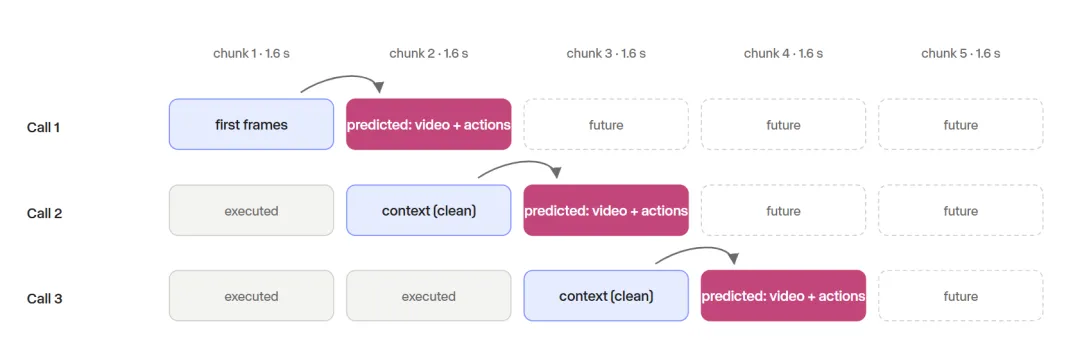
图 7:Praxis-1 如何预测下一个动作块
每次调用读取一个干净的上下文块(蓝色),同时预测接下来 1.6 秒的视频和动作(粉色)。机器人执行该动作块,执行期间相机观测到的画面成为下一次调用的上下文。
我们还探索了实时分块(real-time chunking,RTC):机器人不必等待当前动作块执行完毕,而是在执行到一半时请求下一个动作块,并持续运动。
难点在于两个动作块的衔接。将新旧计划直接混合会使机械臂产生振荡,因此,新计划改为使用模型自身的运动预测,从机械臂实际将要到达的位置继续执行。
在我们的双臂工作站上,这使静止等待所占的时间比例降低了约 5 倍:在每次调用耗时 0.8–0.9 秒的一次实验中,从 32% 降至 5%;使用更快的服务器、每次调用约 0.3 秒时,从 16% 降至 3%。
在将 5 个物体抓取并放入袋中的任务上,RTC 达到了与分块执行相近的成功率:RTC 为 24/30,分块执行为 28/30;同时完成速度更快,成功任务的耗时中位数分别为 9.1 秒和 15.2 秒。
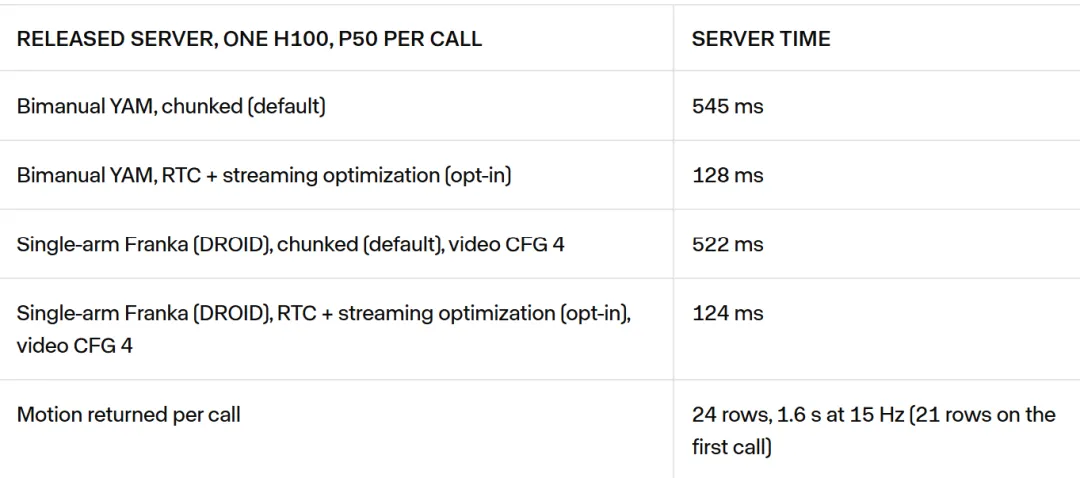
在我们发布的代码仓库中,RTC 需要主动启用;默认设置为分块执行。
6. 实验结果
本节中的所有结果均来自同一个 Praxis-1 checkpoint,该 checkpoint 按照“训练阶段”中介绍的配置在 DROID 上进行微调。我们在仿真环境 RoboLab-120 中对其进行评估,同时在一台由 Positronic 操作的真实 Franka FR3 机械臂上进行评估。
6.1 RoboLab-120
截至本文发布时,在 NVIDIA 的 RoboLab-120 排行榜上:
世界动作模型第一名;
开源机器人基础模型第一名。
RoboLab-120 是 NVIDIA 推出的仿真 benchmark,包含 120 个面向 DROID 风格机械臂的桌面任务。按照每个任务进行 10 次试验的官方评估协议,在 DROID 上微调后的 Praxis-1 在 1,200 个 episode 中完成了 555 个,成功率为 46.2%,在排行榜上的所有世界动作模型和开源机器人基础模型中均排名第一。紧随其后的是 FLUX 3 Action,成功率为 42.9%。Praxis-1 的成绩也超过了榜单上所有开放权重的 VLA,包括 π0.5 和 GR00T N1.6。
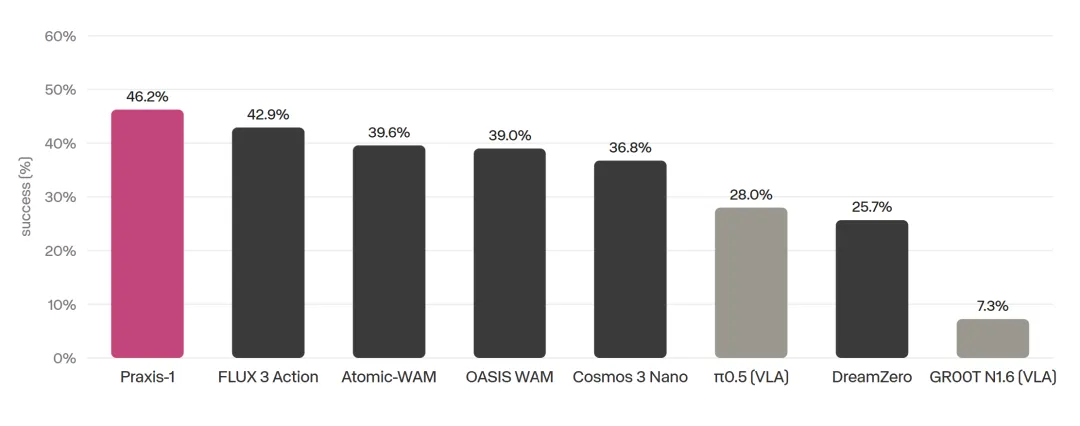
图 8:RoboLab-120 成功率——世界动作模型与开放权重 VLA
世界动作模型以深色表示,开放权重 VLA 以灰色表示;每个任务进行 10 次试验。
以下展示成功的 episode,每个任务展示一个。
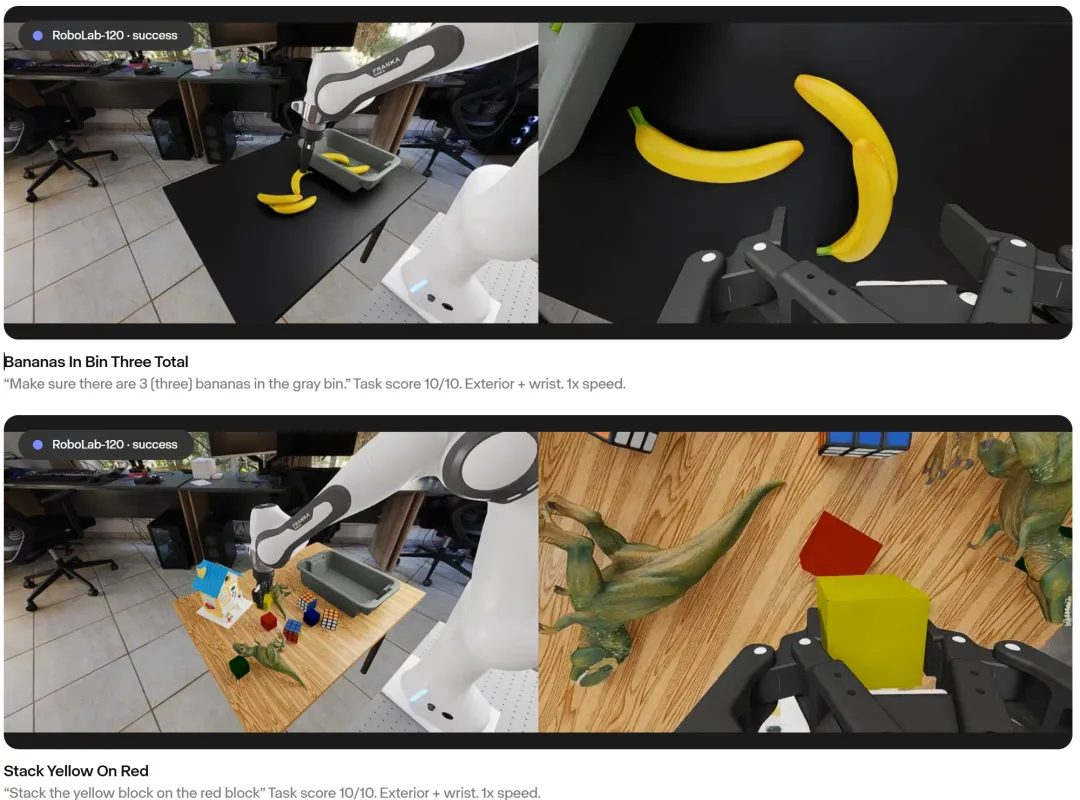
箱子里共有三根香蕉:“确保灰色箱子里有 3 根香蕉。”该任务成绩为 10/10。外部视角和腕部视角,1 倍速。
将黄色积木叠在红色积木上:“将黄色积木叠在红色积木上。”该任务成绩为 10/10。外部视角和腕部视角,1 倍速。
调整白色马克杯的朝向:“确保所有白色马克杯都正立,杯口朝上。”该任务成绩为 10/10。外部视角和腕部视角,1 倍速。
将魔方放在碗后面:“将魔方放在碗后面。”该任务成绩为 10/10。外部视角和腕部视角,1 倍速。
将积木放入箱子:“将所有彩色积木整理到箱子里。”该任务成绩为 10/10。外部视角和腕部视角,1 倍速。
先放魔方,再放香蕉:“将魔方、然后将香蕉放进碗里。”该任务成绩为 9/10。外部视角和腕部视角,1 倍速。
将较小的物体放入箱子:“将较小的物体放进灰色箱子。”该任务成绩为 10/10。外部视角和腕部视角,1 倍速。
将绿色青柠放在盘子里:“将所有绿色水果放在盘子里。”该任务成绩为 10/10。外部视角和腕部视角,1 倍速。
将三个水果放在盘子里:“将 3 个水果放在盘子里。”该任务成绩为 10/10。外部视角和腕部视角,1 倍速。
将记号笔放进马克杯:“将白板笔放进马克杯。”该任务成绩为 7/10。外部视角和腕部视角,1 倍速。
拆开堆叠的魔方:“将堆叠的魔方拆开。”该任务成绩为 10/10。外部视角和腕部视角,1 倍速。
堆叠白色马克杯:“将白色马克杯叠在一起。”该任务成绩为 9/10。外部视角和腕部视角,1 倍速。
取出量勺:“从红色碗中取出白色量勺,并将其放在桌子上。”该任务成绩为 10/10。外部视角和腕部视角,1 倍速。
将调味品放入箱子:“将酱料调味品整理到灰色箱子里。”该任务成绩为 8/10。外部视角和腕部视角,1 倍速。
将粉色勺子放入锅中:“将粉色意大利面勺放进锅里。”该任务成绩为 7/10。外部视角和腕部视角,1 倍速。
从箱子里取出键盘:“从箱子里取出键盘,并将其放在桌子上。”该任务成绩为 7/10。外部视角和腕部视角,1 倍速。
更多demo可以查看原文
在 RoboLab-120 上,有四个参赛模型的得分高于 Praxis-1。前两名是直接使用前沿模型控制机器人的 Agent,而不是经过训练的策略:AMP1 的成功率为 86.0%,被列为 zero-shot 前沿模型 Agent;SenseNova-RoboRSI 的成功率为 57.1%,使用前沿 VLM 作为策略。
SenseNova-RoboRSI 的速度远慢于 Praxis-1。其作者报告,在一个类似的桌面 benchmark——RoboDojo 上,对于 8–76 秒的指令运动,每个 episode 约需 55 分钟的计算时间,并认为这一执行时间难以用于实际部署。Praxis-1 则在单张 H100 上,用约 0.55–0.6 秒计算出每个 1.6 秒的动作块。
另外两个模型 Lakeside(51.0%)和 BiMind v0.5(49.2%)是部分使用仿真数据训练的闭源模型,其中 BiMind v0.5 还在 RoboLab 数据上进行了微调。
6.2 真实机器人
在由 Positronic 操作的 Franka FR3 工作站上,我们使用 FLUX 3 Action 公布的 10 个单物品操作任务评估 Praxis-1。每个任务进行 10 个 episode,分为两轮,每轮 5 个,均于 11 月 2 日在同一套设备上运行。汇总后,Praxis-1 在 100 个 episode 中成功 88 个,FLUX 3 Action 成功 80 个。
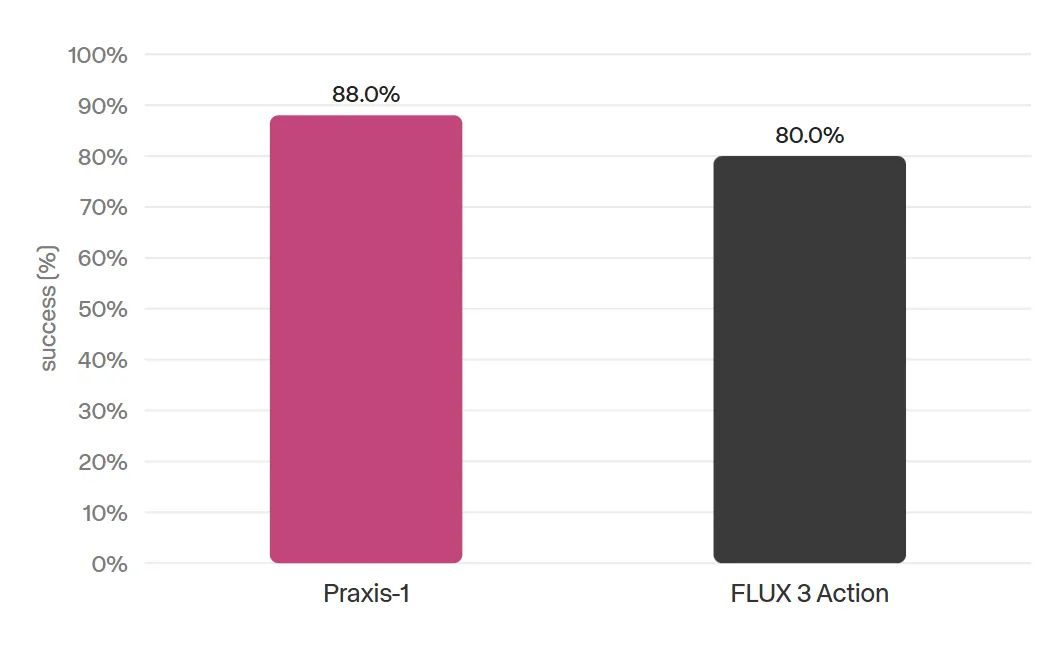
图 9:与 FLUX 3 Action 的真实机器人直接对比
在相同的 10 个任务上,各模型在 100 个 episode 中的成功次数。
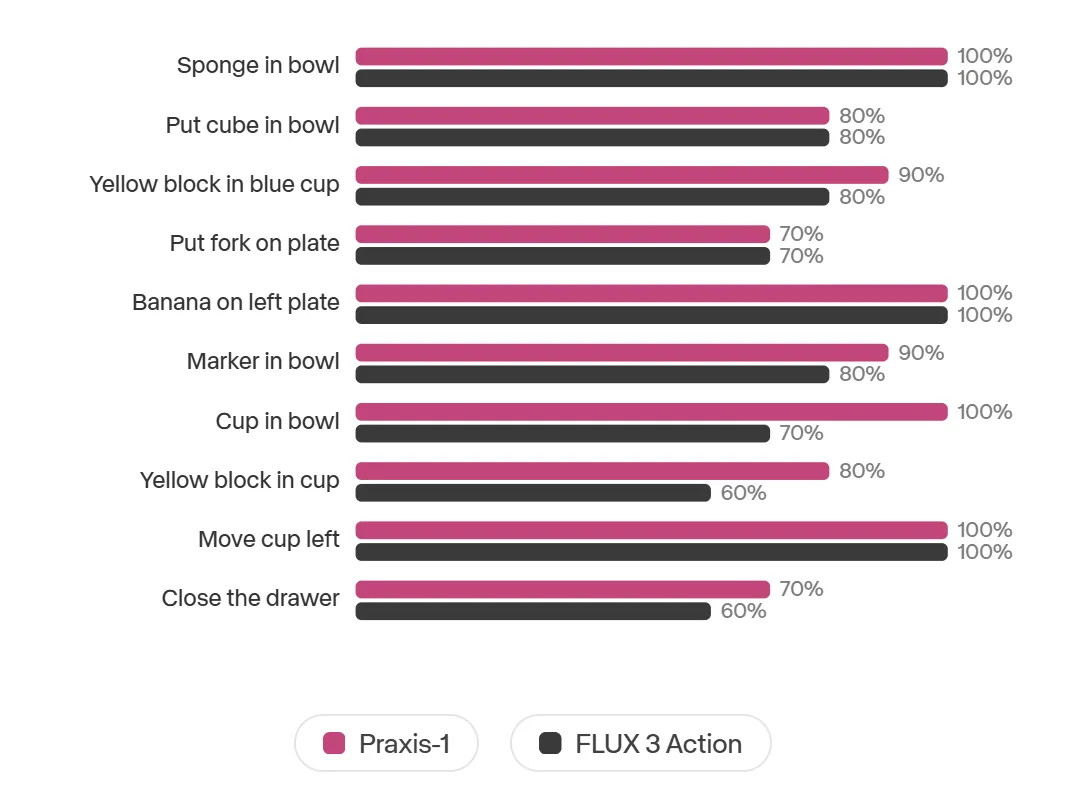
图 10:逐任务结果,每个任务 10 个 episode
Praxis-1 与 FLUX 3 Action 在每个任务上的成功率。
以下展示成功的 episode,每个任务展示一个。
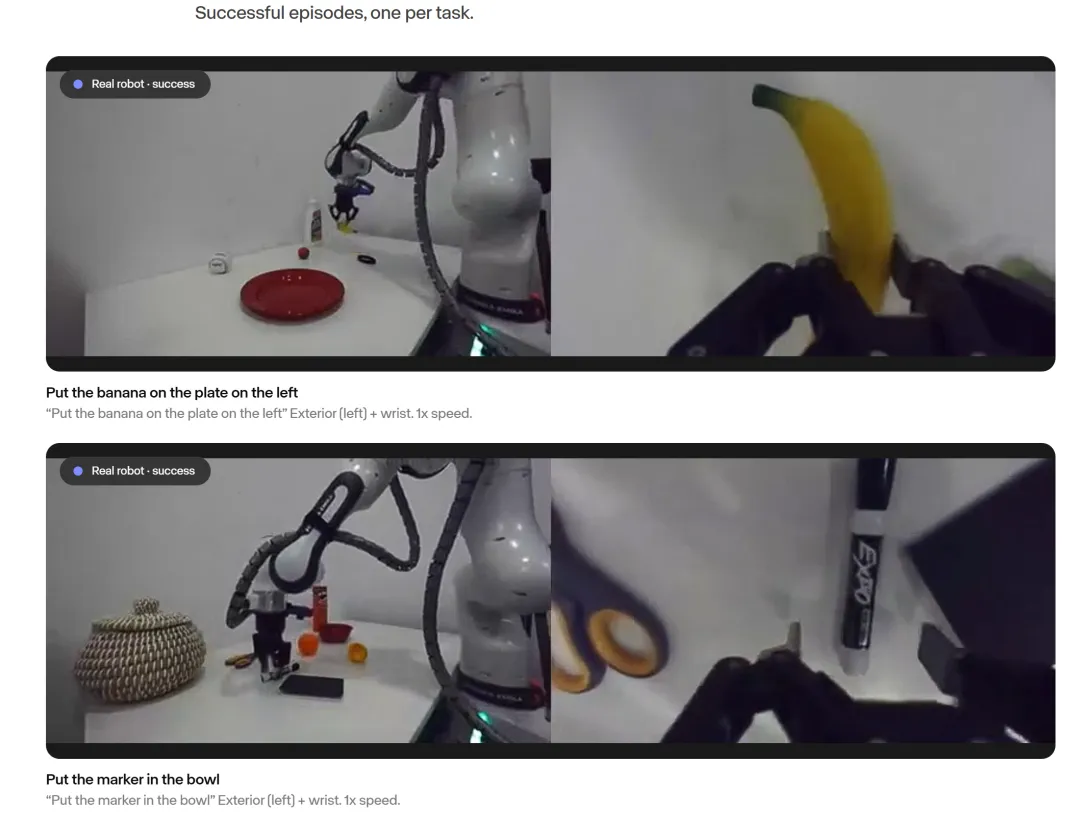
真实机器人 · 成功
将香蕉放在左侧盘子上
“将香蕉放在左侧盘子上。”
外部视角(左侧)和腕部视角,1 倍速。
真实机器人 · 成功
将记号笔放进碗里
“将记号笔放进碗里。”
外部视角(左侧)和腕部视角,1 倍速。
真实机器人 · 成功
将杯子放进碗里
“将杯子放进碗里。”
外部视角(左侧)和腕部视角,1 倍速。
更多demo查看原文
7. 实时执行日常任务
在排行榜上取得第一是一回事,在真实机器人上运行是另一回事。这里,Praxis-1 控制两种真实机器人执行日常任务:双臂 YAM 机器人的两条机械臂协同完成单臂无法独立完成的任务,另一种则是单臂 Franka。以下每段视频均展示策略自主控制的过程,没有遥操作,播放速度为 1 倍速。
YAM 微调采用与 DROID 相同的训练配置:从动作中期训练 checkpoint 开始,使用约 1,400–2,600 小时由三个相机采集的双臂 YAM 数据进行学习。
7.1 双臂机器人(YAM)
以下数据在 Runway 办公室的双臂 YAM 工作站采集,以真实速度播放;每段视频均标注了对应的指令。视频包含外部视角、左腕视角和右腕视角。
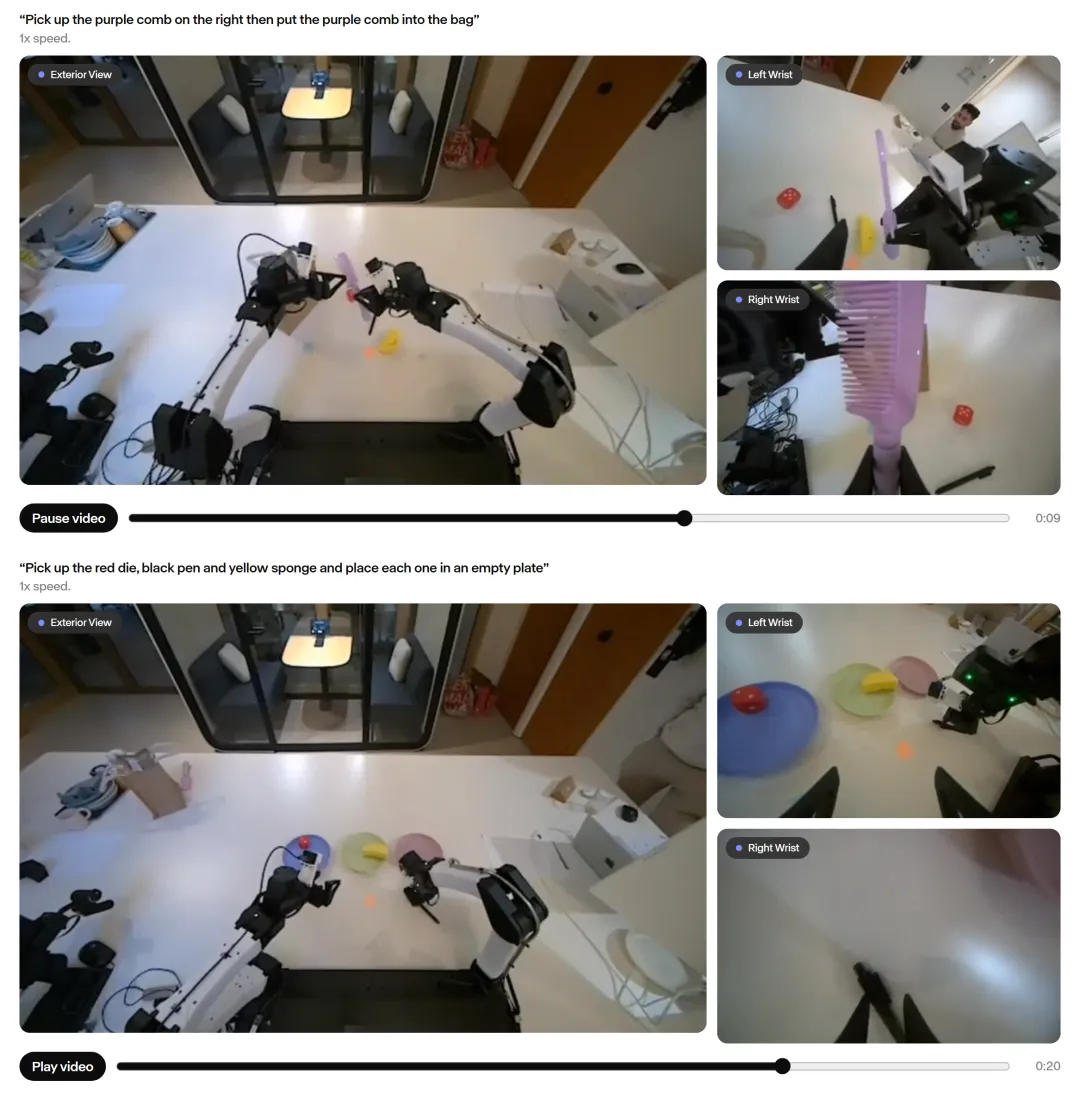
“拿起右边的紫色梳子,然后将紫色梳子放进袋子。”
“拿起红色骰子、黑色笔和黄色海绵,分别将它们放进一个空盘子。”
“将白色马克杯倒扣在黄色托盘上。”
“拿起泰迪熊,将它放在毛巾上。”
“拿起盖子,盖上盒子。”
“拿起红辣椒,将它放进马克杯。”
“拿起砧板,将它放在黄色托盘上。”
“拿起塑料瓶,将它们放进银色垃圾桶。”
以上视频均以 1 倍速播放。
7.2 单臂机器人(Franka,DROID)
以下数据由 Positronic 在 Franka FR3 工作站采集,以真实速度播放;每段视频均标注了对应的指令。视频包含外部视角和腕部视角。
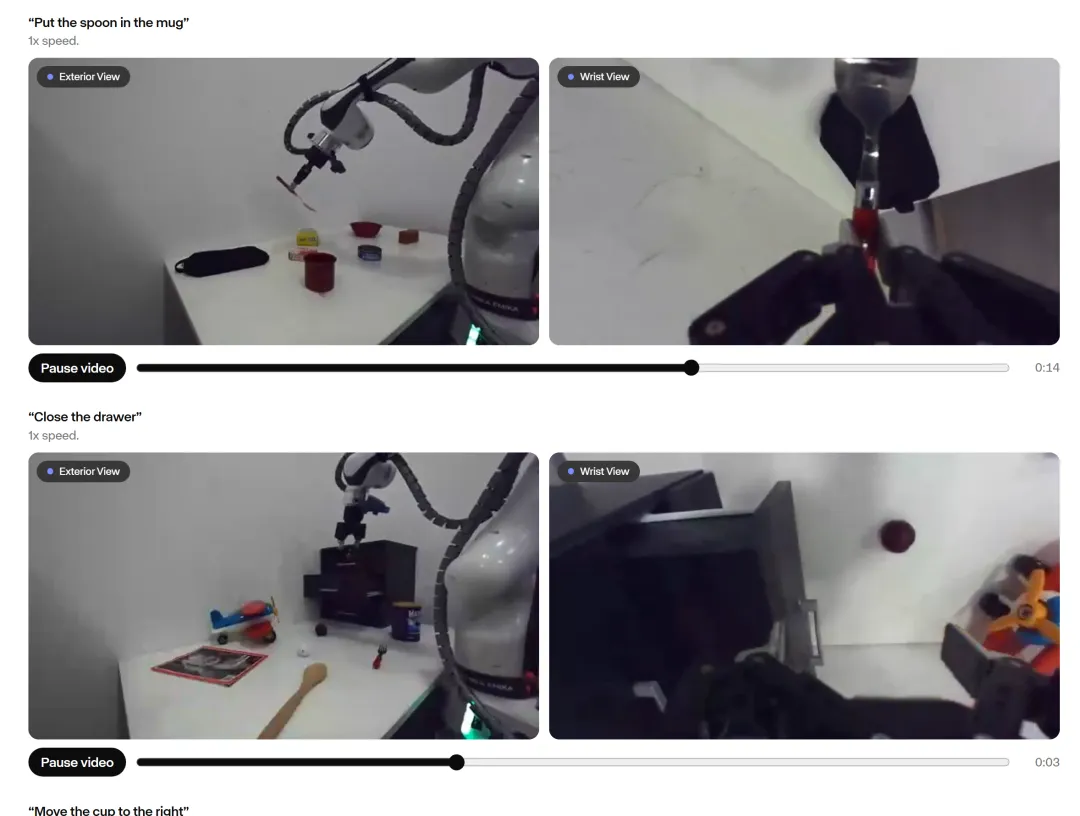
“将勺子放进马克杯。”
“关上抽屉。”
“将杯子向右移动。”
“将笔放进杯子。”
“将记号笔放在桌子上。”
“将叉子放在盘子里。”
“将黄色积木放进蓝色杯子。”
以上视频均以 1 倍速播放。
7.3 与前沿 LLM Agent 的比较
前沿多模态模型现在可以通过工具或代码接口,以 zero-shot 的方式控制机械臂。GPT-6 Astra 首次接受评估时,以 22.5% 的成功率超过了 RoboDojo 上所有公开参赛模型,并在 RoboTwin 2.0 上达到了 76.0% 的成功率。
这些 Agent 具有通用性:它们能够以 zero-shot 的方式解决各种任务。目前,它们在 RoboLab-120 排行榜上处于领先地位,排名前两位的都是 LLM Agent,成功率分别为 86.0% 和 57.1%。
它们的缺点是延迟和成本。在 AA-Robotics benchmark 上,Astra 完成每个桌面任务平均需要 30 分钟、花费 16.36 美元,而人类仅需 20 秒。Zhou 等人也报告称,其推理延迟阻碍了实际部署。
为了自行衡量这一差距,我们让 Praxis-1 和 GPT-6 Astra 在同一个 YAM 遥操作工作站上,通过同一个控制台执行相同的三个任务。平均而言,Astra 完成任务所需的时间是 Praxis-1 的 15.6 倍,每个成功完成任务的成本是 Praxis-1 的 51 倍,如图 11 和图 12 所示。
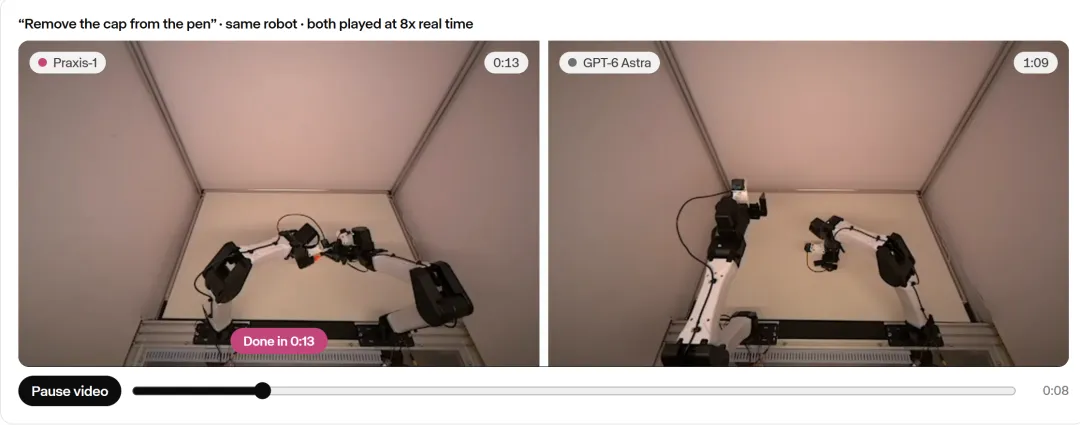
“拔下笔帽”:同一台机器人,均以真实时间的 8 倍速播放
Praxis-1:13 秒完成。
GPT-6 Astra:7 分 54 秒完成。
图 11:拔下笔帽——Praxis-1 与 GPT-6 Astra
俯视相机画面。两侧的计时均为机器人执行时间。Praxis-1 位于左侧,耗时 13 秒;GPT-6 Astra 位于右侧,耗时 7 分 54 秒。
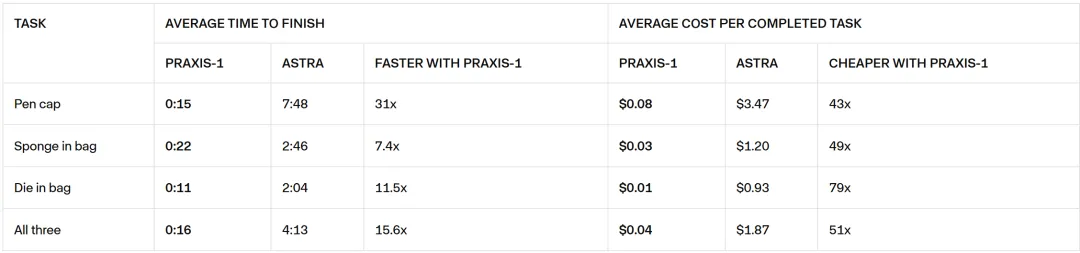
图 12:Praxis-1 与 GPT-6 Astra 的任务完成时间和成本
时间取成功 episode 的平均值,从策略接管控制开始计时,直到 episode 结束。每个成功完成任务的成本计入所有 episode,包括失败的 episode:Praxis-1 按每小时 3.95 美元的一张 H100 计算,Astra 按 API 账单计算。数据采集于 2026 年 11 月 9 日。
前沿 LLM Agent 正在迅速进步,两种方法也具有互补性:Agent 可以规划一项新任务,而 Praxis-1 这样的快速策略可以实时执行其中的每个步骤。我们正在研究如何将二者结合,作为未来工作的一部分,详见“未来方向”。
8. 适配新机器人
8.1 Google RT-1
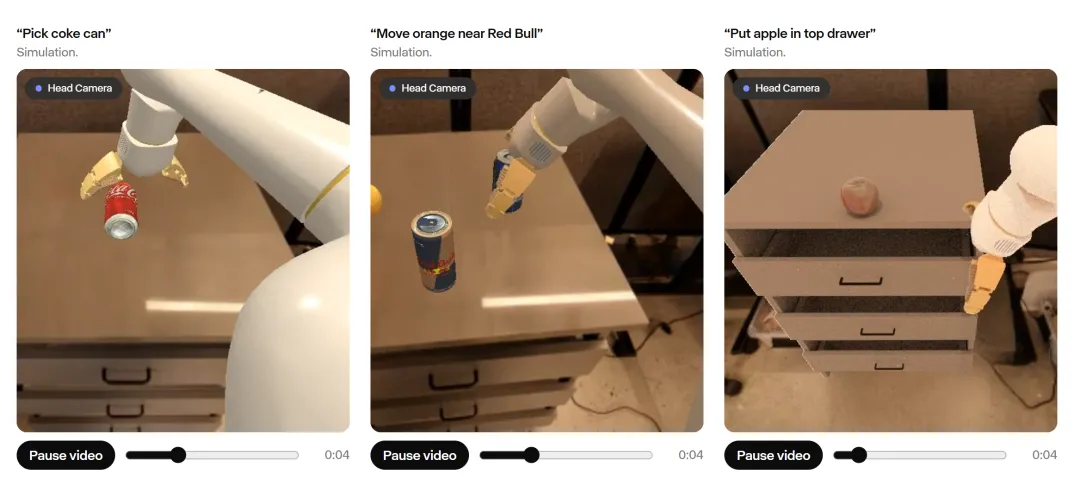
为了进一步测试 Praxis-1 如何适应从未见过的机器人,我们在 Google 的移动操作机器人 RT-1 上进行了微调,其采集数据从未出现在我们的中期训练混合数据集中。
我们从最新的中期训练 checkpoint 出发,使用完整的 RT-1 训练集进行 30,000 步微调,在 32 张 H100 上耗时约 28 小时。训练集包含约 78,000 个 episode、95 小时数据,仅使用头部相机。我们在 SimplerEnv 官方视觉匹配网格上评估模型,该评测包含 4 个任务、864 个 episode,也是大多数 RT-1 策略报告结果时采用的 benchmark。
在 RT-1 上微调后的 Praxis-1,在四个任务上的平均成功率达到 80.0%,高于 RT-1 自身的 52.4%。作为比较,我们按照 Black Forest Labs 公布的 DROID 微调配置,从其基础 checkpoint 出发,使用相同的 RT-1 数据微调 FLUX 3 Action,得到的成功率为 39.7%。
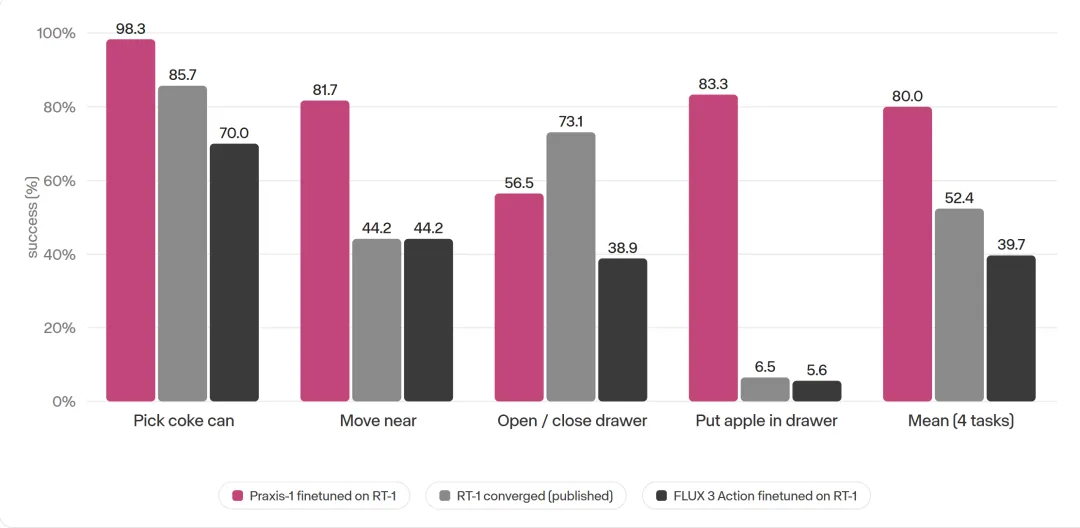
图 13:SimplerEnv Google 机器人逐任务结果(视觉匹配)
在官方视觉匹配网格上评估的各任务成功率。
以下仿真视频展示头部相机视角:
8.2 SO-101
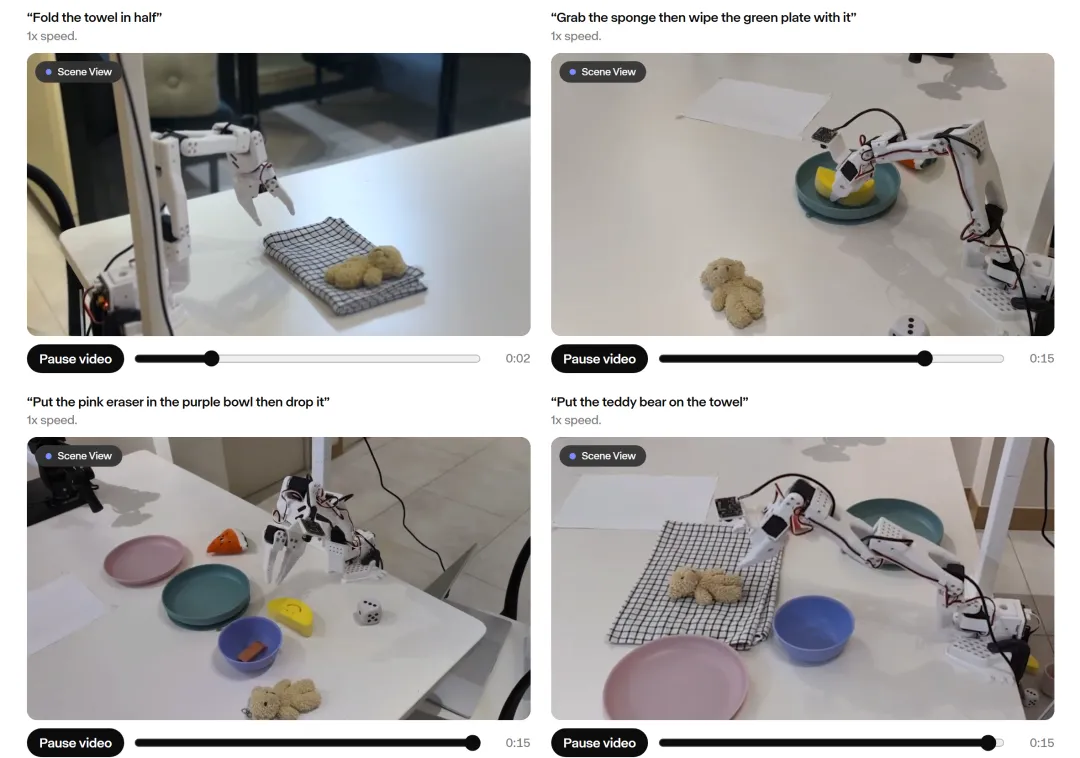
SO-101 是一款面向爱好者和研究人员的低成本开源单臂机器人,其社区已经上传了数千个小型 LeRobot 数据集。我们收集了来自 1,783 名贡献者的 3,956 个公开 SO-100/SO-101 数据集,总时长约为 1,260 小时,大多以 30 fps、 分辨率采集。
每个数据集包含 1 至 3 个场景相机;其中 2,438 个数据集还包含腕部相机,对应约 860 小时的数据。
社区数据集中的相机名称并不可靠:名为“phone”或“top”的相机通常安装在手腕上。因此,我们根据视频为每个相机标注类型,只有当两种检查结果一致时,才将其计为腕部相机:
运动检查:在连续 64 帧中,固定场景相机的大部分像素保持静止,而腕部相机不会。
外观检查:使用 zero-shot CLIP 模型判断。
我们从微调数据中留出 102 个完整数据集,共 64 小时,用于验证;使用其余数据集中的训练 episode 微调 Praxis-1,训练数据来自 3,814 个数据集,总时长约 1,070 小时。
每个样本使用一个场景相机;如果存在腕部相机,也会加入腕部画面。对于包含腕部相机的数据集,采样时也会只使用场景相机,使一个模型无论有没有腕部相机都能运行。
模型以 15 Hz、每块 1.6 秒的形式,预测机械臂的 5 个关节和夹爪动作。其中,关节动作表示为相对于当前状态的偏移量。指令采用视频片段的任务描述,或采用落在每个训练窗口内、自动生成字幕的子步骤。
以下每段视频均展示策略根据单条指令进行控制,以 1 倍速播放,视角为场景视角。
9. 寻找最优引导设置
Praxis-1 通过两步去噪对每个动作块进行采样,并且仅对指令应用无分类器引导:无引导的前向计算保留视频历史和位姿,但将指令替换为空白文本。
视频引导系数决定预测视频遵循指令的强度;系数为 1 时,相当于关闭引导。
第二个可调参数是 flow shift,它会改变两步去噪的时间网格。更大的 shift 会使更多去噪工作留到第二步。视频和动作共享同一个 shift,我们针对二者共同调节;为视频和动作分别设置 shift 留待未来研究。
我们在一组固定的仿真环境中,通过逐步搜索设置这两个参数,起点为关闭视频引导、shift 为 8。加入视频引导有助于提升表现,同时提高视频引导系数和 shift 可以进一步提升表现,最终比起点高出 4.0 个百分点;继续增大任一参数则会导致得分下降。
我们发布的模型使用视频 CFG 为 4、shift 为 12.5、去噪步数为 2 的设置。这些引导设置针对特定机器人本体:它们是为 DROID Franka 调节的,其他机器人需要各自调节。
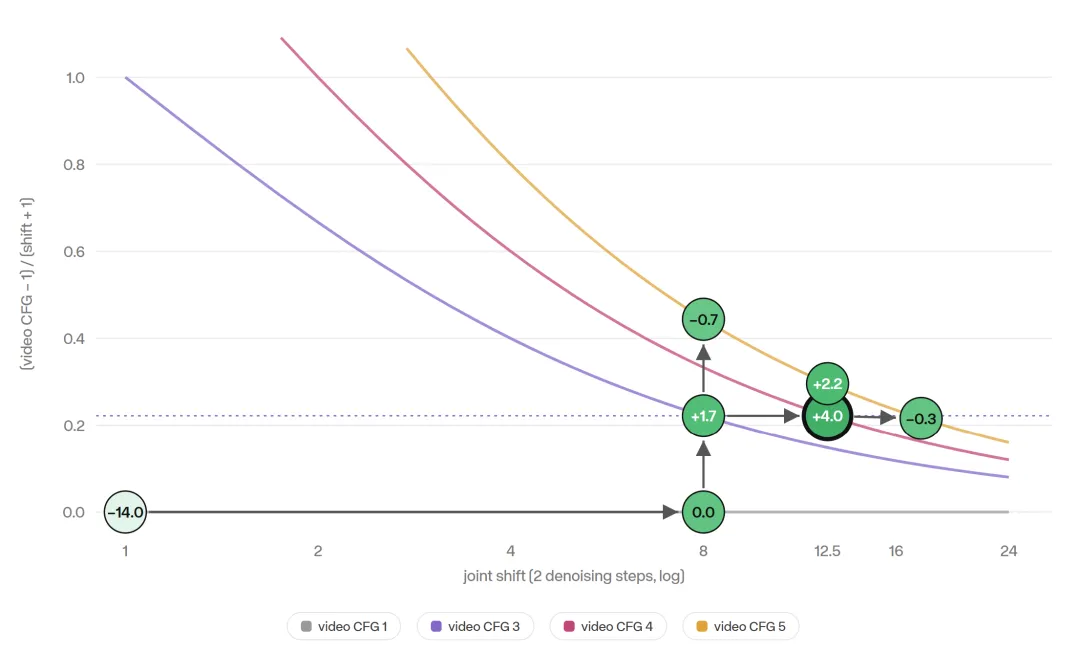
图 14:不同设置下视频 CFG 对动作的引导程度
圆圈表示经过测试的设置,标注数字表示相对于起始设置——关闭视频引导、shift 为 8——的任务成功率变化,单位为百分点;箭头表示搜索过程。
10. 离线评估
除了闭环 benchmark,我们还从两个方面以开环方式评估模型:动作预测的准确程度,以及模型想象出的未来是否遵循指令。
10.1 误差来自预测视频还是预测动作?
我们在 32 个留出的 DROID 窗口上,将动作误差定义为预测的末端执行器绝对位置与真实位置之间的距离。我们使用两种条件输入模式,区分两类误差来源:想象出了错误的未来,以及从正确的未来中读取出了错误的运动。
部署模式:模型像在机器人上运行时一样,同时采样自身的视频和动作。
Oracle 模式:参照 mimic-video 中的 Oracle 测试,我们将真实的未来视频加噪至采样器对应的噪声水平后提供给模型,仅采样动作。
我们观察到,剩余误差主要来自视频模型想象出的未来,而非 Action Expert。因此,改进未来视频预测应当能带来最大的收益。当给定真实未来时,误差约为原来的五分之一。
需要注意,部署模式下的误差并非完全可靠的指标:它同时包含未来视频和未来动作的预测误差,而多个不同的未来都可能完成同一任务。下一节将讨论一种更好的生成视频评估方法。
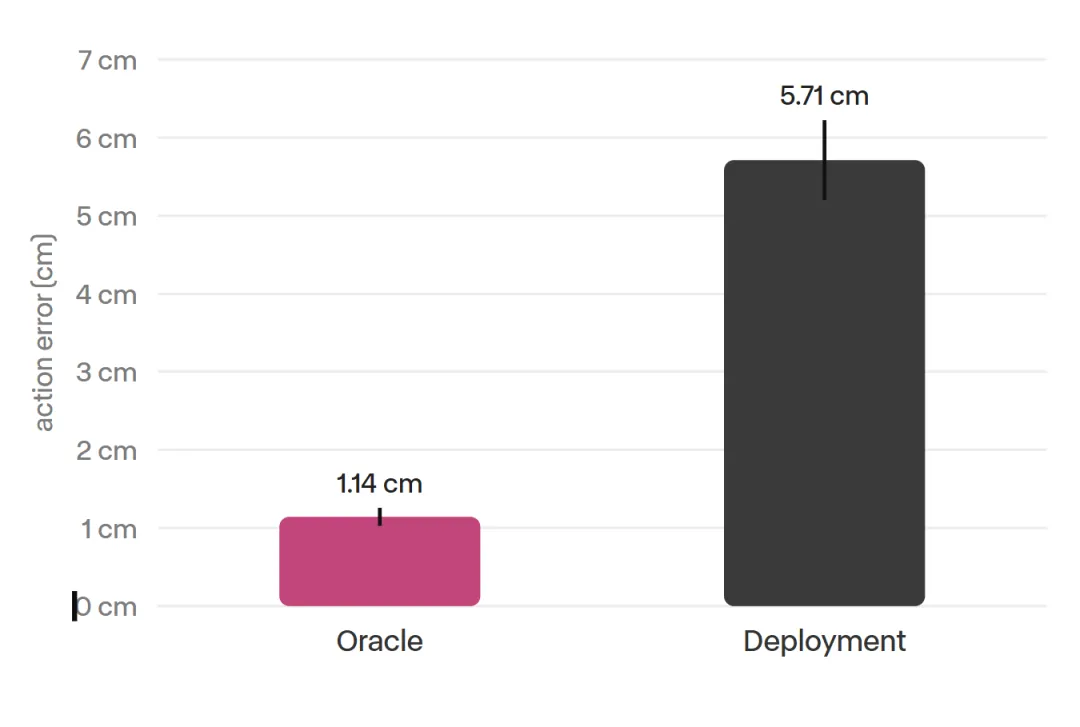
图 15:已发布 checkpoint 的 Oracle 与部署模式动作误差
在留出的 DROID 窗口上计算的平均末端执行器误差;误差条为 个标准误。数值越低越好。
10.2 模型能否在执行任务之前想象任务过程?
为了了解模型如何规划和想象未来,我们向其提供一个三维构建场景的单张首帧、一条指令,以及机器人的真实起始位姿,而不是提供真实 episode。该场景中只有背景来自真实图像,其他物体则以不同的颜色、大小和位置加入。
随后,模型自行 rollout 12.6 秒,同时预测视频和动作;除第一帧外,不再获得任何真实观测。
一个视觉语言评判模型观看每段预测视频,只有在模型操作了正确的物体、将其移动到正确的位置并执行了正确动作时,才判定该视频遵循了指令。这些场景中包含外观相似的物体,用于测试模型遵循 prompt 的稳健性。
想象过程中的指令遵循能力,是衡量模型对任务理解程度的一个代理指标;它与真实世界任务成功率之间的关系仍需进一步研究。
以下示例来自 DROID prompt 集:从展示的第一帧开始,使用在 DROID 上微调的 Praxis-1 进行 12.6 秒的开环自 rollout,并给出评判模型的判断结果。
同样的想象 rollout 方法也用于评估中期训练基础模型,该模型没有针对任何特定机器人本体进行微调。以下长时程示例来自该基础模型在双臂 YAM 工作站上的结果,展示目的是呈现视频质量,而不是任务成功率。
每个示例都从三维构建场景的单张首帧开始,而非从真实 episode 开始。模型在没有真实机器人和动作输入的情况下,想象三个相机视角下长达 20 秒的视频。我们还在每次 rollout 过程中改变指令,以观察模型能否在视频预测中作出相应反应。每个示例的指令变化列于下方。
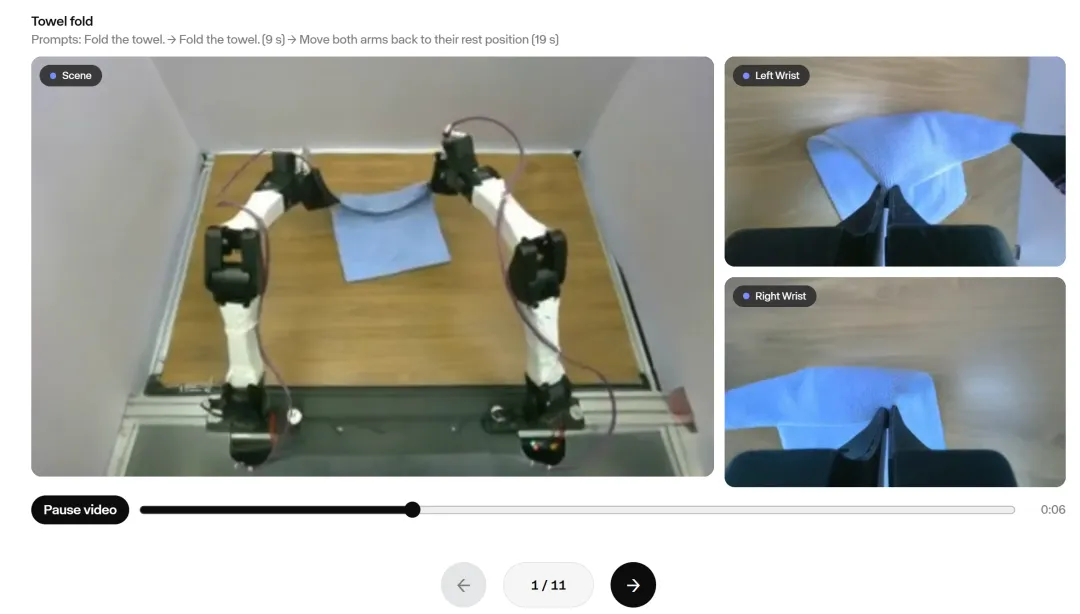
更多demo查看原文
10.3 模型能否预测任务是否会成功?
我们希望了解,模型对自身未来的预测,是否也能反映任务是否会成功。
在一项内部研究中,我们使用了该模型的一个较早、未发布版本,并在 Franka 机械臂上进行了微调。我们冻结模型权重,在其对下一个预测块的表征之上训练了一个小型输出头,用于估计从当前时刻开始,该 episode 最终成功的概率。其唯一的监督信号是整个 episode 的最终结果,没有人工评分。
我们使用来自模型未见过的实验场次和策略的 272 个真实 Franka episode 进行评估。在执行 4 个动作块、约 6 秒后,该分数区分成功与失败的 AUROC 为 0.77,95% 置信区间为 0.70–0.83;仅使用已耗时间作为指标时,AUROC 为 0.64。
对每个策略取平均后,该分数还能够根据真实成功率,对 9 组 checkpoint 和采样器组合进行排序,Spearman 相关系数为 0.79,但其区间较宽,为 0.19–1.00。
这仍是早期证据。该输出头目前还不读取指令,因此,无论机器人执行的是否是正确任务,只要它干净利落地完成了一次抓取放置,就会得到相同的分数。
尽管如此,这一结果指向了我们最关心的方向:让模型利用自己想象出的未来为动作评分,再据此改进动作,从而从自身的视频预测中学习。我们正在积极研究这一方向,以构建真正能够自我改进的世界动作模型。
图 16:根据模型自身预测的未来预测真实机器人任务成功率
在 272 个留出的真实 Franka episode 中,执行 4 个动作块后的 AUROC;0.5 相当于随机水平。误差条为对实验场次和任务分组进行重采样得到的 95% 区间。该结果来自较早、未发布的模型版本,属于研究结果。
11. 量化
将 Praxis-1 的路由 MoE 专家量化为 4-bit NVFP4 后,其性能依然保持稳定。
我们使用量化感知训练,对已发布的 checkpoint 额外微调了 5,000 步,将路由专家的矩阵乘法量化为 NVFP4:数值采用 E2M1 格式、每 16 个数值为一个分块,分块缩放系数采用 E4M3 格式,并使用一个 FP32 全局缩放系数。
我们从 RoboLab-120 中抽取 600 个 episode,对两个 checkpoint 进行直接比较:
NVFP4 模型成功 279/600,成功率为 46.5%;
同一个微调 checkpoint 在关闭量化、使用 bf16 运行时,成功 287/600,成功率为 47.8%。
两者结果接近。
我们还在真实双臂 YAM 工作站上重复了测试:从一个双臂 YAM checkpoint 出发,进行 5,000 步量化感知微调。在将 5 个物体抓取并放入袋中的任务上:
NVFP4 模型在 30 次 rollout 中成功 26 次,成功率为 87%;
作为微调起点的 bf16 checkpoint 在 30 次 rollout 中成功 28 次,成功率为 93%。
两者的抓取质量分别为 2.73 和 2.40,满分为 3;成功任务的平均耗时分别为 20.7 秒和 20.9 秒。在每种设置各进行 30 次 rollout 的条件下,这些差异均不具有统计显著性。
我们将在 Hugging Face 仓库中发布 NVFP4 checkpoint。将路由专家以 NVFP4 格式存储后,策略权重从 54.4 GB 缩减至 17.5 GB。
图 17:bf16 与 NVFP4 的比较——在 DROID 上微调的 Praxis-1(RoboLab-120)和在双臂 YAM 上微调的 Praxis-1(真实机器人)
左图:使用相同的 RoboLab-120 任务和 episode。右图:在真实双臂 YAM 工作站上,将 5 个物体抓取并放入袋中。柱状图表示成功率,悬停可查看 95% 区间。两组差异均不具有统计显著性。
12. Praxis-1 的局限性
外观相似的物体。 真实机器人最常见的失败是伸手去拿一个与目标相似的物体,而这一错误选择通常已经出现在模型想象的视频中。这与第 10.1 节的结果一致:大部分动作误差来自模型想象出的未来。
模糊指令。 当指令明确指出物体属性,例如颜色或大小时,策略表现更好;模糊指令则明显更难处理。当仅凭指令无法确定目标时,模型必须在场景中多个可能的物体之间作出猜测;如果场景中存在外观相似的物体,它可能会选错。
长任务。 当多步骤任务中的每一步都有各自的指令时,模型能够完成任务;但仅凭单条 prompt 串联多个步骤仍然困难。模型必须跟踪哪些步骤已经完成,并在没有额外指令的情况下继续执行下一步。将模型与能够把任务拆解为多个步骤的语言模型或 VLM 结合,是第 13 节提出的研究方向之一。
13. 未来方向
我们将在 Hugging Face 上以 Apache 2.0 许可证发布三个 checkpoint:在 DROID 上微调的 Praxis-1、在双臂 YAM 上微调的 Praxis-1,以及中期训练基础模型。
我们还将在 GitHub 仓库中提供模型代码、策略服务器、相同设置下的 MuJoCo 仿真环境,以及全参数微调和 LoRA 微调代码。更多细节请参阅我们的发布文章。
我们将持续投入WAM研究,尤其关注长期推理、Agent 规划和自我改进闭环。
来源:human five