跨本体、实时、基建……
——换了赛道
今年 GitHub 上星标排第二的 VLA 项目,不再单纯搭建“代码骨架”了。这应该是今年和去年最实在的差别之一。
2025 年的 VLA 开源项目可以按 benchmark 分数往下排,今年排不动了:一个模型值不值得跟,可能更多取决于能不能接进你自己的机械臂、微调一轮要多少卡、跑出来的数别人能不能复现?这些变化更容易在 GitHub 仓库里看出来:除了模型权重,越来越多项目开始提供数据适配、后训练脚本、实机部署接口,甚至将统一评测和人工参与的强化学习流程一起开放。
本文筛选出 2026 年 15 个值得关注的 VLA 开源项目,包括新模型、持续迭代的开源工具。
通用模型开始面对更复杂的机器人身体
VLA 过去主要依靠机械臂桌面操作数据建立能力,现在越来越多项目开始回答:
同一套模型能否覆盖不同机械臂、移动底盘乃至完整的人形机器人?
要做到这一点,增加模型参数还不够,训练数据、动作表示和目标机器人的适配方式都必须一起改变。
NVIDIA Isaac GR00T N1.7
⭐推荐理由:GR00T 是较早形成完整工程生态的通用人形机器人 VLA 系列,2026 年的 N1.7 则把重点放在跨本体动作表示、训练数据和部署链路上。
发布时间:2026年7月
发文团队:英伟达
Star: 约 8.3k(系列累计)
开放内容: N1.7 代码、权重、微调及部署工具
新版使用基于 Qwen3-VL 的视觉语言骨干,结合连续动作生成模块,并引入约 2 万小时 EgoScale 人类视频。相较只靠某一种机械臂的示范训练,N1.7 希望让人类动作经验与多种机器人数据在更一致的动作空间里共享。
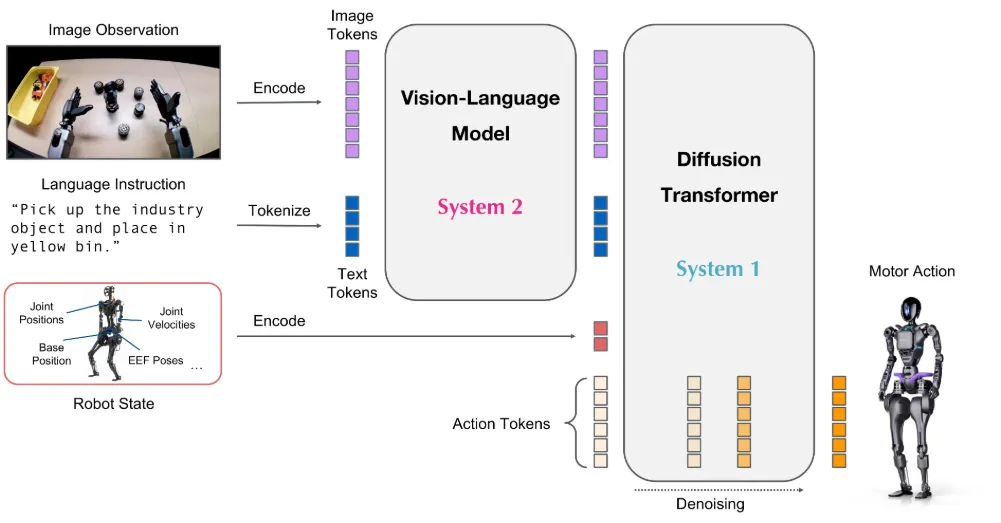
▲图| GR00T N1.7 将视觉语言主干与连续动作生成模块组合起来,同时公开适配数据、微调、测试和部署的开发路径。它所代表的开源价值,不只是“能执行动作的模型”,也包括把一个新机器人接入模型所需的工程工具。©【深蓝具身智能】编译
Ψ₀(Psi0)⭐推荐理由:不少 VLA 仍然主要面对固定机械臂,而 Ψ₀ 把目标扩展到需要移动、转身和双手协同的人形机器人操作。
- 发布时间:2026年3月
发文团队:PSI Lab
Star: 约 2.9k
开放内容: 训练代码、检查点、SIMPLE 仿真/评测与真机部署说明
模型从人类第一视角视频中学习任务语义,再用较少的真机遥操作数据适配机器人身体;高层视觉语言模块负责理解任务,动作专家生成全身动作片段,底层跟踪控制器保持行走与执行稳定。
项目提供了完整训练与微调说明,还接入 SIMPLE 仿真平台,并公开若干可直接用于测试的检查点。对移动操作研究来说,它的价值是把“会抓”与“能走过去再抓”放进同一个项目里,同时提醒开发者:全身操作即使依赖 VLA,仍离不开成熟的底层控制。

▲图| Ψ₀ 通过真实人形机器人展示转身、接近、抓取和持续操作等连续任务。图中高层策略负责动作意图与全身动作预测,底层控制负责稳定跟踪,能直观看出移动操作与桌面机械臂策略的差别。©【深蓝具身智能】编译
完整阅读:从 VLA 到人形全身控制,仅用1/10的数据量,实现40%性能反超
LingBot-VLA 2.0⭐推荐理由:今年不少 VLA 都在谈“跨本体”,LingBot-VLA 2.0 提供了一个比较具体的例子。
发布时间:2026年7月
发文团队:蚂蚁灵波
Star: 约 1.1k
开放内容:代码、预训练权重、RoboTwin 后训练示例
它将约 5 万小时机器人轨迹和 1 万小时第一人称人类视频纳入预训练,覆盖 20 种机器人构型;动作表示也不再局限于双臂关节,而是把灵巧手、腰部、头部和移动底盘等信号放进统一空间。
对通用策略而言,真正困难的地方往往不是识别出任务,而是让不同身体结构的机器人都能利用同一套训练经验。
它还在训练中引入深度和未来视频特征的蒸馏,让动作模型同时学习当前几何与短期动态。
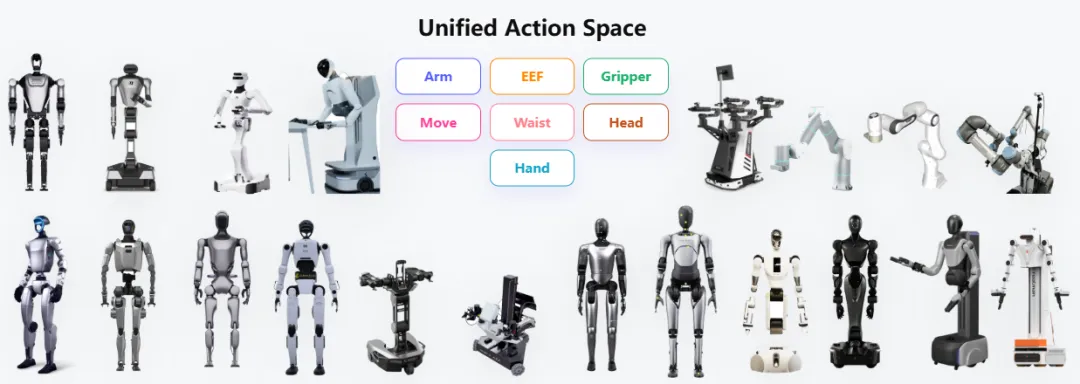
▲图1| LingBot-VLA 2.0 将单臂、双臂与包含移动底盘的机器人数据放在同一训练框架中,配合深度与未来动态监督学习动作。观察不同机器人执行同一类任务时,重点是共享的策略如何通过平台适配转换为实际控制,而非机械地比较某一次 Demo 是否成功。©【深蓝具身智能】编译
MolmoAct2
⭐推荐理由:如果希望从开源模型直接着手训练自己的机器人,Ai2 的 MolmoAct2 是今年值得认真研究的项目之一。
发布时间:2026年5月
发文团队:艾伦人工智能研究所
Star: 约 820
开放内容: 模型权重、训练代码、数据、LeRobot 集成与部署示例
它从具身推理视觉语言骨干出发,加入机器人状态建模和 flow matching 动作专家,使模型能够依据视觉、语言和当前状态生成连续动作。项目同时准备了基础检查点、面向不同平台微调的策略,以及对应数据。
更难得的是,它把前训练、后训练、推理服务和 LeRobot 工作流一起公开。开发者可以从 SO-100/101、Franka DROID 或双臂 YAM 的示例开始,而不必先自己搭好整套训练系统。

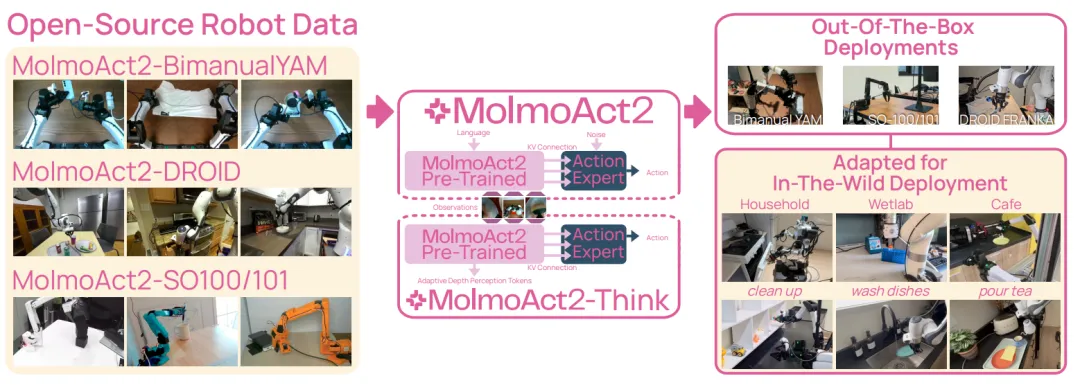
▲图| MolmoAct2 为 Franka、SO-100/101 和双臂 YAM 等平台提供模型与训练入口。除了展示策略在桌面任务中的表现,这类多平台实测还能帮助研究者比较不同相机视角、状态表示和控制接口对部署的影响。©【深蓝具身智能】编译
Qwen-VLA⭐推荐理由:它展示了一种值得关注的路线:不同具身任务或许可以复用更多共同的表示和训练流程。
发布时间:2026年5月
发文团队:千问
Star:约 780
通义千问团队尝试把机器人操作、导航和轨迹预测放进统一动作与轨迹表示中,并用文本条件区分机器人形态,减少针对每种平台单独设置动作输出头的需要。
不过,截至本文整理时,官方 GitHub 主要开放技术报告、实验表格与展示素材,暂时还未提供可直接运行的完整训练/推理代码及模型权重。
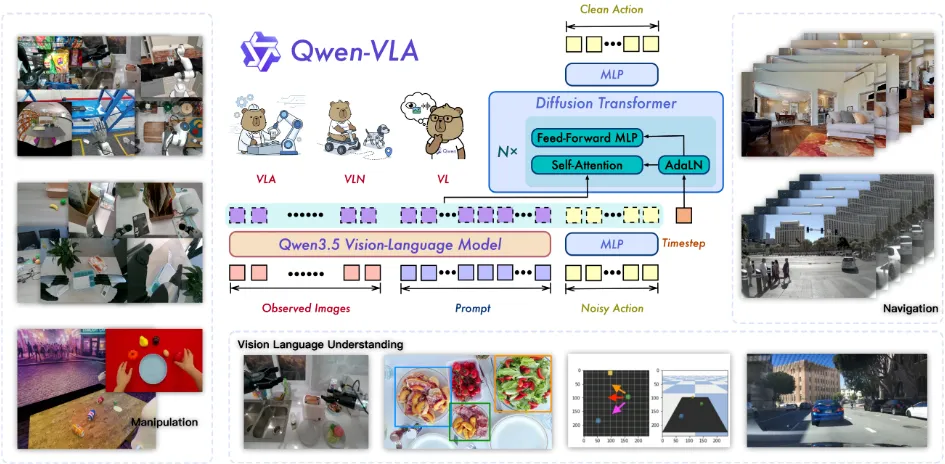
▲图| Qwen-VLA 在统一模型中展示机器人操作、导航与轨迹预测等任务。图中的任务差异说明它研究的是跨任务共享表示,但官方仓库目前主要提供研究介绍和可视化,还不是完整的代码与权重发布。©【深蓝具身智能】编译
Xiaomi-Robotics-1
⭐推荐理由:小米今年公开的 Xiaomi-Robotics-1,将“大规模数据如何转成实际机器人能力”摆在了前面。
- 发布时间:2026年7月
- 发文团队:小米机器人
Star: 约 700
开放内容: 模型权重、后训练、推理及评测代码;
项目使用超过 10 万小时的真实世界操作轨迹进行预训练,其中很大一部分来自不依赖固定机器人构型的 UMI 数据,再通过后训练把通用动作知识对齐到具体机器人和语言指令。与其说它在展示新的动作解码器,不如说它试图回答:没有足够多单一机器人真机数据时,能否先从不同来源的操作经验中学到可迁移的先验。
适合拿来研究“先做大规模预训练、再用少量目标任务数据适配”的路线。

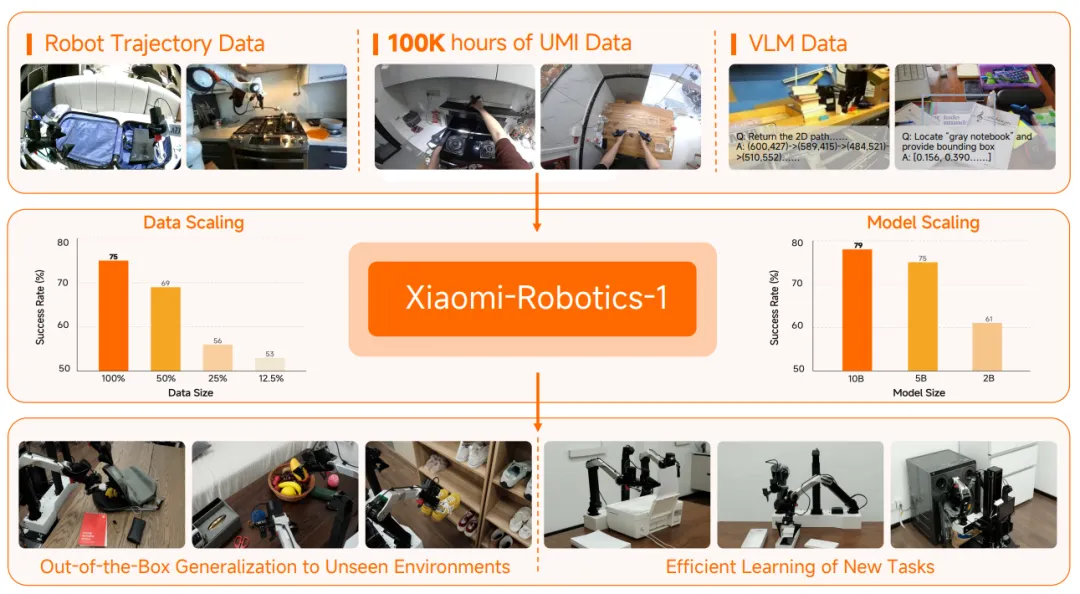
▲图| Xiaomi-Robotics-1 采用先大规模预训练、再针对机器人与指令对齐的两阶段流程。预训练的画面可以帮助模型充分的预习通用操作任务,随后再将这些知识跨环境地落到具体的相机、末端执行器和任务要求上。©【深蓝具身智能】编译
UnifoLM-VLA-0⭐推荐理由:宇树的 UnifoLM-VLA-0 把人形机器人操作推到了更具体的位置。
- 发布时间:2026年1月
发文团队:宇树科技
Star: 约 640
开放内容: 训练与推理代码、模型权重、仿真及真机示例
它在视觉语言模型基础上继续学习空间语义和机器人操作数据,强调从“看懂物体和指令”走向“具备完成操作所需的物理理解”。官方展示了单一策略完成 12 类复杂操作任务的真机实验,这比只给一组仿真分数更容易让读者理解模型面向的机器人形态。
对已经拥有宇树或类似平台的研发团队,这一套系统具有明确的参考价值,可以进行快速的部署测试。

▲图| UnifoLM-VLA-0 的真机画面覆盖多种操作任务,重点是让同一策略在不同物体与步骤之间切换。相比单一抓取 Demo,这类多任务展示更直接对应通用人形机器人策略所追求的能力。©【深蓝具身智能】编译
完整阅读:刚刚!宇树开源VLA大模型,UnifoLM-VLA-0单策略搞定人形机器人12类操作
InternVLA-A1.5
⭐推荐理由:VLA 是否一定要先生成一段未来视频,才能帮助机器人做动作?
- 发布时间:2026年7月
发文团队:上海人工智能实验室
Star: 约 570
开放内容: 代码、模型、训练/推理说明
InternVLA-A1.5 走的是一条折中路线:训练时借助视频模型提供未来动态监督,推理时则丢掉较重的视频分支,由动作专家直接输出连续动作。它希望保留“预先理解物体会怎么动”的好处,又尽量避免在真正控制机器人时承担完整视频生成的开销。
项目把视觉语言理解、潜在未来表征和动作输出放在一套结构里,配有仿真与真机操作验证。开源仓库适合对比“带预测监督”与“只学习动作”的训练方案。

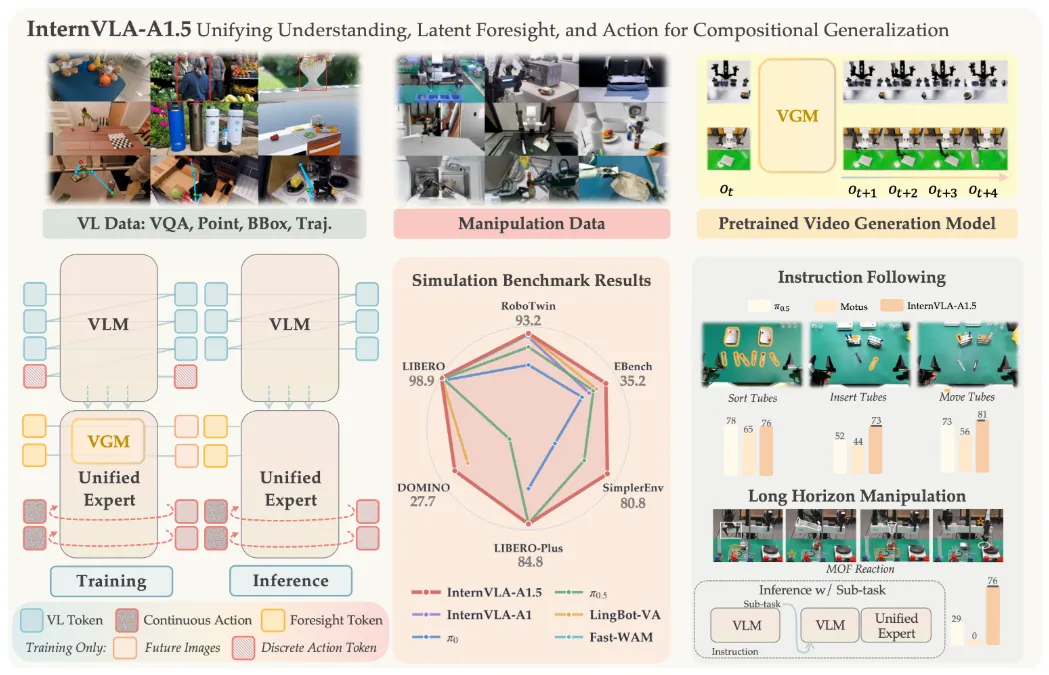
▲图| InternVLA-A1.5 在训练阶段利用未来动态的监督信号帮助动作模型学习场景变化,推理阶段则以较轻的连续动作分支执行。其独特的训练与部署策略,是它兼顾预测能力和控制效率的关键。©【深蓝具身智能】编译
Hy-Embodied-0.5-VLA
⭐推荐理由:腾讯 Robotics X 与混元团队的 Hy-Embodied-0.5-VLA 更像是把 VLA 当作一整套机器人学习系统来开放。
- 发布时间:2026年6月
发文团队:腾讯
Star: 约 300
开放内容: 代码、模型、2,000+ 小时 UMI 数据及训练工作流
除了模型结构,项目还覆盖 UMI 数据采集、预训练、监督微调、强化学习后训练以及真机执行接口。它的公开数据包含超过 2,000 小时的第一人称 UMI 操作记录,为没有大量自有示范数据的研究者提供了一种起点。
这一项目适合关注“训练流程怎么串起来”的团队:能以同一仓库观察数据、模型与执行之间如何配合。

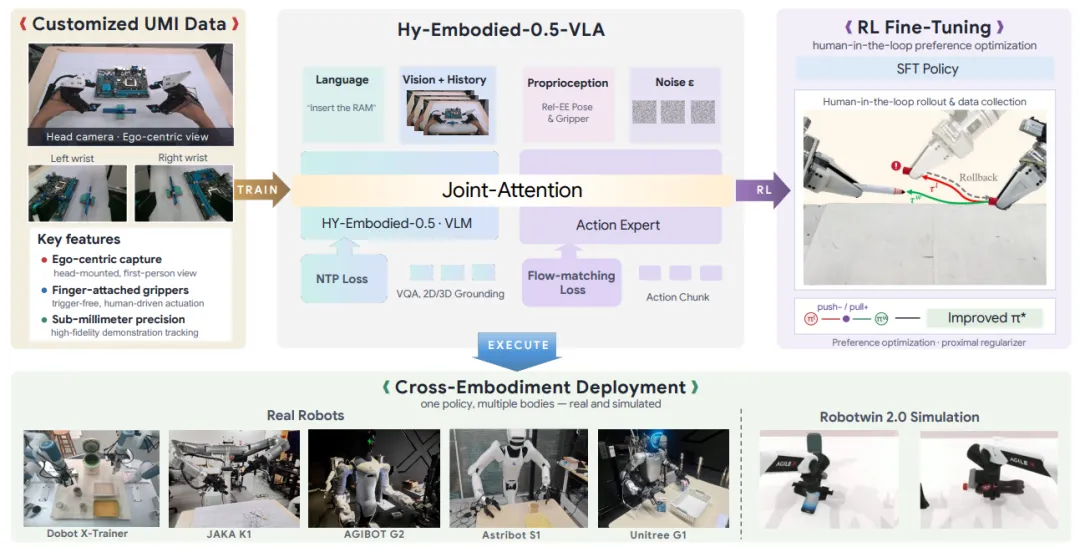
▲图| Hy-Embodied-0.5-VLA 从 UMI 操作数据出发,一直连接到模型训练、后训练和真实机器人执行。阅读这类项目的系统图时,除了观察 VLA 网络本身,也值得注意数据采集与部署接口如何影响开发成本。©【深蓝具身智能】编译
完整阅读腾讯HyVLA-0.5:一套完整的“从数据到部署”的机器人学习栈(全面开源)
让机器人反应得更快,也能完成更长的任务
通用模型擅长理解指令,但实际执行有两个很难绕开的问题:动作要跟得上物理世界,任务也不能只做一步就结束。
今年一些开源项目开始分别从实时推理、分层规划和世界模型入手,为这两个瓶颈提供可运行的方案。
OpenWAM⭐推荐理由:将视频世界模型、动作生成、训练方式和模块连接机制拆成可配置部件
- 发布时间:2026年9月
发文团队:新加坡国立大学
Star: 约 1.2k
开放内容: 模块化框架、预训练/微调权重、数据资源
今年“世界模型 + VLA”出现了很多不同组合,OpenWAM 试图把这种研究变成可系统比较的开源实验。它将视频世界模型、动作生成、训练方式和模块连接机制拆成可配置部件,同时公开 OpenWAM-α 预训练权重,让研究者可以比较不同的世界知识继承方式,而不是每换一种思路就重新搭建整套代码。
项目公开了超过 5 亿帧训练规模的模型、训练框架和整理后的机器人数据。对于希望验证“预测未来到底能否帮动作”的团队,它提供了比较扎实的实验起点。
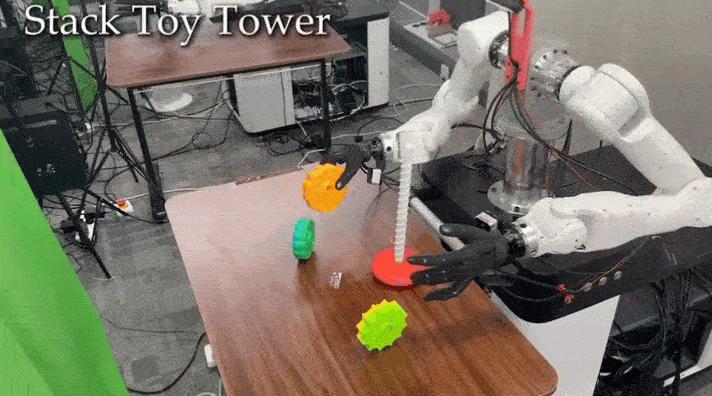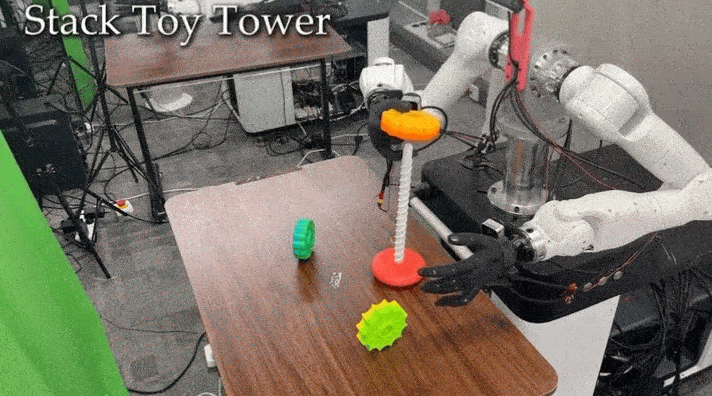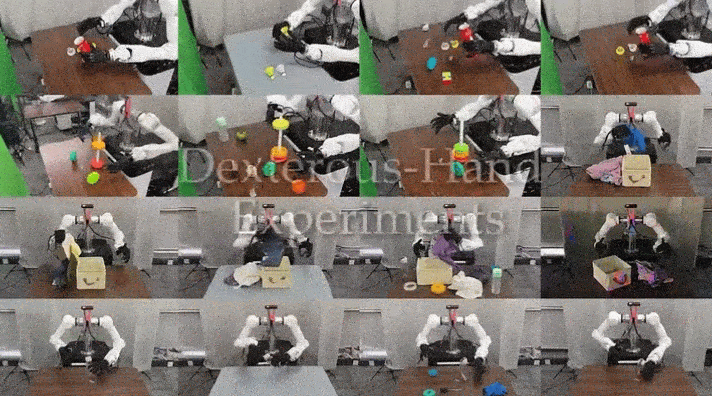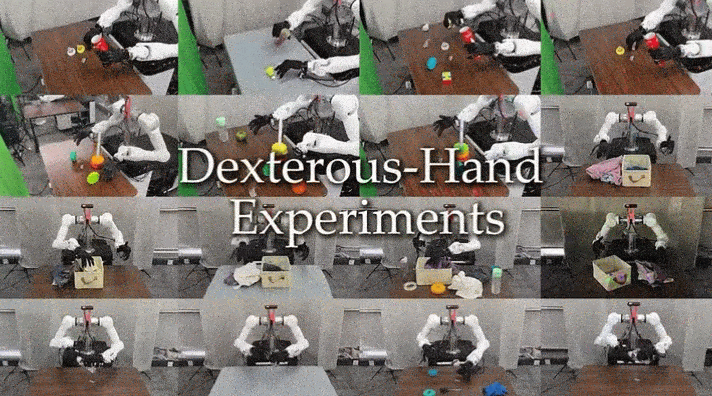
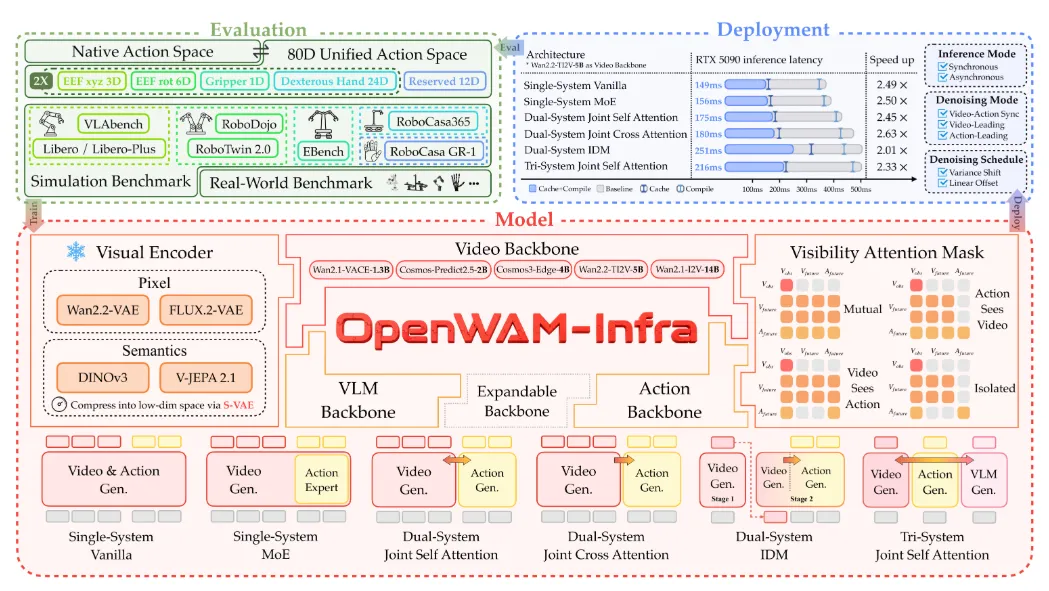
▲图| OpenWAM 把世界模型与动作模型之间的连接做成可更换的模块,并开放训练和评测框架。与直接观察某个新模型的成绩相比,开发者更可以利用这一框架检验不同耦合方式在相同数据与任务上的差别。©【深蓝具身智能】编译
TurboVLA
⭐推荐理由:4090 上跑到 32Hz,把"推理够不够快"单列成指标
- 发布时间:2026年7月
发文团队:华中科技大学
Star: 约 720
开放内容: 训练与评测代码、模型权重
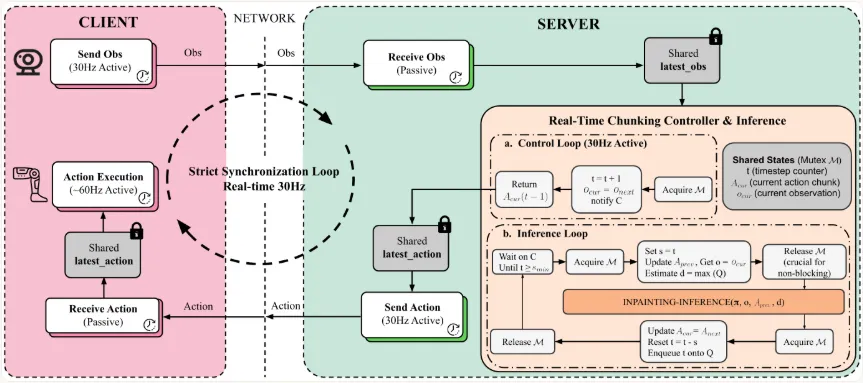
VLA 模型越来越强,控制频率却很容易被大模型的推理时间拖慢。TurboVLA 选择把网络做得更精简,强调在消费级 RTX 4090 上实现约 32 Hz 的模型推理,并将显存占用控制在较低水平。
这里吸引人的不是又出现一种动作预测结构,而是“模型能否按机器人需要的节奏持续输出动作”开始成为独立的工程目标。适合关注部署时延与算力预算的开发者。

▲图| TurboVLA 面向实时操作降低动作预测成本,展示的是模型在特定硬件上维持较高推理频率的能力。观察真机 Demo 时,应把网络推理速度与机器人最终执行、感知和通信组成的完整控制频率区分开。©【深蓝具身智能】编译
完整阅读:华科大×华为TurboVLA:不需要大语言模型,照样实现高性能 VLA!
τ₀-VLA
⭐推荐理由:规划层和执行层分开开放,失败能定位在哪一层
- 发布时间:2026年8月
发文团队:上海创新研究院
Star: 约 640
开放内容: 低层策略、高层提案、世界模型的权重和推理/微调代码
机器人能抓起一个物体,不等于能把整个厨房整理完。τ₀-VLA 面向这类长程任务,把高层任务管理与低层执行分开:高层根据视觉和历史记忆决定下一步子任务,必要时利用世界模型生成目标画面、比较不同计划;低层 VLA 则负责在目标明确后生成具体动作。
对研究长任务的团队而言,亮点不仅在于“有规划模块”,而是高低层模块已经提供了可以分开测试和替换的开放入口。

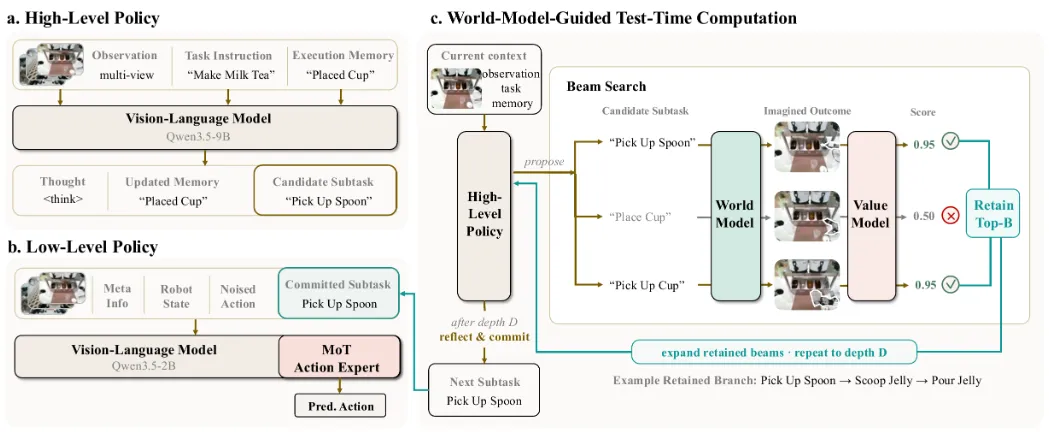
▲图| τ₀-VLA 将长任务拆成高层子目标选择与低层连续执行,并借助世界模型在必要时评估替代方案。它的开源代码允许分别检验规划错误和动作执行错误,更适合分析长程失败究竟发生在哪一层。©【深蓝具身智能】编译
跑通模型,到把训练和评测系统搭起来
模型数量增长之后,工程成本越来越显眼:数据来自不同格式,仿真和真机不在同一台机器上,某个 Benchmark 换版本后分数又难以对齐。训练和评测基础设施虽然不如新模型 Demo 抢眼,却决定了这些开源成果能否真正被社区持续使用。
StarVLA
⭐推荐理由:换骨干、换动作头、换数据,都不用重写训练框架
- 发布时间:2026年4月
发文团队:香港科技大学
Star: 约 3.9k
开放内容: 模块化训练代码、模型与数据适配、多个 Benchmark 接口
StarVLA 去年已经出现在我们的盘点中,今年仍值得保留,原因是它不再只是一个“搭建 VLA 的代码骨架”。项目在 2026 年持续扩展不同视觉语言骨干、训练配置与评测环境的集成,并补充了机器人和数据集接入教程、RoboDojo 等评测支持,以及新的计算平台适配。
它的定位很清楚:研究者希望换一种动作头、换一个骨干或者把实验迁到另一套数据上,不必每次都重写训练框架。StarVLA 更接近 VLA 开发者使用的“实验工作台”。
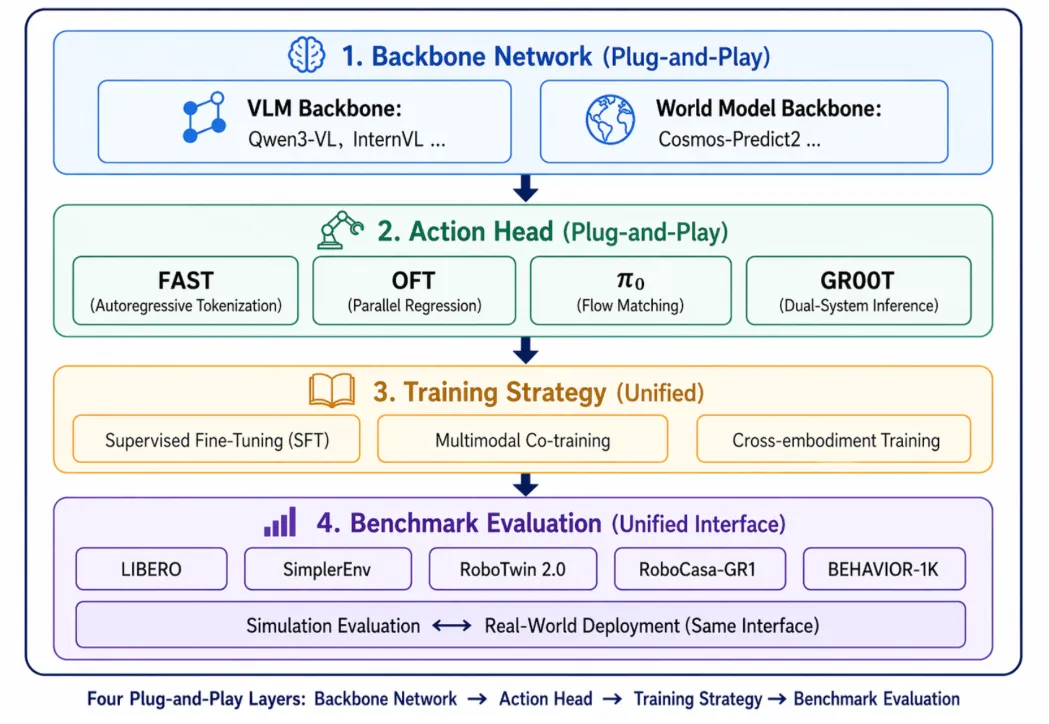
▲图| StarVLA 将模型、训练器、数据、配置与评测划分成可独立替换的模块。这样的工程设计使研究者能在同一环境里比较不同 VLA 架构,而不是因实验代码不兼容而反复维护多个分支。©【深蓝具身智能】编译
vla-evaluation-harness⭐推荐理由:模型和 Benchmark 拆成可插模块,隔离环境防依赖打架
- 发布时间:2026年3月
发文团队:MAUM.AI
Star:约 610
开放内容: 开源评测框架、模型适配器、Benchmark 容器、Python API
模型越来越多,比较它们反而变得越来越困难。不同 VLA 使用不同的观测格式、动作接口、仿真器版本和运行环境,同一 Benchmark 在不同代码库里也可能出现不一致的评测条件。Ai2 的 vla-evaluation-harness 试图把模型与 Benchmark 各自作为可接入模块,并使用隔离的运行环境减少依赖冲突。
仓库已集成多种主流机器人 Benchmark、模型服务端和批量并行评估流程,也可以通过 Python API 在训练中直接调用。它适合需要频繁做模型横向比较的研究团队。对年度开源生态而言,这类项目特别重要:当社区已经能训练大量 VLA,下一步必须回答的是怎么公平、稳定、低成本地测它们。
▲图| vla-evaluation-harness 将不同 VLA 模型和机器人仿真 Benchmark 通过适配层组合起来,减少因环境与接口不一致造成的评测障碍。模型与 Benchmark 的支持矩阵也能帮助开发者判断哪些分数已经复现,哪些仍属于待验证的集成。©【深蓝具身智能】编译
verl-vla
⭐推荐理由:仿真、训练卡、真机、人工,串成一条能跑的后训练链路
- 发布时间:2026年10月
发文团队:浙江大学
Star: 约 150
开放内容: 云边协同后训练框架、人工干预、SFT/RL 与部署示例
VLA 的强化学习训练不仅是多跑一个优化算法。模拟器、GPU 训练节点、真实机器人和人工操作者常常在不同机器上,数据与权重需要反复同步。verl-vla 在 verl 的基础上,为这类分布式场景提供统一的后训练系统,把演示收集、人工干预、监督微调、策略评估和强化学习放进同一工作流。
它把训练、模型 rollout 和环境交互按角色分配给不同计算资源,允许使用者逐步拼装训练流程。对真正做 VLA 后训练的人来说,该工作解决了搭建实验系统时最耗精力的基础设施问题。
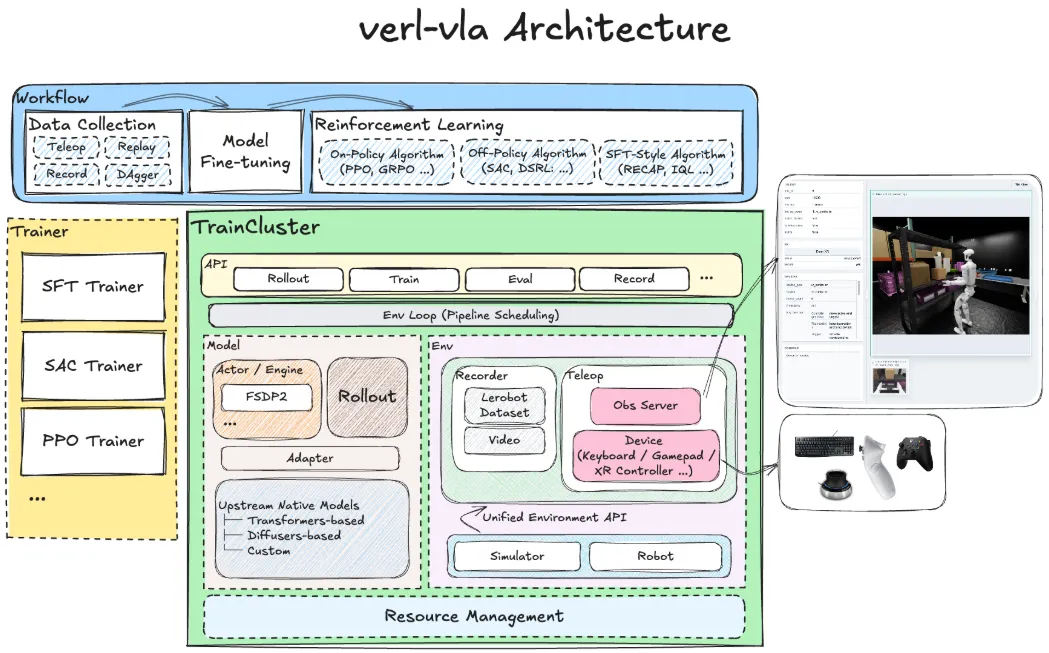
▲图| verl-vla 将训练节点、仿真环境、真实机器人和人工操作入口连接到同一后训练流程中。图中的关键不是某个新算法,而是让数据采集、策略更新、评估和再次执行形成能够复用的工程链路。©【深蓝具身智能】编译
2026 年的 VLA 开源,正在补齐什么?
看完这 15 个项目,一个明显的变化是,开发者现在能获得的已经不只是“可下载的 VLA 权重”。
通用模型陆续开放多本体适配方法,研究者可以尝试把第一人称视频和真机轨迹放在一起训练;模型结构也开始更认真地处理动作频率和长时序任务,避免机器人每走一步都等待重型模型重新规划。
同样值得关注的是围绕模型形成的工具。MolmoAct2、GR00T 这类模型项目越来越重视完整的后训练与部署链路;StarVLA、verl-vla 和统一评测框架则把开发者原本需要自行维护的重复工作做成公共设施。
这意味着 VLA 的开源正在逐步由“展示研究成果”转向“让别人能够继续开发”。
但开源程度仍然参差不齐。有的项目提供训练脚本、模型权重、示例数据和部署流程,有的只公布部分阶段代码,还有项目目前主要开放技术报告。即使是资产比较完整的仓库,机器人平台差异、数据采集质量、硬件成本和安全验证也不可能通过一次 git clone 消失。
对于任何开源项目,clone到本地之后的第一步还是要反复核验,确保代码运行在隔离的安全环境,随后再开始体验。
如果要概括 2026 年这批开源项目带来的共同价值,可能是 VLA 的开发门槛正在被分解:
从数据到训练,从推理到实机,从单项实验到跨平台评测,都开始有公开工具可用。
注:本文筛选标准以代码可获取性和项目活跃度为主,难免存在遗漏。“星标”,只是众多维度里的一个,本文引用它,仅作体量参照,不作优劣排序。未被提及的相关工作同样具有参考价值,欢迎评论区补充。
统计时间截至2026年11月11日。
编辑|阿豹
审编|具身君
Ref1. LingBot-VLA 2.0:
2. NVIDIA Isaac GR00T N1.7:
3. MolmoAct2:
4. Xiaomi-Robotics-1:
5. InternVLA-A1.5:
6. Hy-Embodied-0.5-VLA:
7. UnifoLM-VLA-0:
8. Ψ₀(Psi0):
9. Qwen-VLA:
10. TurboVLA:
11. τ₀-VLA:
12. OpenWAM:
13. StarVLA:
14. verl-vla:
15. vla-evaluation-harness:
来源:深蓝具身智能