为 “Coding Agent 控制机器人” 这一新兴范式,建立了第一个系统性的评测基准
——First Exam
依托LLM的编码智能体在软件代码任务中表现亮眼,可放到机器人场景,物理世界带来的种种硬性约束会层层叠加。
在真实物理规则约束之下,它究竟能不能可靠驾驭形态各异的多款机器人?
针对这一缺口,李曼玲、石冠亚(Guanya Shi)等牵头的联合团队,联合李飞飞等多位学者,推出 Embodied First Exam(EFE),也就是具身的第一场考试。
这是一套面向编码智能体、以智能体为原生设计的统一综合评测框架。它希望回答三个关键问题:
通用编码智能体究竟可以解决哪些类型的机器人任务;
物理世界的各类约束会在多大程度上左右最终表现;
任务执行过程中,失败究竟发生在哪一个环节。
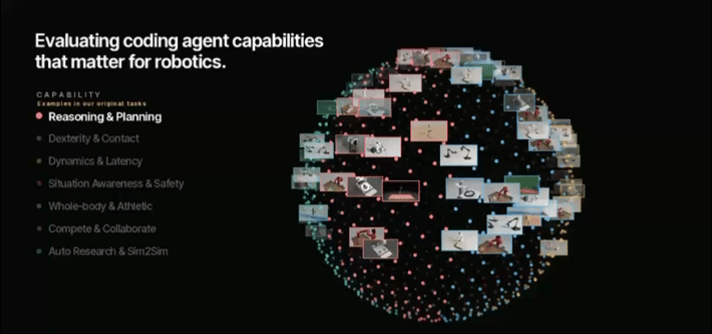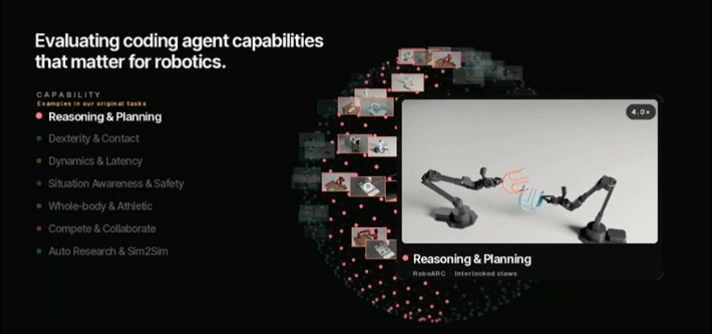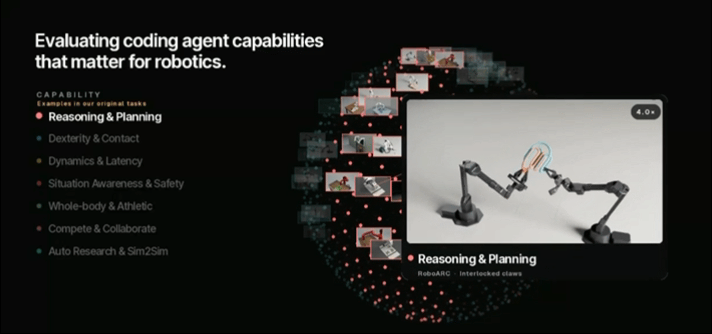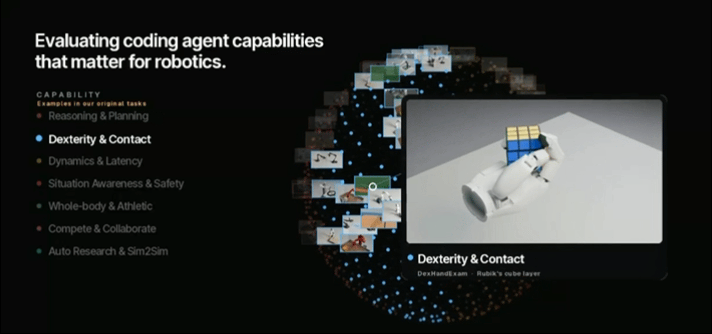
整套评测囊括1156个任务、35个任务套件、47种机器人本体,覆盖单臂、双臂、灵巧手、人形机器人、移动操作平台、四足机器人、空中机器人、肌肉骨骼机器人等九大类形态。
和常见VLA评测基准不一样,EFE并不限定智能体的控制方式,编码智能体可以自主选择实现路径:直接输出动作指令、编写控制器程序,或是在仿真环境中训练策略来完成任务。
在456道筛选后的核心任务上,参与测评的八个智能体中表现最强的GPT‑6 Astra(搭载Codex工具链),在贴近真机条件的标准设定下成功率仅有 33.6%;而同一批任务,一旦向智能体开放完整仿真器状态、允许无限次试错重置的特权设定,成功率直接攀升至 77.5%。
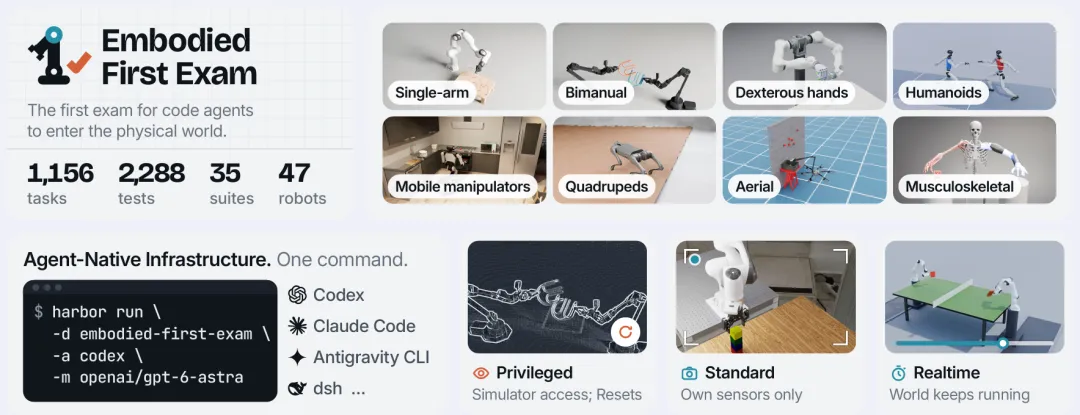
▲图 | Embodied First Exam 概览:面向编程智能体的综合机器人任务评测框架,覆盖 1156 个任务、35 个套件与 47 种机器人;一条命令即可运行任意编程智能体 ©【深蓝具身智能】编译
那道 77% 与 34% 之间的落差
三种设定,差的是三件很具体的事
这套考卷给每个任务最多三种设定:
智能体只能通过机器人的传感器看世界,默认不能重置环境,仿真在它思考时暂停。
实时设定在此基础上让世界继续走;特权设定则是另一个极端:完整仿真状态、无限次重置,随便试错。
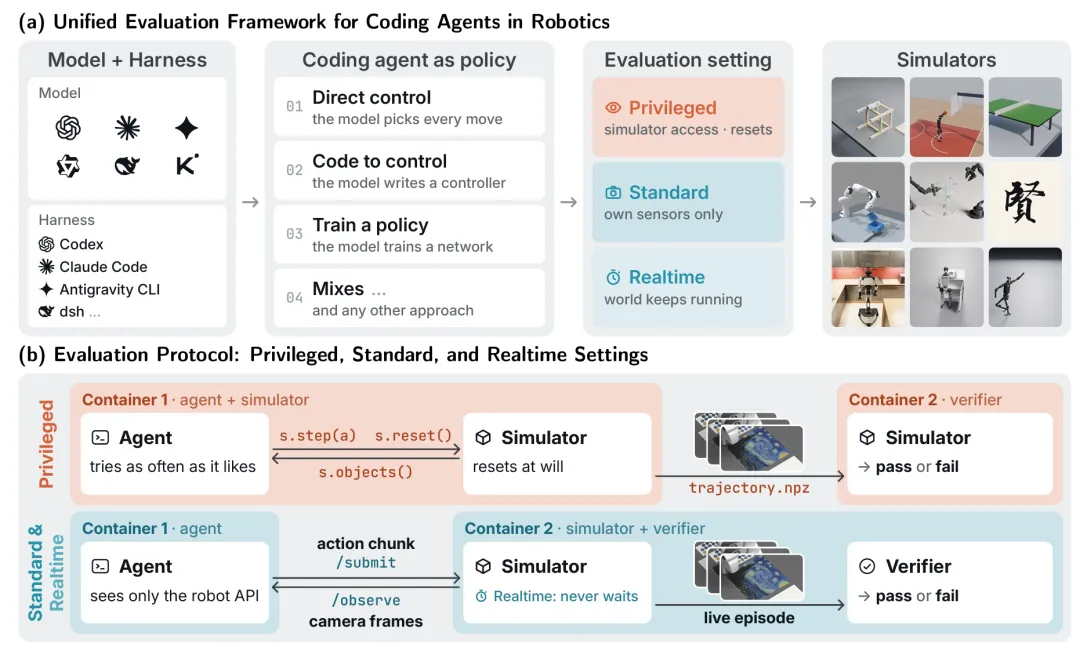
▲图 | EFE 框架与评测协议。(a) 面向机器人领域编程智能体的统一评测框架 (b) 特权模式、标准模式与实时模式的评测协议 ©【深蓝具身智能】编译
同一道题在不同设定下共用初始场景和成功规则,所以结果可比。
这比单纯对比模型刷出的分数有用得多,因为它把能力拆成了可以单独分析的几个条件。
差距的大头不是知道物体在哪
直觉上,标准设定吃亏在看不见物体的精确位姿。研究者做了控制实验:在标准接口上分别增加查询每个物体的精确状态、无限重置加存档读档两项能力。
391 道同时适配两种设定的核心任务上,基线 28%,增加状态查询能力后提升至 45%,开启重置能力后达到 53%,两项能力全部开启达到 68%,特权设定下结果为 77%。
重置带来的性能提升,要大于获取物体精确状态带来的提升。进一步拆分可以看到,执行对精度要求很高的步骤时,仅获取物体状态几乎没有收益,指标仅从19%小幅涨到21%;只有搭配重置能力,性能才有明显上涨至36%。而执行要求相对宽松的步骤,获取物体状态就可以解决34%的失败案例,对照组仅14%。
这个结果也折射出现有不少仿真评测的局限。很多公开报告里的高成功率,测试环境往往允许模型反复重来,还可以直接读取仿真内部真值。但放到真实机器人部署,既拿不到物体精确位姿,也没有反复重开任务的机会。
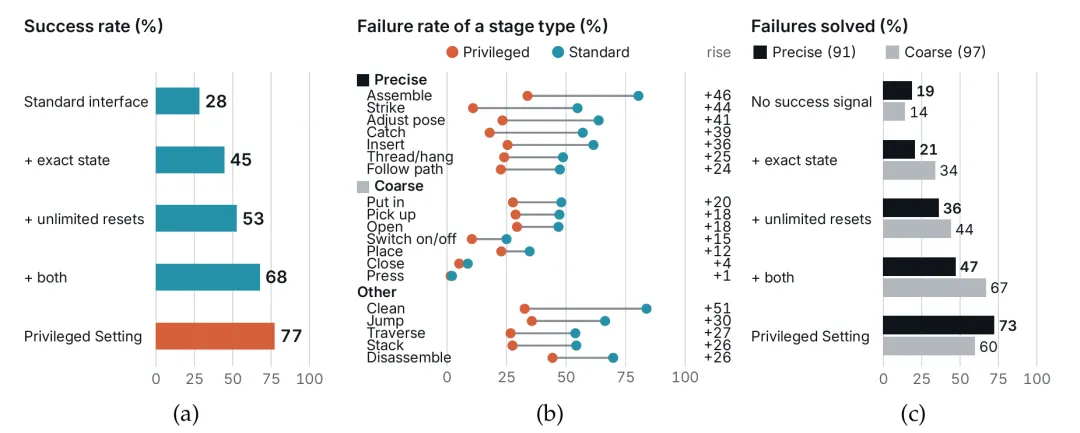
▲图 | (a) 逐步向标准接口加入特权设定功能后的成功率;(b) 各阶段类型失败率对比;(c) 精确与粗放阶段失败被各配置解决的比例 ©【深蓝具身智能】编译
失败为什么总卡在同一处
换一个模型,坑还是那个坑
如果失败单纯源于模型自身缺陷,不同模型发生失败的环节应当比较分散。
但统计数据给出相反结果,三个最强智能体在同一测试上的失败,56% 落在同一个执行阶段,随机基线为 31%;全部八个智能体统计,该比例为 61%,随机基线 37%。值得注意,同一个任务分别跑特权、标准两套设定,最容易出错的执行阶段重合度也达到57%,随机基线仅9%。
这说明任务本身的固有难度,才是失败的主要来源,而不是模型个体差异。
有一项接抛球测试可以直观体现:八个智能体在标准设定全部失败,其中七个都可以完成第一次接球,全部失败集中在第二次接球,问题出在杯子姿态、碰撞位置的微小偏差。
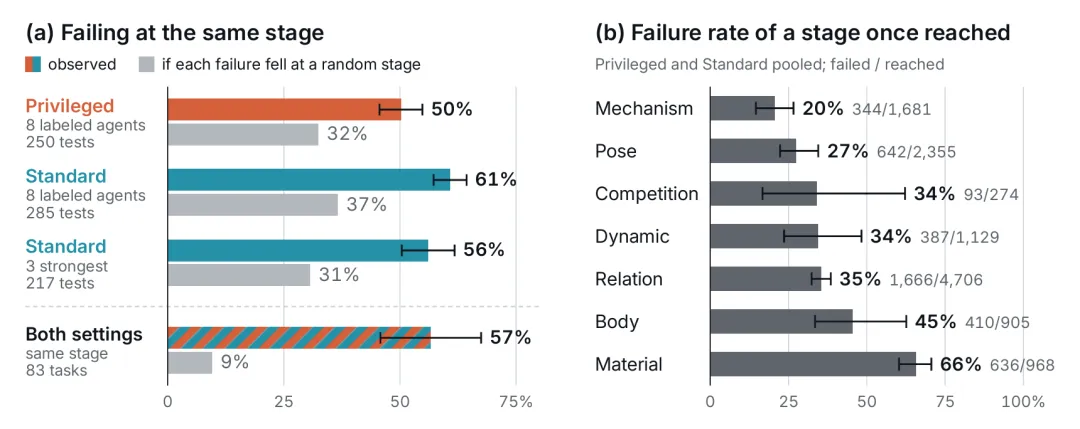
▲图 | (a) 失败阶段的集中度;(b) 一旦到达该阶段后的失败率,按阶段类别统计(两种设定合并) ©【深蓝具身智能】编译
处理材料、躯体运动,执行难度最高
统计进入该阶段之后的失败概率,涉及材料交互,比如擦拭、倾倒、涂抹这类操作失败率最高,达到66%;躯体运动类任务,行走、蹲起、翻身,失败率45%;关系变换35%,动态交互34%;开关、卡扣这类机构操作难度最低,失败率20%。
但是,不同任务类别分布在不同测试套件、不同机器人本体上,该数据仅反映各类操作更容易出错,不代表任务本身存在不可逾越的硬门槛。
能力偏弱的智能体,很多还没接触目标就出错
强弱模型之间存在一处清晰分界线。
五个能力偏弱的智能体,接触任务阶段的失败案例中,9.1%‑18.5%属于还没有接触目标就已经执行出错;而三个能力较强智能体,该区间仅 2.7%‑3.7%。针对包含多阶段的任务,弱模型有44%‑64%的尝试无法推进到第二个阶段;强模型该区间为27%‑36%。
类比人类操作,新手往往距离目标尚有一段距离就发生偏移,熟练操作者至少可以完成接触,问题更多出现在后续精细调整环节。
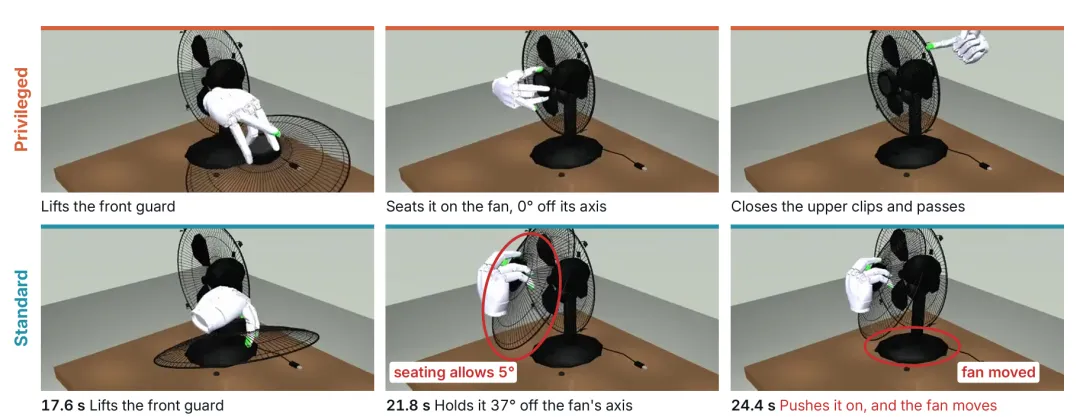
▲图 | Claude Opus 5.5 在特权与标准设定下安装风扇前罩:标准尝试中它把前罩偏轴 36‑39 度夹持,而就位容差只有 5 度,继续推则整台风扇被推动 ©【深蓝具身智能】编译
它会自己选择怎么控制机器人
控制方式会随环境约束发生明显变化
这套评测没有强制规定智能体的控制手段。
智能体可以逐段下发动作、编写闭环控制程序,也可以利用仿真环境训练策略。
基于1489次采样尝试的标注结果:标准设定下,61%的行为是直接输出动作块,读取传感器观测再继续下发后续动作;特权设定,82%的行为切换为编写程序求解运动;实时设定条件下,97%依靠程序完成控制,其中82%的程序内部自带控制循环。
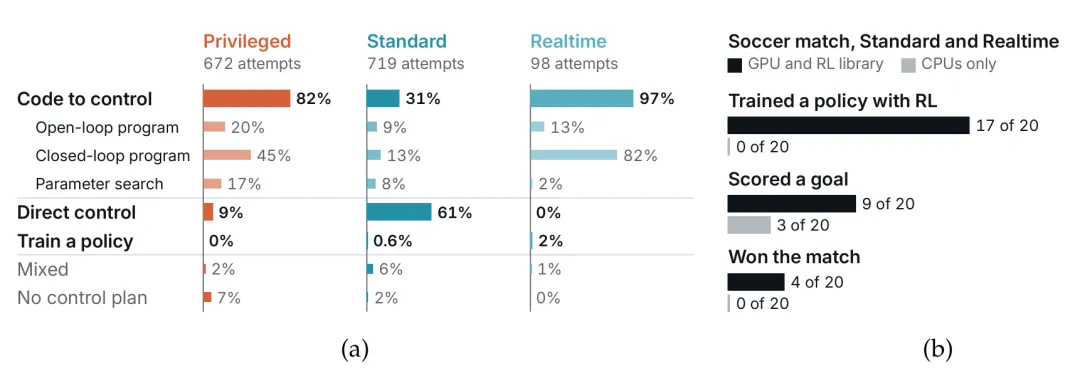
▲图 | (a) 1489 次抽样尝试中,不同模式下各类控制方式占比;混合代表中途切换或者同时使用多种方式 (b) 足球任务中标准、实时模式下训练策略、得分、获胜的尝试统计 ©【深蓝具身智能】编译
背后逻辑不难理解。
仿真可以暂停的时候,一步一步试错成本最低;当物理世界持续向前运行,模型思考存在耗时,就必须把执行交给自主运行的代码循环。
足球任务对照:训练策略才可以完成闭环
人形机器人足球任务给出很有参考价值的一组对照。任务需要人形机器人完成行走、踢球,分为两组测试条件。当开放GPU、强化学习库,允许副本训练,标准设定12次尝试中10次会训练策略,实时设定8次尝试7次训练策略;所有成功案例,全部来自训练得到的策略。
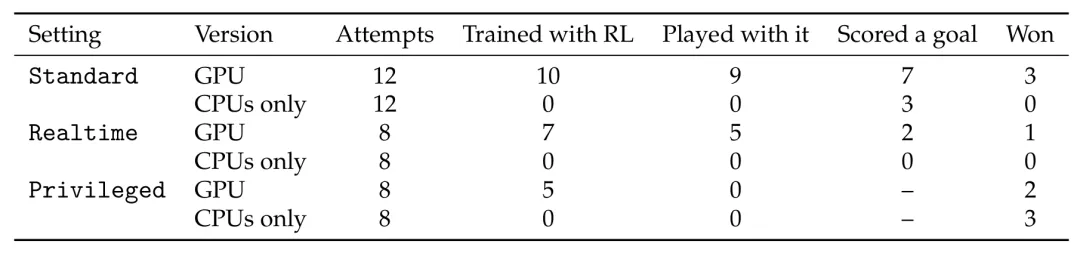
▲表 | 足球任务中,各设置下不同版本尝试数、强化学习训练策略、实际使用训练策略、得分、获胜的统计 ©【深蓝具身智能】编译
仅允许CPU资源,只能手写步态、调参搜索,标准设定12次、实时设定8次,没有一例取得胜利。特权设定下的少数成功,也是直接复用对手角色内置的行走网络实现。
拿GPT‑6 Astra的表现举例,开放GPU训练策略,10次尝试8次取胜,机器人累计行走690米,摔倒22次;仅CPU手写步态,13次尝试3次取胜,行走276米,摔倒59次。
这也体现编码智能体的能力边界。
它擅长把已知逻辑翻译成代码、设计实验循环;但面对高频闭环动态交互,单纯堆叠代码很难补齐性能缺口,需要主动训练策略。而训练策略恰恰是现阶段通用编码智能体并不擅长的工作。
它在行业里的真实刻度
和VLA评测榜单的本质区别
RoboCasa365、RoboDojo、BEHAVIOR‑1K 等套件也被纳入EFE,但评测逻辑完全不同。传统VLA榜单,评估固定策略在观测输入下的任务表现。
EFE评估的是,拿到机器人完整接口的通用智能体,能不能自主完成调试、选型、试错,最终实现控制。前者衡量模型策略本身的能力上限,后者更偏向评估智能体的工程解决能力。
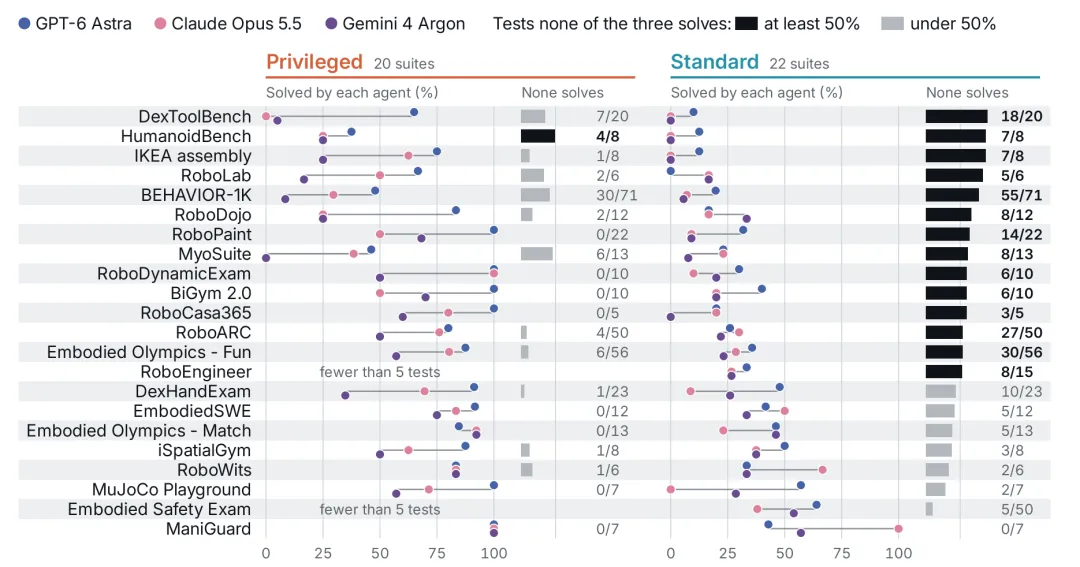
▲图 | 各套件的成功率统计;圆点代表最强三个智能体各自成功率,横条代表三者全都无法解决的测试占比 ©【深蓝具身智能】编译
定位差异也解释了整体分数偏低的现象。
三个最强智能体合计只能完成48%标准设定测试;22个标准套件里面,有14个套件超过一半测试,最强模型都无法完成。反观特权设定,20个套件仅有HumanoidBench存在大面积失败,10个套件平均成功率超过70%;标准设定没有套件可以达到这个水平。
分数之外的几个刻度
调用外壳harness会带来不小的性能浮动。
Astra运行在Codex外壳,成功率34%;切换到Claude Code外壳,降到22%,浮动达到12个百分点。同样模型、同样任务,外层调用环境就能拉开明显差距。
不同强模型的可解任务也不是完全包含关系。
Opus 5.5、Gemini 4 Argon合计可以完成64道Astra解不开的标准测试。反观五个弱模型解出的69道测试,其中65道都可以被强模型覆盖,弱模型几乎不存在独有的解题能力。
成本同样是不可忽略的因素。
整体上单次测试开销越高,模型的完成度越高。这也提示,这类评测任务,思考时长本身就是算力成本。
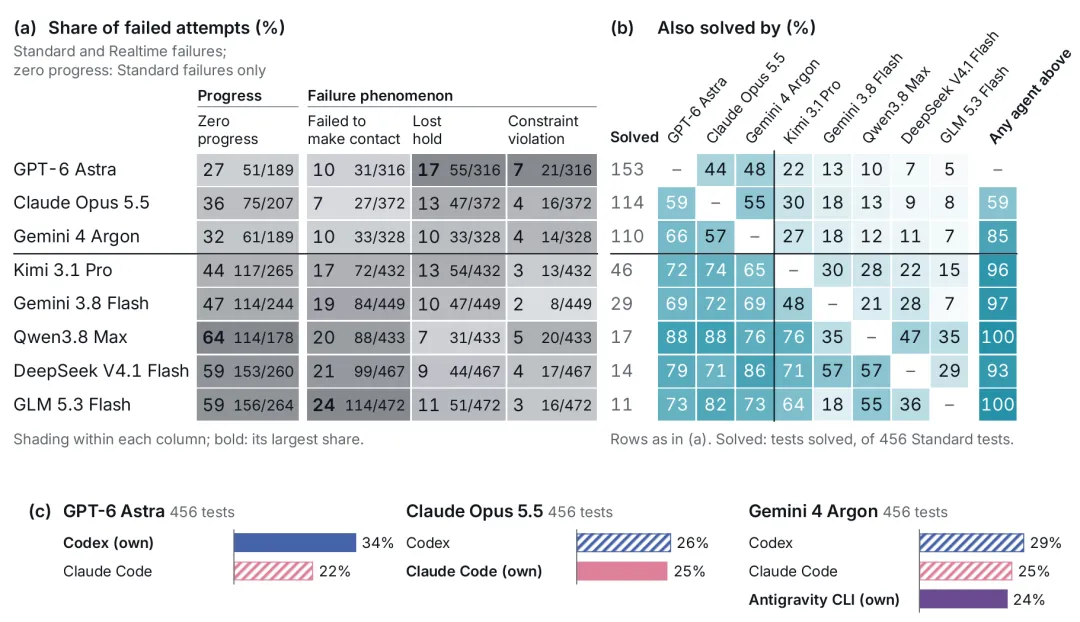
▲图 | (a) 各智能体失败画像,零进度指一次尝试没走到任何阶段;(b) 行智能体解出的测试中被列智能体也解出的比例;(c) 同一模型换 harness 的成功率变化 ©【深蓝具身智能】编译
这套考卷自己的“软肋”
有几处局限需要客观说明,否则34%这个数字容易被过度解读。
每个测试仅执行一次,研究本身也把该点列为未来改进方向。单次运行无法区分,究竟是模型稳定不具备该能力,还是本次运行偶然出错。强模型之间64道题的差异,有多大成分来自随机波动,目前无法量化。
执行阶段、控制方式的标签,同样依靠大模型自动标注。还有一处需要留意,做标注的GPT‑6.1 Sol,和被测的Astra属于同一系列模型,会带来潜在的标注偏向,论文正文也坦诚记录了该风险。
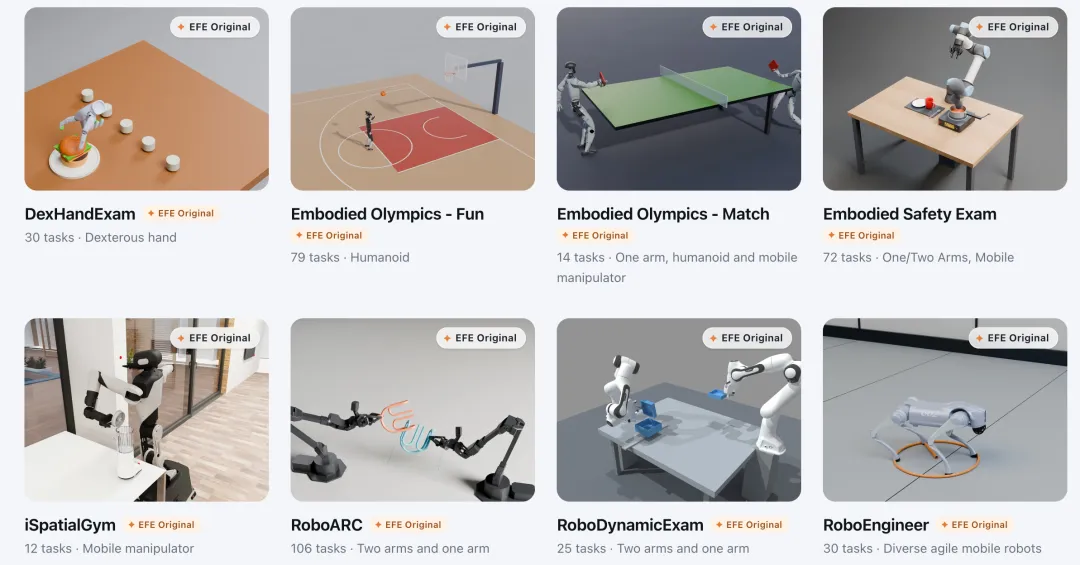
整套评测全部运行在仿真环境。
47款机器人本体全部为仿真模型,真机部分仅有一个简易游戏演示。仿真物理能否复现接触类任务的真实条件,这套基准本身无法给出验证。
评测得到的结果,是模型加上调用外壳harness的组合效果,不能完全等价模型本身能力。12个百分点的harness性能浮动已经证明,不能简单把测试分数全部归罪底层大模型。
First Exam
这份评测把具身智能的问题拆解得更具体。
核心问题不是模型能不能操控机器人,而是剥夺仿真真值、不允许任务重启、物理世界持续向前演化的条件下,智能体还能不能找出可行方案。
77%和34%之间的性能鸿沟,恰恰对应现实机器人落地最棘手的现实。很多仿真环境的漂亮指标,建立在现实世界并不具备的试错特权之上。
足球任务的对照,也暴露出编码智能体路线的现实边界。写代码可以处理计算逻辑,但很难凭空完成动态交互策略的迭代。只有智能体可以自主判断什么时候需要训练策略,而不是一味增加代码逻辑,整套方案的性能才会迎来实质提升。
编辑|小小怪博士
审编|具身君
参考论文:
论文标题:Embodied First Exam
论文链接:https://arxiv.org/pdf/2611.12177
来源:深蓝具身智能