让机械臂把网球稳稳放到易拉罐上,既要识别物体,也要判断网球是否对准罐顶,以及何时松开夹爪。这些看似简单的操作,往往依赖细微的视觉信息。问题在于,动作模型能否充分利用这些信息?
近日,来自南洋理工大学 S-Lab、商汤研究院与 Ropedia 的研究团队提出 NEO-VLA,将原生视觉语言模型引入机器人动作学习。图像经过轻量卷积层转换后,与语言指令共同进入主干网络;负责生成动作的模块则直接读取主干不同深度的表征。整个视觉通路无需独立的预训练视觉编码器。
围绕这一设计,团队依次考察了四个问题:原生主干是否更适合动作学习?动作专家最依赖哪些层的信息?保留多模态理解能力对动作训练有何影响?模型在常规任务和场景变化下表现如何?研究者通过一系列对照实验,并结合仿真与真机测试,给出了回答。论文现已在 arXiv 公开。
论文题目:From Pixels to Actions - Towards Native Vision-Language-Action Policies
Paper:
WebPage:
Github:
Model:
DataSet:
操作所需的视觉细节如何进入动作模型
目前,多数视觉语言动作(VLA)模型采用相似的处理流程:先由 CLIP、SigLIP、DINOv2 等预训练视觉编码器提取图像特征,再将这些特征交给语言主干和动作模块。动作决策通常从编码器的输出开始。
但抓取、对齐、插入等操作,需要利用物体边缘、局部几何、深度,以及夹爪与物体之间细微的状态变化。在视觉信息逐层抽象的过程中,部分与精细操作有关的线索可能变得不易利用。
已有研究发现,视觉模块对 VLA 的性能有显著影响,也对模型剪枝较为敏感;动作微调还可能损伤预训练的视觉表征。这些现象提示,视觉与动作之间的接口本身值得重新审视。
NEO-VLA 由此提出一个问题:如果动作模块能够直接访问视觉计算过程中形成的不同层次的表征,能否更好地利用其中与操作有关的信息?
让动作模块直接读取不同深度的视觉语言表征
从视觉处理方式与动作输出形式看,可以将相关设计分为三类。下图展示了它们的区别。
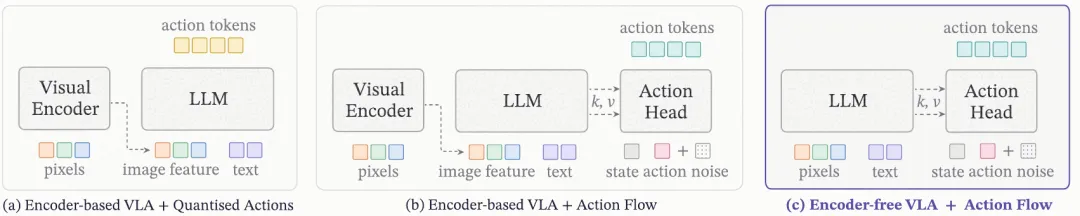
图 1 三类 VLA 设计的视觉接口与动作输出方式
区别在于,编码器式 VLA 即使读取语言主干的不同层,所用视觉信息也已经过独立编码器的处理。在 NEO-VLA 中,视觉与语言从主干的第一层起共同建模,因此,动作模块可以接触到视觉表征逐层形成的过程。「读取哪一层」也由此成为一个可以单独研究的设计问题。
NEO-VLA 如何从观测生成动作
NEO-VLA 以 NEO-2B 为基础。该原生多模态主干包含 40 层,参数量约为 20 亿,视觉通路中没有独立的视觉 Transformer、自编码器或离散视觉码本。主干之外,模型接入一个网络宽度较小、从随机初始化开始训练的动作专家。
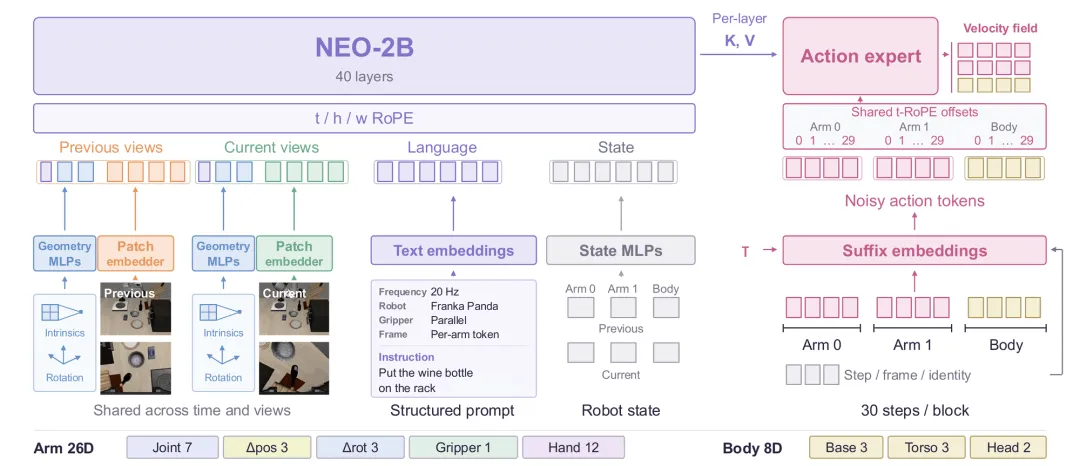
图 2 NEO-VLA 的多模态输入、主干网络与动作专家
将多视角图像与指令及机器人状态组织为统一输入
模型同时接收前一时刻与当前时刻的观测,每个时刻最多包含三个相机视角。每个视角的输入由相机标识、相机内参与旋转信息,以及图像分块后的视觉词元组成。所有视角和时刻共用同一个图像嵌入层;图像保留原始宽高比,每个视角最多使用 88 个视觉 Token。
视觉输入之后是一段结构化提示词,用于说明控制频率、机器人类型、夹爪配置、动作参考坐标系和任务指令。模型另用 6 个状态词元表示两只手臂与身体在前一时刻和当前时刻的状态。对于机器人不具备的部件,相应输入会被屏蔽,使同一套接口能够适配单臂、双臂及带移动底盘等不同配置。
通过层映射配置动作专家的读取位置
动作专家的每一层对应主干中的一个指定层,并读取该层缓存的 KV 表示。论文比较了四种层映射方案:
first-28:读取第 0 至 27 层,同时将主干截断至前 28 层。
skip-28:保留 40 层主干,在其中近似均匀地选取 28 层。
来源:机器之心