“ 通用模型开始承担部分机器人任务,具身智能公司的优势在哪里?
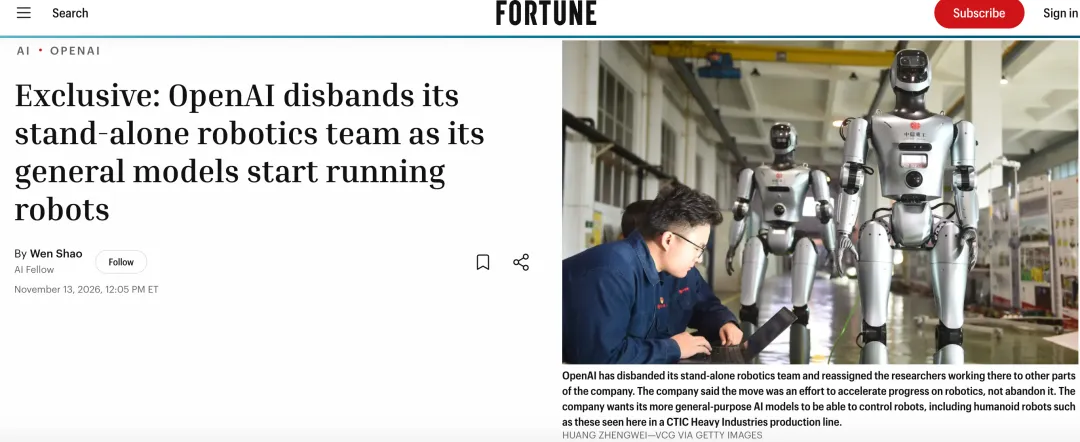
日前,《财富》报道OpenAI撤销了独立的机器人团队,OpenAI随后确认了这一消息。调整后,原机器人研究团队并入公司主研究团队,向首席研究官Mark Chen汇报;应用机器人和硬件团队划入Applied部门,由总裁Greg Brockman负责。
外界几天前就看到了迹象。奥斯汀的CoRL会议上,会议App和展馆平面图都标着OpenAI的208号展位,但记者到场时,那里既没有机器人,也看不到OpenAI的标志。至于现场是否一直无人值守,各家报道说法不一;能确认的只有一点:原定的机器人展示没有出现。
OpenAI向《财富》表示,通用前沿模型已经展现出直接用于部分机器人任务的能力,外界普遍将这一判断与9月发布的GPT-6 Astra联系起来。英伟达10月公布的Astranomy研究给出了相关数据。这项测试使用RoboLab-120基准,共120项抓取和放置任务。榜单上最强的专用模型Lakeside成功率是51.0%。GPT-6 Astra直接生成动作,成功率是66.3%;接入保留完整会话历史的编码智能体Codex之后,升到74.8%。
GPT-6 Astra于9月发布时,主要面向编码、操作电脑和科研等任务。从现有公开材料看,机器人控制并不是当时的展示重点。
两种方案用的工具、上下文和推理预算都不一样。23.8个百分点只是同一榜单上不同方案的成绩差,不能归因于模型架构本身。这组数字也只来自仿真环境,而且模型思考时,仿真环境是暂停的。它离“通用模型接管机器人”还很远,但OpenAI已经把这类变化写进了组织架构图。
一个更合理的解释是,OpenAI并没有放弃机器人,而是不再认为机器人需要一套独立于主模型的智能。当通用模型逐渐开始承担机器人任务,行业竞争的重点也可能发生变化。影响产品落地和商业化进程的关键,可能不再只是模型本身有多聪明,还包括设备是否已经进入真实场景,以及能否持续积累现场数据。
01.
OpenAI为什么现在调整?
第一个原因,技术前提变了。
今年年初,OpenAI内部的主流思路还是从Sora这类视频生成模型入手。模型要生成足够逼真的画面,就需要在训练过程中形成对物体运动、空间关系和物理规律的隐含理解。负责人Aditya Ramesh是DALL·E的作者,也是Sora团队的核心组建者。他领导的世界模拟研究,在一年内逐渐演变成了OpenAI Robotics。
5月31日,Sam Altman公开发帖招机器人相关人员,目标仍是2027年第一次公开演示。
但9月以后,外部团队展示了GPT-6 Astra直接完成机器人任务的能力。开头那组数据说明,目前证据还不足以证明通用模型已经全面超过专用模型,但至少表明,通用模型在不经过机器人专项训练的情况下,也能够在部分任务上达到甚至超过专用方案。
第二个原因,和历史有关。
这是OpenAI第二次调整机器人团队。2019年,它展示了机械手解魔方研究;2020年前后,团队和相关研究收缩。联合创始人Wojciech Zaremba后来解释,机器人缺少适合预训练的大量数据,把资源投入其他路线效率更高。此后,OpenAI把更多精力转向大语言模型。2022年底,ChatGPT发布。
2024年,OpenAI重建机器人团队,并与Figure合作。2025年2月,Figure结束合作、转向自研。据Business Insider报道,OpenAI旧金山机器人实验室最多时约有100名数据采集员,为训练积累真实操作数据。
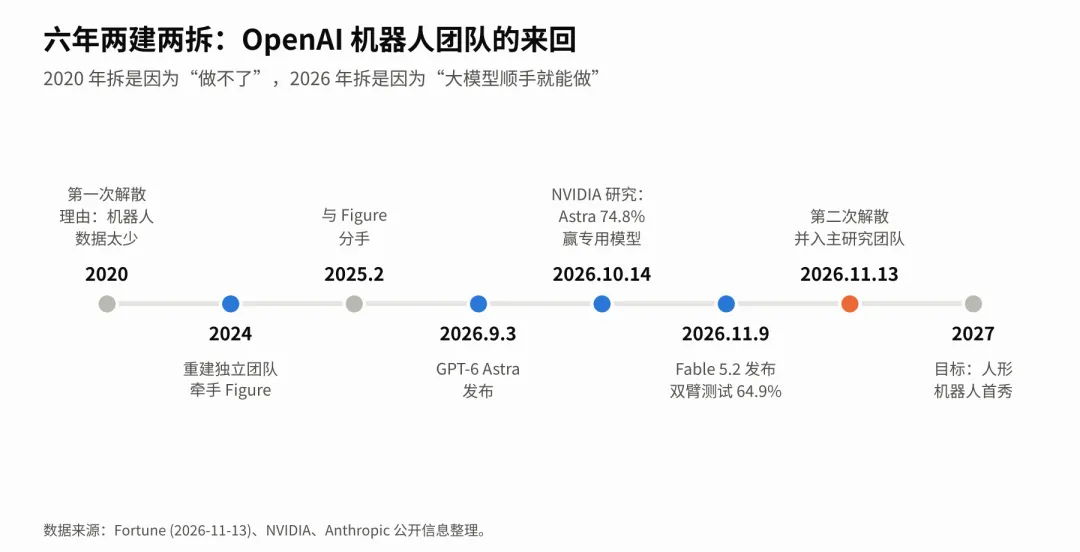
两次调整的原因正好相反:第一次,机器人数据太少,模型学不起来;这一次,通用模型从别处学到的能力,已经能直接用于部分机器人任务。至于OpenAI手中这些数据以后如何使用,目前没有公开说明。
第三个原因,是成本背景。
据报道,OpenAI最近一个季度经营亏损达到109亿美元。此前,Altman要求公司放弃部分偏离核心目标的“支线任务”,包括Sora在内的一些项目被调整,算力被集中到更核心的业务上。公司正在推进新一轮融资,IPO最早可能在2027年初。
把研究员集中到主模型研发,财务上确实更容易解释。
OpenAI的公开说法仍然是:机器人仍是长期愿景的核心,调整是为了加快通用机器人落地。OpenAI员工Scott Cory表示,项目路线图和目标没有改变;工程师David Schnurr则在X上称,还有十几个机器人相关岗位在招聘。硬件项目接下来如何安排,目前仍没有更多公开信息。
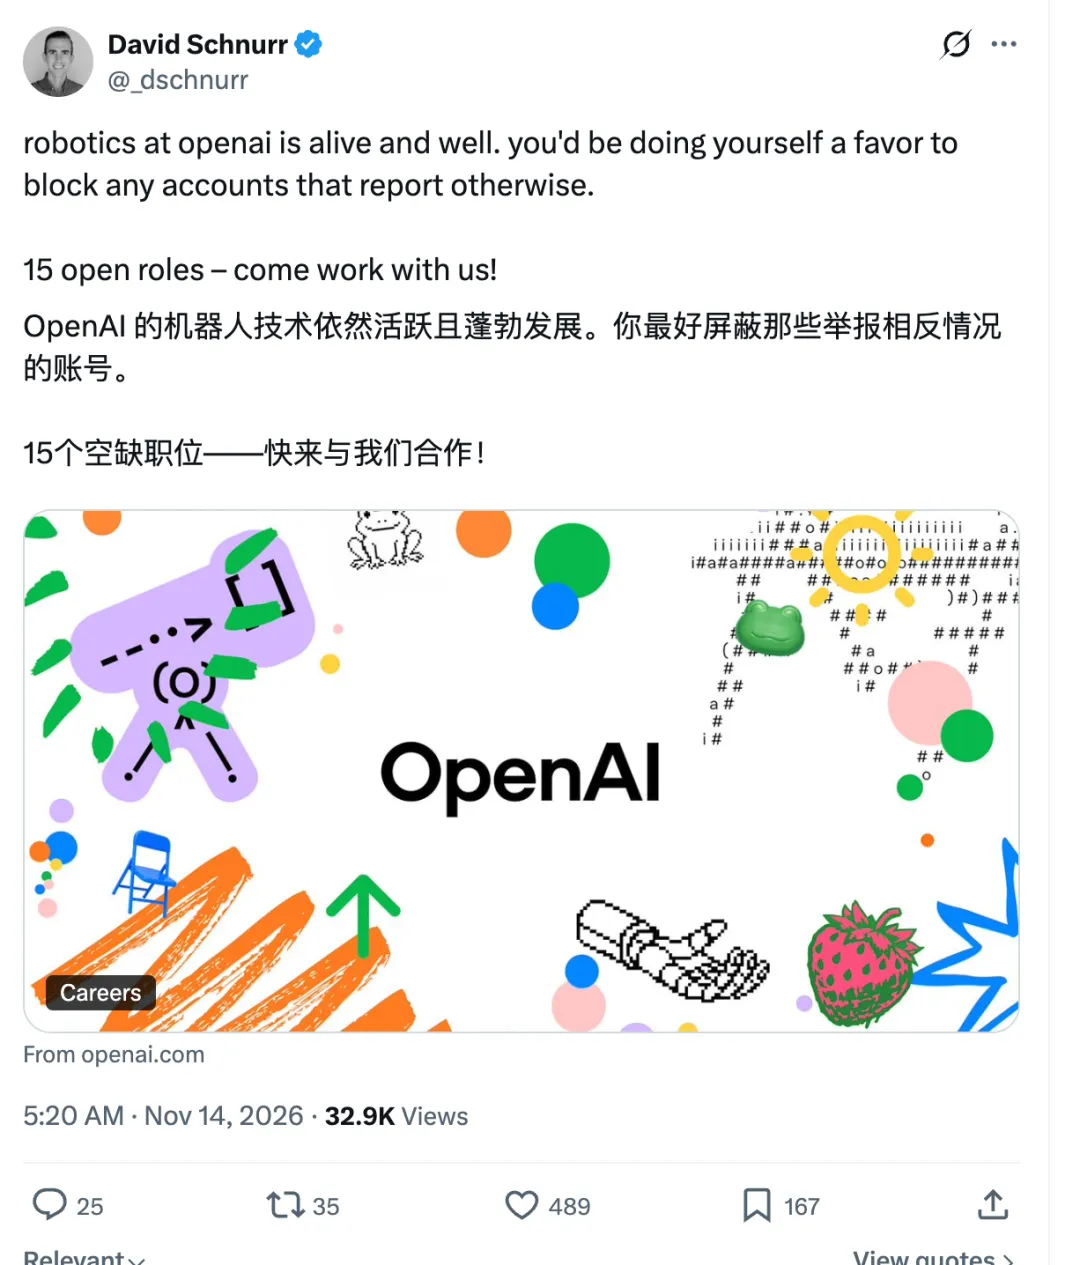
三个原因指向同一件事:机器人从一个需要单独养着的方向,变成了主模型能力的一个出口。
02.
通用模型进入机器人的四个层次
最近几家公开的实验看上去各做各的,其实可以按通用模型参与机器人的方式和深浅,分成四个层次。
第一层:在幕后帮忙训练专用模型。 据谷歌介绍,通用模型Gemini 4 Argon参与了机器人模型Gemini Robotics 2.5的研发。它根据真实摄像头画面辅助构建数字孪生,生成仿真练习,还结合失败视频分析原因。
这一层最不显眼。它可能最先规模化,因为它不要求通用模型在现场实时反应。
第二层:一个模型负责理解流程,动作交给专用模型。谷歌在奔驰工厂做过一次概念验证:Apptronik的Apollo 2人形机器人做零部件拣选配套,报告成功率96%。其中,具身推理模型负责跟踪工作流程,Gemini Robotics 2.5动作模型控制手臂和双手。
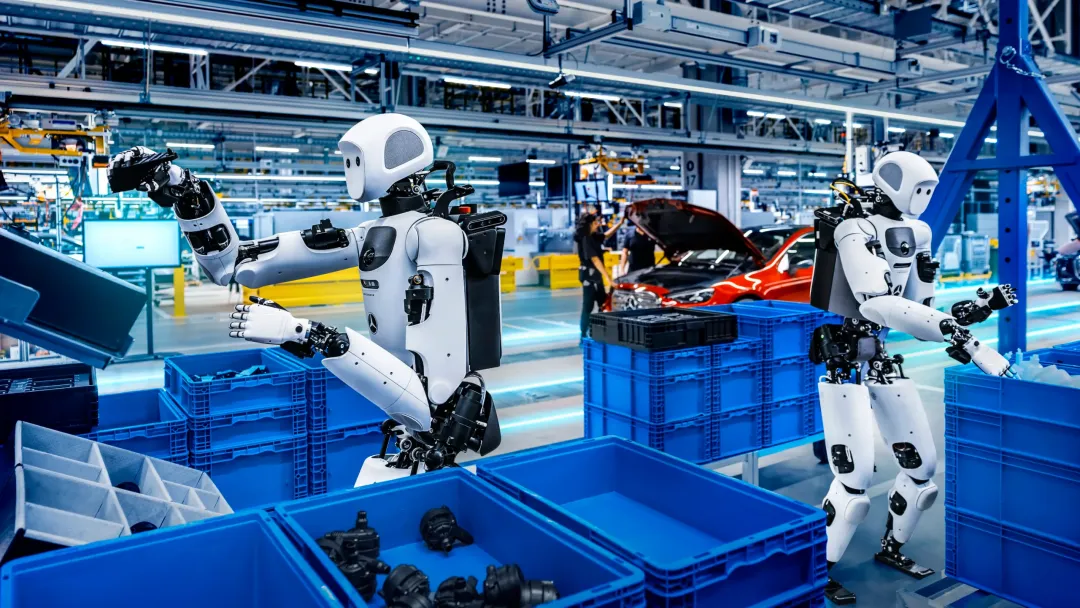
要说明两点。第一,谷歌没有说明这个具身推理模型是不是通用模型,公开材料也不足以认定负责规划的是Argon,所以这个案例只能代表“推理和动作分工”这种结构。第二,96%是概念验证的结果,不是正式产线长期运行的指标。
分工的好处,是把慢的部分和快的部分拆开:规划可以慢慢想,动作必须马上做。
第三层:直接控制,模型根据画面和机器人状态输出动作。 Gemini 4 Argon通过动作接口控制机械臂摆正杯子、放入纸巾。它还为波士顿动力的Spot搭建了一个垃圾桶的仿真模型,先在里面练习踩踏板开盖,再到真实环境里投放易拉罐。
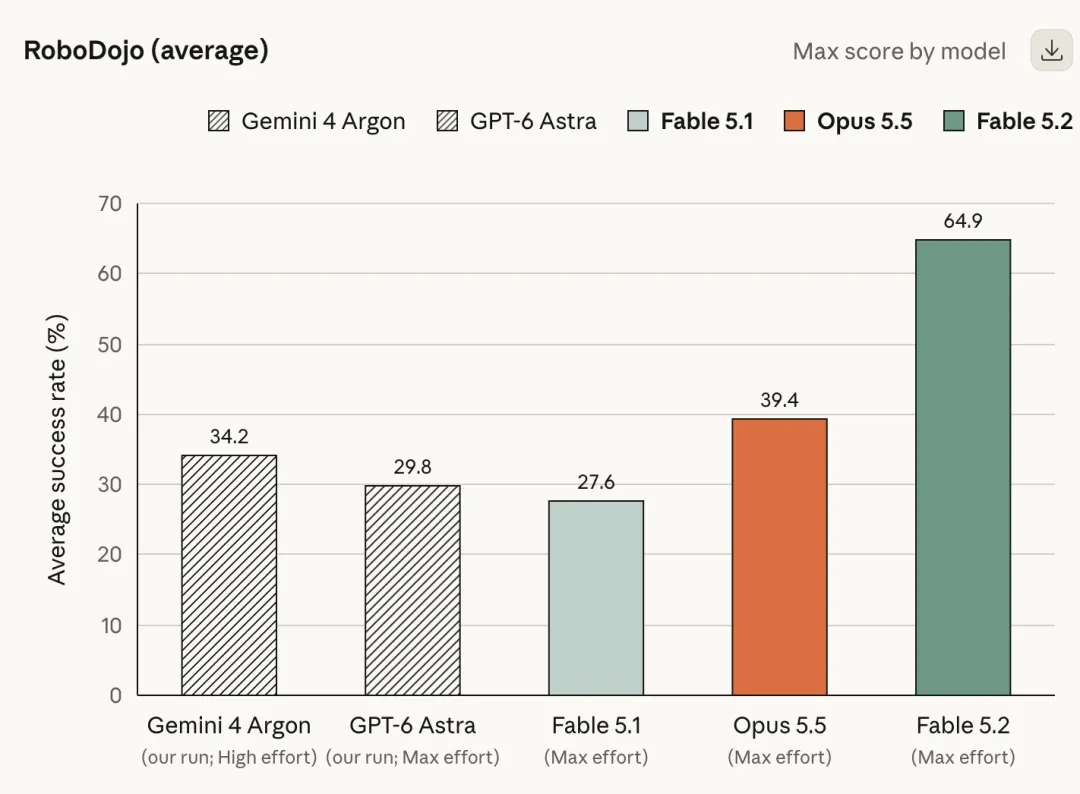
Anthropic展示了Claude Fable 5.2控制真实机器人拧瓶盖、解益智方块和绘画。据报道,Anthropic称这些任务都没有专门训练过,但演示视频不是原速。在公司内部运行的RoboDojo Sim双臂仿真评测中,Fable 5.2得分64.9%,上一代Fable 5.1是27.6%,同一框架下GPT-6 Astra只有29.8%。这项评测由Anthropic自己运行,并拿来和竞品对比。它测的是双臂操作,和英伟达的抓取放置基准不同,成绩不能直接横向比较。
第四层:直接控制,再加上记忆。 英伟达的Astranomy研究里,Astra直接生成动作的成功率是66.3%,平均每次推理约18.56秒。接入保留完整会话历史的Codex后,成功率升到74.8%。研究的解释是,会话历史保存了计划、动作和反馈,帮助模型跟踪任务进度。在子集实验中,额外开放代码执行、图像检查等工具,提升有限。这套方案每成功完成一次任务,API费用估算约36.40美元。
以上能看出三点。第一,最好的74.8%是在“暂停世界”的条件下拿到的。英伟达的测试里,模型思考时仿真环境会暂停;测试主要是抓取和放置,没有覆盖插接、装配这类复杂接触任务。仿真环境可以等模型想十几秒,传送带和正在倒下的杯子不会等。
第二,在接近真实工厂的场景里,报告成功率最高的是推理和动作分工的方案,不是由一个通用模型包办一切。
第三,同一个Astra,在英伟达的抓取放置基准上接入Codex后是74.8%,在Anthropic内部的双臂评测中只有29.8%。两项测试的任务、接口和评判标准都不同。这不能说明Astra变弱了,只说明成绩高度依赖基准和接口,何况后一项是竞争对手自己运行的评测。
所以,开头那23.8个百分点能说明,通用模型在这类任务上已经够聪明,但说明不了它已经够快、够便宜。
03.
两种押注的交锋
OpenAI现在开始让通用模型承担机器人任务,并不等于物理世界的问题已经解决了。Physical Intelligence联合创始人谢尔盖·莱文长期研究的,正是这个问题——训练一个以物理交互为核心的机器人基础模型。不过,莱文并不认为机器人模型必须与通用模型完全分开。
需要说明的是,下面莱文的观点来自他此前在Minus One节目的一场访谈,不是对OpenAI这次调整的回应。所谓交锋,是笔者把两种看法放在一起对照。
交锋一:机器人需要一个独立于通用模型的“大脑”吗?
CMU机器人研究所助理教授Guanya Shi认为,OpenAI可能已经不再把机器人当作特殊问题,而是看成通用智能的下游应用,和编程、法律、金融工具共用一个底座的原理相似。瓶子换了位置、光线变了,模型也能应对,还能推理任务的先后顺序,判断哪一步出了错。
莱文其实不反对用大模型做底座。他在谷歌时,把一间会议室改成实验室,放进很多机器人不停地抓东西。结果机器人非常擅长抓取,却没有因此学会其他任务。他的结论是,缺的是经验之外的先验知识。所以PI的第一个模型π0,用的就是预训练的视觉语言模型骨干。
两人的分歧不在于要不要用通用模型,而在于通用模型之外还缺什么。Guanya Shi自己也提醒,能在机器人本地运行、不依赖持续联网的小型专用模型仍然有必要。
交锋二:从通用模型借来的能力能不能直接用?
莱文的回答是,原则可以借,方法得重做。他举过两个例子。
第一个是标注。视频模型扩写提示词时,可能会描写翠绿的草、狗飘动的金色毛发,这些对机器人没用。机器人需要的,是和自己该做的动作紧密相关的信息。
第二个是视觉推理。要让机器人按电器的电源键,说“在右边缘往左三英寸”不一定有用;生成一张机器人手指正碰着按钮的图片,就能清楚地告诉它该做什么。在π0.7里,这类图片由一个独立模型生成。
这里的重点不是π0.7会不会生成图片,而是机器人需要的信息最终要能对应到动作上。通用模型擅长描述世界,机器人需要的却是能直接转成动作的信息。从描述到动作这一步,目前还得专门去做。
交锋三:物理世界的知识从哪来?
这是双方押注真正不同的地方。OpenAI的判断是,通用前沿模型已经能直接用于部分机器人任务,机器人研究应当并入通用模型研发。至于通用模型最终能覆盖多少物理世界的需求,它没有公开说。
莱文有一个形象的说法:互联网很小,物理世界很大。大量关于物体、接触、力、材料和现场纠错的知识,并没有被完整地记录在互联网上。要让机器理解物理世界,只能让它成为机器人。
他描述的路径是这样的。机器人先在人的监督下干活:比如物流设施里掉了东西,人捡起来放回去,机器人由此学会补救。他说这已经是很多部署中的常见做法。下一步是用强化学习让机器人从一开始就少出错。这一步目前主要在实验室里起作用,还没有在实际部署中广泛采用。
主持人拿Waymo追问:几千辆车,也走了十七年。莱文的回答是,汽车太专用,又不能随便试错;机器人能做的事更多,可以先做低风险任务积累能力,再去做高风险任务。
这条路径有个前提:机器人得先部署出去,哪怕还不完美。
莱文说,模型表现不好,可能是参数不够,也可能只是连接器没插好,夹爪合不严。这时你得走到机器人旁边,把连接器插好,再回去训练模型。
双方的分歧并不在“通用和专用谁赢”,而在于物理世界的知识有多少能提前学到,又有多少只能在现场边干边学。
04.
具身公司接下来比什么
MIT教授、Walden Robotics联合创始人兼CEO Russ Tedrake认为,机器人公司的机器已经在工厂等真实场景里干活,这些部署经验和数据是AI实验室难以复制的。而且基础模型越强,这些数据越值钱,因为机器人能更快地从中学会适应具体任务。Generalist联合创始人Pete Florence则认为,目前还看不出哪种模型会在长期主导机器人领域。
各家已经在调整位置。PI通过API提供模型微调和托管推理;Generalist用自己采集的物理交互数据训练模型,适配不同的夹爪和末端工具。莱文认为,机器人行业未来可能像计算机产业一样,从一家公司包办一切,走向硬件、物理智能层和应用的分工。
把四个层次和三轮交锋放在一起,能得到一个比“专用模型会不会被淘汰”更具体的结论:通用模型降低了机器人理解任务的门槛,但没有降低进入现场的门槛,也没有降低产生有效数据和控制身体的成本。
对具身公司来说,更现实的机会可能落在三处。第一是部署能力,设备是否已经进入真实场景并持续产生数据;第二是数据闭环,失败和人工纠错经验能否重新反馈给模型;第三是商业可行性,单次任务的时延、人工接管次数、连续稳定运行时间和完整成本,能否达到客户愿意付费的水平。
未来一两年,或许比谁发布了更聪明的模型更值得关注的,是真实任务里的成功率、每个动作要等多久,以及每完成一件活要花多少钱。
来源:机器人大讲堂