摘要
Robot-use Agent(RUA)已成为通用机器人控制的一种有前景的方法。然而,迄今为止,只有 GPT-6 Astra 和 Claude Fable 5.2 等前沿闭源模型取得了强劲表现,开放权重模型的能力仍明显不足。
我们展示了如何完全在仿真中、无需示范数据,通过RL训练一个 27B 参数的开放权重推理模型,使其能够原生地使用真实机器人。与 Computer-use Agent(CUA)类似,该模型观察环境,通过思维链进行推理,并生成下一步的末端执行器位姿,无需任何 Harness。
我们构建了面向 Agentic Robotics 的后训练引擎 PEAR(Post-training Engine for Agentic Robotics),并利用 Robot-use RL(RURL)在大规模仿真机器人任务上训练模型,这一过程与前沿模型习得计算机使用能力的方式相似。
我们发现,在仿真中习得的技能具有远超训练任务范围的泛化能力:它们能够迁移到未见过的机器人、真实世界和新指令。在仿真中的 LIBERO 和 RoboDojo 上训练后,模型在真实双臂机器人的测试中取得了 60% 的成功率,而基础模型一次也未成功。
在 LIBERO 上,训练将成功率从 1.6% 提升至 74.4%,接近以最大推理强度运行的 GPT-6 Astra 和 GPT-6.1 Sol。与使用示范数据微调的 VLA 模型 π0.5 相比,我们的模型在任务本身发生变化时表现出明显更强的鲁棒性。在 LIBERO-Pro 上,当模型被要求在熟悉的场景中执行新任务时,π0.5 的 episode 成功率仅为 0.75%,而我们的模型达到 57.4%。
最后,模型保留了其通用能力:在九项推理、编程和视觉 Benchmark 上,没有出现可测量的性能下降。这些结果表明,Robot-use RL 有望成为基础模型后训练的一部分。
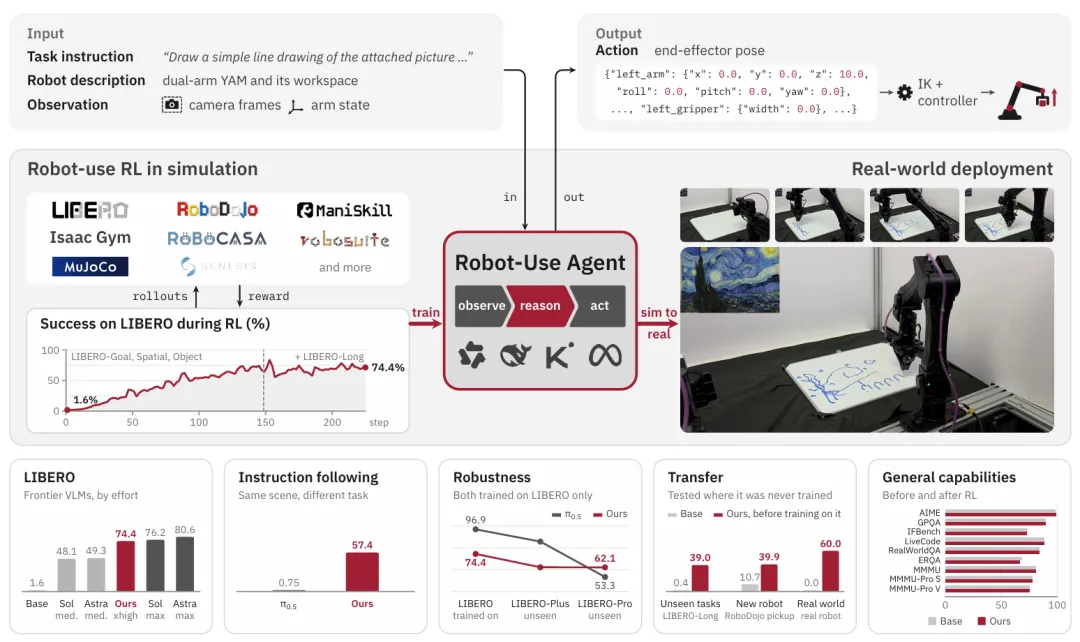
图 1. Robot-use RL(RURL)概览。 与 Computer-use Agent 类似,Robot-use Agent(RUA)观察场景,通过思维链进行推理,并生成下一步的末端执行器位姿,如图上方所示。它完全在仿真中通过RL训练,如图左侧所示,然后部署到真实机器人上,如图右侧所示。图中的标识展示了仿真器和开放权重模型的示例;我们在 LIBERO 和 RoboDojo 中训练 Qwen3.8-27B。图下方展示了模型在 LIBERO、指令遵循、鲁棒性、向未见任务、新机器人及真实世界迁移,以及通用能力方面的结果,所有结果均未使用 Harness。
1. 引言
Robot-use Agent(RUA)最近已成为通用机器人控制的一个有前景的方向。与通过屏幕截图操作计算机的 Computer-use Agent(CUA)类似,RUA 使用视觉语言模型(VLM)观察机器人相机图像,对任务进行推理,并输出下一步的末端执行器位姿。由于 VLM 直接操作机器人,RUA 能够利用强大基础模型所具备的广泛世界知识和推理能力,从而实现泛化并完成复杂任务。
基于 GPT-6 Astra 和 Claude Fable 5.2 等前沿模型构建的 RUA,已经展现出出色的泛化能力和语言指令遵循能力。在 RoboDojo 和 RoboLab 上,基于 GPT-6 Astra 构建的 Agent 已经超越了此前表现最好的策略。相比之下,使用特定任务示范数据微调的 VLA 模型通常难以泛化到新目标,也难以遵循新指令。
两个因素可能促成了前沿 RUA 的表现:这些模型接受过 Computer-use 训练,并且具备较强的空间推理能力。我们认为,通过思维链进行推理的能力对泛化尤其重要。
然而,迄今为止,这样的表现只有最强的闭源模型才能取得。开放权重模型在相同 Benchmark 上的成功率较低,在一些简单任务上也会失败。多项工作构建了 Harness,在模型之外加入技能和其他组件,例如分割模型 SAM 3,并将某些运动转换为少量可选项。这类 Harness 使开放权重模型能够完成部分任务,但它也可能限制模型的动作空间,进而使其他任务无法完成。随着模型能力增强,Harness 中的一些组件也可能被模型自身吸收。
OpenAI 等机构开发的 Computer-use Agent 通过在计算机任务上进行RL训练而获得能力。两类场景之间的高度相似性表明,机器人使用能力也可能通过同样的方式习得。因此,我们使用 Robot-use RL训练一个开放权重推理模型,训练完全在仿真中进行,并且不使用示范数据。
为了支持大规模、长时程、多轮次的 RURL,我们构建了 PEAR,即面向 Agentic Robotics 的后训练引擎。这是一套专为训练 RUA 设计的基础设施,详见第 3.2 节。在每一轮交互中,模型观察相机图像和机器人状态,对任务进行推理,并输出下一步的末端执行器位姿,如图 1 所示。逆运动学将该位姿转换为关节目标,机器人的控制器执行运动,然后模型接收下一次观测。
之前各轮的内容会保留在上下文中,每个 episode 获得一个二值奖励,表示任务是否完成,如图 2 所示。我们不提供感知工具、规划器或技能库,因此模型自身必须定位物体、确定如何操作物体,并识别动作何时失败。由于模型指定的是位姿,而非关节指令,并由每台机器人自身的逆运动学模块和控制器执行,仿真和真实机器人可以使用相同的接口。
尽管模型完全在仿真中训练,它习得的技能仍能很好地迁移到真实世界。我们先在 LIBERO 上训练模型,再使用 RoboDojo 中的两个任务进行训练。随后,在训练过程中从未接触过的真实双臂机器人上,模型完成了 60% 的测试,而基础模型一次也未完成,详见第 4.4 节。仅在 LIBERO 单臂任务上训练的 Checkpoint,在这些测试中也取得了 23% 的成功率。这些结果表明,基于仿真的RL能够赋予通用推理模型机器人使用技能,并使这些技能迁移到未见过的真实机器人本体上。
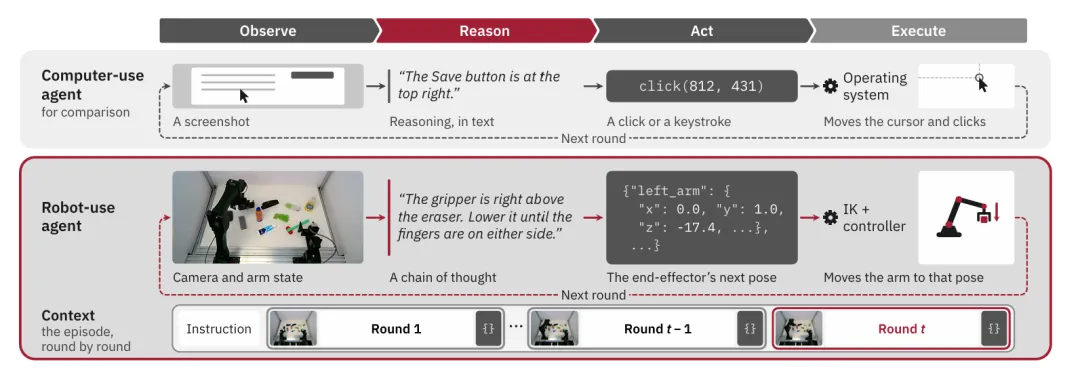
图 2. 一轮机器人使用过程。 Computer-use Agent(上)观察屏幕截图,对任务进行推理,并输出一次点击或按键,再由操作系统执行。我们的模型(下)以类似方式操作机器人:它观察相机视角和机械臂状态,通过思维链进行推理,并输出末端执行器的下一步位姿;随后,逆运动学模块和机械臂控制器将机械臂移动到该位姿。每一轮交互都会加入上下文,上下文中还包含指令和此前所有轮次的内容。仿真和真实机器人使用相同的步骤。
我们的主要发现如下:
在 LIBERO 上接近前沿模型。 模型在 LIBERO 上的成功率从 1.6% 提升至 74.4%,超过以中等推理强度运行的 GPT-6.1 Sol 和 GPT-6 Astra,后两者的成功率分别为 48.1% 和 49.3%。模型也大幅缩小了与二者在最大推理强度下的差距:后两者的成功率分别为 76.2% 和 80.6%,详见第 4.1 节。
鲁棒性与指令遵循能力。 当训练任务受到扰动时,模型仍能保持鲁棒性,并能遵循从未见过的指令。LIBERO-Pro 改变了 LIBERO 中的目标和布局;在这一 Benchmark 上,我们的模型优于 VLA 模型 π0.5,成功率分别为 62.1% 和 53.3%,详见第 4.2 节。
向未见任务和机器人的 Zero-shot 迁移。 模型没有在 LIBERO-Long 上接受任何训练,但在该任务集上取得了 39.0% 的成功率;基础模型的 episode 成功率为 0.4%。在 RoboDojo 的两个双臂机器人任务上,仅使用 LIBERO 训练的模型分别取得了 39.9% 和 17.0% 的 episode 成功率,而基础模型分别为 10.7% 和 13.0%。在 RoboLab-120 上,仅使用 LIBERO 训练就将模型的成功率从 5.4% 提升至 22.1%;同时,使用 LIBERO 和 RoboDojo 训练的模型超过了 RoboLab 榜单上的 π0.5,成功率分别为 37.3% 和 28.0%,详见第 4.3 节。
Sim-to-real 迁移。 这些技能也能从仿真 Zero-shot 迁移到真实世界:无需任何真实机器人训练数据,模型就能在一台双臂机器人上完成 60% 的测试,而基础模型一次也未成功。
通用能力得到保留。 Robot-use 训练没有使模型在九项推理、编程和视觉 Benchmark 上出现可测量的性能损失,详见第 4.5 节。这一结果表明,RURL 可以作为基础模型后训练的组成部分。
2. 相关工作
Robot-use Agent。 GPT-6 Astra 等前沿 VLM 已作为 RUA 在仿真和真实机器人上接受评测,RoboDojo 也为机器人 Agent 设置了单独的排行榜赛道。
许多近期工作构建了 RUA Harness,为模型提供感知工具、技能库、运动原语、记忆或代码执行能力,包括 ORA、ASPIRE、Harness VLA、OpenRUA、RAX、unirobot-agent 和 PyRUA-Lean。
同期工作还在这类 Harness 内训练开放权重模型:PyRUA-Lean 使用RL;CaPtain、AgenticRoboRL 和 ZAP 则先使用SFT,再进行多轮RL。相比之下,我们的模型不使用 Harness,也不使用示范数据,而是仅通过RL训练。
用于 Computer-use Agent 的RL。 Computer-use Agent 通过屏幕截图操作计算机,并在 OSWorld、WebArena 等 Benchmark 上进行评测。OpenAI 报告称,其 Agent 先通过监督学习训练,再进行RL。开放权重 Agent 也已通过在线多轮RL训练,例如 DigiRL 在 Android 设备上训练,WebRL 在网页环境中训练,UI-TARS-2 在桌面操作系统中训练。
基于可验证奖励的RL也被广泛用于训练长思维链。在新任务上进行RL,相较于SFT,对模型其他技能的侵蚀更少,泛化能力也更好。RURL 将这一方法应用于仿真机器人任务,并直接使用推理模型本身作为策略。
3. Robot-use RL
我们的目标是在仿真中训练一个推理模型,使其能够使用真实机器人。我们首先介绍 Robot-use Agent 如何操作机器人,以及我们在仿真和真实机器人上使用的交互协议,见第 3.1 节。随后介绍训练基础设施 PEAR 及其运行的RL算法,见第 3.2 节。由于基础模型在训练初期很少成功,训练采用了课程式学习,见第 3.3 节。
3.1. Robot-use Agent
Computer-use Agent 观察屏幕截图,对任务进行推理,并输出一次点击或按键,随后由操作系统执行,如图 2 上方所示。我们的模型以相同的方式操作机器人,如图 2 下方所示。在每一轮交互中,它观察相机画面和机械臂状态,通过思维链进行推理,并输出末端执行器的下一步位姿。随后,逆运动学将该位姿转换为关节角度,机械臂控制器执行相应运动。
我们不使用感知工具、抓取规划器、运动规划器或技能库,因此模型自身需要在相机画面中定位物体,确定如何接近和操作物体,并检测动作何时失败。此前各轮的内容和指令都会保留在上下文中,因此每次决策都可以考虑整个 episode 的信息。模型通过在仿真机器人任务上进行RL,习得上述所有能力,详见第 3.2 节。
System Prompt 规定了这一交互过程的协议,描述机器人的坐标系和相机,并给出任务指令,详见附录 H。该协议将机器人描述为一组具有名称的部件,以及这些部件对应的具名物理量:每条机械臂末端执行器的位置和朝向。
机器人状态以 JSON 对象的形式列出每个物理量的当前值;动作是一个结构相同的 JSON 对象,给出每个物理量的变化量,单位分别为厘米和弧度。控制器驱动机器人运动,直到所有目标均已到达且机器人处于静止状态,或者机器人在到达目标之前受到阻挡。
当仿真器报告任务成功、达到 Benchmark 的步数上限或上下文的 token 预算上限,或者模型的响应中不包含有效动作时,episode 结束。
由于动作是位姿层面的目标,且控制器位于模型之外,因此该协议对所有机器人都相同:在 LIBERO 的单臂 Franka、RoboDojo 的双臂 ARX 和真实双臂 YAM 之间,只有部件列表和机器人描述发生变化。
因此,部署到真实机器人上无需进一步训练:模型通过相同协议输出动作,Prompt 描述真实机器人的坐标系和相机,再由机器人自身的逆运动学模块和控制器执行动作。
3.2. PEAR:面向 Agentic Robotics 的后训练引擎
我们基于 veRL 和 LMCache 构建了用于训练 RUA 的基础设施 PEAR。我们遵循 Computer-use 所采用的训练方法,在仿真机器人任务上通过RL训练模型。
令一个 episode 表示为:
其中, 是第 轮的观测, 是模型的响应,包含推理过程和动作。策略 根据上下文逐 token 生成每一次响应。第 轮的上下文为:
其中, 是 System Prompt。如果仿真器在 episode 结束前报告成功,奖励 为 1;否则为 0。训练的目标是最大化该奖励在训练任务上的期望值。
我们使用 GRPO 的组内归一化优势估计:采样由 个 episode 组成的组 ,组内 episode 共享同一个任务和初始状态,并定义:
其中, 是一个很小的常数。一个 episode 中生成的每个 token 都获得该 episode 的优势值,无论它属于推理过程还是动作,也无论它位于哪一轮。梯度估计对一个 batch 中生成的 个 token 取平均:
其中, 是第 个 episode 中第 轮响应的第 个 token,$c_{i,t}^{k} = (h_{i,t}, y_{i,t}^{<k})$ 是该="" token="" 的上下文,$\mu$="" 是生成该="" episode="" 的策略。<="" p="">
第一项是 REINFORCE 估计器,以组内均值作为基线,且不使用 PPO clipping。Rollout 和参数更新完全异步运行,因此 比正在训练的策略落后一到两个版本。第二项是 score-centering 修正项,用于处理这种不匹配。我们仅使用这一修正项,不使用截断重要性采样。
与 DAPO 一样,组内所有 episode 均成功或均失败的组会被丢弃并重新采样,因为这些组的优势值为零。
训练属于长时程、多轮次的 Agentic RL,因此较高的 prefix-cache 命中率对高效 rollout 很重要。为此,我们使用 LMCache 将 prefix KV cache 卸载到 CPU 内存,并限制并发 episode 的数量,以保持较高的 prefix-cache 命中率。
在策略更新时,一个完整的 episode 构成一条训练序列。我们结合 FSDP、序列并行和梯度检查点,使该序列能够放入显存。附录 A 给出了每种 GPU 的配置。
3.3. 训练课程
使用二值奖励时,公式中的优势值只有在一个组同时包含成功和失败的 episode 时才非零。因此,如果模型在某个任务上从未成功,该任务就无法提供学习信号。
在训练开始时,几乎每个 episode 都会失败:基础模型在 LIBERO 的 Spatial、Object 和 Goal 任务集上的 episode 成功率约为 2%;在其长时程任务集 LIBERO-Long 上为 0.4%;在大多数 RoboDojo 任务上则几乎从不成功。
因此,我们先在已经能够提供学习信号的任务上训练,再依靠迁移将能力扩展到其他任务。在最初任务上习得的技能,可以提高模型在未参与训练的任务上的成功率;当模型开始在这些任务上取得成功时,我们再将它们加入训练。
在我们的实验中,训练分为三个阶段:
在 LIBERO 的 Goal、Spatial 和 Object 任务集上训练。
在 LIBERO 的全部四个任务集上训练。
在完成 LIBERO 训练后,从 RoboDojo 中选择能够提供最强学习信号的两个任务进行训练,即 general pickup 和 align blocks,见第 4 节。
第一阶段不使用 LIBERO-Long,也为测试迁移能力提供了一个清晰的条件,见第 4.3 节。
4. 实验
训练。 我们按照第 3.3 节的课程式训练方案,训练开放权重推理模型 Qwen3.8-27B:先在 LIBERO 的 Goal、Spatial 和 Object 任务集上训练 148 步;第 149 至 225 步使用全部四个任务集;然后在两个 RoboDojo 任务上继续训练 115 步。
我们将第 225 步的 Checkpoint 称为“仅在 LIBERO 上训练的模型”,在图表中标记为 Ours(LIBERO only)。最后一个 Checkpoint 是最终模型 Qwen3.8-27B-PEAR,我们将其部署到真实机器人上,并标记为 Ours。
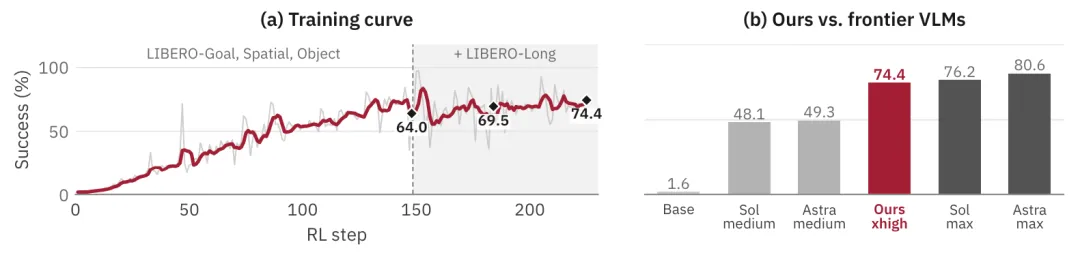
图 3. LIBERO 上的训练曲线以及与前沿 VLM 的对比。
(a)每个RL训练步中 rollout 的成功率:细线为原始值,粗线为平滑后的值。在第 149 步加入 LIBERO-Long;菱形标记表示同一训练 run 在 LIBERO 的 2,000 个 episode 上的评测结果。
(b)基础模型、以 xhigh 推理强度运行的我们的模型,以及分别以 medium 和 max 推理强度运行的 GPT-6.1 Sol 和 GPT-6 Astra,在 LIBERO 的 2,000 个评测 episode 上的表现。xhigh 也是我们的模型在训练时使用的推理强度。所有模型使用相同的评测协议;推理强度是各模型自身用于控制推理时长的设置。
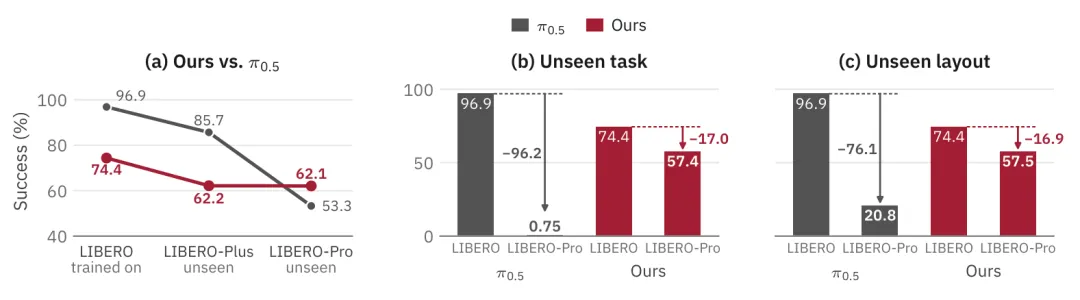
图 4. 在 LIBERO、LIBERO-Plus 和 LIBERO-Pro 上与 π0.5 的对比。 两个策略都仅在 LIBERO 上训练:π0.5 使用示范数据进行SFT,我们的模型使用 RURL。
(a)在 LIBERO 和两个扰动 Benchmark 上的成功率。
(b、c)LIBERO-Pro 中的两种扰动:在训练场景中执行未见过的任务,以及交换物体位置。箭头表示相对于 LIBERO 的成功率下降幅度。π0.5 的结果来自此前工作。
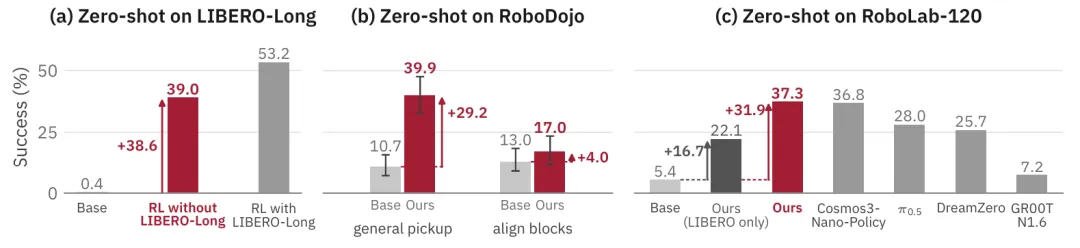
图 5. 在未见任务、新仿真器和新机器人,以及新 Benchmark 上的 Zero-shot 成功率。
(a)“不使用 LIBERO-Long 的RL”仅在 LIBERO 的其他三个任务集上训练;“使用 LIBERO-Long 的RL”表示同一训练 run 在加入 LIBERO-Long 后的结果,作为参考。
(b)仅在 LIBERO 上进行RL训练后,在 RoboDojo 上的结果。RoboDojo 使用不同的仿真器和双臂 ARX 机器人;误差线为 95% Wilson 置信区间。
(c)在第三个 Benchmark RoboLab-120 上,与 RoboLab 榜单中的四个通用机器人策略进行对比;这四个策略均为在 DROID 上训练的 Checkpoint。
评测设置。 在 LIBERO 上,我们报告全部 2,000 个评测 episode 的成功率:40 个任务各有 50 个 episode。
LIBERO-Plus 从七个维度对 LIBERO 施加扰动:相机、光照、背景、传感器噪声、指令措辞、布局和机器人的初始状态。我们的模型在该 Benchmark 上评测了 10,030 个 episode。
在 LIBERO-Pro 中,我们使用四种扰动类型:在同一场景中执行不同任务、交换物体位置、改变指令措辞,以及改变物体的外观风格。我们的模型在每种扰动类型上分别评测了 2,000 个 episode。
在 RoboDojo 中,我们评测 general pickup 和 align blocks 两个任务,每个任务运行 163 至 200 个 episode,并报告 95% Wilson 置信区间。
RoboLab-120 包含 120 个桌面操作任务,分为三个难度等级,由配备 Robotiq 夹爪的单臂 Franka 机器人执行。我们在每个任务上运行 10 个 episode,共计 1,200 个 episode,并报告最终模型两次评测的平均值。
在真实双臂 YAM 机器人上,我们对每个模型进行 30 次测试:
在五个场景中各进行两次测试,指令为:“使用三角尺将三个积木推成一条对齐的直线,然后松开三角尺,并将机械臂复位。”
对十个物体各进行两次测试,指令为:“将〈物体〉拿起 10 厘米。”
如果一次测试超过 25 轮,或者模型在单轮中的推理超过 32k token,则该测试判定为失败。当模型输出逆运动学无法求解的无效动作时,它会重试,重试也计为一轮。
除非另有说明,我们的模型均以 xhigh 推理强度运行。
基线。 前沿 VLM 使用与我们模型相同的协议,见第 3.1 节。我们评测 GPT-6.1 Sol 和 GPT-6 Astra 的 medium 与 max 推理强度。推理强度是各模型自身用于控制推理时长的设置。
π0.5 是一个使用 LIBERO 中每个任务的示范数据进行SFT的 VLA。我们没有自行评测 π0.5,而是使用其已发布 Checkpoint 的公开结果:LIBERO 结果来自 openpi 代码仓库,LIBERO-Plus 结果来自 Yan 等人的工作,LIBERO-Pro 结果则来自 Zhou 等人报告的各任务集结果,并对四个任务集取平均。
在 RoboLab-120 上,我们与 RoboLab 排行榜中的四个通用机器人策略进行比较:Cosmos3-Nano-Policy、π0.5、DreamZero 和 GR00T N1.6。四者均为在真实机器人数据集 DROID 上训练的 Checkpoint,并由 RoboLab 组织者评测。因此,这里的 π0.5 与上述 LIBERO 评测使用的 Checkpoint 不同。
4.1. 在 LIBERO 上学习机器人使用能力
RL 使策略从接近零的起点取得提升。在 Goal、Spatial 和 Object 任务集上,基础模型约有 2% 的 rollout 成功,因此几乎所有 rollout 结束时都无法获得奖励。尽管如此,这三个任务集上的训练成功率仍在 148 步内上升至约 70%,如图 3(a)所示。
在这三个任务集上习得的技能,也能很好地迁移到模型从未接受过训练的任务。在第 148 步,即模型尚未在 LIBERO-Long 上训练时,它已经能够解决其中 39.0% 的任务,而基础模型的成功率仅为 0.4%,如图 5(a)所示。此时,模型在整个 LIBERO 上的成功率为 64.0%。我们将在第 4.3 节重新讨论这一迁移结果。
从第 149 步开始在全部四个任务集上训练后,成功率在第 184 步提升至 69.5%,在第 225 步提升至 74.4%,每次比前一个阶段提高约 5 个百分点。
达到 74.4% 后,我们的模型接近以 max 推理强度运行的 GPT-6 Astra 和 GPT-6.1 Sol,后两者的成功率分别为 80.6% 和 76.2%;同时超过以 medium 推理强度运行的二者,后两者的成功率分别为 49.3% 和 48.1%,如图 3(b)所示。
这些结果表明,即使基础模型的初始成功率很低,也可以仅通过RL训练获得较高的成功率:在本实验中,成功率从 1.6% 提升至 74.4%。
模型获得的能力也具有通用性,并非仅适用于 LIBERO 的训练任务。接下来的章节将展示:当 LIBERO 的场景和任务受到扰动时,模型仍然保持鲁棒性;它能够遵循从未用于训练的指令,见第 4.2 节;还能迁移到新 Benchmark、新机器人和真实世界,见第 4.3 节和第 4.4 节。
4.2. 鲁棒性与指令遵循能力
尽管仅在 LIBERO 上训练,我们的模型仍能泛化到训练任务之外:当任务受到扰动时,它能够保持鲁棒性,并遵循从未见过的指令,如图 4 所示。
π0.5 在 LIBERO 上的表现优于我们的模型。在 LIBERO 上,π0.5 使用每个任务的示范数据进行SFT;但当任务目标或物体布局发生变化时,它失去了这一优势。
我们在 LIBERO-Plus 和 LIBERO-Pro 上测试两个策略。这两个 Benchmark 以两个策略均未见过的方式扰动训练任务。
LIBERO-Plus 主要扰动观测,例如相机、光照、背景和传感器噪声。两个策略在该 Benchmark 上的成功率下降幅度相近:π0.5 下降 11.2 个百分点,我们的模型下降 12.2 个百分点。
LIBERO-Pro 还会改变任务目标和物体布局。我们的模型在该 Benchmark 上再次下降约 12 个百分点,而 π0.5 下降了 43.6 个百分点。因此,π0.5 在 LIBERO 上领先 22.5 个百分点,在 LIBERO-Pro 上则变为落后 8.8 个百分点,如图 4(a)所示。
我们的模型在 LIBERO-Pro 上的优势,来自那些改变机器人需要执行何种操作的扰动。
任务扰动保留一个训练场景及其初始状态,但给出一条要求执行不同任务的指令。π0.5 的成功率从 LIBERO 上的 96.9% 降至 0.75%,下降 96.2 个百分点;我们的模型从 74.4% 降至 57.4%,下降 17.0 个百分点,如图 4(b)所示。π0.5 倾向于执行它在该场景中接受训练的任务,而我们的模型执行新指令要求的操作。
位置扰动从另一个角度测试相同的能力:它保留指令,但交换物体位置,因此遵循指令需要执行不同的运动。π0.5 下降 76.1 个百分点,降至 20.8%;我们的模型下降 16.9 个百分点,降至 57.5%,如图 4(c)所示。
在另外两种扰动下,即改变指令措辞或改变物体外观风格、但保留原始任务时,π0.5 仍然领先,如图 10(b)所示。因此,当示范过的运动仍然正确时,π0.5 能够保持鲁棒性;当需要改变运动时,它就会失败。我们的模型在每种扰动下下降 1 至 17 个百分点,但仍能继续遵循指令。
这种差异可能源于模仿示范与对任务进行推理的区别:我们的模型保留了基础模型理解指令和场景的能力,而RL使它学会根据所理解的内容采取行动。
4.3. 向未见任务和机器人的 Zero-shot 迁移
在没有使用 LIBERO-Long 的 episode 进行训练的情况下,我们的模型在 LIBERO-Long 上取得了 39.0% 的成功率,而基础模型的 episode 成功率为 0.4%,如图 5(a)所示。
RL 几乎不可能直接从基础模型开始学会 LIBERO-Long,因为一个几乎从未成功的模型几乎无法获得奖励,也就缺少可供学习的信号。来自另外三个任务集的迁移改变了这一情况:当 LIBERO-Long 在第 149 步被加入训练时,模型在该任务集上取得的成功为RL提供了训练信号,其在 LIBERO-Long 上的成功率最终达到 53.2%。
当仿真器和机器人同时发生变化时,技能也能够迁移。RoboDojo 是一个不同的环境,其任务使用双臂 ARX,而非 LIBERO 使用的单臂 Franka。
仅在 LIBERO 上训练后,我们的模型在 RoboDojo 的 general pickup 任务上取得 39.9% 的 episode 成功率,在 align blocks 任务上取得 17.0%;基础模型的对应成功率分别为 10.7% 和 13.0%,如图 5(b)所示。因此,模型在 LIBERO 上习得的能力并不局限于 LIBERO 的仿真器或机器人。
我们还在第三个仿真 Benchmark RoboLab-120 上对最终模型进行 Zero-shot 评测。该模型仅在 LIBERO 和 RoboDojo 上通过RL训练,见第 3.3 节;RoboLab 中的任务和场景对它而言都是新的。
在 RoboLab-120 的 1,200 个 episode 中,最终模型的成功率为 37.3%,基础模型为 5.4%。这一结果与 Cosmos3-Nano-Policy 的 36.8% 相当,并高于 π0.5 的 28.0%、DreamZero 的 25.7% 和 GR00T N1.6 的 7.2%。这四个模型都是 RoboLab 排行榜中的通用机器人策略,如图 5(c)所示。
仅在 LIBERO 上训练的模型成功率为 22.1%。附录 D 报告了按任务难度划分的结果。
4.4. Sim-to-real 迁移
从仅在 LIBERO 上训练的模型出发,我们继续在 RoboDojo 的两个任务上进行RL训练,整个过程完全在仿真中进行。
在不同的仿真器和双臂机器人上,RL 的作用方式与在 LIBERO 上相同:经过 115 步训练,两个任务上的训练成功率从约 25% 上升至约 70%,如图 6(a)所示。
在 RoboDojo 上评测时,最终模型在 general pickup 和 align blocks 任务上的 episode 成功率分别为 71.2% 和 78.8%;在这一训练阶段之前,成功率分别为 39.9% 和 17.0%,如图 6(b)所示。
随后,我们在真实双臂 YAM 上对各模型进行 Zero-shot 评测。所有模型都未曾在这台机器人上接受训练。
在没有任何真实机器人数据的情况下,最终模型在 30 次测试中成功 18 次,而基础模型一次也未成功。仅在 LIBERO 上训练的模型在 30 次测试中成功 7 次,尽管它既未见过这些任务,也未见过这台机器人,如图 7(a)和(b)所示。
最终模型成功的测试需要 7 至 24 轮交互,上下文长度为 23k 至 132k token。附录 G 列出了每次测试及每次失败的原因。
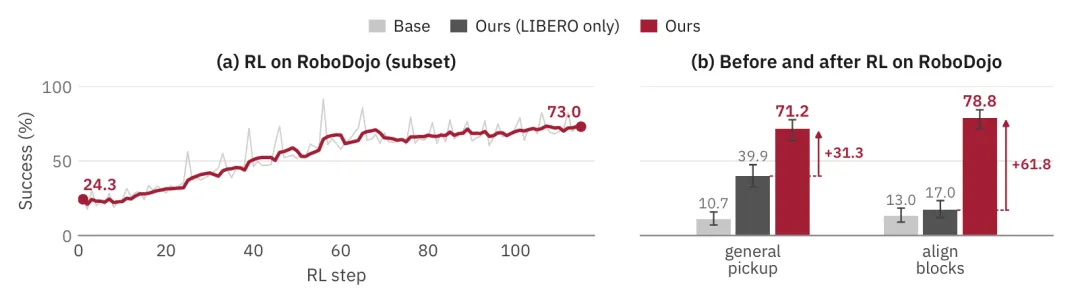
图 6. 在 RoboDojo 子集上的训练曲线及RL前后的成功率。 最终模型从仅在 LIBERO 上训练的模型继续出发,在 RoboDojo 的两个任务上进行 RURL,整个训练过程完全在仿真中进行。
(a)每个RL训练步中 rollout 的成功率:细线为原始值,粗线为平滑后的值。
(b)这一训练阶段前后,模型在两个任务上的成功率;误差线为 95% Wilson 置信区间。
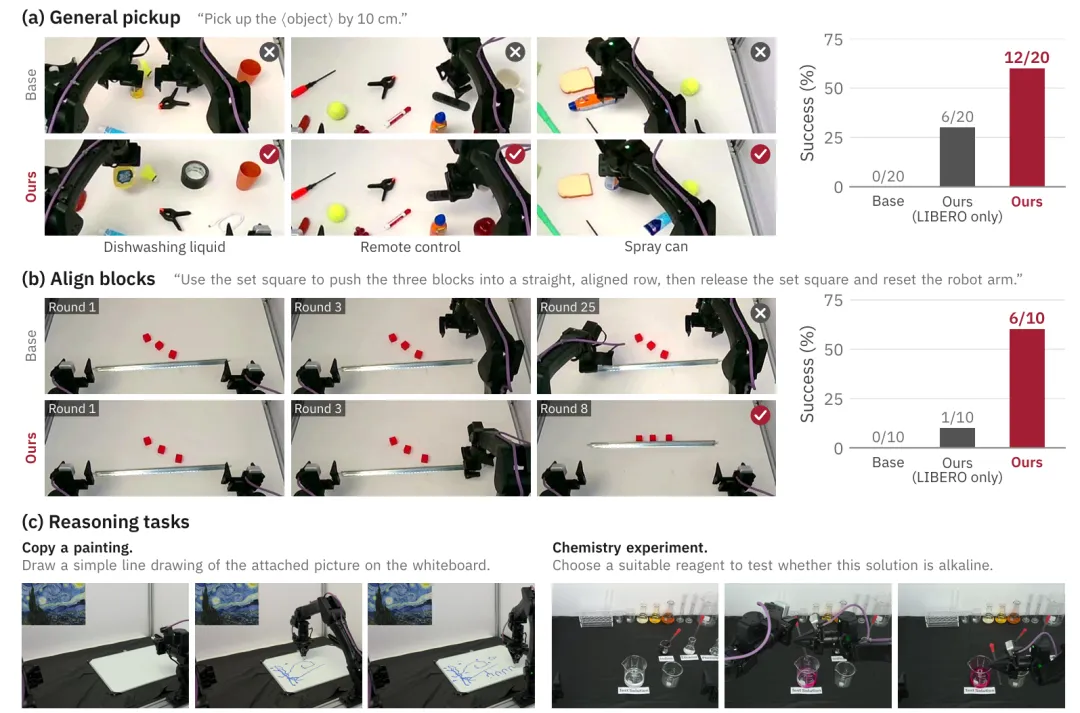
图 7. 在真实双臂 YAM 机器人上的评测。 我们的训练不包含这台机器人,也不使用真实机器人数据。
(a)General pickup:展示了三次测试,最终模型成功拿起物体,而基础模型未能成功。柱状图给出每个模型在 20 次测试中的成功次数;十个物体各测试两次。
(b)Align blocks:展示了一次测试中的三个交互轮次,最终模型成功,而基础模型失败。柱状图给出每个模型在十次测试中的成功次数。
(c)推理任务:最终模型在白板上绘制一幅画的简化线条版本,并选择一种能够检验溶液是否呈碱性的试剂。
推理任务。 上述测试重复了最终模型在 RoboDojo 上接受训练的两个任务。除此之外,我们还让模型执行两个推理任务。我们将推理任务定义为:在训练中没有对应任务,并且依赖于推理下一步应该做什么,而非依赖经过训练的运动的任务,如图 7(c)所示。对于这类任务,Prompt 会详细描述机器人和任务,见第 5 节。
给定《The Starry Night》的一张图片后,最终模型在白板上绘制了这幅画的简化线条版本。
为了测试一种溶液是否呈碱性,模型选择了酚酞,而非碘或乙醇,因为酚酞在碱性溶液中会变成粉红色。加入试剂后,溶液确实变成了粉红色。
这类任务需要世界知识和推理能力,而这些能力来自基础模型。
4.5. 保留通用能力
我们使用配对比较,在相同问题上对比最终模型与基础模型。在全部九项 Benchmark 上,RL后的分数变化均处于配对比较得到的 95% 置信区间内,没有出现可测量的性能下降,如图 8 所示。
九项 Benchmark 包括 AIME 2026、GPQA Diamond、IFBench、LiveCodeBench v6、RealWorldQA、ERQA、MMMU 验证集,以及 MMMU-Pro 的 Standard 和 Vision 两种设置。九项 Benchmark 的平均分数变化为下降 0.15 个百分点。完整数值和评测设置见表 6。
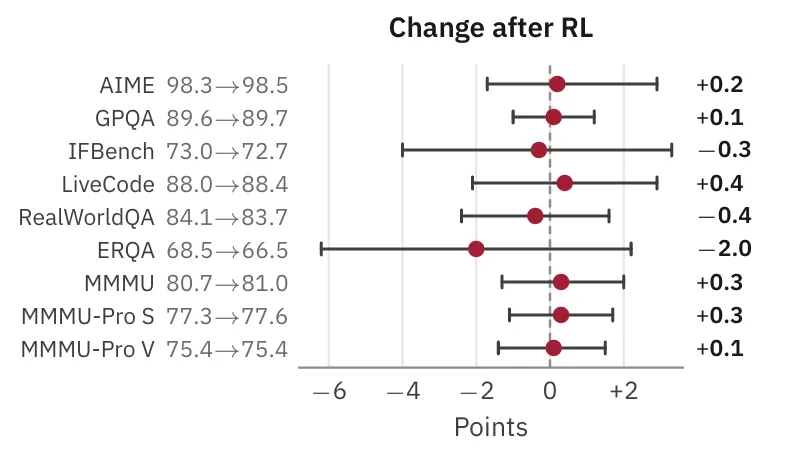
图 8. RL前后的通用 Benchmark 表现。 在相同问题上对比最终模型和基础模型:圆点表示分数变化,线段表示相应的配对 95% 置信区间;每项 Benchmark 名称旁列出了RL前后的分数。
图 9. 推理强度与推理速度。
(a、b)仅在 LIBERO 上训练的模型使用 BF16 权重时,在 low 和 xhigh 推理强度下,每轮生成的思考 token 数量以及在 LIBERO 上的成功率。low 推理强度的数值是两次评测的平均值。
(c)单设备上的解码速度。所有测试均使用 NVIDIA ModelOpt 量化得到的 NVFP4 权重,以及 Inco 的 DFlash2 Drafter;GPU 上使用我们的 megakernel,M5 Max 上使用 Inco 的 Splash 引擎。
我们使用配对比较,在相同问题上对比最终模型和基础模型。在全部九项 Benchmark 上,分数变化的 95% 置信区间均包含零,如图 8 所示。这与此前的发现一致:在新任务上进行RL,相较于SFT,对模型其他技能的侵蚀更少。
最终模型在 RoboDojo 的 general pickup 和 align blocks 任务上达到 75.0% 的成功率,同时在 AIME 2026 上得分 98.5,在 GPQA Diamond 上得分 89.7,在 LiveCodeBench 上得分 88.4;在每项视觉 Benchmark 上,它与基础模型的分数差距都不超过 2 分。
同一个模型现在既能推理、编写代码、回答有关图像的问题,也能使用机器人。
4.6. 推理强度与推理速度
尽管模型仅以 xhigh 推理强度进行训练,Chat Template 中的推理强度设置仍能控制它的推理时长。
训练期间没有任何RL rollout 使用更低的推理强度,但在 low 强度下,模型每轮使用 0.86k 个思考 token,而非 xhigh 强度下的 3.23k 个,如图 9(a)所示。因此,在单一推理强度下进行RL,并没有固定模型的推理长度。
成功率也随着推理长度缩短而下降:在 LIBERO 上,low 推理强度下的成功率为 21.9%,这是两次评测的平均值;xhigh 推理强度下则为 74.4%。当思考 token 数量减少到不足原来的三分之一时,成功率也下降到不足原来的三分之一,如图 9(b)所示。
因此,模型在 LIBERO 上的大部分能力来自每次运动前的长时间推理。
由于模型在每次运动前都要进行较长时间的推理,解码速度决定了它采取行动的速度。使用 NVFP4 权重和 DFlash2 Drafter 时,模型在 M5 Max 上通过 Inco 的 Splash 引擎达到每秒 52 token 的解码速度。
我们使用 KDA 优化了自己的 megakernel。使用该 megakernel 时,模型在单张 RTX 5090 上的解码速度为每秒 221 token,在单张 GB300 上为每秒 747 token,如图 9(c)所示。
以每秒 747 token 的速度计算,xhigh 强度下的一轮推理约需 4.3 秒,low 强度下的一轮推理约需 1.1 秒。因此,推理强度设置也带来了成功率与速度之间的权衡。
我们使用 Inco 原始的 DFlash2 Checkpoint,其平均接受长度为 3.2 个 token。针对我们的模型专门调优的 Drafter 可能具有更长的接受长度,从而进一步加快解码速度。因此,该模型可以在单张消费级 GPU 或一台笔记本电脑上本地运行。
然而,NVFP4 量化会降低模型的准确率,并使其思维链变长,因此所有评测均使用 BF16 权重。
5. 局限性
训练规模尚未扩大。 主要由于 GPU 资源有限,我们在完成两个 RoboDojo 任务的训练后停止了训练,当时训练过程仍然稳定。到目前为止,训练也只覆盖两个仿真器和少量任务,并且以一个 27B 参数的基础模型作为起点。我们认为,如果通过更多样化的仿真和任务扩大训练规模,并使用能力更强的基础模型作为起点,可能获得更强的机器人使用能力。
未使用SFT。 我们没有使用SFT,原因有二。第一,我们缺少高质量的分布内数据,并担心SFT会损害模型的通用能力。第二,我们认为,即使能够获得机器人数据,也应在预训练和中期训练阶段加入这些数据,而非使用它们对一个已经完成后训练的模型进行SFT。因此,我们仅使用RL进行训练。
执行任务的速度仍然较慢。 模型在每次运动前都要进行较长时间的推理。我们在RL过程中没有施加长度惩罚,也没有限制思维链的长度。虽然单张 GB300 上的推理速度达到每秒 747 token,但一轮推理平均仍需约 4.3 秒,如图 9 所示;在少数情况下,思维链可达到 32k token,使得一次运动需要半分钟以上。如何在不牺牲成功率的情况下缩短推理过程,例如在RL期间对较短的思维链给予奖励,留待未来研究。
性能高度依赖 Prompt。 我们的基础模型 Qwen3.8-27B 相对较小,受能力限制,它通常缺少关于所控制机器人本体的知识,因此需要在 Prompt 中提供这些信息。由此,任务成功率可能在很大程度上取决于模型能否根据 Prompt 清楚地理解机器人本体和环境;当 Prompt 提供了模型所需的足够信息时,模型才能达到最佳表现。对于图 7(c)中更难的任务,我们的模型只有在 Prompt 中得到机器人本体和任务的详细描述后才能成功。因此,模型的表现高度依赖 Prompt,但这也在一定程度上展示了它遵循详细语言指令的能力。
尚不能可靠地规划 Action Chunk。 当前模型只能输出末端执行器的下一步位姿,随后由逆运动学模块和控制器将机械臂移动到该位姿并停下。因此,准确性部分取决于控制器:实现不佳的控制器可能使机械臂在某些位置突然运动,导致其偏离目标位姿;效率低下的控制器则会消耗任务的步数预算,留下更少的运动机会,这主要影响仿真评测。
这一设计也增加了完成任务所需的轮数。由于每轮只能将机械臂移动到一个位姿,原本模型可能通过一个 Action Chunk 在一轮内完成的复杂运动,现在必须拆分为多个轮次。我们希望未来的工作能够改善这一点。
6. 结论
通用推理模型可以完全在仿真中学会使用真实机器人,其方式与前沿模型学习使用计算机的方式相同。
模型通过一个以相机画面为输入、以末端执行器位姿为输出的接口采取行动,并在机器人任务上通过RL训练。在仿真中仅使用 LIBERO 和 RoboDojo 训练后,我们的模型在真实双臂机器人的测试中取得 60% 的成功率,而基础模型一次也未成功。
从一个在机器人任务上很少成功的基础模型出发,RURL 还训练出了一个能够遵循训练中从未出现过的指令、在训练任务受到扰动时保持鲁棒性、迁移到新仿真器和新机器人,并保留通用能力的模型。
因此,在仿真中进行 RURL 为构建真实世界的 Robot-use Agent 提供了一套简单的方法,并且仍有很大的改进空间。我们的结果表明,推理能力使这类 Agent 能够泛化到远超其训练任务的范围。我们希望这些结果能够推动后续研究,将 RURL 作为基础模型后训练的一部分。
来源:human five