前几节中,我们探索了 flow 和扩散模型作为欧几里得空间 上的生成模型,允许我们生成由向量 表示的数据点。
然而,并非所有数据都自然建模为 中的点。许多数据类型,如文本或 DNA,更自然地被视为离散状态空间 的元素。最重要的是,语言由离散 token 序列组成,我们想用扩散模型建模。
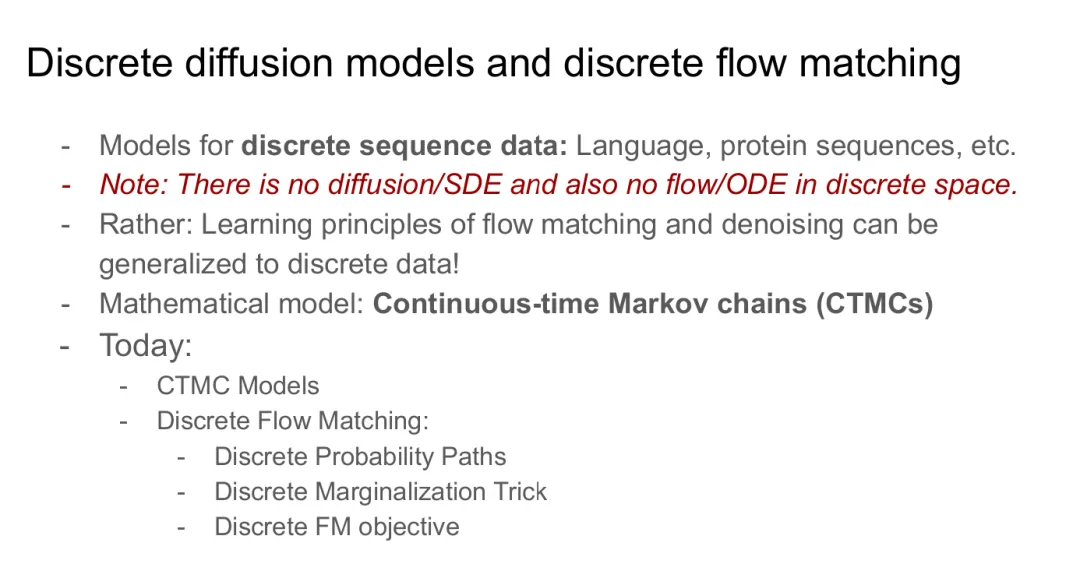
那么,我们如何把 flow 和扩散模型应用于这种数据类型?结果是,我们在前面几节学到的原理对这种数据类型也成立。由此产生的模型称为离散扩散模型。
然而重要的是要记住,离散状态空间中不存在数学扩散过程(SDE 不存在于离散状态空间中)。我们不使用 ODE/SDE,而是使用连续时间马尔可夫链(CTMC)。
下面我们将解释 CTMC 模型(见 7.1 节)以及如何学习它们(见 7.2 节),使我们能够用 flow 和扩散模型的原理构建LLM。
7.1 连续时间马尔可夫链(CTMC)模型
本节中,我们解释连续时间马尔可夫链(CTMC)。你可以把 CTMC 看作离散设置下 SDE 的离散类比:我们可以用它来构建生成离散状态的神经网络。此外,我们将介绍 CTMC 模型,即允许用 CTMC 生成离散序列(如文本)的神经网络。
让我们通过描述状态空间 来开始。设 为词表。状态空间为 ,其中 是序列长度, 是词表大小。
例如, 可以枚举字母表或离散 token 集合, 表示长度为 的序列(句子)集合。对 DNA, 可以是全部 4 个 DNA 碱基, 是所有长度为 的 DNA 序列。
接下来, 是 上的随机过程,即从 、 的随机轨迹。我们要求 是一个马尔可夫过程,即一个无记忆过程。具体地,这意味着以下条件成立
换句话说,未来事件的概率只取决于现在——过去与未来不再相关。注意,ODE/SDE 不存在于离散状态空间上——也是马尔可夫过程。这里 是离散空间上的点,因此称为马尔可夫链。
量 是转移概率,它们与初始分布 一起完全决定了 CTMC。
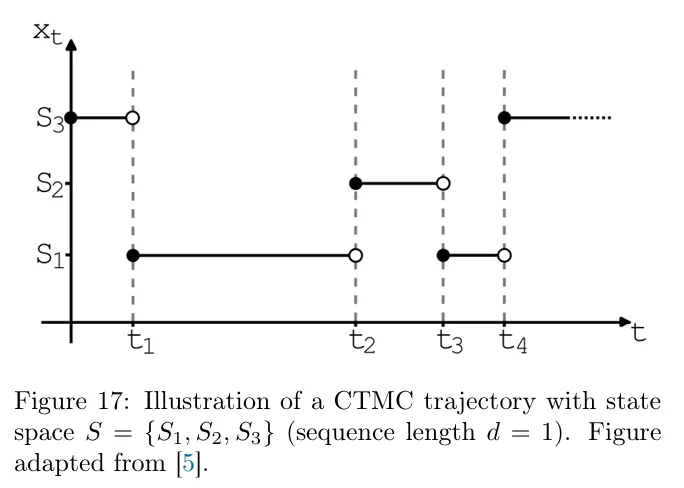
图 17:状态空间 上 CTMC 轨迹示意(序列长度 )。
接下来,我们推导离散设置下向量场的类比。由于我们在离散设置中,只能在状态之间"跳"(切换)——不能再沿方向走。
因此,我们定义一个率矩阵,有效地总结了从状态 跳到状态 的速率。形式上,率矩阵 由一个有界函数(连续时间)给出:
其中 描述从 切换到 的速率,满足:
(1) 向外速率为正:,只要 (85)
(2) 停留速率等于向外速率的负值:,对所有 (86)
这两个条件很直观。第一个条件表示从 切换到不同状态 的速率只能是非负的(不切换只是对应于 0,所以速率小于 0 没有意义)。
第二个条件表示在 停留的速率 应该抵消离开 的速率——本质上是一个一致性条件,说明你在 或离开 之间没有第三选择。
注意,这些条件特别意味着 。因此, 是一个对角元素非正、所有非对角元素非负的矩阵。
我们现在可以定义微分方程的类比,即 CTMC "遵循"率矩阵的条件。我们要求 的分布或演化应该遵循率矩阵 。换句话说,我们要求转移概率满足
左边是从 切换到 的概率的无穷小变化率。我们施加条件,使这些概率应该按率矩阵指定的方式变化。
让我们简单检查一下对 时请求这些条件是否合理,即方程 (87) 中的 是否为有效率矩阵?对 ,从 切换到 的概率为零(因为时间未流逝),即对所有 有 。因此我们知道导数必须非负,且只要 有 。这检查了方程 (85) 中的第一个条件。此外,我们知道
其中我们使用了概率和为 1。这表明方程 (86) 成立。这检查了每个 CTMC 至少有一个满足方程 (87) 的率矩阵。但如果我们向前看——如果我们指定 ,是否存在对应的 CTMC?如果存在,它唯一吗?答案确实是肯定的。
定理 33(CTMC 的存在唯一性)
对任意率矩阵 (有界且关于时间 连续),存在唯一的马尔可夫链 (即唯一的一组转移概率 )使得方程 (87) 成立。
对感兴趣的读者,我们在附录 C 中提供自包含证明。该定理的关键要点是:对机器学习而言,我们可以构造一个率矩阵 (例如通过神经网络),并假设存在一个对应的唯一马尔可夫链。
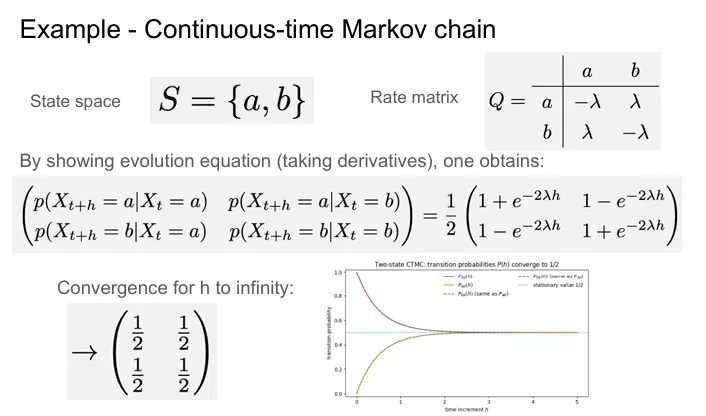
例 34(跳变率相等的两状态 CTMC)
设 ,考虑一个时间齐次 CTMC ,以常数速率 在两个状态之间切换:
则时间增量 上的转移概率在时间 处也是常数,由下式给出:
可以验证方程 (87) 成立,即这些转移概率确实是该率矩阵的正确值。事实上,这些速率非常直观:链以瞬时速率 持续翻转。指数项 捕捉了初始状态的记忆衰减。随着无限时间流逝,即 ,有
所以链忘记了它从哪里开始,并以概率 处于 或 。这个收敛随切换速率 越高越快。
模拟 CTMC。接下来,让我们思考如何模拟 CTMC 的轨迹。设 为步长, 为 上的初始分布(例如 是 上的均匀分布)。然后我们可以通过设 并设置
来迭代模拟。现在,如果我们知道 ,这就能行。然而,对所有除最简单 CTMC 外的 CTMC,我们通常不知道转移核,只能访问率矩阵 。但由方程 (87):
其中 是一个小 时可忽略的误差项。因此,对小 ,我们可以设
可以验证 对小 确实是一个有效的概率分布(由我们施加于率矩阵的条件)。因此,我们可以通过下式近似采样下一个点:
由于以上只是一个离散分布,我们可以通过标准网络从中轻松采样。这就是模拟 CTMC 的简单方法。
CTMC 模型。接下来,让我们定义如何在神经网络中参数化 CTMC。一个 CTMC 模型(或离散扩散模型)由 上的初始分布 和一个以参数 参数化的率矩阵网络 给出,使得对每个输入 ,模型返回率矩阵的一列:
我们希望模型返回整列,因为模拟 CTMC(方程 (88))时需要它,即采样下一个状态。
上述模型的一个复杂之处在于空间 可能非常大。特别地,,其中 是词表大小, 是序列长度。这种指数增长使得在内存中存储整列率矩阵基本上不可能—— 永远无法在计算机中表示。
因此,我们必须约束模型。具体地,所有现代 CTMC 模型都是因子化的(见图 18),这是一种有效稀疏化。
具体地,一个因子化 CTMC 模型由 CTMC 模型 给出,满足对所有 ,有
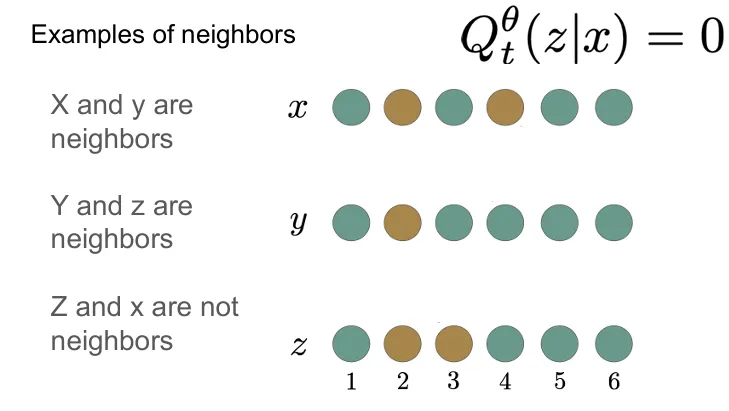
我们称与 仅在一个 token 上不同的 为 的邻居。我们可以把这样的因子化 CTMC 模型写为
其中 现在给出从 通过用 交换第 个元素得到的 的速率。每一行对应位置 的率矩阵。我们要求
我们可以通过神经网络的输出强制这些条件,例如 transformer 模型在序列长度 上,输出维度为 。注意因子化率矩阵使输出形状为 ——这个大小随维度线性增长(而非指数增长)。
模拟 CTMC 模型。要从 CTMC 模型采样,我们采样 ,并执行迭代,按方程 (88) 采样下一个状态。我们在算法 7 中给出算法。
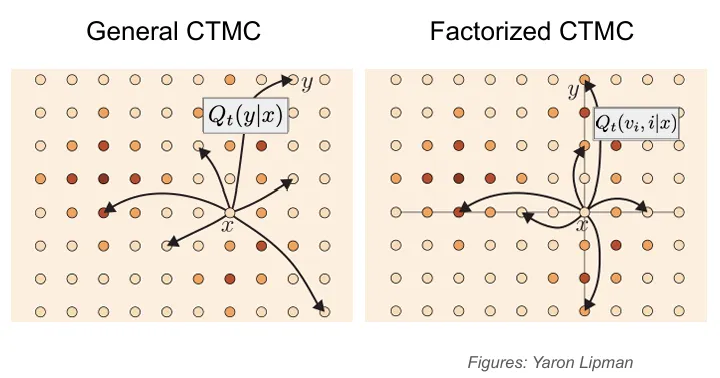
图 18:因子化 CTMC 模型示意。因子化 CTMC 仅在起点和终点仅差一个维度时有非零率 (这里 )。
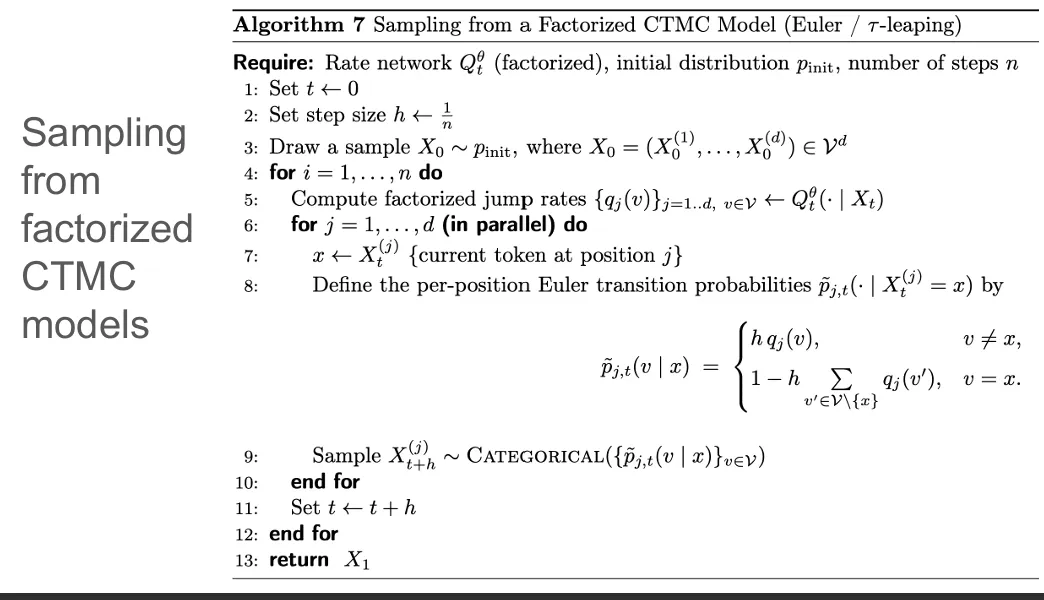
算法 7 从因子化 CTMC 模型采样
7.2 训练 CTMC 模型
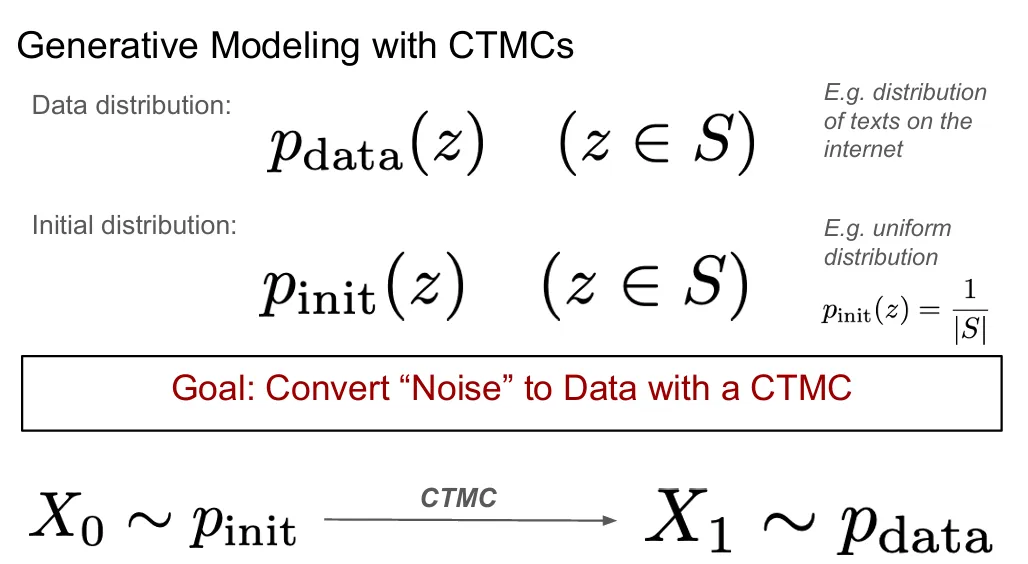
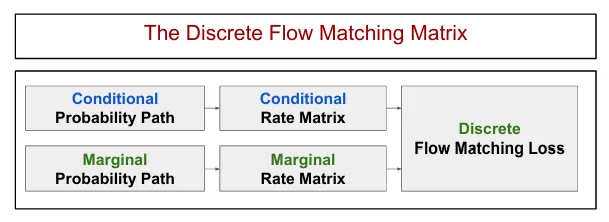
接下来我们讨论如何学习 CTMC 模型。原理与 Flow Matching 相同:(1) 我们构建一个在噪声和数据之间插值的概率路径;(2) 我们推导条件和边缘率矩阵;(3) 我们以无模拟的方式学习边缘率矩阵。我们将逐步解释这个配方。
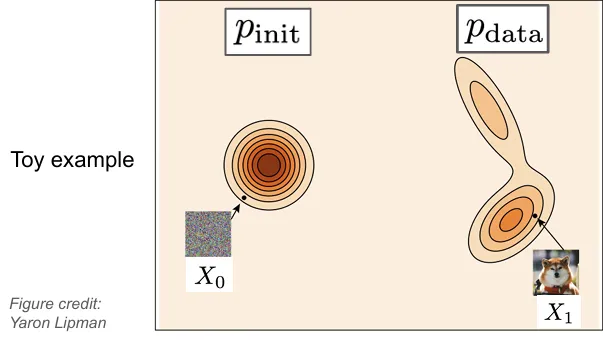
本节中,数据分布 是 上的分布,由概率质量函数刻画。即 ,,满足 。我们不知道 ,但可以访问训练时从 中以数据形式采样的样本 。例如全球网络上的所有文本。我们的目标是训练一个 CTMC 模型 ,使得
所以你可能意识到,这与欧几里得情形(见第 2、3 节)没有什么不同,只是我们用 CTMC 模型代替 flow/扩散模型。
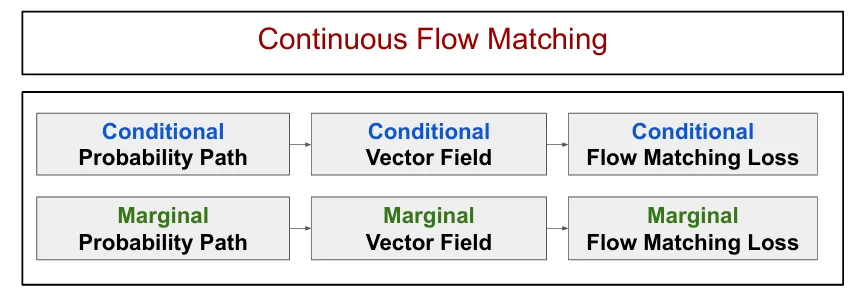
7.2.1 条件与边缘概率路径
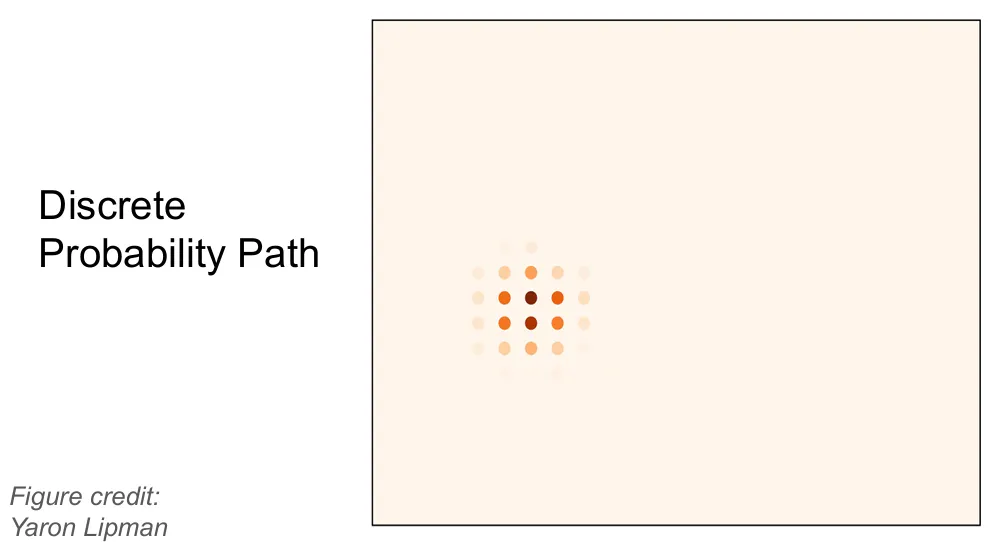
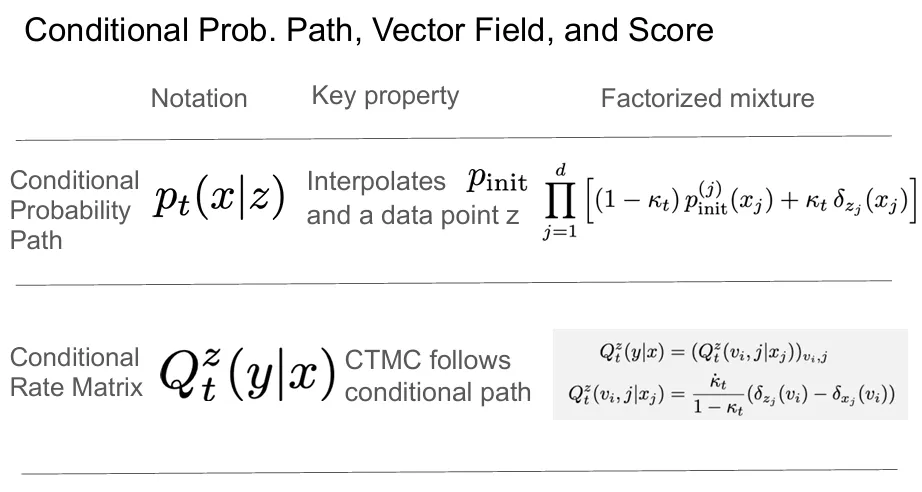
我们定义 为一个函数,使得如果 则 ,如果 则 。一个(离散)条件概率路径由一组分布 (,)给出,满足
与欧几里得情形类似,离散条件概率路径在与 无关的分布和质量全在 上的分布之间插值。
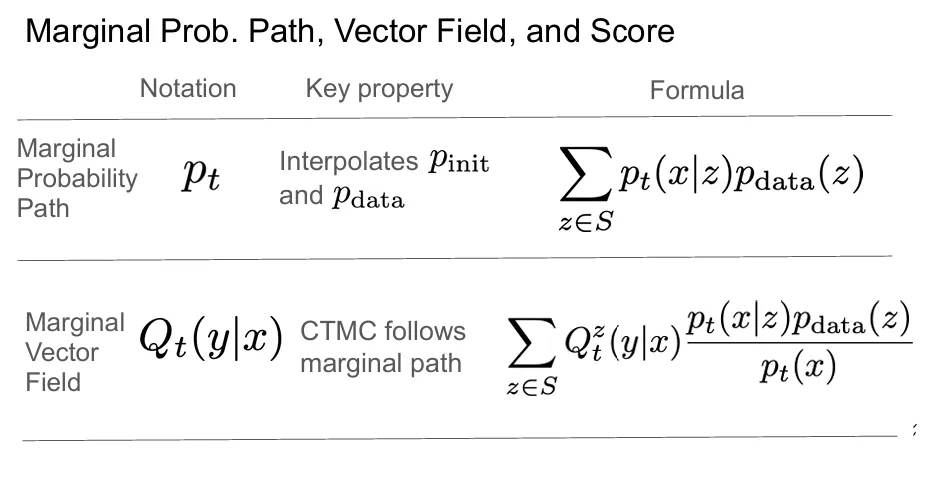
一个(离散)边缘概率路径由下式给出:
容易验证边缘概率路径在"噪声"和数据之间插值:
例 35(因子化混合路径,逐 token 独立噪声化)
设 ,令 为因子化初始分布。固定一个调度器 ,使得 ,且 。定义条件路径为
等价地,可以通过采样 i.i.d. mask 和噪声 ,然后设置
我们称以上为因子化混合路径。
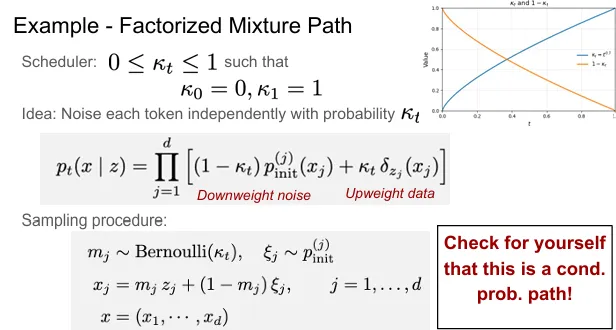
上述过程以概率 独立地"破坏"第 个位置的 token。 时 ,所有信息被破坏; 时 ,没有信息被破坏。
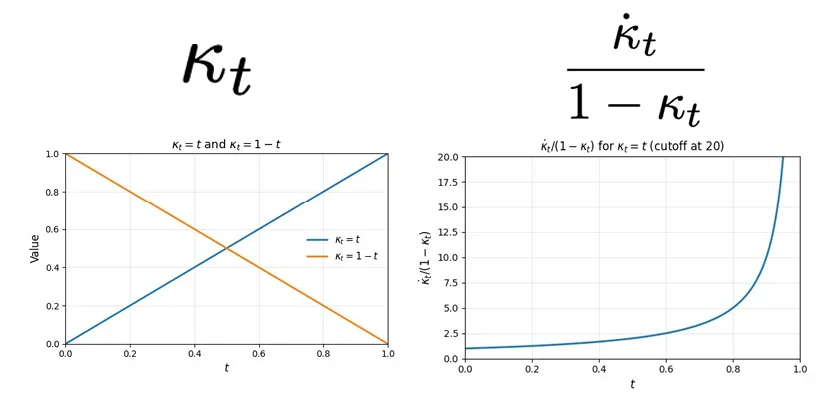
注意,这与高斯概率路径例 8 类似,信息以调度器 决定的速度逐步被破坏。然而,它与高斯概率路径也不同:因子化混合路径不移动/传输概率质量(因为我们在离散空间,没有方向)——它只是在一个分布中淡出,并在另一个分布中淡入。
图 19: 的离散概率路径示意。上排:在初始分布和狄拉克分布之间插值的条件概率路径。下排:在初始分布和数据分布(这里是棋盘图案)之间插值。注意与图 5 的异同。这里概率路径被"传送"(在初始分布上下注并在末端分布上提升)。
7.2.2 条件与边缘率矩阵
下一步,我们现在构建离散 Flow Matching 的训练目标。首先,我们构造条件率矩阵——类似于 Flow Matching 的条件向量场。令 为每个数据点 的率矩阵。
我们称它为条件率矩阵,如果
换句话说,条件率矩阵使其 CTMC "遵循"条件概率路径。条件率矩阵作为构建遵循边缘概率路径的边缘率矩阵的积木块。
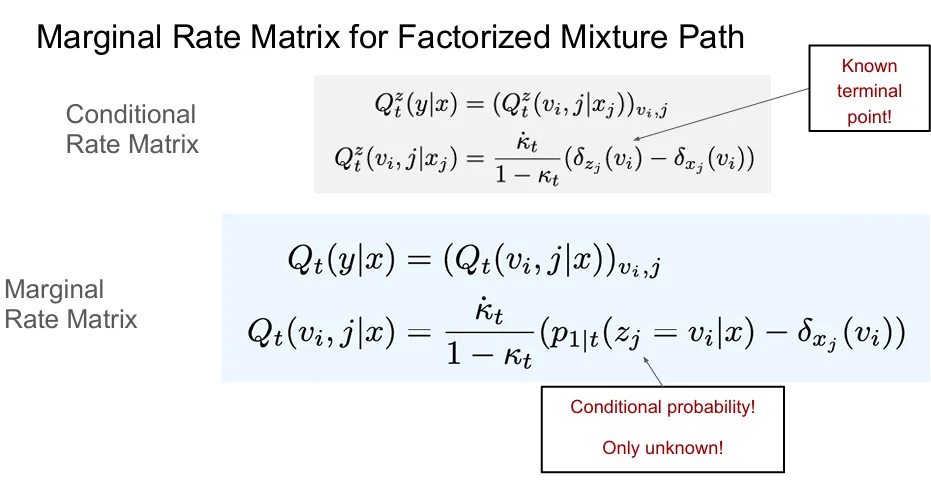
定理 36(离散边缘化技巧)
由下式定义的边缘率矩阵
是一个有效的率矩阵,满足以下条件:
特别地,由方程 (89) 有 ,即边缘率矩阵的 CTMC 把噪声转换为数据。
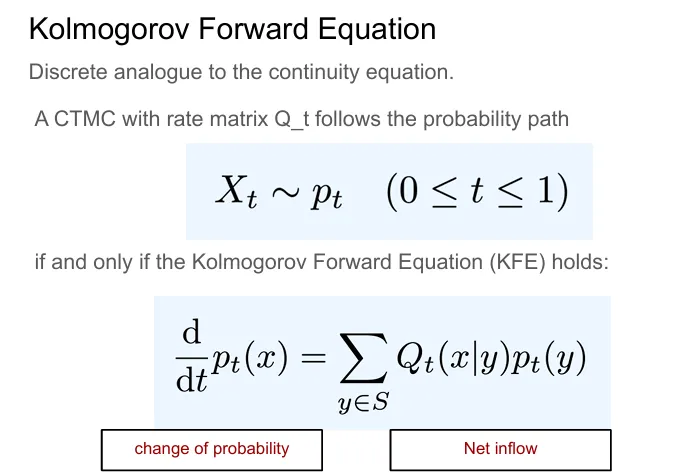
为证明这个结论,我们需要一个 CTMC 的基本方程,即所谓的科尔莫戈罗夫向前方程:
命题 2(科尔莫戈罗夫向前方程)
设 为 上的一组分布,。进一步,设 为带矩阵 和初始分布 的 CTMC。则对所有 , 当且仅当以下科尔莫戈罗夫向前方程(KFE)成立:
KFE 的证明。为证明 KFE 是必要的,假设 是 CTMC 的真实边缘,即对所有 有 。则我们可以计算:
其中 (i) 我们简单使用时间偏移,(ii) 我们使用转移概率的定义,(iii) 我们交换求和和导数,(iv) 我们使用率矩阵的定义(见方程 (87))。
接下来,为证明 KFE 是充分的,我们可以把 KFE 重写为矩阵形式:
其中在这个方程中我们把 视为向量, 视为矩阵。注意上面是关于向量空间 的线性 ODE。其初始条件固定为 ,如定理所述。因此,如果任何其他边缘集合 满足这个方程,我们由 ODE 的唯一性(见定理 3)知道可以得出 。这表明 KFE 也是充分的。
定理 36 的证明。使用 KFE,剩下要证明定理中定义的边缘率矩阵(见方程 (90))满足 KFE:
其中 (i) 由边缘概率路径的定义推出,(ii) 我们交换求和和导数,(iii) 我们对条件率矩阵使用 KFE,(iv) 我们乘并除以 ,(v) 我们使用边缘率矩阵 的定义。这表明 KFE 成立。结论由命题 2 得出。
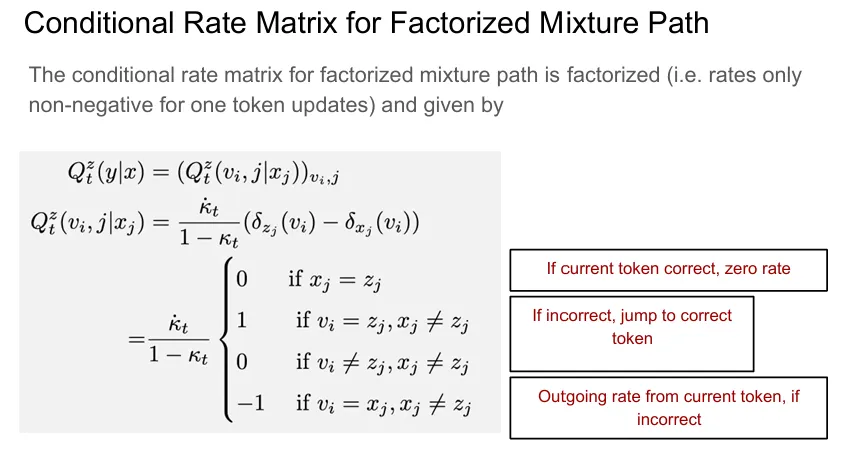
让我们现在推导因子化混合路径的条件率矩阵的具体例子。
例 37(因子化混合路径的条件率矩阵)
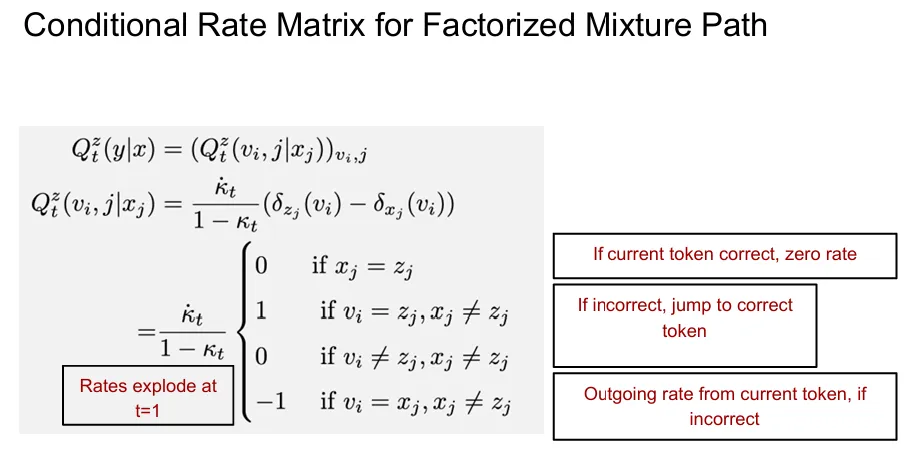
设 。因子化混合路径有一个因子化条件率矩阵,由下式给出:
注意这是一个非常简单的率矩阵:它只允许跳到 ——即如果任何 token 被更新,它必须跳到终端数据点 的 token 值——而且只有当我们还没在 时才跳到 。
证明。我们注意到因子化混合路径完全因子化为独立分量,因此建议的条件率矩阵也是。我们可以不失一般性地假设 。我们对每个维度进行计算。然后可以推导:
其中 (i) 使用 时因子化混合路径的定义,(ii) 通过取导数得到,设 ,(iii) 由简单代数得到,(iv) 由因子化混合路径的定义,(v) 由简单代数,(vi) 由 的事实,(vii) 由率矩阵的定义,(viii) 由简单代数。上面表明 KFE 成立,因此结论成立。
7.2.3 学习边缘率矩阵
本节中,我们推导训练 CTMC 模型的基本算法。由定理 36,训练 CTMC 模型 可以通过学习边缘率矩阵来实现。
本节中,我们只考虑因子化混合路径(见例 35),因为它是迄今为止大多数离散扩散/Flow Matching 模型使用的路径。这种情况下,边缘率矩阵有非常直观的形式:
定理 38(因子化混合路径的边缘化技巧)
因子化混合路径的边缘率矩阵是因子化的,形式为
其中 是条件概率:在给定完整噪声序列 的条件下,序列中第 个位置(第 个 token)等于 的概率。
证明。边缘率矩阵由下式给出:
现在,只要 和 不是邻居(差超过一个 token),(对每个 )。因此这种情况下 。这表明边缘率矩阵也是因子化的。于是有
其中 (i) 由条件率矩阵的公式得出(见例 37),(ii) 由 的事实得出,(iii) 由边缘化得出。证明完毕。
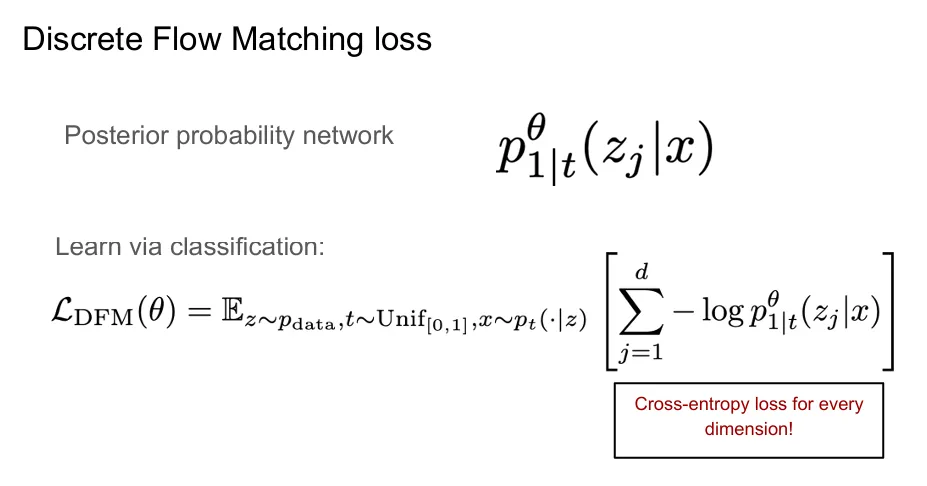
上一个定理值得注意:边缘率矩阵有效地是概率 的重参数化。这实际上不过是学习每个 token 位置 的分类器。换句话说,我们可以简单地定义一个去噪概率网络为
注意网络输出形状为 。可以通过简单 softmax 层获得每个 token 位置的概率。网络本身可以是标准的序列到序列网络,例如 transformer 工作(见 6.1.2 节)。
由于这只是位置 的分类器,我们可以对每个 通过交叉熵损失训练这样的网络。这给出了离散 Flow Matching 损失:
这很引人注目:要训练一个生成模型,我们只需要在每个位置 训练一个分类器。连续 Flow Matching 简化为简单回归训练(见算法 3),离散扩散模型也简化为简单分类训练。算法 8 中我们总结了训练算法。训练后,我们可以通过算法 7 采样。
例 39(Masked Diffusion 语言模型)
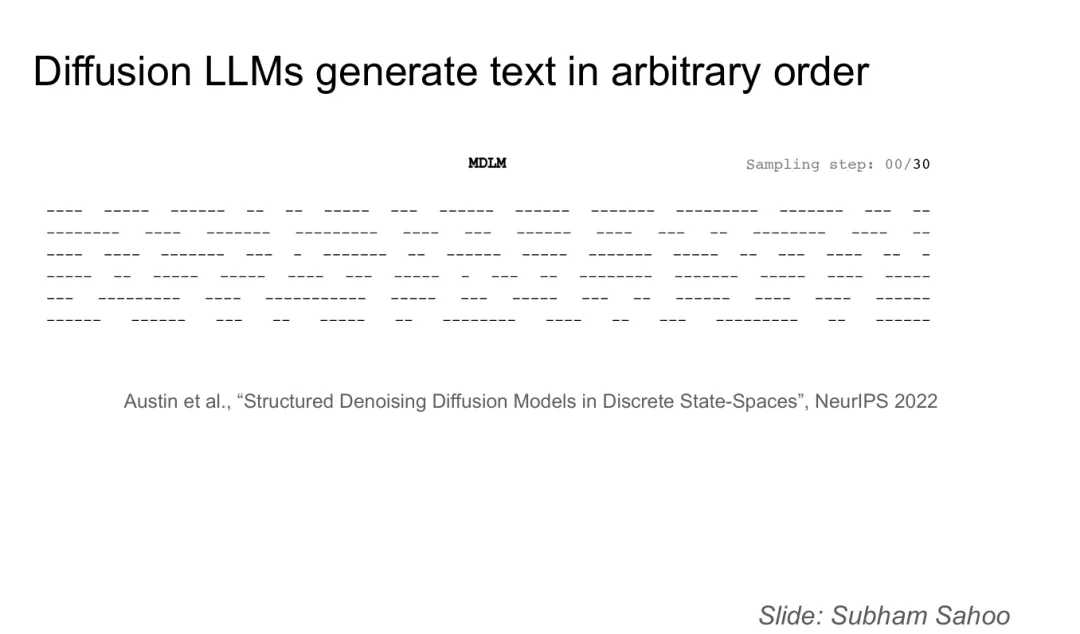
上述方法的一个具体案例是 masked diffusion 语言模型(MDLM)。MDLM 的思想是可以用语料库上的词表 和新 token [mask] 扩展词表,指示该 token 缺失(或被 mask)。具体地,设 ,初始点就是 [mask],即全被 mask 的序列。形式上,这设置 为上述框架中的初始分布。采样过程如图 20 所示。
图 20:Masked Diffusion 语言模型轨迹示意。
算法 8 训练因子化 CTMC 模型(离散扩散)
这完成了现在训练和采样 CTMC 模型的完整流水线,使我们能够生成文本等离散序列。当前最先进的离散扩散模型使用本工作中描述的配方,在网络规模数据上训练神经网络(通常是 transformer)。
备注 40(Generator Matching)
你可能想知道,为什么 flow/扩散模型的原理能如此无缝地翻译到离散状态空间。
事实证明,Flow Matching 的原理并非 flow 或甚至 CTMC 所独有。相反,这些是构建带马尔可夫过程的生成模型的一般学习原理。这引出了 Generator Matching 框架——一个扩展并统一离散和连续 flow 与扩散模型到一个框架的生成式建模框架。
Generator 是向量场 和率矩阵 的推广。马尔可夫过程和 generator 可以为任意数据模态和状态空间构建。例如,可以为光滑流形、混合状态空间(如联合文本和图像生成)、跳过程等其他马尔可夫过程构建模型。
来源:human five