文中视频转码失败,感兴趣的同学自行查看原文
01. 什么是 Human Data?
一名工人将衣物装入纸箱。要将这一操作示范转化为机器人训练数据,需要经过哪些步骤?
在上一篇文章中,我们提出了一个基本观点:对于灵巧机器人手而言,没有比人手更好的老师。我们介绍了一套pipeline,通过采集人类裸手操作示范,并在仿真环境中将其重定向到机器人手上。
此后,我们持续开发这套pipeline,推动其面向真实工业场景部署。本文将分享我们的最新进展,解释为什么要投入 Human Data,并探讨如何将人类示范转化为机器人能够在工厂环境中使用的技能。
视频1:Human Data 采集。 展示为机器人训练数据录制的人类操作示范。
02. 为什么需要 Human Data?
Human Data 提供了一种可扩展的方式,使机器人能够从人类在真实工业工作中已经掌握的技能中学习。我们的目标是将熟练工人的操作经验转化为可重复使用的数据资产,帮助企业以此训练能够执行工业任务的机器人。
Human Data 的潜力来自两个相互补充的优势:一是跨任务、跨环境扩展数据采集规模;二是在不同机器人本体之间复用已采集的数据。目前,我们从工业任务的定向示范采集入手,逐步建立可靠的数据基础,为未来更大规模的数据采集与复用做好准备。
扩展数据采集规模。 人类操作示范能够从以下几个方面提升训练数据的规模与多样性:
降低采集成本。 遥操作需要机器人本体、控制接口,以及能够熟练使用该接口的操作人员。直接记录人类执行任务的过程,可以减少对这些资源的依赖,使相同预算能够采集更多示范数据。
提高采集效率。 直接记录人类操作可以提升数据采集吞吐量。Chi 等人的研究表明,在杯子排列任务中,裸手示范的数据采集吞吐量约为 SpaceMouse 遥操作的 6.6 倍。
更容易在真实环境中采集。 在工业现场部署机器人和遥操作系统,会带来较高的物流与运维复杂度。基于摄像头的人类动作采集方案更容易安装和运行,因此更适合在不同地点、工作流程和作业条件下采集示范数据。
扩展跨机器人复用能力。 将人类数据采集与面向特定机器人的动作重定向分离,可以让同一份示范数据应用于不同机器人手和硬件配置。可复用的数据处理pipeline能够减少为每种机器人本体重新采集数据的需求。当然,每种机器人仍然需要进行适配和验证,但原始录制数据可以作为共享的数据资源。
03. 什么样的 Human Data 才是好的?
我们首先针对特定工业任务,有目的地采集操作示范,以此明确哪些数据真正有助于机器人学习,再逐步扩大采集规模和数据复用范围。
对于我们关注的工业任务,高质量 Human Data 必须保留足够的信息,以便在整个示范过程中重建手与物体之间的交互细节。这首先取决于数据采集:摄像头覆盖范围、标定和时间同步必须支持准确的 3D 重建,包括手或物体部分被遮挡的情况。
因此,我们围绕机器人需要学习的具体任务,将数据采集与处理作为一个整体进行设计,并将数据质量视为端到端的要求。
04. RLWRLD 如何使用 Human Data?
我们采用端到端 Human Data pipeline,将人类熟练操作示范转化为用于机器人模型微调的数据集。整个流程包含四个阶段,每个阶段都以前一阶段的输出为基础:
人类视频采集(Human Video Capture): 通过同步、标定的多视角视频记录人类操作示范。
3D 动力学重建(3D Dynamics Reconstruction): 将 RLHND(读作“Real Hand”)对手部姿态、接触和作用力的估计,与物体的 3D 扫描结果相结合,重建手与物体之间的交互。
高精度机器人动作生成(High-Precision Robot Action Generation): 将重建得到的动力学信息重定向到目标机器人,生成机器人动作轨迹。
4D+ 上下文合成(4D+ Context Synthesis): 基于 Isaac Sim 渲染生成与这些动作相匹配的视觉观测。我们也在研究将 World Model 作为一种新的上下文合成方案。结合任务指令,这些观测和动作共同构成机器人模型训练数据集。
我们的目标是生成包含动作、观测和语言的完整数据集,直接用于机器人模型微调,同时确保机器人运动不仅仅是在视觉上看起来合理。
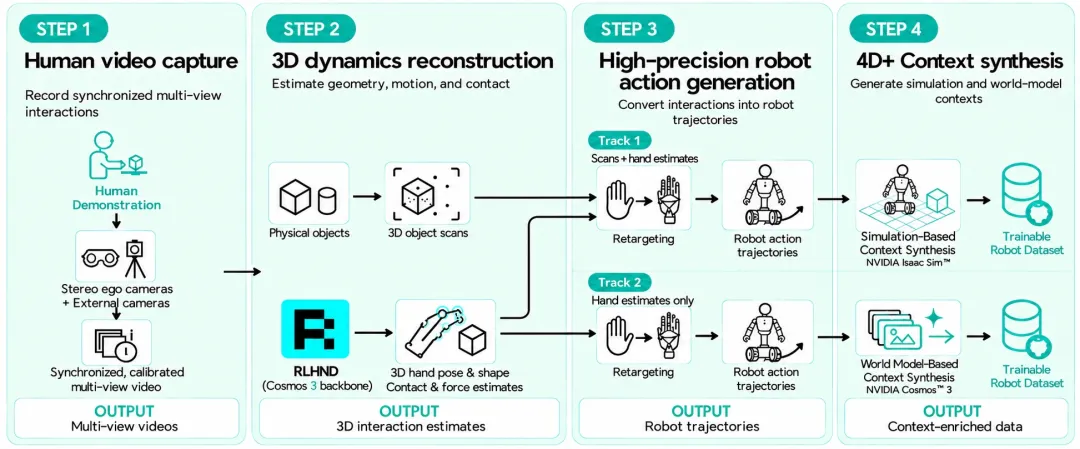
图1:Human Data Pipeline。 人类示范依次经过四个阶段:视频采集、3D 动力学重建、机器人动作生成和 4D+ 上下文合成。
接下来,我们将逐步介绍 Human Data pipeline 的各个环节。
Step 1. 人类视频采集
可靠的重建始于数据采集方式。针对每一项真实工业任务,我们首先搭建采集系统,确保能够保留重建所需的手与物体交互信息。
我们的方案结合了双目第一视角摄像头(Stereo Egocentric Cameras)和外部视角摄像头(Exocentric Cameras)。外部摄像头的数量和安装位置取决于具体任务和现场条件。
双目第一视角画面能够提供近距离观测,用于手部追踪和深度估计。当手部被遮挡,或者移动到第一视角摄像头的视野之外时,外部视角画面可以提供补充信息,从而提高追踪的连续性和重建精度。
我们使用自研采集软件对第一视角和外部视角的录像进行时间同步,使不同视角的画面在时间上对齐,以支持多视角重建。
Step 2. 3D 动力学重建
Step 1 得到的是经过标定和时间同步的示范视频。Step 2 则需要将这些视频转化为交互过程的 3D 记录:包括手部如何运动、在哪里与物体接触、施加了多大的作用力,以及物体如何对此产生响应。
为支持这一重建过程,我们首先对物体进行 3D 扫描,再使用自研工具 RLHND 重建手部运动。
完成物体扫描后,我们利用 RLHND 重建双手及其与物体之间的交互。RLHND 从双目第一视角录像中提取单目视角画面,逐帧估计双手在公制相机坐标系下的 3D 姿态和形状,同时预测每只手与物体的接触位置及施加的作用力。
RLHND 架构
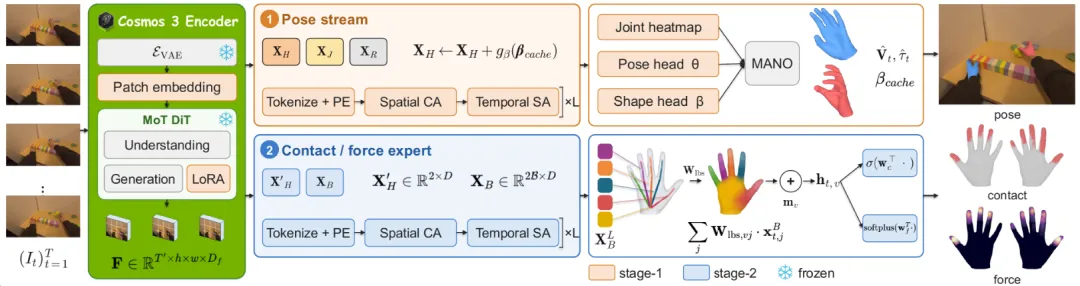
图2:RLHND 架构。 预训练 Cosmos 3 backbone 通过其条件帧接口接收每段视频,并通过可训练的 Patch Embedding 和 LoRA Adapter 进行适配。姿态分支(第一阶段)预测 MANO 手部参数和公制相机坐标系下的平移量;接触与作用力专家(第二阶段)在冻结姿态分支后进行训练,预测手部表面每个顶点的接触概率和作用力。
使用 NVIDIA Cosmos 3 作为视频编码器。
从单一视角追踪手部存在很大的歧义:手指会相互遮挡,物体会遮住部分手部,而且深度信息需要从图像中推断。经过大规模数据训练的视频扩散模型,已经学习到了丰富的手部运动和物体交互先验。
我们在 RLHND 中使用预训练的 NVIDIA Cosmos 3 模型,作为确定性的片段级特征提取器。我们没有在人工设置的零噪声水平下,将干净视频输入去噪路径,而是使用 Cosmos 3 的条件输入接口来处理干净的上下文帧。这种方式使输入形式与编码器在预训练期间接触的数据形式保持一致。
我们通过轻量级 LoRA 微调对模型进行适配,并为每段 81 帧的视频片段提取时空特征网格。
两个专家分支。
我们利用这些特征构建姿态专家分支,用于预测 MANO 手部参数,包括受到人体解剖结构约束的关节角度、在整个视频中保持一致的手部形状,以及公制 3D 平移量。这些约束能够避免只能弯曲的手指关节出现扭转等不合理运动。
在冻结姿态分支后,我们再训练一个独立的触觉专家分支,预测手部表面各顶点的接触概率和作用力。由于带有压力标注的数据远少于姿态数据,将两个分支分开训练,可以在引入触觉监督的同时,避免损害手部姿态估计的精度。
视频2:仅使用单个头戴摄像头运行 RLHND(1 倍速)。查看原文
左侧:输入视频及估计得到的手部网格(蓝色代表左手,红色代表右手)。
中间:预测得到的手部接触区域,展示在展开后的手部表面上。
右侧:预测得到的作用力分布(颜色越深,作用力越大)。
底部:随时间变化的每只手所受总作用力。
当工人抓住袋子提手并向外拉动时,接触和作用力主要集中在指尖;松开提手后,两者均降至零。
实验结果。
在公开基准 ARCTIC、HOT3D 和零样本 EgoDex 上,RLHND 在手部姿态估计以及接触与作用力估计方面均达到了 SOTA 精度。
为了评估模型在我们自身采集环境中的表现,我们将 RLHND 基于单个头戴摄像头得到的估计结果,与多视角采集系统提供的参考测量结果进行比较。
实验针对真实环境中的袋子提手打结任务,共评估 201 个 Episodes,包含双手约 15 万帧数据。RLHND 仅使用头戴式 ZED Mini 摄像头中的一路视频,其估计结果与四台固定式 ZED X 双目摄像头(共八个视角)三角测量得到的手部关键点高度吻合。
具体而言,平均腕部位置差异为 1.7 cm,手部关节运动误差(PA-MPJPE)为 0.7–0.8 cm。在 96% 的帧中,位置差异控制在 3 cm 以内,并且在所有帧中都成功保持了对双手的追踪。
由于多视角参考结果本身也存在数毫米的误差,因此报告的差异同样包含参考测量的不确定性。
在单张 H100 GPU 上,RLHND 的处理速度约为 39 FPS;在 A100 上约为 20 FPS。在 H100 上,其处理速度超过了 30 FPS 视频的实时要求。
Step 3. 高精度机器人动作生成
Step 2 提供了每段示范的精确 3D 记录,包括手部如何运动、接触了什么,以及物体如何响应。但这些记录描述的仍然是人手的运动,机器人无法直接执行。因此,在 Step 3 中,我们需要将人类运动转换为特定机器人的动作。
为了给指定机器人生成动作,我们将重建得到的手物交互(HOI)动力学信息与机器人的 URDF 模型相结合。URDF 定义了机器人的连杆、关节及其运动限制。我们将人类运动映射到这一模型上,生成机器人能够执行的轨迹。这些轨迹的质量已经接近遥操作数据。
这一阶段的精度取决于前面几个环节的质量。我们不是从粗略的 2D 估计开始生成动作,而是直接利用精确重建的 3D 动力学信息生成机器人动作。因此,最终得到的机器人数据更加精确,甚至可以让模型仅使用几百个 Episodes 就在微调过程中实现收敛。
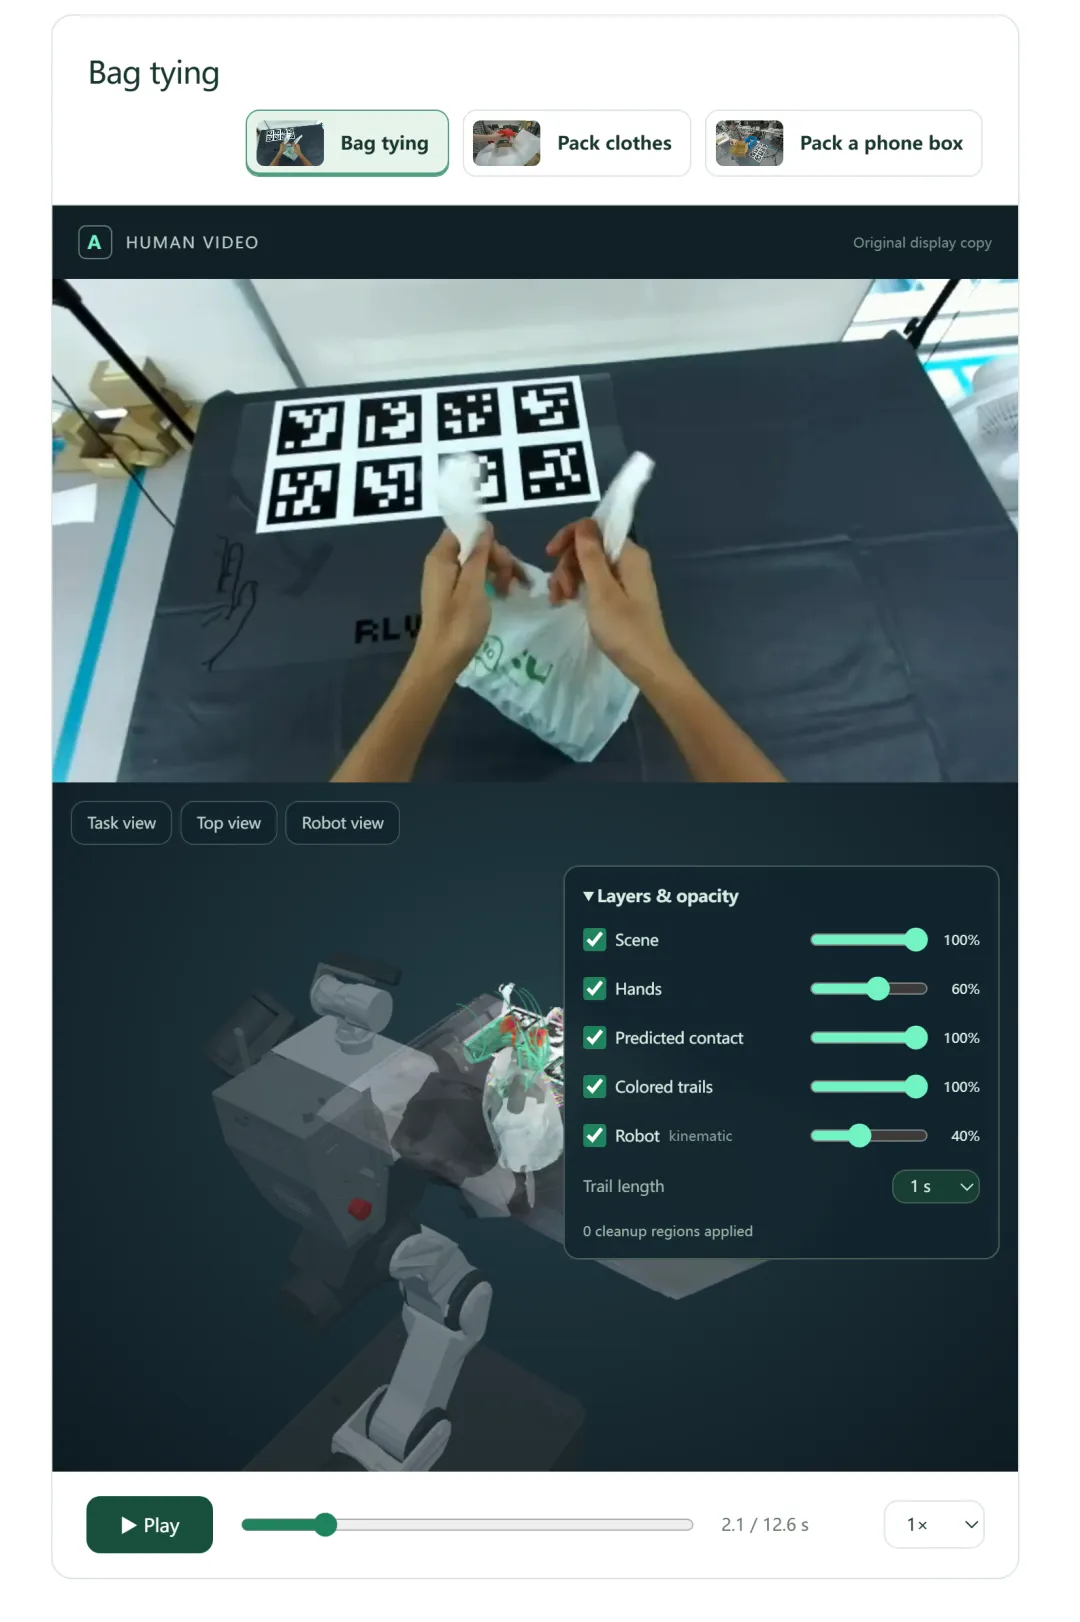
通过原始视频、重建场景、手部运动、预测接触区域、运动轨迹以及生成的机器人动作,探索整套pipeline。选择视频并切换不同的数据图层,即可查看各个组成部分。点击 Play 可以同步播放,还可以调整播放速度,以便仔细观察。
Step 4. 4D+ 上下文合成
为了构建训练数据集,我们还需要机器人所看到的视觉观测,以及描述任务的指令。
在 Step 4 中,我们以场景参考和任务文本描述为条件,合成与 Step 3 生成的动作相匹配的视觉观测。目前,我们使用基于 NVIDIA Isaac Sim 的渲染方案,同时也在研究将 World Model 作为一种新的上下文合成方法。
最终,这一阶段将动作、观测和语言对齐,形成用于机器人模型微调的数据集。
在仿真环境中渲染机器人观测
我们的仿真pipeline分为三个阶段:轨迹准备、观测渲染和动作标签对齐。
首先,我们将追踪得到的手物运动转换到机器人的坐标系中,并对轨迹的位置、朝向、初始姿态和速度进行数据增强。为了保持手与物体之间的相对几何关系,我们对二者进行整体变换,同时过滤掉存在追踪或动作重定向错误的 Episodes。
接下来,我们使用 3D Gaussian Splatting 重建工作空间,并在 Isaac Sim 中回放经过重定向的轨迹。经过标定的虚拟双目摄像头从目标机器人的视角采集观测。
最后,我们根据真实机器人的控制延迟调整动作标签,并以 LeRobot 格式导出 Episodes,用于模型微调。
瓶颈:物体运动重建
可靠的 3D 物体位姿估计成为整个pipeline中的一个瓶颈。对于衣物等可变形物体,问题更加复杂:要复现这类物体的交互过程,不仅需要捕捉位置和朝向,还必须记录其形状变化。
这促使我们探索一个新的研究方向:使用 World Model 根据机器人运动生成场景响应,而不再显式重建每一个物体。
新方案:由机器人渲染引导的 World Model
我们此前的工作《Robot-Factored World Models via Robot Rendering》为这一方案奠定了基础。
该方法通过三个输入条件控制视频生成:
机器人渲染(Robot Rendering): 指定机器人的形状和运动。
静态场景参考(Static Scene Reference): 提供物体和背景的外观信息。
文本提示(Text Prompt): 描述机器人正在执行的任务。
对于人类示范,我们首先在 Isaac Sim 中渲染经过重定向的机器人运动,再通过 Inpainting 移除第一帧示范画面中的人类,生成场景参考。World Model 随后根据这些条件生成机器人与场景之间的交互过程。
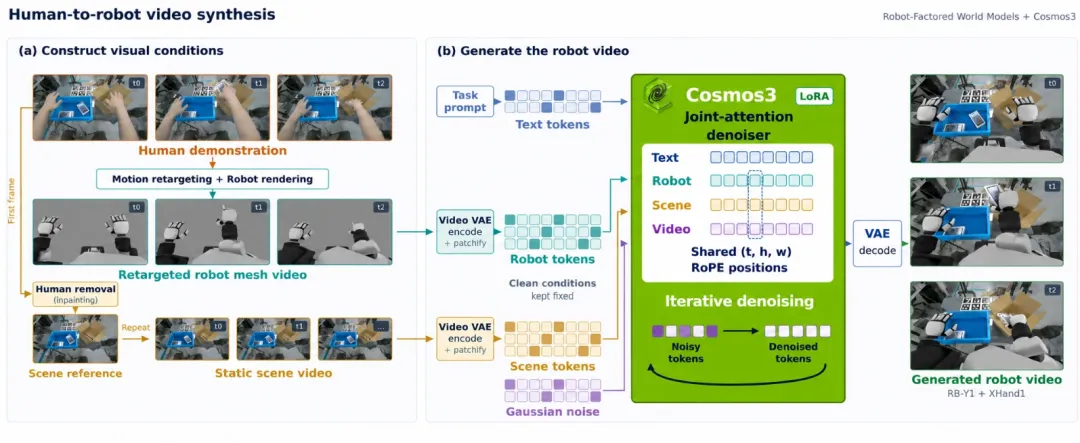
图3:基于 World Model 的上下文合成。
首先将人类运动重定向到机器人,并渲染为视频。随后对第一帧示范画面进行 Inpainting,移除其中的人类,再将该画面重复生成静态场景视频。
这两段视频分别作为条件输入编码至 Cosmos 3。模型通过 Joint Attention 对视频 token 进行去噪,最终解码生成机器人操作视频。
从 WAN 到 NVIDIA Cosmos 3
在最初的工作中,我们使用 DROID 和 RoboCasa 的机器人视频数据,通过 Low-Rank Adaptation(LoRA)对 WAN 进行适配。
场景参考、机器人渲染和生成视频分别构成独立的 token 序列。对应位置共享空间和时间 RoPE(Rotary Position Embedding),并通过 Joint Attention 建立不同序列之间的联系,使模型能够理解渲染出的机器人所处的位置和运动方式,以及正在生成的场景内容。
在此基础上,我们进一步比较了 Wan2.1-14B、Cosmos3-Nano 和 Cosmos3-Super。
三个模型均使用相同的 DROID 和 RoboCasa 数据进行微调,并在相同视频片段上进行评估,同时保持场景参考和机器人渲染输入一致。
视频4:WAN 与 Cosmos 3 在 DROID 任务上的表现。
对比真实参考视频与模型生成的视频序列,涵盖抽屉打开、物体抓取和钢笔释放等任务,展示机器人与场景交互过程中物体运动生成效果的差异。
我们使用 PSNR、SSIM 和 LPIPS 衡量视觉重建质量。对于 DROID 数据集,我们还采用了改编自 Physics-IQ 的 Motion IoU 指标,评估生成视频与参考视频在运动位置和时间上的匹配程度。
在大多数评估指标上,NVIDIA Cosmos 3 均优于 WAN。
在 DROID 数据集上,Cosmos3-Super 获得了最高的 PSNR 和 Motion IoU,以及最低的 LPIPS,而 WAN 的 SSIM 最高。
在 RoboCasa 数据集上,Cosmos3-Nano 在三项重建指标上均取得了最佳结果。
表1:DROID 和 RoboCasa 上的视觉重建与运动对齐结果。
在相同的 DROID 和 RoboCasa 数据上微调 Wan2.1-14B、Cosmos3-Nano 和 Cosmos3-Super,并使用相同视频片段以及匹配的场景参考和机器人渲染输入进行评估。加粗数值表示对应数据集上的最佳结果。↑/↓ 分别表示数值越高或越低越好。Motion IoU 仅在 DROID 上报告。
随后,我们将 Cosmos3-Super 应用于经过重定向的人类示范,以探索这一方案在 Human Data pipeline 中的应用潜力。
以下案例展示了两项值得关注的能力:在不显式重建物体的情况下合成可变形物体交互,以及无需针对不同机器人本体进行额外训练,就能生成适用于不同机器人形态的观测。
1. 合成可变形物体交互
在衣物打包案例中,机器人渲染指定手部运动,而 World Model 则负责生成布料的外观和运动。
这些定性结果展示了该方案的潜力:在不需要显式进行物体级 3D 扫描或详细材料建模的情况下,合成涉及可变形物体的视觉观测。这解决了基于仿真的数据处理pipeline中的一个关键难题。
视频5:合成衣物打包交互。
机器人渲染引导 ALLEX 的手部运动,而 Cosmos3-Super 则在不需要显式物体级 3D 扫描或详细材料建模的情况下,合成布料的外观和运动。
2. 扩展到不同机器人本体
我们将同一个模型应用于重定向到 ALLEX 和 RB-Y1 的操作示范,没有针对这两种机器人进行额外训练。
对于 RB-Y1,我们测试了三种不同的灵巧手配置:XHand1、Wuji2 和 Tesollo,并分别使用对应机器人的渲染结果作为生成条件。
衣物打包和纸箱转移案例展示了 World Model 在不同机器人平台和手部配置之间复用的潜力。下一步,我们将评估这些生成的视觉观测能否进一步改善策略学习效果和真实世界任务表现。
视频6:使用 ALLEX 合成纸箱转移交互。
Cosmos3-Super 根据重定向后的 ALLEX 运动生成纸箱转移序列,无需针对 ALLEX 进行额外训练。
视频7:跨不同机器人手部配置的上下文合成。
同一个 World Model 根据不同机器人配置的渲染结果,分别为搭载 XHand1、Wuji2 和 Tesollo 灵巧手的 RB-Y1 生成纸箱操作交互。
05. 总结与下一步计划
我们的 Human Data pipeline 能够将熟练的人类操作示范转化为适用于多种机器人本体和手部配置的机器人训练数据。
我们在数据采集阶段保留 3D 信息,并在后续的重建、动作重定向和上下文合成过程中持续保持这一精度。Cosmos 3 作为先进的 World Model,已经帮助我们实现更准确的手部追踪,并合成更加真实的机器人观测。随着这类模型不断进步,我们计划将其能力融入pipeline,以更大规模生产精度更高的训练数据。
下一步,我们将重点提高整套pipeline的效率和工业部署的实用性。在保持可靠操作所需精度的同时,进一步优化示范数据采集方式,并降低将人类示范转化为机器人训练数据所需的计算成本。
随着这项工作不断推进,我们也将持续分享技术进展、工程经验和实验结果。
参考文献
Universal Manipulation Interface: In-The-Wild Robot Teaching Without In-The-Wild Robots
Chi, C., Xu, Z., Pan, C., Cousineau, E., Burchfiel, B., Feng, S., Tedrake, R., & Song, S.(2024)。arXiv:2402.10329。
RLHND: Video Foundation Models as Physically Grounded Hand Trackers for Robot Learning
Moon, S., Jeon, S., Kim, S., et al.(2026)。arXiv:2610.09455。
Robot-Factored World Models via Robot Rendering
Kim, B., Kim, T., Cha, H., & Joo, H.(2026)。arXiv:2607.22535。
Wan: Open and Advanced Large-Scale Video Generative Models
Team Wan, Wang, A., Ai, B., et al.(2025)。arXiv:2503.20314。
Cosmos 3: Omnimodal World Models for Physical AI
NVIDIA(2026)。arXiv:2606.02800。
来源:human five