摘要
VLA对经过网络数据预训练的视觉语言模型进行适配,使其能够输出机器人动作,从而将网络知识迁移到物理控制中。不到四年的时间里,该领域已经从首个 VLA——RT-2,发展到能够在单张消费级 GPU 上微调的开源模型,以及能够在未见过的住宅中完成清洁任务的专有通用模型。
本文综述了 2022 年 12 月至 2026 年 10 月期间的 88 项工作,主要涵盖机器人操作和导航,同时涉及 Humanoid 控制、World Action Model 和评测。我们沿着 VLA 的生命周期,从模型设计、训练到部署,通过七个维度展开讨论。
模型设计包括:(a)输入与记忆,即模型观察什么;(b)架构,即模型的 pipeline 如何构建;(c)动作输出,即模型如何生成运动控制指令;(d)中间预测,即除动作外还预测什么,范围从推理步骤到未来观测。训练包括:(e)预训练数据,即机器人、网络、人类和仿真数据的组合;(f)后训练,即针对目标机器人进行适配。部署包括:(g)实时执行,即使模型跟上机器人的运行节奏。
我们沿这七个维度分析了 22 个模型,并整理了它们的训练数据、模型规模、推理速度和硬件配置。由此呈现出三个趋势:
训练数据来源更加多样,从约 10,000 小时的遥操作机器人数据(π0),扩展到社区采集的 23,000 条 episode(SmolVLA),以及 20,000 小时的第一视角人类视频(GR00T N1.7)。
模型规模出现分化:近期大多数模型拥有 30 亿至 70 亿参数,同时出现了一批参数量低于 10 亿、能够在消费级 GPU 上运行的新模型。
能够同时处理操作和导航的通用 VLA 正在出现,例如 UniVLA 和 Qwen-VLA。
我们还将 VLA 与既预测动作、又预测未来观测的 World Action Model 进行了比较。本文梳理了相关证据:一些在 Benchmark 上取得接近满分成绩的 VLA,在物体或相机位置发生轻微变化时便会失败。最后,我们提出了有待进一步研究的问题。
1 引言
LLM 和 VLM 从互联网规模的数据中获取广泛的语义知识。相比之下,机器人学习过去通常针对每种机器人、任务和环境分别训练一个策略,所用数据集的规模也要小几个数量级。
VLA 将两者连接起来。VLA 以预训练 VLM 为基础,通过微调使其能够在输出文本的同时输出动作,或直接输出动作。“VLA”这一术语伴随 RT-2 的提出而出现。RT-2 将机器人动作表示为文本 token,使用机器人轨迹和网络数据对 VLM 进行联合微调,并展示出涌现的语义泛化能力。
此后,VLA 生命周期各个阶段的设计空间都在不断扩大。在模型层面,动作头从离散 token 扩展到 Diffusion 和 Flow Matching,整体 pipeline 从单一网络发展出双系统和分层设计。在训练层面,数据从数万条遥操作 episode 增长到数万小时的多机器人经验,并辅以人类视频、仿真数据和机器人自身的自主尝试。在部署层面,计算频率只有几赫兹的模型,仍需要以数十赫兹的频率平滑控制机器人。
概览。 第 3 节提出的七个设计维度贯穿 VLA 的整个生命周期。
模型:它是什么。
输入与记忆: 模型观察什么,包括相机、语言、机器人状态和额外条件输入,以及它保留多少历史信息。
架构: 整个 pipeline 的结构,而非骨干网络的结构:单一网络、由慢速 VLM 和快速动作模块组成的双系统,或由分别训练的模型组成的层级结构。
动作输出: 模型如何将视觉语言特征转化为运动控制指令,包括离散 token、Diffusion、Flow Matching 和回归,通常以未来动作块的形式输出。
中间预测: 除动作之外,模型还预测什么,包括文本形式的推理(思维链、子任务),或由世界模型预测的未来观测;后者提供有关物理动力学的额外训练信号。
训练:它如何学习。
预训练数据: 模型从什么数据中学习,包括机器人示范、跨机器人本体汇集的数据、网络数据、人类视频、仿真数据和生成轨迹,以及如何组合这些数据。
后训练: 如何针对目标机器人或任务对模型进行适配和改进,从微调方案到利用部署经验进行 RL。
部署:它如何运行。
- 实时执行: 通过 Action Chunking、异步推理,以及远程服务器和机器人之间的计算分工,让运行频率只有几赫兹的模型仍能平滑控制机器人。
由此呈现出三个趋势:
训练数据更加多样: 从约 10,000 小时的遥操作机器人数据(π0),到社区采集的 23,000 条 episode(SmolVLA),再到大规模第一视角人类视频(GR00T N1.7 使用了 20,000 小时)。
模型规模出现分化: 近期大多数模型拥有 30 亿至 70 亿参数,同时出现了一批参数量低于 10 亿、能够在消费级 GPU 上运行的新模型。
通用 VLA: 能够同时处理操作和导航的模型正在出现,例如 UniVLA 和 Qwen-VLA。
本综述有五个目标:
建立基于生命周期的分类体系。 我们沿七个设计维度组织 VLA 研究,覆盖从模型设计、训练到部署的整个生命周期(第 3 节),使读者能够根据新模型在各维度上的选择,将其放入这一体系中。表 3 按照这一方式整理了 22 个主要模型。
并列讨论操作与导航。 大多数 VLA 综述聚焦于操作。我们将导航 VLA 作为一条并行的研究脉络(第 5 节),涵盖移动和 Humanoid 全身控制(第 6 节),并讨论近期操作与导航的融合(第 7 节)。
提供以数据为中心的定量视角。 对于每项工作,我们提取论文报告的训练数据,并绘制该领域机器人 episode 数量和参数量的变化趋势(图 6、表 5 和表 6)。
比较 VLA 与 World Action Model,并讨论公平评测。 我们将 VLA 与 World Action Model 进行比较(第 8 节),梳理标准 Benchmark,以及近期为使 VLA 评测更加公平、更能预测真实世界表现而做出的努力(第 9 节)。
讨论开放问题。 其中包括我们直接遇到的一个报告问题:相当多的论文使用彼此不兼容的单位描述训练数据,或者完全没有量化训练数据(第 10 节)。
图 1 将主要工作放在同一条时间线上。
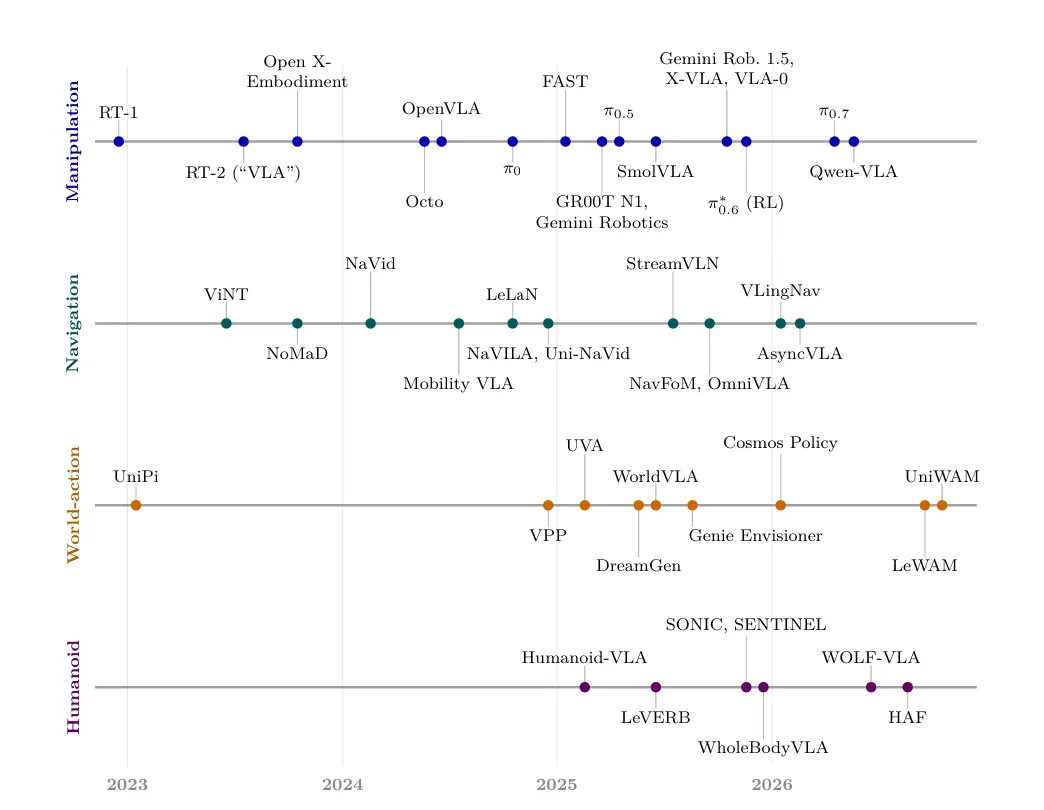
图 1:本文综述的文献中的里程碑工作,按首次发布到 arXiv 的时间排列。操作 VLA、导航 VLA、World Action Model 和 Humanoid 全身控制基本上沿着各自的方向并行发展。第 4 至第 8 节讨论了这些工作。
范围与筛选。 我们纳入以视觉和语言为条件、输出机器人动作或动作层级中间结果的学习型策略工作。候选文献的寻找方式包括:从广泛使用的 VLA 出发,追踪其参考文献和引用它们的工作,并搜索 arXiv。因此,本文是一篇结构化综述,而非系统性综述。
满足以下三个条件之一的工作会在正文中讨论:
提出原创性想法,例如新的动作表示、架构或训练信号;
在核心问题上取得明确进展,包括操作、导航或移动,例如真实机器人成功率大幅提升,或获得新的能力;
为社区提供可供其他研究继续使用的工具、数据集、Benchmark 或方法。
主要带来小幅性能提升,或将现有方法应用到新领域的工作,会被引用,但不展开讨论。我们排除了仅发布消息、未披露方法细节的系统;如果基础模型的方法已经发表,则会纳入发布说明中描述的版本更新,例如 GR00T N1.5 至 N1.7。
少量非 VLA 的先驱工作也被纳入,包括 RT-1、ACT、Diffusion Policy、PaLM-E 和 Open X-Embodiment,因为后续 VLA 直接建立在这些工作的基础上。
本文涵盖 2022 年 12 月至 2026 年 10 月期间的 88 项工作:5 项基础工作、38 项操作 VLA、12 项导航 VLA、5 篇综述,以及 28 项关于 Humanoid 控制、World Action Model 和评测的工作。表格中的预印本以星号()标记。训练数据取自各篇论文的实验部分;如果论文没有报告某项数值,我们会予以说明。
相关综述。 Ma 等人提出了首个 VLA 分类体系,包含三个分支:构建模块、底层控制器和高层规划器。Sapkota 等人综述了 80 多个模型,重点关注应用。Zhang 等人将 300 多项研究划分为自回归、Diffusion、基于 RL 和混合范式。Kawaharazuka 等人从全栈视角出发,涵盖硬件、数据采集和评测。Cui 等人综述并实证比较了双系统架构。
近期的综述采用了更聚焦或不同的切入方式。Shao 等人将基于 VLM 的操作 VLA 分为两类:单体模型,采用单系统或双系统设计;以及分层模型,通过可解释的中间结果进行规划。Zhong 等人根据模型生成的动作 token 类型组织 VLA;Yu 等人从模型、训练和数据三个方面综述效率问题;Xu 等人则从模块、里程碑一直梳理到开放挑战。
在世界模型方面,Hou 等人综述了用于机器人学习的世界模型;Lu 等人综述了 World Action Model;Yao 等人根据能够改善行为的能力对世界模型进行分级;Zhang 等人提供了一篇简明教程;Mehta 等人则在同一个分类体系中连接了表征学习、VLA 和世界模型。
本综述有四点区别:沿 VLA 生命周期组织设计空间,将主要模型放入其中,并提供实践指南;将导航和 Humanoid 控制与操作并列,作为独立研究脉络;从 VLA 的视角比较 World Action Model 与 VLA;以及从各篇论文的全文中提取训练数据、模型规模和推理速度,以开展以数据为中心的定量比较。
如何阅读本综述。 第 2 节介绍问题定义和 VLA 的先驱工作。第 3 节定义生命周期中的七个维度,将主要模型放入这一框架(表 3),并汇总它们的部署数据(表 2)。第 4 至第 6 节梳理操作、导航和 Humanoid VLA 的发展过程,第 7 节讨论这些研究方向的交汇。第 8 节比较 VLA 与 World Action Model,第 9 节梳理 Benchmark 和公平评测,第 10 节提出开放挑战,第 11 节总结研究发现。附录 A 是构建 VLA 的实践指南,附录 B 解释本文使用的术语。
VLA 领域的新读者可以从附录 B、图 1 以及第 2、4、5 节开始阅读;正在构建模型的读者可以从第 3 节和附录 A 开始;寻找研究问题的读者可以阅读第 9 节和第 10 节。
2 背景
2.1 问题形式化
按照常用记法,以语言为条件的机器人策略可以建模为:
其中, 是来自一个或多个相机的图像, 是语言指令, 是本体感知状态, 是包含未来 个动作的动作块。
ACT 提出的 Action Chunking 能够减少误差累积,如今已成为近期操作 VLA 的标准配置,不过大多数导航 VLA 仍然每次只预测一步。
VLA 使用预训练 VLM 初始化策略 的大部分参数。分层 VLA 则通过中间变量 对策略进行分解:
其中, 可以是语言形式的子任务、二维路径、目标帧或中层运动指令。
2.2 先驱工作
RT-1 使用来自 13 台同型号机器人的约 13 万条真实 episode,训练了一个拥有 3,500 万参数的 Transformer。其消融实验表明,数据多样性比数据量更重要。
PaLM-E 将连续传感器编码注入一个拥有 5,620 亿参数的语言模型,使其作为高层规划器运行,并展示了混合任务带来的正向迁移。
Diffusion Policy 将视觉运动控制表述为条件去噪问题,能够处理多模态动作分布,相比此前方法平均提升 46.9%。
ACT 在低成本双臂硬件上引入 Action Chunking,并利用 50 条示范学习精细技能。
Open X-Embodiment 将来自 21 个机构、22 种机器人本体的超过 100 万条轨迹汇集成标准格式。它成为学术界 VLA 常用的预训练语料库;大多数工业界模型则主要使用自己的数据训练。
3 VLA 生命周期中的设计维度
我们沿着 VLA 的生命周期组织设计空间。其中四个维度描述模型本身:观察什么(第 3.1 节)、pipeline 如何构建(第 3.2 节)、如何生成运动控制指令(第 3.3 节),以及还会预测什么(第 3.4 节)。
另外两个维度描述模型如何学习:使用什么数据进行预训练(第 3.5 节),以及之后如何进行适配(第 3.6 节)。最后一个维度描述模型如何运行(第 3.7 节)。第 3.8 节从这七个维度整理了 22 个主要模型。
3.1 输入与记忆
按照公式中的定义,大多数 VLA 仅观察当前时间步的一个或多个相机图像、语言指令,以及在操作任务中的机器人本体感知状态。两个扩展方向反复出现。
第一,条件输入变得更加丰富:Hi Robot 接受开放式提示和用户实时纠正;π0.7 以 episode 元数据和子目标图像为条件;跨本体模型则加入用于标识机器人、数据集或相机视角的提示或 token(第 3.5 节)。
第二,一些模型会观察过去的信息。
记忆。 大多数 VLA 在实际运行中具有马尔可夫性。较长的观测历史处理成本高,基于这些历史训练的策略也可能依赖与正确动作不存在因果关系的线索。
MemER 使用高层 VLM 选出关键帧,再通过一维聚类将其整合为紧凑的情景记忆,使模型能够完成需要回忆数分钟前信息的操作任务。
StreamVLN 将快速滑动窗口上下文与慢速、具备三维感知能力的剪枝记忆相结合,并复用 Transformer 的键值(KV)缓存,以控制延迟。
VLingNav 维护一种由视觉辅助的语言记忆,避免重复探索相同地点。NaVid 则直接将视频历史作为时空上下文。
3.2 架构
图 2 对比了三种架构模式。这种划分遵循 Shao 等人的分类,但我们将双系统设计单独视为一种模式,而非将其归入单体模型。
单体模型,例如 RT-2、OpenVLA 和 π0,将观测直接映射为动作。尽管 π0 的 Action Expert 使用独立权重,我们仍将其归为单体模型,因为该 Expert 属于同一个 Transformer,并在每一层都对 VLM token 进行注意力计算;相比之下,双系统设计是在两个网络之间传递一个潜在表示。
π0.5 保持单一网络结构,但会在生成动作之前预测文本形式的子任务,因此具有内部层级结构。
双系统模型通过潜在特征,将慢速 VLM(“System 2”)与快速动作模块(“System 1”)连接起来,并对两者进行联合训练,例如 GR00T N1 和 CogACT。
Gemini Robotics 也将部署在云端的 VLM 骨干网络与机器人端的动作解码器分开,但没有说明两者如何连接或训练。OpenHelix 对这些设计进行了系统性的实证比较。
分层模型使中间结果显式且可解释。Hi Robot 对开放式提示和用户实时纠正进行推理,为 π0 控制器生成语言形式的子任务。
HAMSTER 预测一条二维末端执行器路径,再由具备三维感知能力的策略跟随该路径。由于路径易于标注,成本较低的非目标领域数据也可用于训练。
MolmoAct 依次生成深度 token、可编辑的轨迹路径和动作。分层模式还允许将记忆和慢速推理放在快速控制循环之外,MemER 就采用了这种方式。
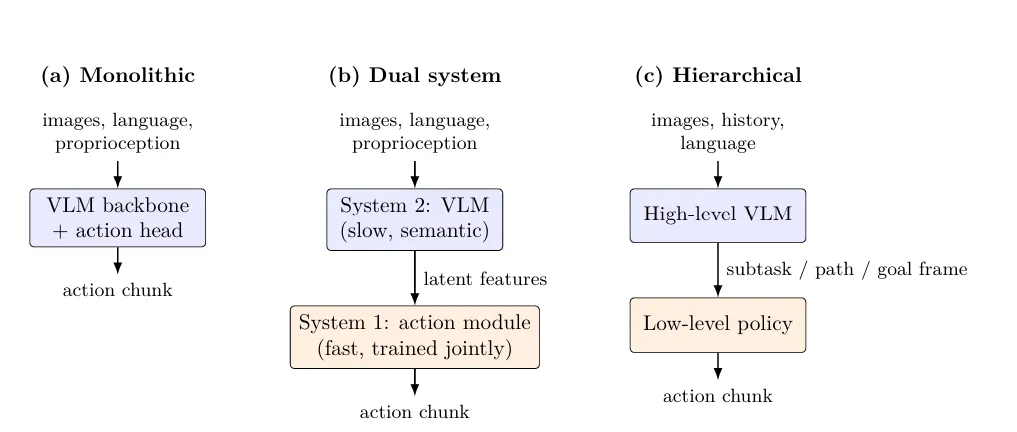
图 2:三种架构模式。
(a)单个网络将观测映射为动作,例如 RT-2、OpenVLA 和 π0。
(b)慢速 VLM 推理模块将潜在特征传递给与其联合训练的快速动作模块,例如 GR00T N1 和 CogACT。
(c)高层模型输出可解释的中间结果,再由单独训练的底层策略执行,例如 Hi Robot、HAMSTER、MemER、Mobility VLA 和 NaVILA。
3.3 动作输出
VLA 如何将 VLM 特征转化为连续机器人动作,是目前探索最活跃的设计维度。表 1 总结了主要方法类别。
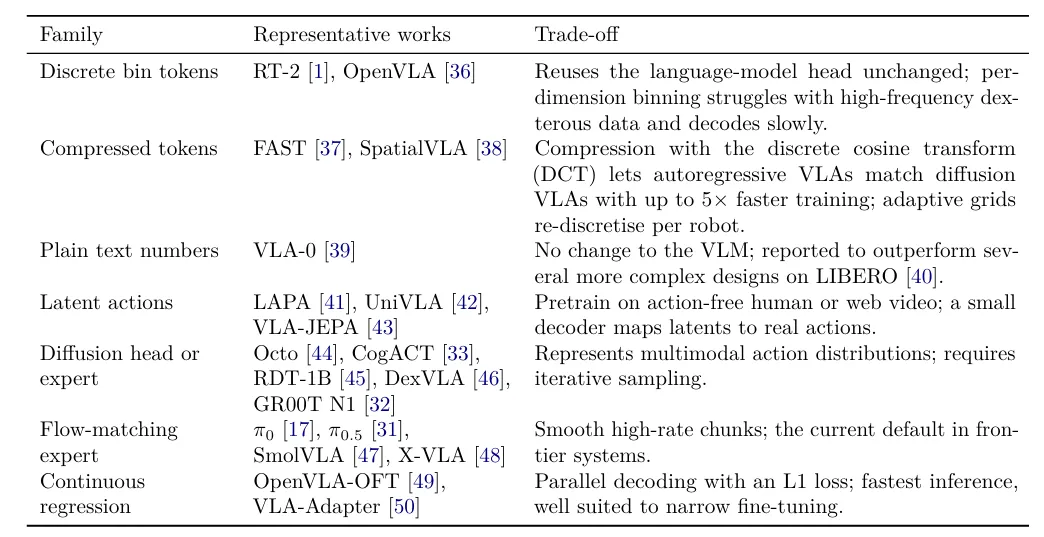
表 1:VLA 中的动作表示类别
有两项改进适用于上述多个类别。
第一,向预训练 VLM 添加一个未经训练的 Action Expert,可能损害 VLM 的语义知识并减慢训练。知识隔离(Knowledge Insulation)阻止梯度从 Expert 流向骨干网络,同时让骨干网络通过离散动作 token 学习。
第二,去噪调度本身可以进行自适应调整。AsyncVLA 的异步 Flow Matching 使用非均匀、感知上下文的调度方式,并在执行前进一步优化低置信度的动作 token。
注:2025 至 2026 年有两项彼此无关的工作都使用了 AsyncVLA 这一名称。本文将这项操作工作称为 AsyncVLA(Flow Matching),将远程 VLA 导航系统称为 AsyncVLA(导航)。
3.4 中间预测
除了动作,许多 VLA 还会预测其他输出,使其决策过程更加明确,或预判接下来会发生什么。这些输出有两种形式:文本推理,以及对未来观测的预测。
在分层系统中,这些输出会从一个模型传递给另一个模型(第 3.2 节);本节重点关注模型预测的内容。
行动前推理。 Embodied Chain-of-Thought(ECoT)训练 VLA 在行动前依次推理计划、子任务、运动、边界框和夹爪位置。在不增加机器人数据的情况下,它使 OpenVLA 的成功率绝对提升了 28%。
Gemini Robotics 1.5 将自然语言推理与动作交替进行。在导航方面,VLingNav 使用自适应思维链,只在需要时进行显式推理。
预测未来。 越来越多的 VLA 除了预测动作,也会预测未来观测。
3D-VLA 使用对齐的 Diffusion 模型生成目标图像和点云。GR-2 在学习动作之前,先作为视频生成器进行预训练。
基于联合嵌入预测架构(JEPA)的 VLA-JEPA 预测未来帧的嵌入表示,而非像素,因此训练目标不要求模型复现无关的视觉细节;负责预测的模型部分也不会直接看到未来帧。
π0.7 使用轻量级世界模型生成子目标图像。这些模型是通往 World Action Model 的桥梁,后者联合预测未来观测和动作;第 8 节比较了这两类模型。
3.5 预训练数据
预训练数据规模从 RT-1 的 13 万条 episode,增长到 OpenVLA 从 Open X-Embodiment 中筛选出的 97 万条 episode,再到 π0 的约 10,000 小时、LingBot-VLA 的约 20,000 小时,以及 π0.6* 的“数万小时”。
LingBot-VLA 报告称,当预训练数据从 3,000 小时增加到 20,000 小时时,下游任务表现持续提升。
多种机制使不同动作空间的数据能够一起训练:
具有物理可解释性的统一动作空间,例如 RDT-1B;
针对各数据来源的可学习软提示,即通过学习得到的嵌入表示,告诉模型每个样本来自哪个数据集和哪种机器人,例如 X-VLA;
感知机器人本体的文本提示,例如 Qwen-VLA;
Motion Transfer 机制,例如 Gemini Robotics 1.5,但论文没有描述该机制的具体设计;
用于导航的相机视角和时间标识 token,例如 NavFoM。
图 3 展示了这些模型覆盖的机器人本体。
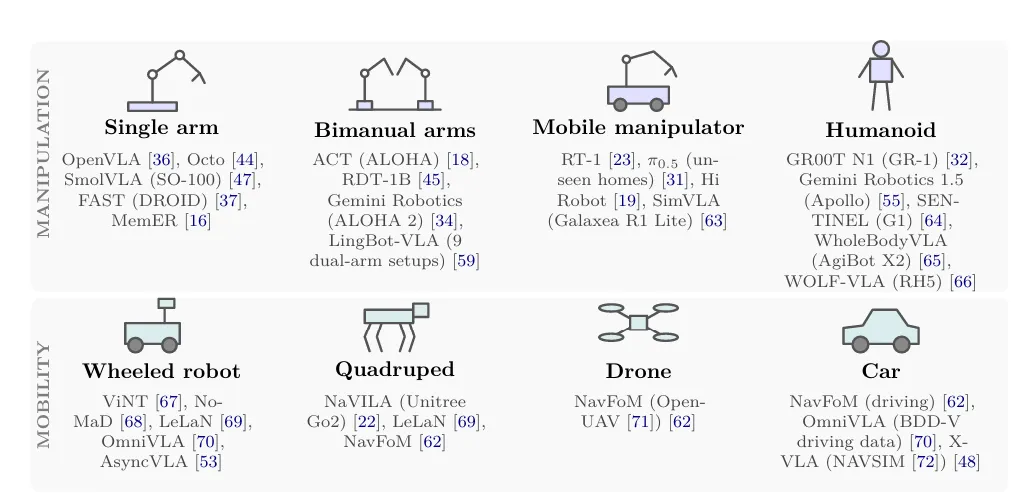
图 3:本文综述工作中涉及的机器人本体,以及在各类本体上训练或评测的模型。
操作类包括单臂机器人、双臂机器人、移动操作机器人和 Humanoid;移动类包括轮式机器人、四足机器人、无人机和汽车。
部分模型覆盖多种本体:π0 在单臂、双臂和移动操作机器人上训练;Gemini Robotics 1.5 在 ALOHA、双臂 Franka 和 Apollo Humanoid 之间迁移技能;NavFoM 覆盖四足机器人、无人机、轮式机器人和汽车;Qwen-VLA 则统一了操作与导航。
联合训练。 联合训练将机器人动作数据与其他数据混合,最常见的是网络视觉问答(VQA)和图像描述数据。RT-2 将这一做法引入 VLA,PaLM-E、π0.5、MolmoAct、NaVid 和 NavFoM 也采用了类似方式。
联合训练的价值取决于数据本身。在 π0.5 的消融实验中,来自其他机器人和环境的数据对模型在未见过的住宅中的表现很重要,而网络数据主要帮助模型处理机器人数据中未出现的物体;网络数据对整体任务成功率的影响没有达到统计显著性。
遥操作之外的数据。 训练数据越来越多地来自其他来源(图 4):
人类视频和网络视频: GR-2 使用了 3,800 万个视频片段;LAPA 和 VLA-JEPA 使用了 Something-Something v2;UniVLA 使用了 Ego4D;LeLaN 使用了 YouTube 导览视频。
仿真数据: GR00T N1 使用了 78 万条轨迹,Qwen-VLA 使用了 720 万条轨迹。
由视频生成的“神经轨迹”: 例如 GR00T N1。
失败和自主执行的 episode: 通过元数据或优势值估计,告诉策略每条 episode 或每个动作的质量,使这些数据能够用于训练。
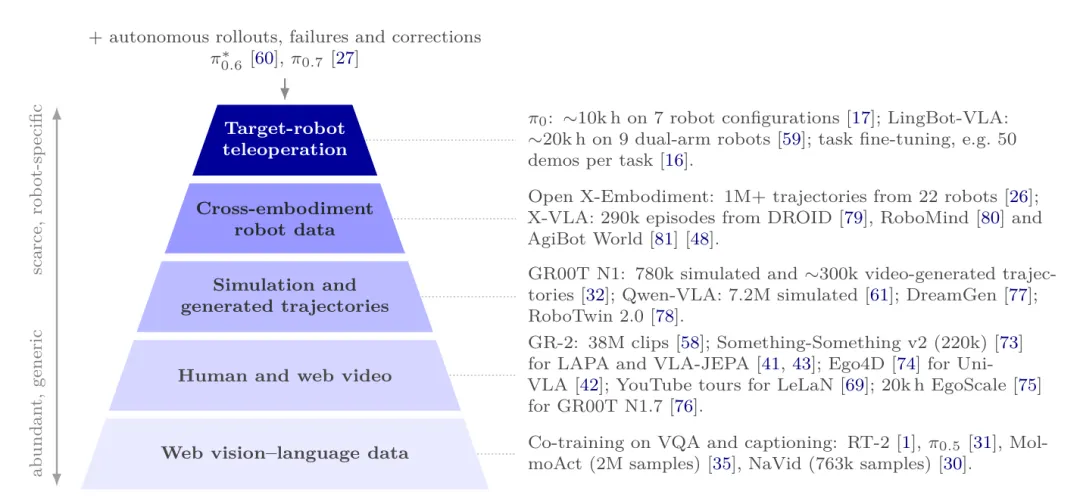
图 4:VLA 训练数据来源,从底部数量丰富但较为通用的数据,到顶部稀缺但针对目标机器人的数据。图中数字来自所综述论文的报告。自主经验是一类不断增长的数据来源,会反馈到最上层。图中的分层方式遵循训练 GR00T N1 时所用数据金字塔的思路。
目标机器人遥操作数据: π0 在 7 种机器人配置上使用约 10,000 小时数据;LingBot-VLA 在 9 种双臂机器人配置上使用约 20,000 小时数据。任务微调数据例如每项任务 50 条示范。
跨本体机器人数据: Open X-Embodiment 包含来自 22 种机器人的超过 100 万条轨迹;X-VLA 使用来自 DROID、RoboMind 和 AgiBot World 的 29 万条 episode。
仿真与生成轨迹: GR00T N1 使用 78 万条仿真轨迹和约 30 万条视频生成轨迹;Qwen-VLA 使用 720 万条仿真轨迹。相关工作还包括 DreamGen 和 RoboTwin 2.0。
人类视频和网络视频: GR-2 使用 3,800 万个视频片段;LAPA 和 VLA-JEPA 使用包含 22 万个片段的 Something-Something v2;UniVLA 使用 Ego4D;LeLaN 使用 YouTube 导览视频;GR00T N1.7 使用 20,000 小时的 EgoScale 数据。
网络视觉语言数据: 使用 VQA 和图像描述数据进行联合训练的工作包括 RT-2、π0.5、MolmoAct 和 NaVid。其中,MolmoAct 使用了 200 万个样本,NaVid 使用了 76.3 万个样本。
3.6 后训练
在目标机器人上进行 SFT 是默认做法。OpenVLA-OFT 总结出一套结合并行解码、Action Chunking、连续动作和 L1 损失的训练方案。
它将 OpenVLA 在 LIBERO 上的平均成绩从 76.5% 提高到 97.1%,吞吐量提升 26 倍。
近期,利用部署经验进行大规模 RL 已变得可行。RECAP 将示范、自主 rollout 和专家干预结合起来,训练一个价值函数,以及一个以优势值为条件的策略。优势值表示每个动作的实际表现比预期好多少。
RECAP 被应用于叠衣服、制作浓缩咖啡和组装盒子。在其中最困难的任务上,它使吞吐量提高了一倍以上,并将失败率大致减半。
VLingNav 在导航中加入了由专家引导的在线 RL 阶段。π0.7 则以 episode 元数据和子目标图像为条件,使质量较低的数据能够改善模型,而非降低模型表现。
3.7 实时执行
大型 VLA 的运行频率只有几赫兹,这会导致机器人在动作块的边界处出现停顿或不流畅的过渡(图 5)。
SmolVLA 使用异步推理系统,将动作预测与动作执行解耦。
Real-Time Chunking(RTC)让两者并行:机器人执行当前动作块时,模型规划下一个动作块。对于新动作块准备完成之前就会执行的动作,模型保持其固定;对于剩余部分,模型进行补全,使两个动作块平滑衔接。
RTC 在推理阶段应用于现有 Diffusion 和 Flow Matching 策略,无需重新训练。
AsyncVLA(导航)在远程工作站上运行大型 VLA,并在机器人端运行轻量级边缘适配器。它能够容忍长达 6 秒的通信延迟;在人群中,机器人在 85% 的试验中无碰撞到达目标。作者报告称,这一结果比最强基线高 40%。
分层系统通常以不同频率运行两个层级:MemER 的高层策略运行频率约为 1 Hz,底层策略约为 2 Hz。
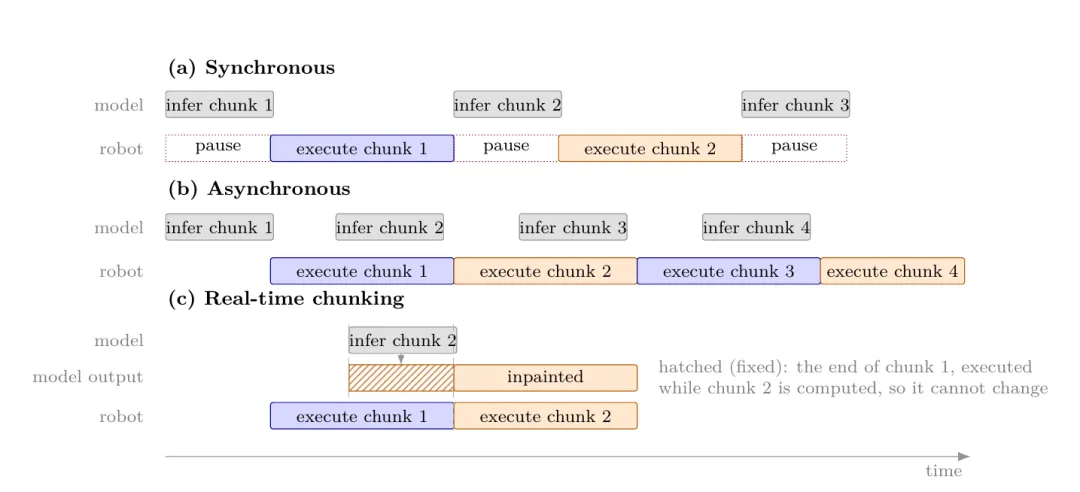
图 5:动作块的执行方式。
(a)同步执行: 模型计算下一个动作块时,机器人停止运行,因此机器人会在每个动作块边界处停顿。
(b)异步执行: 当前动作块执行时,模型计算下一个动作块。SmolVLA 的推理系统,以及 AsyncVLA(导航)中远程 VLA 与边缘适配器分工的设计,都采用了这种方式。但如果新动作块规划了不同的运动,机器人在切换时会发生突变,导致动作不流畅。
(c)Real-Time Chunking: RTC 避免了这一问题。模型计算动作块 2 时,机器人继续执行动作块 1;这段期间即将执行的动作无法改变,因此模型将其固定,并在动作块 1 剩余部分的引导下预测动作块 2 的其余内容,使后续动作平滑衔接。
VLA 在哪里运行。 表 2 汇总了主要工作报告的模型规模、推理速度和硬件配置。有三个明显特点。
首先,所有明确给出硬件配置的模型,都运行在单张桌面级或数据中心 GPU 上,例如 RTX 4090、RTX 5090、A6000、A100、L40、H100,或运行在云端 TPU 上。嵌入式机器人硬件只出现在分离式系统的边缘部分,例如 AsyncVLA 运行在 Jetson Orin 上的适配器。
其次,基于 70 亿至 80 亿参数视频 VLM 构建的导航 VLA,通常通过网络调用远程 RTX 4090 或 A100 服务器。
最后,不同论文在不同 GPU 上使用彼此不兼容的方式报告速度,包括吞吐量、每个动作块的延迟、每秒帧数和有效控制频率,因此表中的数字不能直接用于排名。VLA-Perf 通过解析式延迟模型处理这一问题(第 9 节)。
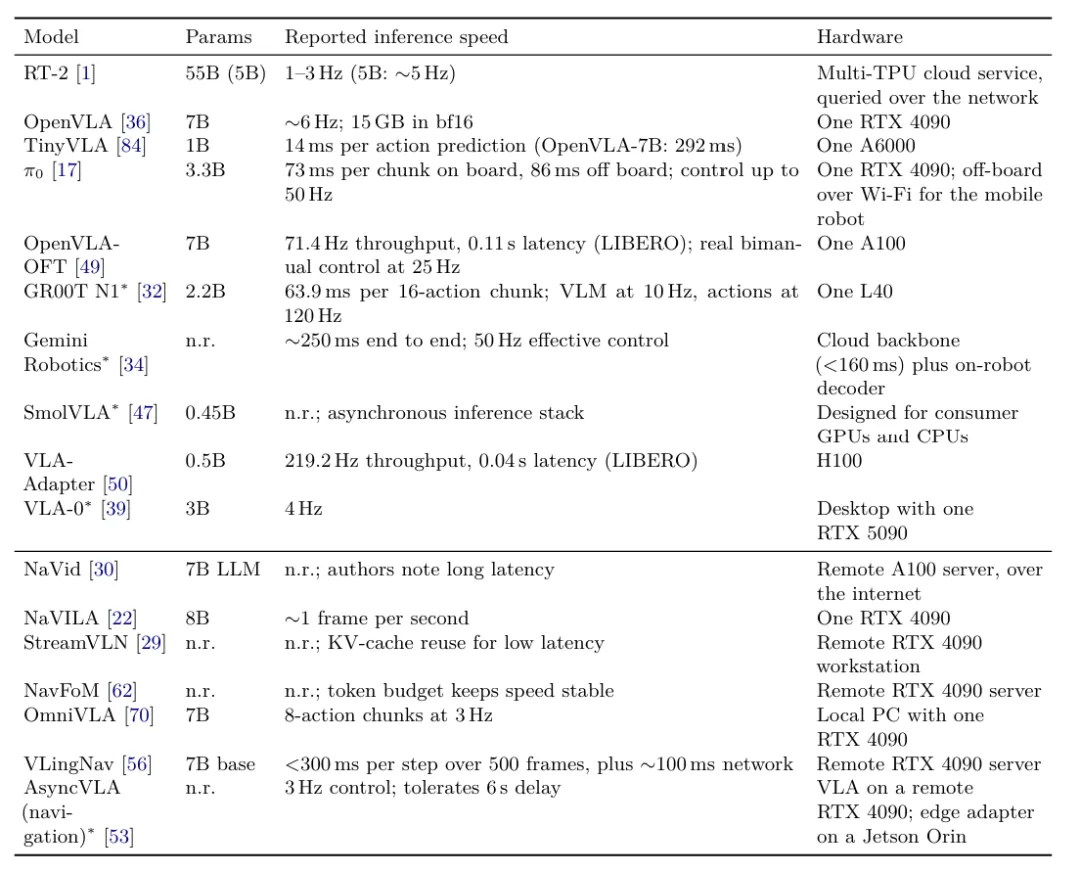
表 2:主要 VLA 论文报告的模型规模、推理速度和硬件
速度沿用各论文的原始单位,不能直接比较。n.r. 表示未报告。星号()表示预印本。
3.8 将模型放入各设计维度
表 3 按生命周期顺序,将 22 个主要模型放入七个设计维度。表中的短横线表示该工作在相应维度上没有特别突出的设计选择,并不表示模型缺少这一维度。
按列阅读,可以看出研究工作主要投入在哪些方面:每个模型的动作输出和预训练数据都有所不同;9 个模型扩展了输入,10 个模型预测动作之外的内容,但只有 7 个模型在后训练上做出了特别的设计选择,只有 VLA-JEPA 和 π0.7 这两个模型预测未来观测。
导航模型在输入方面尤其突出:7 个导航模型中有 5 个加入了历史信息或额外视角,因为导航依赖于机器人此前去过哪里。
按行阅读,可以看到不同设计选择的累积:π0.7 在七个维度上都有特别的设计选择,而 RT-2 和 OpenVLA 分别在其中四个维度上有特别选择。
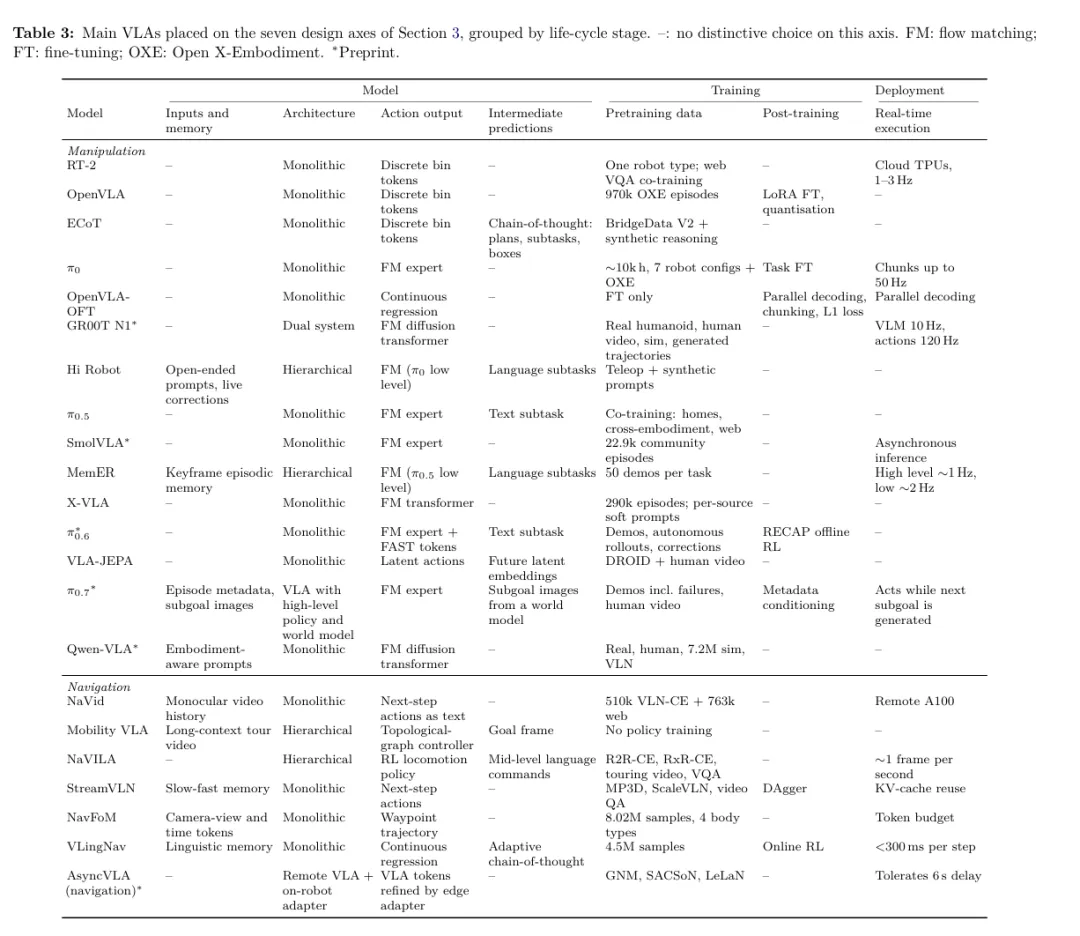
表 3:主要 VLA 在七个设计维度上的分布
表格按生命周期阶段分组。“—”表示该维度上没有特别突出的设计选择。FM 表示 Flow Matching,FT 表示微调,OXE 表示 Open X-Embodiment。星号()表示预印本。
由于原表较宽,以下将每个模型的七个维度依次列出。
操作模型
RT-2
输入与记忆:—
架构:单体模型
动作输出:离散分箱 token
中间预测:—
预训练数据:一种机器人;与网络 VQA 数据联合训练
后训练:—
实时执行:云端 TPU,1–3 Hz
OpenVLA
输入与记忆:—
架构:单体模型
动作输出:离散分箱 token
中间预测:—
预训练数据:97 万条 OXE episode
后训练:LoRA 微调、量化
实时执行:—
ECoT
输入与记忆:—
架构:单体模型
动作输出:离散分箱 token
中间预测:思维链,包括计划、子任务和边界框
预训练数据:BridgeData V2 加合成推理数据
后训练:—
实时执行:—
π0
输入与记忆:—
架构:单体模型
动作输出:Flow Matching Expert
中间预测:—
预训练数据:约 10,000 小时,覆盖 7 种机器人配置,另加 OXE
后训练:任务微调
实时执行:动作块控制频率最高 50 Hz
OpenVLA-OFT
输入与记忆:—
架构:单体模型
动作输出:连续回归
中间预测:—
预训练数据:仅进行微调
后训练:并行解码、Action Chunking、L1 损失
实时执行:并行解码
GR00T N1
输入与记忆:—
架构:双系统
动作输出:Flow Matching Diffusion Transformer
中间预测:—
预训练数据:真实 Humanoid 数据、人类视频、仿真数据和生成轨迹
后训练:—
实时执行:VLM 为 10 Hz,动作频率为 120 Hz
Hi Robot
输入与记忆:开放式提示、实时纠正
架构:分层模型
动作输出:Flow Matching,底层为 π0
中间预测:语言子任务
预训练数据:遥操作数据加合成提示
后训练:—
实时执行:—
π0.5
输入与记忆:—
架构:单体模型
动作输出:Flow Matching Expert
中间预测:文本子任务
预训练数据:联合训练,包括住宅、跨本体和网络数据
后训练:—
实时执行:—
SmolVLA
输入与记忆:—
架构:单体模型
动作输出:Flow Matching Expert
中间预测:—
预训练数据:22,900 条社区采集的 episode
后训练:—
实时执行:异步推理
MemER
输入与记忆:关键帧情景记忆
架构:分层模型
动作输出:Flow Matching,底层为 π0.5
中间预测:语言子任务
预训练数据:每项任务 50 条示范
后训练:—
实时执行:高层约 1 Hz,底层约 2 Hz
X-VLA
输入与记忆:—
架构:单体模型
动作输出:Flow Matching Transformer
中间预测:—
预训练数据:29 万条 episode;针对各数据来源使用软提示
后训练:—
实时执行:—
π0.6
输入与记忆:—
架构:单体模型
动作输出:Flow Matching Expert 加 FAST token
中间预测:文本子任务
预训练数据:示范、自主 rollout 和纠正数据
后训练:RECAP 离线 RL
实时执行:—
VLA-JEPA
输入与记忆:—
架构:单体模型
动作输出:潜在动作
中间预测:未来潜在嵌入表示
预训练数据:DROID 加人类视频
后训练:—
实时执行:—
π0.7
输入与记忆:episode 元数据、子目标图像
架构:带高层策略和世界模型的 VLA
动作输出:Flow Matching Expert
中间预测:世界模型生成的子目标图像
预训练数据:包含失败在内的示范、人类视频
后训练:以元数据为条件
实时执行:生成下一个子目标时继续执行动作
Qwen-VLA
输入与记忆:感知机器人本体的提示
架构:单体模型
动作输出:Flow Matching Diffusion Transformer
中间预测:—
预训练数据:真实机器人数据、人类数据、720 万条仿真数据、视觉语言导航数据
后训练:—
实时执行:—
导航模型
NaVid
输入与记忆:单目视频历史
架构:单体模型
动作输出:以文本形式表示的下一步动作
中间预测:—
预训练数据:51 万个 VLN-CE 样本,加 76.3 万个网络样本
后训练:—
实时执行:远程 A100
Mobility VLA
输入与记忆:长上下文导览视频
架构:分层模型
动作输出:拓扑图控制器
中间预测:目标帧
预训练数据:无需策略训练
后训练:—
实时执行:—
NaVILA
输入与记忆:—
架构:分层模型
动作输出:RL 移动策略
中间预测:中层语言指令
预训练数据:R2R-CE、RxR-CE、导览视频、VQA
后训练:—
实时执行:约每秒 1 帧
StreamVLN
输入与记忆:慢速—快速记忆
架构:单体模型
动作输出:下一步动作
中间预测:—
预训练数据:MP3D、ScaleVLN、视频问答数据
后训练:DAgger
实时执行:复用 KV 缓存
NavFoM
输入与记忆:相机视角和时间 token
架构:单体模型
动作输出:航点轨迹
中间预测:—
预训练数据:802 万个样本,覆盖 4 类机器人本体
后训练:—
实时执行:token 预算
VLingNav
输入与记忆:语言记忆
架构:单体模型
动作输出:连续回归
中间预测:自适应思维链
预训练数据:450 万个样本
后训练:在线 RL
实时执行:每一步小于 300 ms
AsyncVLA(导航)
输入与记忆:—
架构:远程 VLA 加机器人端适配器
动作输出:由边缘适配器进一步优化的 VLA token
中间预测:—
预训练数据:GNM、SACSoN、LeLaN
后训练:—
实时执行:可容忍 6 秒延迟
4 操作 VLA
表 5 列出了 43 项操作相关工作及其训练数据和核心思想。图 6 绘制了其中报告了可比较数值的部分。我们将这段发展历程分为四个阶段。
2023 年:VLA 出现。 RT-2 确立了一种方案:在大型 VLM 中将动作表示为 token,并使用网络数据进行联合微调。RoboFlamingo 表明,开源 VLM 加上轻量级策略头,也能在 CALVIN 上取得有竞争力的表现。
2024 年:开源通用模型。 Octo 和 OpenVLA 分别发布了使用 80 万条和 97 万条 Open X-Embodiment episode 预训练的开源模型。OpenVLA 以少 7 倍的参数量,超越了拥有 550 亿参数的 RT-2-X。
ECoT、TinyVLA、RDT-1B、LAPA 和 CogACT 分别探索了推理、模型轻量化、双臂 Diffusion、潜在动作和专用动作模块。π0 将基于 PaliGemma 的 VLM、Flow Matching Action Expert 和约 10,000 小时的多机器人灵巧操作数据结合起来。
2025 年:效率、层级结构与泛化。 FAST 使自回归 VLA 具备了竞争力,OpenVLA-OFT 提高了微调效率。GR00T N1 发布了双系统 Humanoid 模型的开放权重,Gemini Robotics 将 Gemini 引入机器人控制。
π0.5 展示了在训练期间从未见过的住宅中,端到端完成长时程清洁任务的能力。在高效率模型方面,SmolVLA、VLA-Adapter 和 VLA-0 展示了参数量低于 10 亿,或不进行机器人预训练时的强劲表现。MemER 引入了长达数分钟的记忆,π0.6* 则引入了利用部署经验进行的 RL。
2026 年:可引导性与统一。 LingBot-VLA 将开放真实机器人数据的规模扩展到约 20,000 小时。VLA-JEPA 引入了潜在世界模型预训练。SimVLA 表明,采用标准化训练方案的极简 5 亿参数模型能够达到远大于自身的模型的表现,并指出许多报告的性能提升很难与训练方案差异区分开来。
π0.7 通过丰富的上下文信息,使通用模型能够被引导,并报告了零样本跨本体叠衣能力。Qwen-VLA 训练了一个同时处理操作、导航和轨迹预测的模型。
没有论文的开源模型系列。 一些使用最广泛的开源 VLA 如今通过代码发布而非论文持续演进。NVIDIA 的 GR00T 系列是最明显的例子:只有 N1 发表了论文。N1.5、N1.6 和 N1.7 的信息记录在 NVIDIA 开源仓库的发布说明中,见表 4。
在这四个版本中,该系列从冻结 VLM 转向部分微调面向推理的 VLM,从绝对动作转向相对动作,并从仅使用机器人数据转向加入大规模人类视频。由于这些版本没有论文,其数据和评测无法按照表 5 中其他工作的标准进行核查。
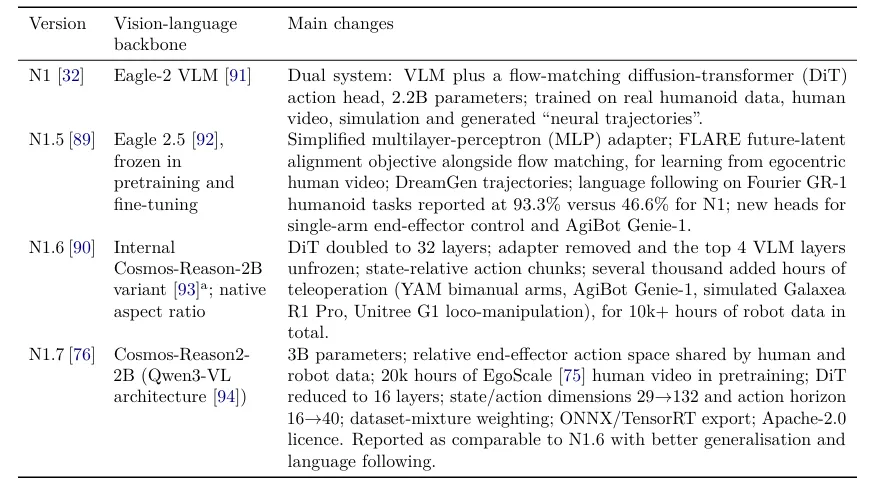
表 4:GR00T N1 模型系列
N1 的信息来自其论文,后续版本的信息来自 NVIDIA 仓库的发布说明。四个版本均未经同行评审。
注:N1.6 的发布说明将骨干网络描述为内部 Cosmos-Reason-2B 变体,而 N1.7 的更新日志将 N1.6 的骨干网络命名为 nvidia/Eagle-Block2A-2B-v2;两者可能是同一模型的不同名称。
图 6 显示出两个趋势。
第一,数据策略出现分化。2023 年底至 2025 年初,多个模型使用约 100 万条 episode 训练,包括 Open X-Embodiment、Octo、OpenVLA、RDT-1B 和 SpatialVLA。
此后,前沿系统报告使用了 10,000 至 20,000 小时机器人数据:π0 约 10,000 小时,LingBot-VLA 约 20,000 小时;π0.6* 只说明使用了“数万小时”。
同时,数据来源扩展到了机器人之外:近期发布的模型加入了大规模人类视频,例如 GR00T N1.7 使用的 20,000 小时第一视角视频,见表 4。
另一些模型使用的数据要少得多。SmolVLA 使用 22,900 条社区采集的 episode 训练;TinyVLA、VLA-Adapter 和 VLA-0 则完全跳过机器人预训练。不过,这些模型最强的结果来自 LIBERO 等仿真 Benchmark,后者覆盖的能力远少于真实世界应用,见第 9 节。
第二,模型规模并没有简单地持续下降。RT-2 拥有 550 亿参数,仍是本文中规模最大的机器人策略;PaLM-E 拥有 5,620 亿参数,规模更大,但它充当的是规划器,而非策略。
2025 至 2026 年的大多数模型拥有 30 亿至 70 亿参数,同时出现了一批参数量低于 10 亿的新模型:SmolVLA 为 4.5 亿,VLA-Adapter 和 SimVLA 为 5 亿,X-VLA 为 9 亿。SmolVLA 被设计为能够在消费级 GPU 甚至 CPU 上运行;VLA-Adapter 可以在单张消费级 GPU 上训练 8 小时。
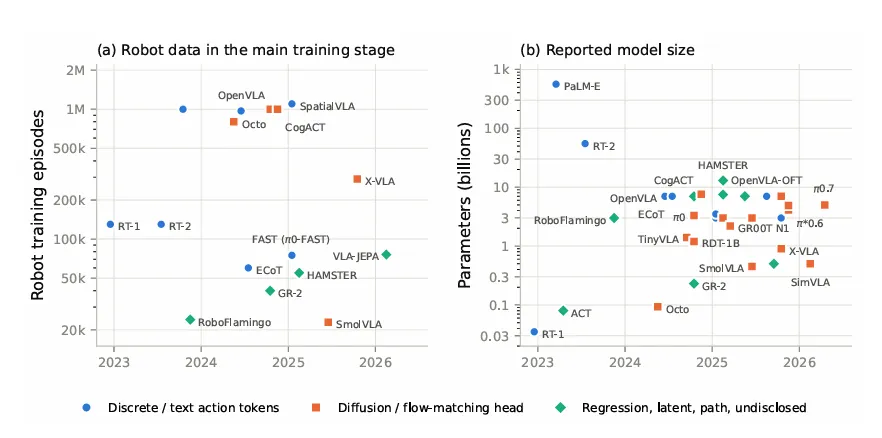
图 6:操作 VLA 随时间的发展。
(a)机器人数据: 展示 16 项工作中各模型主要训练阶段使用的机器人 episode 数量,这些工作均报告了单一 episode 数量。Open X-Embodiment 是数据集本身,位于 2023 年底但未标注名称。只报告小时数的模型,例如 π0 的约 10,000 小时和 LingBot-VLA 的约 20,000 小时,无法放在这一坐标轴上;没有进行机器人预训练的模型,包括 Diffusion Policy、ACT、TinyVLA、VLA-Adapter 和 VLA-0,也被省略。SimVLA 同样被省略,因为其 Benchmark 模型没有进行机器人预训练,但其真实机器人模型使用约 500 小时数据训练。
(b)模型规模: 展示 32 项报告了参数量的工作。对于分层系统,图中数值表示高层模型的参数量。为避免标签重叠,部分标签被省略;所有数据点均列于表 5。
表 5:操作 VLA 及先驱工作
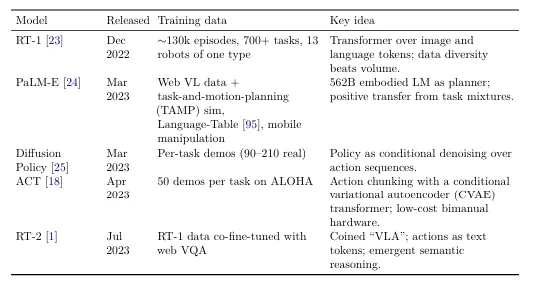
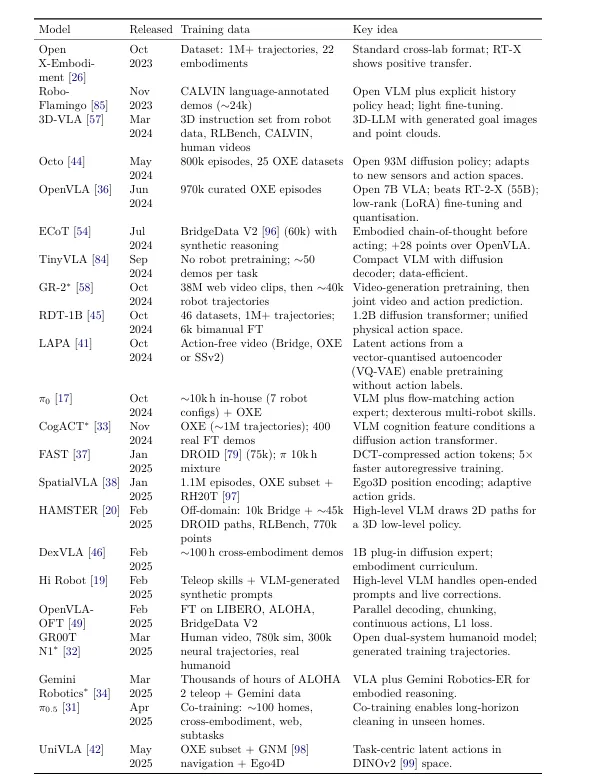
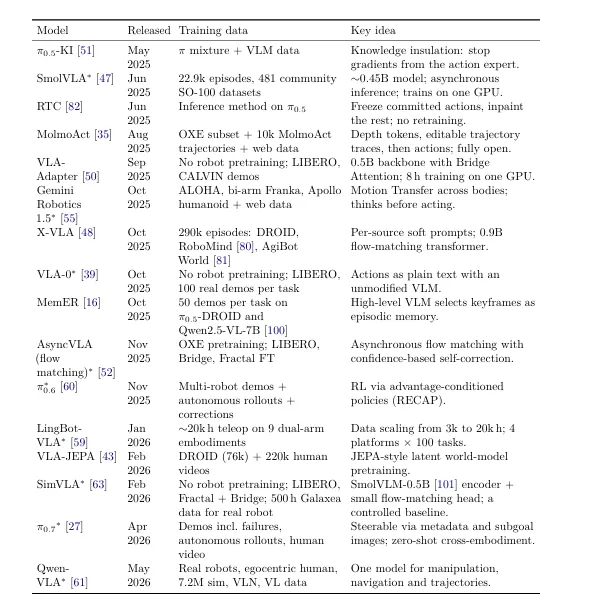
OXE 表示 Open X-Embodiment,FT 表示微调。星号()表示预印本。
5 导航 VLA
大多数导航 VLA 来自两条研究脉络,二者使用不同的数据、输出和评测方式;规模较小的第三类方法则将 VLM 置于单独训练的控制器之上,见图 7 和表 6。
视觉导航基础模型。 ViNT 使用来自 8 个机器人平台的超过 100 小时真实轨迹训练导航 Transformer,并通过替换目标编码器来适应新的目标类型。
NoMaD 使用目标掩码,使一个 Diffusion 策略能够同时处理探索和到达目标两种任务。
LeLaN 使用 VLM 标注了约 130 小时没有动作标注的第一视角视频,其中包括 YouTube 导览视频和人类行走视频。
OmniVLA 使用约 10,000 小时导航数据训练,目标可以通过二维位姿、图像、语言或这些形式的组合给出。
AsyncVLA(导航)将远程 VLA 与机器人端的边缘适配器分开。这一脉络中的模型输出航点,主要使用真实机器人数据训练,并以边缘部署为目标。
基于视频 VLM 的视觉语言导航(VLN)。 NaVid 表明,视频 VLM 仅凭单个 RGB 相机的视频流即可完成导航,无需地图、里程计或深度传感器。它使用 51 万个 VLN-CE 样本和 76.3 万个网络样本训练。
Uni-NaVid 使用 360 万个仿真样本,统一了指令跟随、物体搜索、具身问答和跟随行人四类任务。
StreamVLN 为流式输入引入了慢速—快速上下文建模。NavFoM 使用 802 万个导航样本,跨四足机器人、无人机、轮式机器人和汽车进行训练。VLingNav 加入了自适应推理、语言记忆和在线 RL。
这一脉络中的模型主要使用 Habitat 仿真数据训练,输出下一步动作,并在 R2R-CE 和 RxR-CE 上评测。
分层系统。 规模较小的一类方法将 VLM 放在控制循环之外。
NaVILA 通过输出中层语言指令,将 VLN 引入足式机器人;这些指令由 RL 移动策略执行。
Mobility VLA 无需进行策略训练:长上下文 VLM 在示范导览视频中定位目标帧,再由拓扑图控制器驱动机器人前往目标。
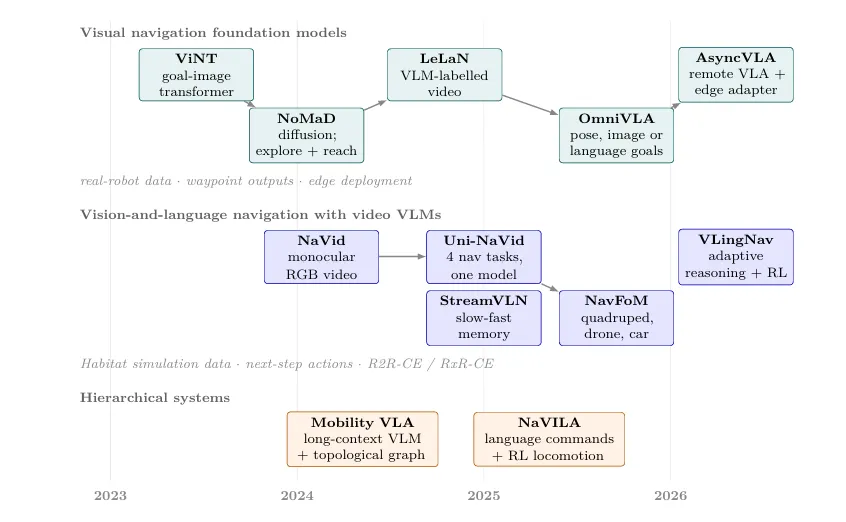
图 7:导航 VLA 的两条主要研究脉络,最下方一行是分层系统。
箭头连接同一研究团队中直接建立在早期模型或其数据之上的工作:一条是 Berkeley 视觉导航方向中从 ViNT 到 AsyncVLA 的工作;另一条是视频 VLM 方向中从 NaVid 到 NavFoM 的工作。StreamVLN 和 VLingNav 是第二条脉络中的独立工作。最下方一行展示分层系统。每一行中的方框均按照首次发布到 arXiv 的时间排列。
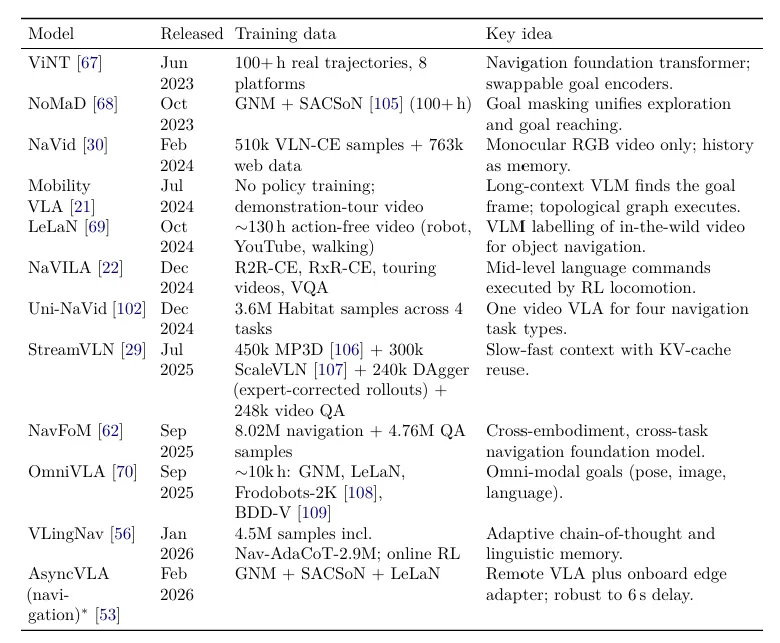
表 6:导航 VLA
星号()表示预印本。
6 移动与 Humanoid 全身控制
操作 VLA 通常输出末端执行器位姿,导航 VLA 则输出速度或航点;在这两种情况下,都由独立控制器执行这些输出。
对于 Humanoid,这种分工更加困难,因为控制器必须在腿部、腰部和手臂协同运动时保持机器人平衡。LeVERB 认为,这类固定动作接口会将 Humanoid 限制在缓慢的准静态任务中。
合适的数据也很稀缺:Humanoid 遥操作成本高,符合动力学约束的示范也很少。目前出现了两种设计,见表 7。
分层设计:在学习得到的全身控制器之上加入视觉语言层。 这与第 3 节中的分层 VLA 相呼应。NaVILA 在 RL 移动策略之上使用语言指令,是导航领域的先驱工作。
Humanoid-VLA 以全身控制架构为基础,首先使用带文本配对的人类动作数据集对语言与动作进行预对齐,再通过参数高效微调加入第一视角视频。
LeVERB 训练视觉语言策略输出潜在“动词”,再由通过 RL 学习得到的全身控制器将其转化为动力学层面的指令。它还提出了一个闭环 Benchmark,包含 10 个类别、超过 150 项任务。LeVERB 在该 Benchmark 上的总体成功率为 58.5%,是一个简单分层基线的 7.8 倍。
SONIC 扩展了控制器本身:它训练了一个参数量最高为 4,200 万的动作跟踪基础模型,使用 700 小时动作捕捉数据,消耗 21,000 GPU 小时。该模型的 token 空间同时服务于 VR 遥操作和 VLA。
WholeBodyVLA 从没有动作标注的第一视角人类视频中学习潜在动作,并将 VLA 与一个专门处理移动操作动作的 RL 策略结合,例如前进、转身和下蹲。
在 AgiBot X2 Humanoid 上,WholeBodyVLA 的平均成功率为 78.0%,比最强 VLA 基线 OpenVLA-OFT 的 56.7% 高 21.3 个百分点,也比一个模块化非 VLA 基线的 64.0% 高 14 个百分点。
端到端设计:从语言到关节动作。 SENTINEL 使用 Flow Matching,直接将语言和本体感知信息映射为底层动作,不使用中间表示,并通过残差 RL 动作头在 Unitree G1 上进一步优化动作。
它的训练数据来自人类动作数据集,这些动作由预训练的全身控制器在仿真中进行跟踪。
WOLF-VLA 使用最优控制代替人类动作,为 RH5 Humanoid 合成了 277 小时符合动力学约束的轨迹,覆盖六类移动任务。
与上述两者不同,HAF 不训练新模型。它对现有 Flow Matching VLA 进行适配,使其依次生成腿部、腰部和手臂动作;随后使用 RL 进行改进,RL 只调整输入去噪过程的噪声,VLA 权重保持不变。
共同趋势。 操作领域的三个主题再次出现。
由于机器人遥操作数据稀缺,Humanoid VLA 依赖非机器人数据,包括人类动作捕捉、第一视角视频、仿真和最优控制。
RL 再次作为后续优化阶段出现,例如 SENTINEL 的残差动作头和 HAF 的潜在空间 RL。
工业界模型也在朝相同方向发展:GR00T N1.6 加入了 Unitree G1 移动操作数据,N1.7 的发布说明则记录了基于 SONIC 的全身控制。
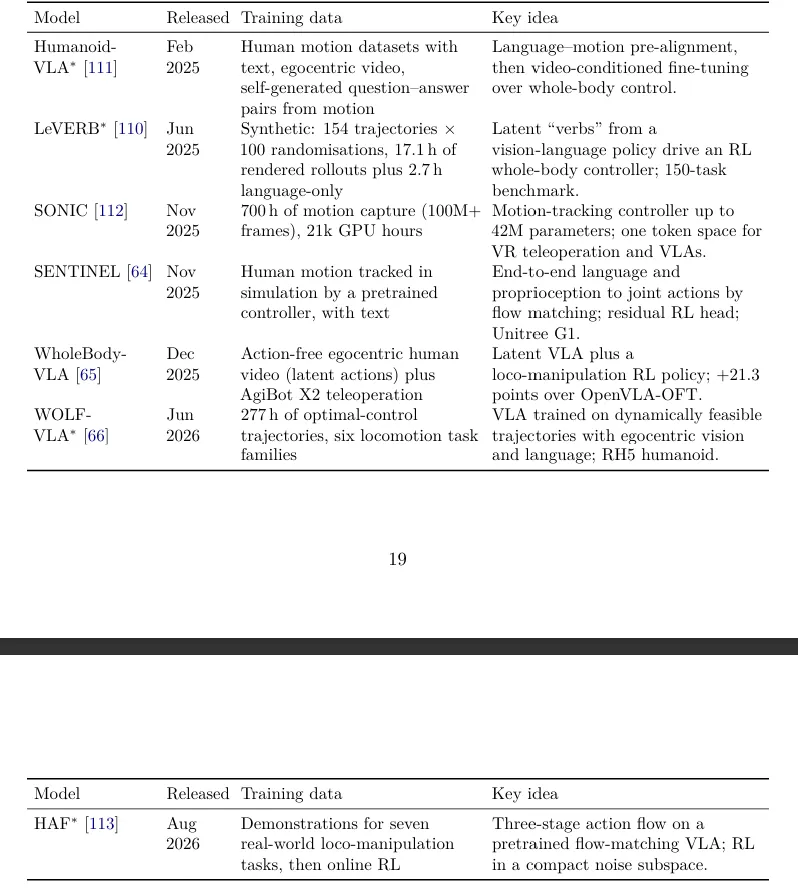
表 7:结合视觉和语言的 Humanoid 全身控制
星号()表示预印本。
7 操作与导航的融合
操作和导航两个研究社区长期使用不同的动作空间、Benchmark 和模型类别。
在动作空间上,前者使用末端执行器或关节指令,后者使用航点;在 Benchmark 上,前者使用 LIBERO、SimplerEnv 和 CALVIN,后者使用 VLN-CE。
近期的两个模型显示出早期的统一迹象:
UniVLA 联合使用操作数据、导航数据和人类视频学习潜在动作,并报告了操作 Benchmark 和 R2R 上的结果。
Qwen-VLA 将操作、导航和轨迹预测视为同一个预测问题。单个模型在 LIBERO 上达到 97.9%,在 RxR 上达到 59.6% 的成功率。作者在两个 Benchmark 上进行的消融实验发现,联合使用多种机器人类型进行训练,没有造成显著性能损失。
另外两条相关研究路线尚未实现统一。
π0.5 等移动操作机器人在同一台机器人上结合移动和操作,但仍被作为操作系统进行训练和评测。NavFoM 覆盖从四足机器人到汽车等差异很大的本体,但只处理导航。
我们认为,构建同时具备这两种技能的单一模型,其主要障碍可能正从架构转向数据和评测。
从生命周期设计维度来看,这两个尝试统一的模型都在训练阶段发挥作用:通过汇集数据和共享动作接口实现统一。UniVLA 使用潜在动作,Qwen-VLA 则将其作为同一个预测问题;但它们的评测仍然分散在独立的操作和导航 Benchmark 上。
8 VLA 与 World Action Model
另一类机器人基础模型从视频而非语言出发。世界模型预测智能体行动时环境会如何变化。World Action Model(WAM)进一步联合预测未来观测和机器人动作。
在我们找到的机器人领域文献中,最早使用这一术语的是 DyWA;目前大多数 WAM 从经过视频生成预训练的模型出发。
VLA 仅通过动作监督学习 ;WAM 则学习将未来观测与动作一起预测:
其中, 表示未来帧,或未来帧的潜在嵌入表示。
已有专门综述分别讨论 World Action Model 和用于机器人学习的世界模型;本文将 WAM 与 VLA 进行比较。这两类模型从不同的预训练模型出发,失败方式也有所不同,见图 8 和表 8。
正如 UniWAM 作者所指出的,VLA 的视觉语言模型从图文数据中学习了语言和物体的语义,但其有关物理规律的唯一训练信号来自机器人动作。WAM 的视频模型则学习了场景如何随时间变化,但没有学会如何遵循语言或进行语言推理。
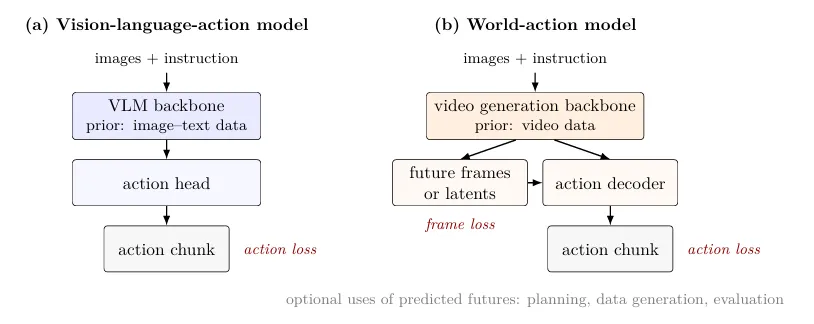
图 8:两类模型的起点。
(a)VLA: 对视觉语言模型进行适配,仅使用动作进行监督。
(b)World Action Model: 对视频模型进行适配,同时使用未来观测和动作进行监督。预测的未来可以为动作解码器提供信息,并支持规划、合成数据生成或评测。
表 8 对两者进行了详细比较。
表 8:VLA 与 World Action Model 对比
从视频计划到联合模型。 这里反复出现两个术语:前向动力学模型根据当前观测和动作预测下一次观测;逆动力学模型则推断连接两个观测的动作。
UniPi 将决策表述为以文本为条件的视频生成:模型合成展示计划行为的视频,再由逆动力学模型从生成帧中恢复动作。
Video Prediction Policy(VPP)跳过了完整的视频生成过程:它将视频 Diffusion 模型内部有关下一步将发生什么的特征输入逆动力学模型,在 CALVIN ABC→D 上取得 18.6% 的相对提升。
Unified Video Action model(UVA)学习视频和动作的共享表示,并为二者分别设置 Diffusion 动作头。动作推理因此可以完全跳过视频生成;通过掩码不同的输入,同一个模型既可以充当前向动力学模型,也可以充当逆动力学模型。
WorldVLA 在一个自回归模型中合并 VLA 和世界模型,并报告称两者能够相互促进。
视频基础模型作为策略骨干网络。 Genie Envisioner 围绕一个以指令为条件的视频 Diffusion 模型构建机器人平台,其中包括 Flow Matching 动作解码器、以动作为条件的神经仿真器,以及评测世界模型质量的 Benchmark。
Cosmos Policy 仅通过微调就将预训练视频模型转化为策略,同时保留原有架构:动作、未来状态和价值估计被写入模型的潜在帧中。
由于能够预测未来状态和价值,Cosmos Policy 可以在测试时进行规划。其报告在 LIBERO 上达到 98.5%,在 RoboCasa 上达到 67.1%。
超越视频 Diffusion。 2026 年的两篇预印本将 WAM 带向了不同方向。
LeWAM 降低了计算成本:它使用预测式 JEPA 嵌入表示替换视频 Diffusion 骨干网络,以 4 亿可训练参数在 RoboTwin 2.0 上达到 92.3%。
UniWAM 则通过在同一架构中加入推理模块“Physical Reasoner”,使 WAM 更接近 VLA;该模块与视频生成器和动作预测器并列。作者报告称,在人类数据和机器人数据上进行联合训练时,模型表现呈现对数线性的 Scaling Laws。
世界模型的三种作用。 世界模型目前以三种方式服务于机器人学习:
作为策略骨干网络: 即上述 WAM 的做法。
作为数据生成器: DreamGen 将视频世界模型转化为合成“神经轨迹”的来源。借助这些轨迹,一个 Humanoid 从单项任务的遥操作数据中学会了 22 种新行为。DreamGen 的视频 Benchmark 成绩与下游策略成功率相关。GR00T N1 使用了约 30 万条此类轨迹。
作为评测器: Genie Envisioner 的 GE-Sim 等神经仿真器能够生成闭环 rollout,用于策略开发。
逐渐模糊的边界。 VLA 越来越多地预测未来:3D-VLA、GR-2、VLA-JEPA 和 π0.7 都会生成目标图像、视频或未来潜在表示,见第 3 节。
反过来,WAM 也在加入 VLM 风格的推理能力,UniWAM 便是一个例子。一种实用的区分方式是:VLA 以理解为先,WAM 以动力学为先;最强的系统很可能需要同时具备两者。
9 Benchmark 与公平评测
是否存在标准 Benchmark? 目前还没有。没有任何单一 Benchmark 被公认为衡量 VLA 的标准。
取而代之的是,少数仿真评测套件已经成为事实上的标准,见表 9;真实世界评测仍然由各实验室自行设计,不同论文之间很少能够直接比较。
当前评测实践存在的问题。
分数饱和。 LIBERO 成绩如今集中在接近上限的位置:OpenVLA-OFT 报告 97.1%,Qwen-VLA 为 97.9%,X-VLA 约为 98%,SimVLA 为 98.6%。VLA-0、VLA-Adapter 和 SimVLA 在没有任何机器人预训练的情况下就能达到这样的成绩,因此该 Benchmark 已无法显示大规模预训练带来的增益。
记忆化与脆弱性。 两套独立的扰动测试都表明,较高的 LIBERO 分数夸大了模型的鲁棒性。在 LIBERO-PRO 中,OpenVLA 和 π0 在标准 LIBERO 上的成绩均超过 90%;一旦物体位置相对训练位置发生轻微移动,两者成功率就降至 0%。π0.5 表现更好,在其中一个任务套件上仍保持 38%。
LIBERO-Plus 对 OpenVLA-OFT、π0 等模型测试了七类扰动:改变相机视角或机器人初始位姿,会使成功率从约 95% 降至 30% 以下;许多模型还在很大程度上忽略了指令。
比较中的混杂因素。 架构变化通常伴随着数据、骨干网络和训练调度的变化,因此许多报告的性能提升很难归因。SimVLA 的受控基线将这一问题具体呈现出来,见第 4 节。
表 9:最常用于评测 VLA 的 Benchmark
图 9:VLA 评测的不同层级,按定性方式从成本低、易复现,到更接近真实部署排列,并列出各层级报告的关键发现。
标准仿真: 包括 LIBERO、CALVIN、RoboCasa 和 VLABench。LIBERO 上的成绩已接近饱和,达到 97% 至 98.6%。
扰动测试: 包括 LIBERO-PRO、LIBERO-Plus 和 RoboTwin 2.0。原本超过 90% 的分数可能降至 0%。
经真实世界验证的仿真: SimplerEnv 的仿真结果与真实结果高度相关;目前验证了两种机器人配置。
自动化真实世界评测: AutoEval 使用排队任务、自动场景重置和成功检测;其分数与人工执行的试验接近。
分布式真实世界评测: RoboArena,以及 π0.5 在未见过的住宅中进行的实验。RoboArena 在 7 个机构完成了 600 多次成对比较。
贯穿各层级的要求包括:受控基线和匹配的训练方案,如 SimVLA 所强调的;推理延迟,如 VLA-Perf 所研究的;以及训练数据报告。
公平比较正越来越多地结合多个评测层级,而非依赖单一仿真分数。
推动公平评测的工作。 图 9 将这些工作按从低成本、易复现到接近真实部署的顺序排列。
面向鲁棒性的 Benchmark。 LIBERO-PRO 和 LIBERO-Plus 使用系统性扰动替代固定测试场景;RoboTwin 2.0 则将域随机化直接纳入 Benchmark。
经真实世界验证的仿真。 SimplerEnv 为真实机器人平台构建仿真副本,并对其控制行为和外观进行调节,使其与真实平台匹配。研究发现,策略在这些仿真副本中的结果与真实世界结果高度相关。
可扩展的真实世界评测。 AutoEval 将真实机器人测试自动化:系统自行检测任务是否成功并重置场景,因此评测可以昼夜运行,其分数与人工执行的试验高度接近;其 WidowX 场景向社区开放。
RoboArena 则将评测分布到使用相同 DROID 机器人的 7 个机构。评测人员以盲测方式比较两个策略;基于 600 多次这样的比较,它对策略的排名比单一中心化评测更加准确。
将世界模型作为评测器。 视频模型仿真器是一种较新的选择。DreamGen Bench 报告称,其视频模型分数与下游策略成功率相关;GE-Sim 则在生成的世界中运行策略。但两者都尚未与真实机器人结果进行验证。
受控基线。 SimVLA 主张使用固定、透明的基线和训练方案报告结果,从而将性能提升归因于被研究的具体变化。
将效率作为指标。 VLA-Perf 为不同模型设计,以及设备端、边缘端和云端部署提供推理延迟解析模型,使速度能够与成功率一起进行比较。
综合这些工作,可以形成一套共同的评测协议:使用受扰动的测试场景,而非固定场景;使用真实机器人验证仿真分数;开展分布式真实世界比较;匹配训练方案;在成功率之外报告延迟和训练数据。附录 A 将这套协议整理为评测新模型的检查清单。
10 开放挑战与研究方向
我们按照第 3 节中的生命周期阶段对开放挑战进行分组,并补充了贯穿多个阶段的挑战。每项挑战最后都提出一个由本综述中的证据所引出的研究问题。
10.1 模型
超越数分钟的记忆。 关键帧记忆和慢速—快速记忆如今已能支持需要回忆数分钟前信息的任务,但表 3 中只有少数模型保留历史信息,而且这些模型大多用于导航。
开放问题:记忆能否从数分钟扩展到数小时,并将机器人曾经去过哪里的空间地图,与机器人曾经做过什么的情景记忆结合起来?
VLA 内部的世界模型。 潜在世界模型和生成式世界模型正在进入 VLA,WAM 也在加入 VLM 风格的推理能力,见第 8 节。
然而,表 3 的 22 个模型中,只有 VLA-JEPA 和 π0.7 两个模型预测未来观测。有无未来预测的受控对比仍然很少;WorldVLA 报告两者可以相互促进,是一个例外。
开放问题:对于哪些任务,预测未来带来的收益足以抵消其计算和延迟成本?用于生成数据或评测策略的世界模型,应如何通过真实机器人进行验证?
10.2 训练
数据混合设计。 混合权重通常通过启发式方法设定,例如 π0 按照 为各数据集赋权,Octo 则根据数据集的规模和多样性赋权;同时还会采用一些临时性规则,例如在训练后期移除 DROID 数据。
少数受控消融实验表明,不同数据来源所教授的能力有所不同:在 π0.5 中,跨本体数据对未见过的住宅最重要,网络数据则主要帮助模型处理未见过的物体。
开放问题:哪些数据来源塑造了哪些能力?能否根据这些测量结果,而非总小时数,来设计数据混合?
从部署经验中学习。 RECAP 和导航中的在线 RL 表明,VLA 可以从自身经验中改进,但表 3 的 22 个模型中,只有 7 个在后训练上做出了特别的设计选择,而且 RECAP 仍然依赖专家干预。
开放问题:在很少有人类监督的情况下,VLA 能否从跨多种任务和机器人的自主经验中安全地改进?
全身数据。 由于 Humanoid 遥操作成本高,Humanoid VLA 大多仍依赖单独训练的全身控制器;端到端模型则主要使用合成数据或人类动作数据训练,见第 6 节。
开放问题:能否将最优控制数据和人类动作数据,与有限的真实遥操作数据结合,使 VLA 在真实 Humanoid 上实现灵活、富含接触的全身控制?
10.3 部署
延迟与边缘部署。 异步执行能够掩盖延迟,参数量低于 10 亿的模型也能在通用硬件上运行。
但表 2 中所有明确给出硬件配置的模型,都运行在桌面级或数据中心 GPU 上;嵌入式机器人计算机只用于分离式系统的边缘部分。
开放问题:能否压缩大型 VLA,使其在不失去通用性的情况下运行于机器人硬件?例如,可以使用量化——OpenVLA 表明量化能够保持真实机器人表现——或使用 VLA-0 作者提出的蒸馏方法。
10.4 贯穿生命周期的问题
统一技能。 UniVLA 和 Qwen-VLA 通过汇集数据和共享动作接口统一操作与导航,但它们的结果仍在不同的 Benchmark 上分别报告;移动操作机器人也仍被作为操作系统进行训练和评测,见第 7 节。
开放问题:对于既能移动又能操作的单一模型,应如何在同时需要这两种技能的任务上进行评测?
具有预测能力的评测。 仿真正成为越来越重要的数据来源,例如 GR00T N1 和 Qwen-VLA;但很少有工作衡量仿真成功率在多大程度上能够预测真实世界迁移表现。接近饱和的 LIBERO 分数也掩盖了模型的脆弱性,见第 9 节。
SimplerEnv 在两种配置上使用真实机器人验证了仿真分数。
开放问题:能否跨多种机器人本体,使用真实机器人验证 Benchmark 分数,从而让仿真结果能够预测部署表现?
报告标准。 在制作表 5 和表 6 时,我们发现训练数据的报告方式并不一致:
43 项操作相关工作中,只有 16 项给出了单一的机器人 episode 数量;
有些工作只报告小时数,或使用“数千小时”“数万小时”等定性描述;
11 项工作没有给出部署策略的参数量;
即使报告了推理速度,也是在不同 GPU 上使用吞吐量、每个动作块的延迟、每秒帧数或有效控制频率等不同形式,见表 2。
这些问题使数据效率和计算成本无法进行同条件比较。
我们建议 VLA 论文至少报告:每个训练阶段使用的机器人 episode 数量和小时数、非机器人数据的占比、机器人本体数量、推理时的总参数量,以及在明确注明的硬件上每个动作块的延迟。附录 A 将这些内容列为检查清单。
11 结论
不到四年的时间里,VLA 模型已经从概念验证发展为一个多样化的生态。沿其生命周期考察,主要变化十分清晰。
在模型方面,操作 VLA 如今大多使用 Flow Matching 或 Diffusion 动作头预测动作块,导航 VLA 大多仍然每次预测一步;越来越多的模型会显式呈现推理过程或预测未来观测。
在训练方面,数据从遥操作机器人数据扩展到社区采集的 episode、人类视频、仿真和机器人自身的尝试。一些小模型完全跳过机器人预训练,不过它们最强的结果来自仿真 Benchmark。
在部署方面,模型规模出现分化:一批参数量低于 10 亿的新模型能够在消费级 GPU 上运行,异步执行则掩盖了更大模型的延迟。
能够同时处理操作和导航的通用 VLA 正在出现,World Action Model 则提供了一条互补的、以动力学为先的路径。
评测正从已经饱和的仿真分数转向鲁棒性测试和分布式真实世界比较。
最迫切的研究方向包括:超越数分钟的记忆、有原则的数据混合、能够预测真实世界迁移的评测、从部署经验中安全学习,以及一致地报告数据和延迟。
我们希望,生命周期分类体系、以数据为中心的表格,以及附录 A 中的实践指南,能够帮助研究者理解这一领域、构建自己的模型,并选择可以做出贡献的方向。
来源:human five