在 Scale AI,我们认为,构建高质量机器人数据集,不能仅仅依靠增加数据采集时长。我们重点关注操作任务的四个多样性维度:任务(Task)、物体(Object)、动作(Action)和环境(Environment)。这四个维度各自都呈现长尾分布:从有效数量(Effective Number)来看,任务的多样性最高,而被操作物体的分布具有最长的尾部。
通过对包含 20,000 小时数据集中的文本和视觉 Embedding 进行详细分析,我们发现,纯视觉模型的 Embedding 空间主要捕捉场景信息,对动作本身的关注较少。我们测试的 VLA 能够将动作区分开来,不过,它的语言输入中也包含了动词信息。
理解模型如何感知机器人数据,是构建机器人基础模型的重要一步。
数据集拆解
我们分析的 20,000 小时数据子集来自带有子任务标注的遥操作数据,其中包含 Mobile Trossen 机器人数据。该机器人采用双臂结构,并搭载在轮式移动底盘上,即 Mobile ALOHA。下面是该数据集的基本情况。
数据集规模
| 指标 | 数量 |
|---|---|
| 录制视频 | 344,625 段 |
| 子任务 | 9,924,297 个 |
| 任务 | 797 个 |
| 场所 | 231 个站点,覆盖 11 种场景类型 |
每段录制视频对应一个完整任务,例如“收拾物品”,并被拆分成若干子任务:每个子任务都是一段较短的视频片段,并配有一行文字标注,例如“将量杯放入容器中”。
每段视频还对应一个具体采集站点,即某个特定房间,并标注其场景类型(如厨房、办公室等)和光照条件。
为了理解如此庞大的数据集,我们构建了一个可视化工具,将每个子任务映射到模型的 Embedding 空间中。相似的视频片段会彼此靠近。该工具还支持根据文字标注进行搜索,或者从动词出发,浏览其对应的操作物体。
如何定义数据集的多样性?
我们从四个维度分析数据集:任务、动词、物体和场景类型。对于每个维度,我们统计其类别数量,并检查这些类别是集中分布,还是呈现长尾分布。
为了用单一指标衡量数据分布的丰富程度,我们采用有效数量(Effective Number):即需要多少个等规模的类别,才能达到相同的多样性水平(Hill, 1973; Jost, 2006)。
如果某个维度中的所有类别都拥有相同的数据时长,那么有效数量就等于类别总数。当少数几个类别占据了绝大部分数据时,有效数量就会变小。
下图展示了各个维度的数据分布形态。
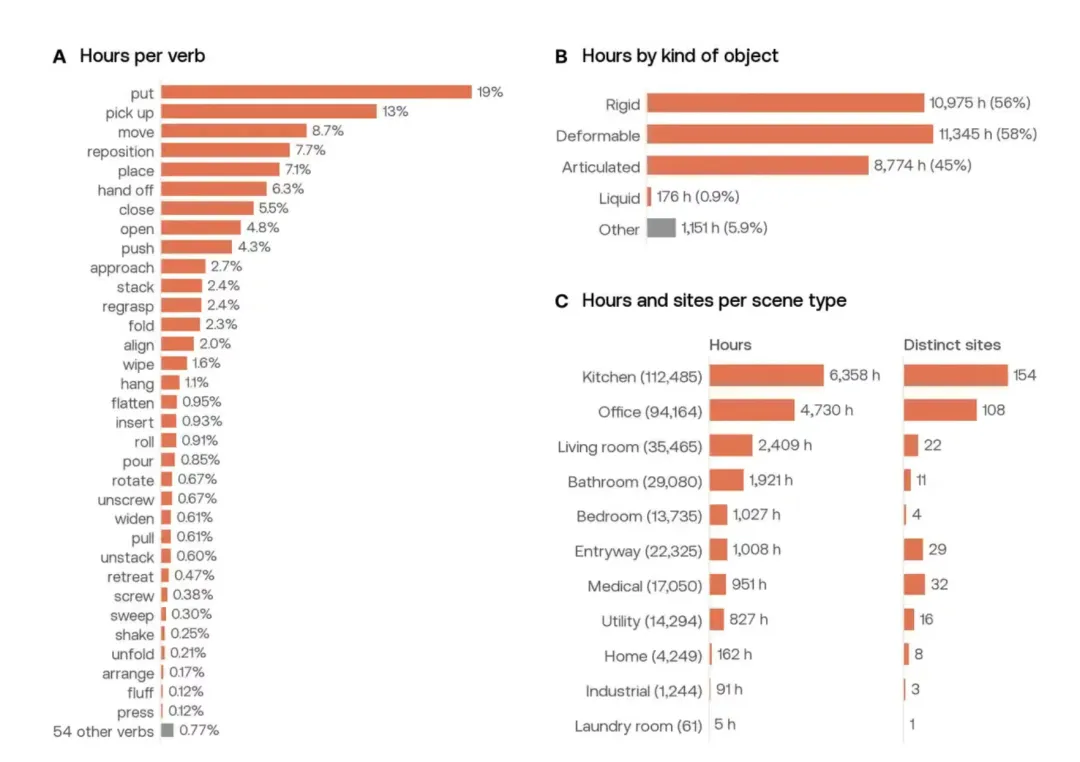
图 2:数据集概览,三个维度呈现长尾分布。
(A) 每个动词对应的数据时长,低于总时长 0.1% 的动词合并显示为灰色。
(B) 不同物体类别对应的数据时长;“Other”代表 5.9% 的数据时长,这些记录没有标注物体类别。由于一段记录可能同时标注两种物体类别,因此各类别占比之和超过 100%。
(C) 各场景类型对应的数据时长(左)和不同采集站点数量(右),括号内为每种场景类型对应的录制数量。
| 维度 | 类别数量 | 最大类别 | 有效数量 |
|---|---|---|---|
| 任务 | 797 | Zip bag,占 5.7% | 194 |
| 动词 | 86 | put,占 19% | 17 |
| 物体 | 3,696 | towel,占 6.2% | 162 |
| 场景类型 | 11 | kitchen,占 33% | — |
如图 2 所示,动词、物体和采集站点均呈现长尾分布。超过 100 万条子任务文本只出现过一次。图 2A 展示了动词标签内部的长尾分布。部分采集站点在数据集中占据了更大的比例:例如,卧室场景占据了 5% 的数据时长,但这些数据仅来自 4 个站点(图 2C)。
在任务标注中出现的物体具有最长的长尾分布。3,696 个物体标签所呈现的多样性,相当于约 162 个均匀分布的类别:其多样性与任务(194)大致相当,远高于动词(17),但分布在一个更长的类别列表中,因为数千种物体标签仅出现过寥寥数次。
下一节将进一步展示常见物体本身具有怎样的多样性。
人类如何观察这些数据
数据量能够告诉我们每种任务有多少数据,却无法反映不同录制内容之间究竟存在多大差异。例如,一千段折叠毛巾的操作视频,可能使用的都是同一条白色毛巾,并且都在同一张桌子上完成。
我们分析了每种任务对应的摄像头视野,并提出三个问题:
视频中出现了哪些物体?这些物体有多大差异?
数据采集发生的房间有多大差异?
不同任务在上述两个维度上有何区别?
为了研究数据集的视觉多样性,我们在每段录制视频的第一帧上运行物体检测器,并统计文字标注中使用的描述性词汇。
首先观察每段视频的第一帧
通过分析每段录制视频的第一帧,我们在整个数据集中发现了 1,372 种不同的物体。每帧通常包含 7 个物体。
桌子是最常见的物体,出现在 71% 的第一帧中,其次是植物(42%)和瓶子(33%)。
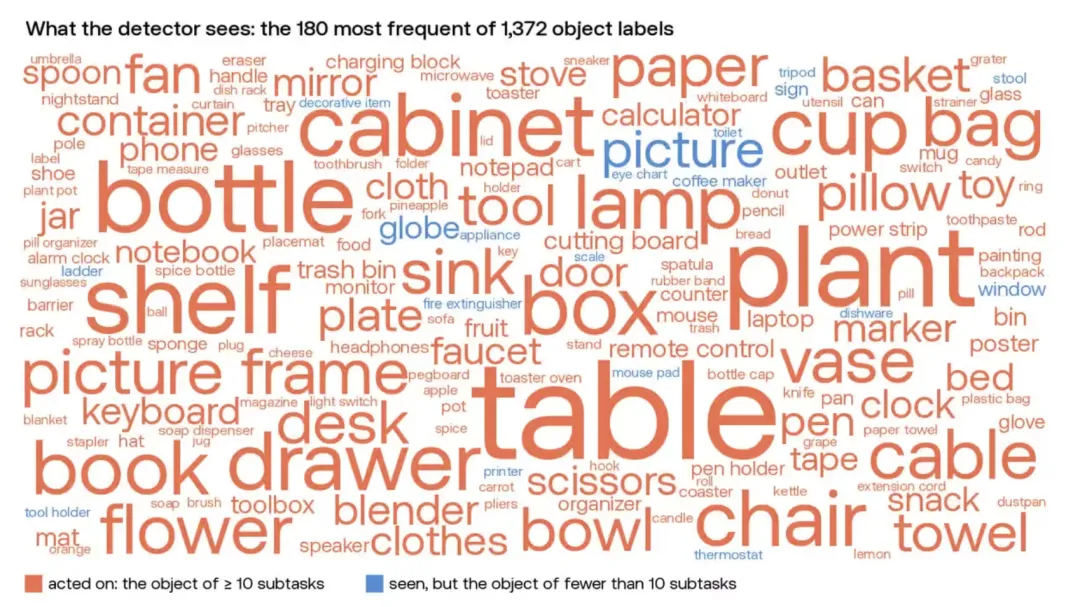
图 3:第一帧中的检测标签。
每个词语的大小对应于其出现在多少段录制视频的第一帧中(不包括人物)。橙色词语表示该物体在整个数据集中至少有 10 个子任务对其进行过操作;蓝色词语表示该物体虽然出现在画面中,但几乎从未被实际操作。
由于数据集由移动操作(Loco-manipulation)数据构成,第一帧无法捕捉整个 Episode 中出现的所有物体。我们仅在第一帧中发现了全部物体的 39%。
下面展示最常见和最少见的物体。
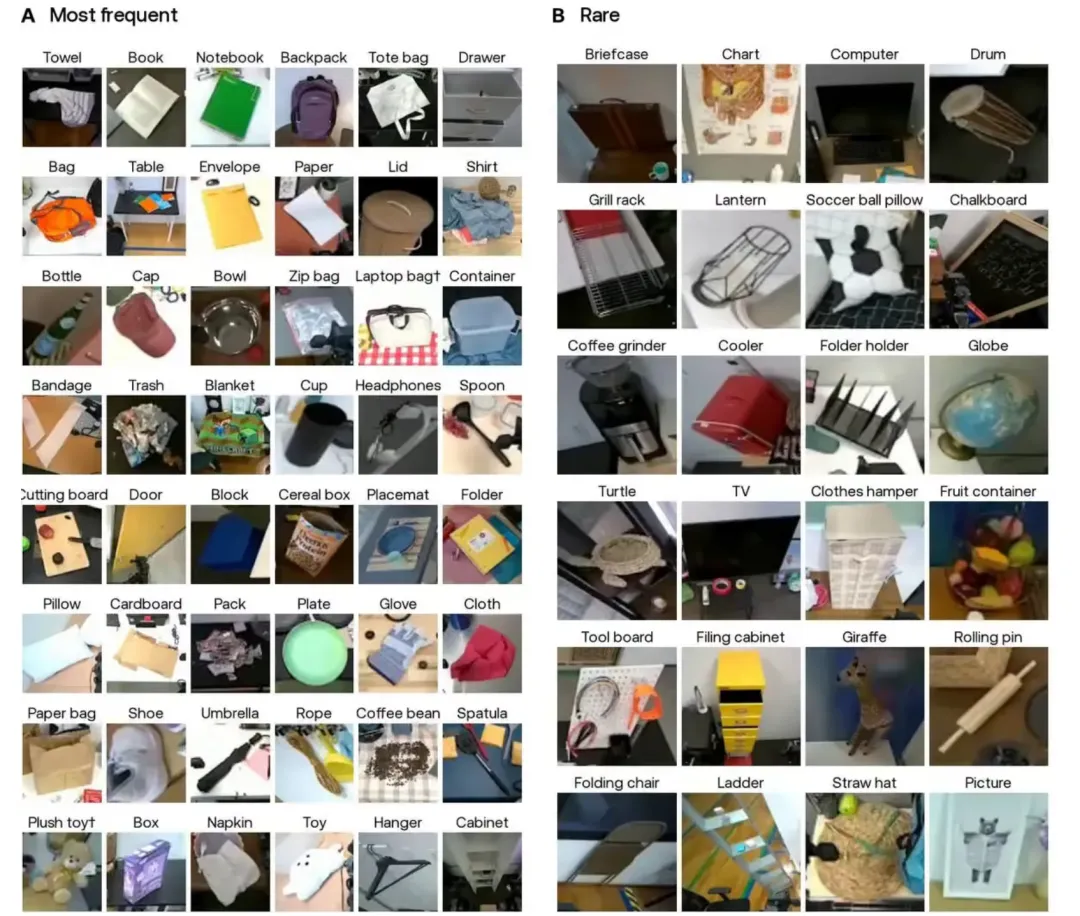
图 4:
(A) 最常见的物体:每个物体均提供一个可用的裁剪图像,且来自不同的、实际操作过该物体的录制视频。匕首符号(†)表示其中两个裁剪图像使用了名词短语中核心名词的 Bounding Box(例如,laptop bag 对应的核心名词是 bag)。
(B) 最少见的物体:每种物体在 6 个或更少的子任务中被提及。
同一种物体,也有多种形态
最常见的物体实际上具有多种不同形态。对于出现频率最高的 12 种物体,文本标注分别为每种物体添加了 83 至 506 种不同的修饰词。这些修饰词包括物体的颜色、材质和状态。
这 12 种物体中的每一种,都出现在 231 个采集站点中的至少 39 个站点。
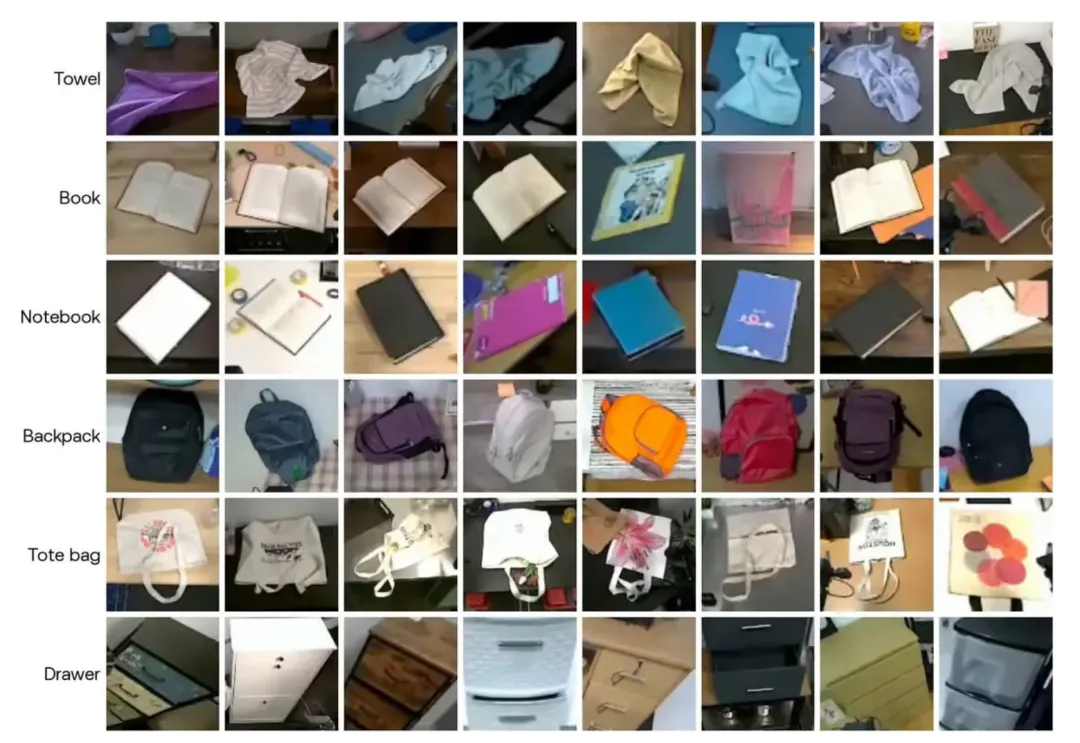
图 5:六种物体,每种物体分别展示来自八个不同采集站点的实例。
场景是什么样的?
为了比较数据集中不同场景类型的背景多样性,我们从每种场景类型中提取前 60 帧,并统计其中出现的不同背景物体。
厨房具有最高的多样性,共包含 82 种不同物体;工业房间的多样性最低,仅包含 14 种。
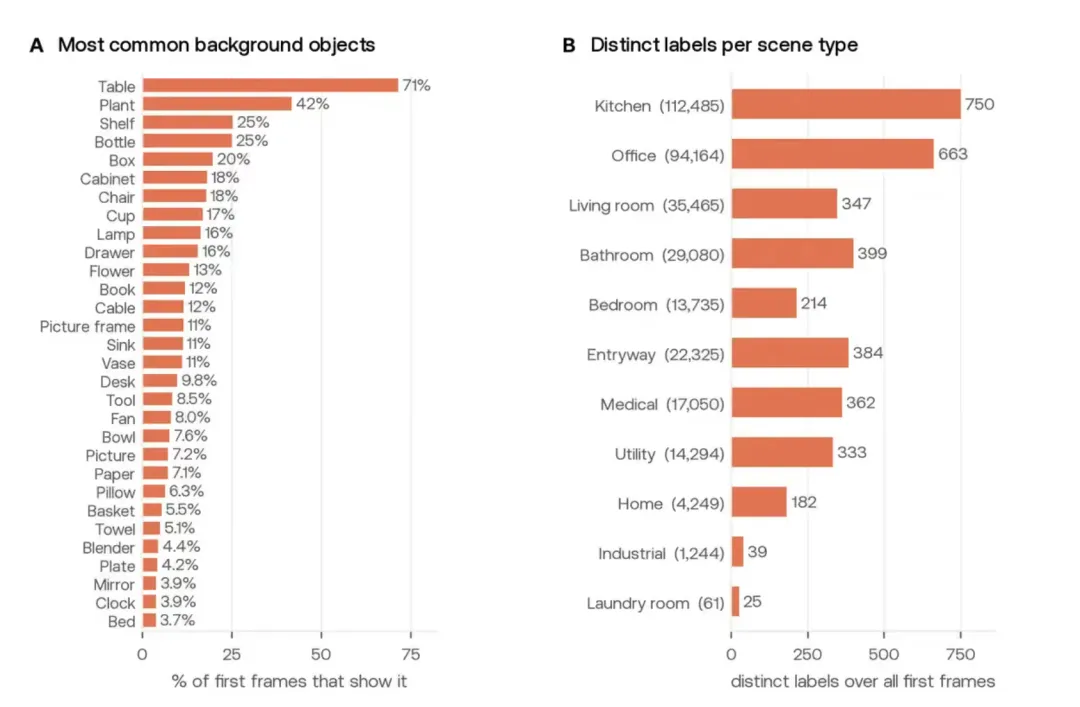
图 6:
(A) 最常见的背景物体:统计所有视频第一帧中出现频率最高的 30 种背景物体。
(B) 每种场景类型对应的不同标签数量:统计所有第一帧中每种场景类型包含的不同背景标签。括号中为该场景类型对应的录制数量,各行按照数据时长排序。
下面展示每种场景类型中的采集站点示例,以说明相同类型的房间之间也可能存在多大差异。同时,我们还展示四种光照标签对应的示例:正常、昏暗、明亮和变化不定。
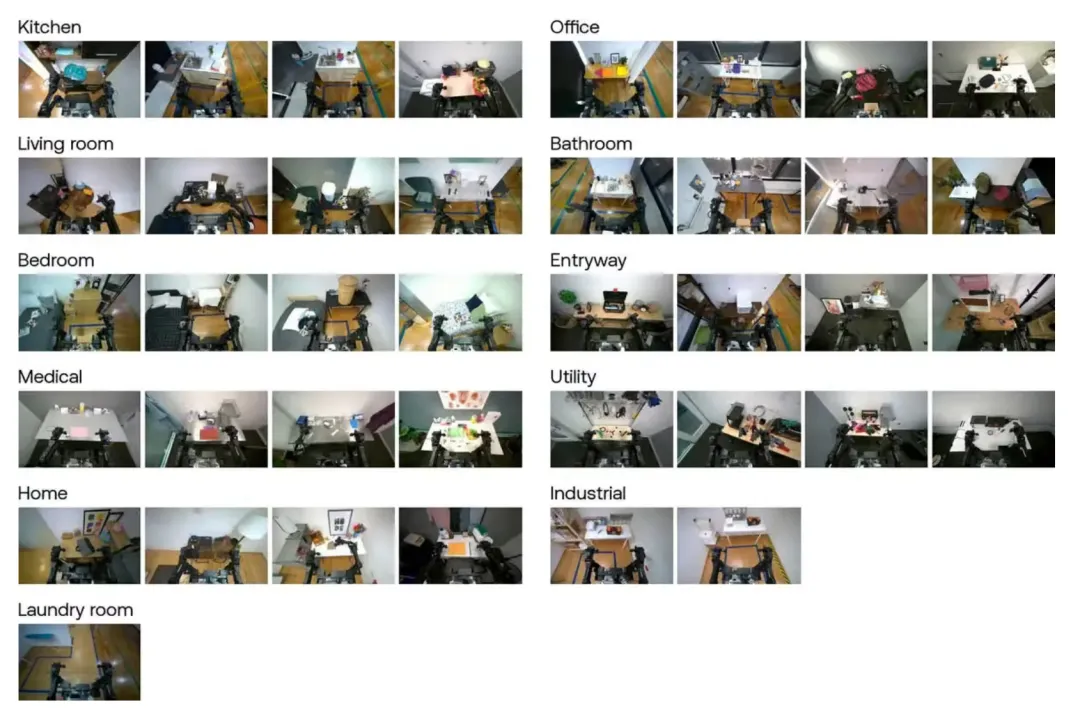
图 7:不同场景类型,每种场景类型最多展示来自四个不同采集站点的一帧图像。
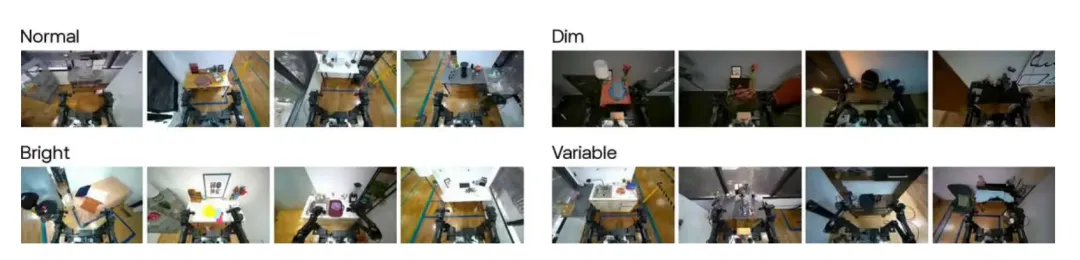
图 8:光照条件,每种标签展示来自四个不同采集站点的四帧图像。
多样性最高的任务
此前我们分析的是整个数据集的总体情况。接下来,我们将研究每种任务内部的多样性。
为了保证比较公平,我们从每种任务中随机抽取相同数量的录制视频,即 200 段,以消除数据量较大的任务所带来的偏差。
在至少拥有 200 段录制视频的 270 种任务中,我们从七个维度进行评分,涵盖任务涉及的采集站点和物体数量,以及不同视频片段之间的差异程度(详见附录)。
最后一个指标是 Vendi Score,用于衡量一组视频片段中真正不同的内容数量。该指标依据下一节介绍的 VLM 视频 Embedding 计算。
“Put supplies away”(收拾物品)是多样性最高的任务,另有几种任务的表现也与之接近。下面将多样性最高的任务与中位数任务进行比较:
| 衡量指标 | Put supplies away | 中位数任务 |
|---|---|---|
| 任务物体数量 | 24 | 2 |
| 背景物体数量 | 127.5 | 59.7 |
| 视频片段的 Vendi Score | 43.1 | 16.1 |
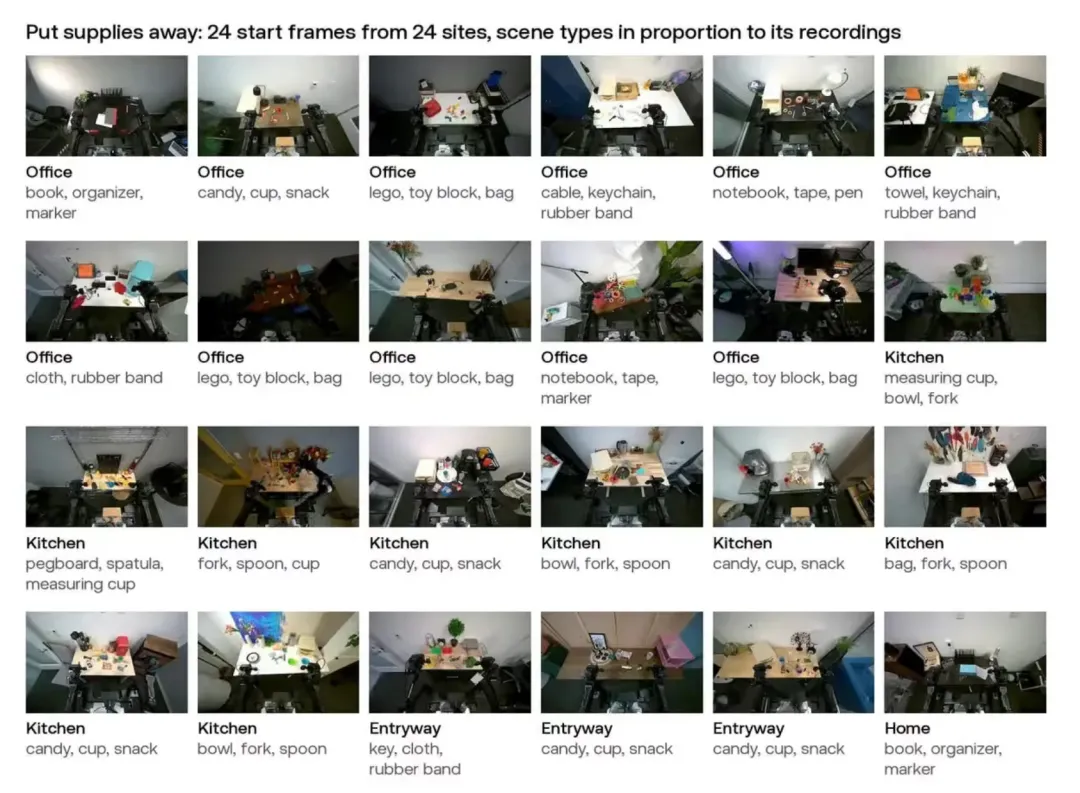
图 9:“Put supplies away”任务在 24 个不同采集站点执行,覆盖了该任务涉及的全部 24 种物体。
每帧图像均标注了场景类型以及最多三个任务物体。图像的选择优先展示新的采集站点,其次展示新的物体。
同一种任务,在三个房间中执行
“Put supplies away”任务分别在办公室、厨房和入口区域中执行。
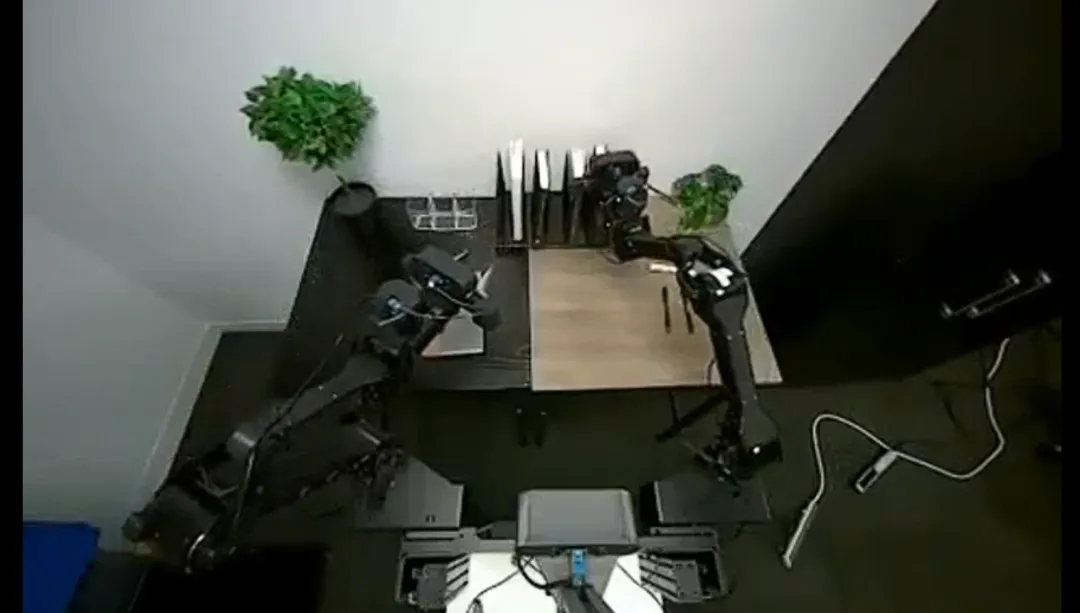
图 10:办公室。
“将黑色书本放入桌面文件整理架最右侧的隔间中”(5.2 秒):深色桌面上摆放着一盆绿植。
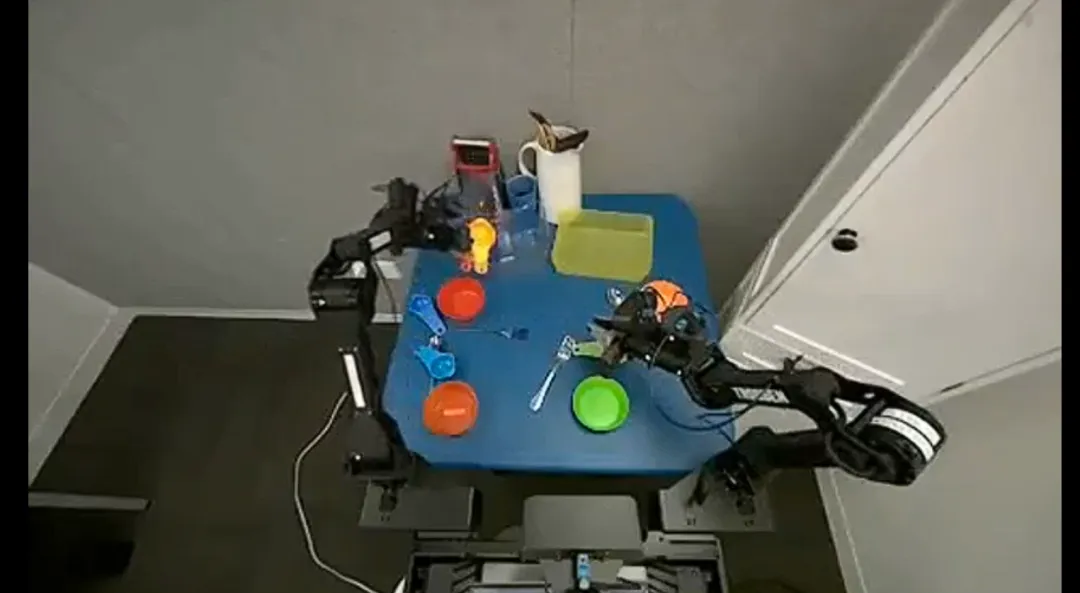
图 11:厨房。
“将量杯放入容器中”(5.1 秒):蓝色桌面上摆放着多个彩色碗。
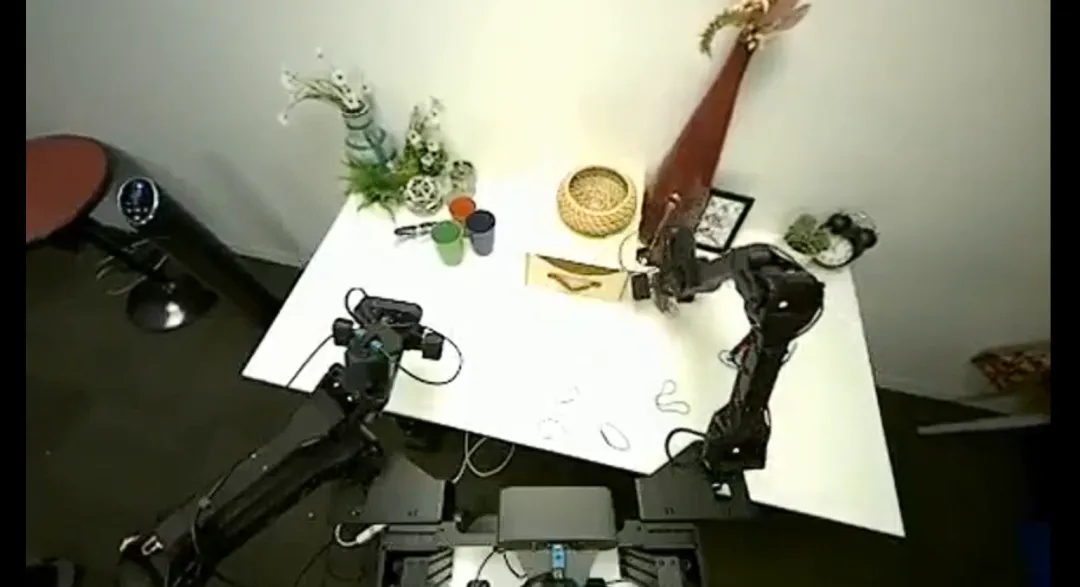
图 12:入口区域。
“将绿色橡皮筋从桌子上移到一叠橡皮筋上”(7.2 秒):白色桌面上摆放着一个柳编碗、植物和多个彩色杯子。
模型如何观察这些数据
机器人 Policy 并不会直接看到我们定义的场景标签。它接收的是像素信息,并且通常还会接收文字标注,这些信息经过学习得到的 Encoder 进行处理。
因此,我们使用五种模型,将每个子任务转换为一个向量,并研究每种模型能够准确识别哪些信息:
VLM 文本标注 Embedding(VLM text):使用视觉语言模型 Qwen3-VL-Embedding,仅输入文字标注。
WM:使用视频世界模型 V-JEPA 2.1,在视频片段中均匀采样 16 帧。
VLM 视频 Embedding(VLM video):使用与 VLM text 相同的 Qwen3-VL-Embedding 模型,以每秒一帧的频率处理视频片段(每段视频包含 4 至 64 帧)。
DINO:使用图像模型 DINOv3,仅输入一张场景图像,即视频片段的第一帧。
π0.5:使用机器人 Policy π0.5 中的视觉语言部分,同时输入同一张第一帧图像和对应的文字标注。
所有图像均来自机器人的顶部摄像头,不使用腕部摄像头。π0.5 是我们测试的唯一一个同时接收图像和语言标注的模型。
VLM 文本标注 Embedding
首先,我们分析 VLM 文本标注 Embedding 空间。该空间将每条文字标注转换为一个向量,使语义相似的文本获得相似的向量,并在 Embedding 空间中彼此靠近(图 13A)。
部分动词在该空间中具有密集的表示。例如,“hand off”(递交)在 Embedding 空间中部形成一个较长的聚类:94% 的相关子任务都位于以该动词为最常见动词的区域中。
相比之下,place、move、reposition、push 和 stack 等动词则分布在不同的混合区域中(图 13B)。
当我们使用 K-means 将文字标注划分为 128 个聚类时,发现这些聚类更多地遵循物体类别,而不是动作类别。
对于每个聚类,我们还提取了文字标注中出现频率最高的三个词语(图 14)。
我们使用 AMI(Adjusted Mutual Information,调整互信息)分数来衡量不同分组之间的相关性。AMI 用于评估两种分组方式的一致程度:0 表示一致程度相当于随机结果,1 表示完全一致。
在最大的 20 个聚类中,有 18 个聚类的高频词中包含物体名称。此外,这些聚类与文字标注中的物体类别具有更高的一致性(AMI 为 0.44),而与动词类别的一致性较低(AMI 为 0.21)。
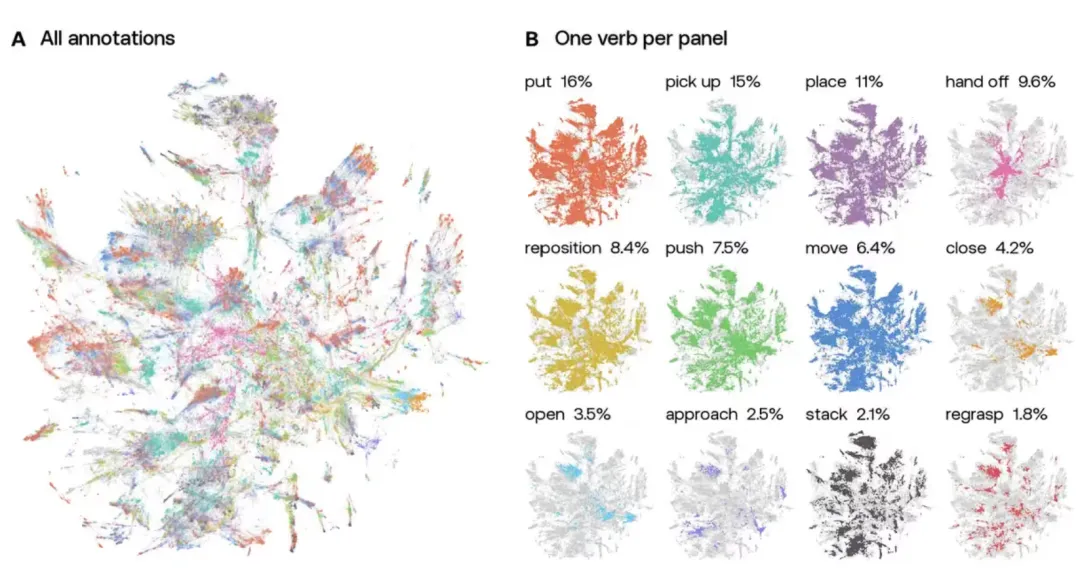
图 13:
(A) 全部文字标注:共包含 251 万条不同的标注。每条标注根据其占比最高的动词进行着色,并映射到 VLM 文本标注 Embedding 的 UMAP 空间中。其他动词对应的子任务占比为 12%,以浅灰色显示;同一条文本被更多子任务使用时,颜色会更深。
(B) 每个面板对应一种动词,展示子任务数量最多的 12 种动词在同一 Embedding 空间中的分布,并标注每种动词对应的子任务占比。
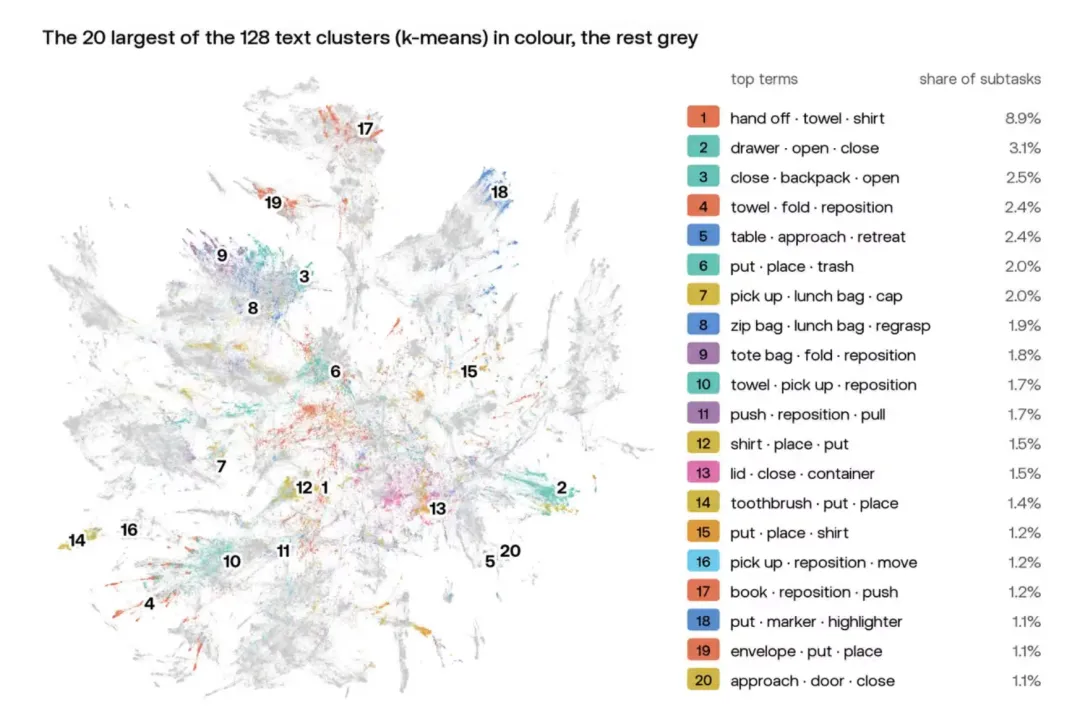
图 14:128 个文字标注聚类中规模最大的 20 个,每个聚类根据出现频率最高的三个动词和物体词语命名。
视觉 Embedding 空间
在 WM 和 DINO 的 Embedding 空间中,每个聚类主要与某一种房间类型相关联。
VLM 视频 Embedding 空间中存在一个较大的区域,其中厨房和办公室场景相互重叠。π0.5 的部分聚类则可以仅根据场景进行区分。
相比之下,VLM 文本标注 Embedding 与场景类型之间缺乏相关性,因为“拿起毛巾”这样的指令可以在多种不同场景中出现。
图 15:每一列对应一种模型。
(A) 场景类型:展示各模型 Embedding 空间按照场景类型着色后的结果。在 VLM text 列中,根据每条文本最常见的场景类型着色。不同场景类型重叠的区域会呈现混合颜色,颜色亮度则反映数据点的密度。
(B) 六种规模最大的任务:在相同的 Embedding 空间中,将每种任务对应的数据点以橙色显示,其余视频片段以灰色显示,括号内为该任务的数据时长占比。在 VLM text 列中,每条文本按照其所属子任务中最常见的任务进行统计。
在纯视觉 Embedding 中,每种规模最大的任务都形成了一个区分明显的聚类。
需要注意的是,这里的 Embedding 空间被压缩成二维可视化结果,因此可能产生误导。下面的最近邻分析直接基于原始向量进行,而不是依赖二维可视化结果。
最近邻分析
为了理解 Embedding 空间实际表达了什么,我们提取每段录制视频距离最近的 10 个邻居,并检查这些邻居是否具有相同的标签,包括房间类型、任务、物体和动词。
我们使用 κ 作为评价指标:0 表示结果与随机邻居相当,1 表示所有 10 个最近邻始终具有相同标签。
我们只从其他采集站点中寻找最近邻,确保匹配结果不会来自同一任务在同一个房间内的重复录制。
图 16:在 100 万条采样子任务上计算的 κ,最近邻来自其他采集站点。
这里没有展示 VLM 文本标注 Embedding,因为该模型只接收文字标注,不包含图像信息。
在纯视觉模型中,最近邻之间匹配程度最高的是场景类型(κ 为 0.512 至 0.642)。相比之下,任务(0.103 至 0.317)和主要操作物体(0.144 至 0.423)的匹配程度要低得多。
不同 Embedding 空间擅长表达什么?
图 16 展示了不同 Embedding 空间在场景、任务、动词和物体四个维度上的最近邻匹配情况。不同 Embedding 对特定标签的表达能力存在明显差异。
VLM video:在跨采集站点的比较中,对任务(0.317)和物体(0.423)的表达能力最强。
DINO:仅凭单帧图像,对场景类型的表达能力最强(0.642)。
π0.5:对动词的表达能力最强(0.763),明显高于纯视觉模型,后者最高仅为 0.141。
在采集站点分析中,WM 区分不同站点的能力最强。采集站点能够解释 0.37 的变化量,是 VLM video Embedding(0.17)或 DINO(0.19)的两倍。
然而,在三种纯视觉模型中,WM Embedding 空间对房间类型、任务、物体和动词的表达能力反而最弱。
这里需要说明一个限制:π0.5 的任务标注输入本身就包含动词。因此,其 Embedding 能够表达动词信息,说明模型保留了这部分信息,但并不一定意味着它能够从输入图像中推断出动作。
结论
数据时长是描述机器人数据集最简单的指标,但它无法充分说明机器人实际上看到了什么,以及机器人如何与真实世界交互。数据时长如何分布、物体和场景具有多大多样性,以及模型的 Embedding 空间能够区分哪些信息,都能提供更加丰富的认识。
从 Embedding 空间来看,纯视觉模型主要捕捉机器人所处的位置和场景,而不是机器人正在执行什么动作:最近邻之间的场景类型匹配程度,远高于动词匹配程度。
VLM 文本标注 Embedding 能够区分不同动作,但其聚类更多地按照物体进行组织。我们测试的 VLA 对动词的区分能力远高于任何纯视觉模型。
不过,该 VLA 的语言输入中也包含动词,因此这一结果说明模型保留了动作信息,但并不能证明它能够仅凭像素推断动作。
数据集的每个维度都存在长尾分布。包括我们此前研究在内的大多数长尾研究,主要关注任务分布,但动词、物体和场景的分布同样不均衡。
这些维度的长尾分布是否能够像任务长尾分布一样帮助提升 Policy 性能,目前仍是一个开放问题。
随着 Scale 持续扩大高多样性的机器人数据采集与操作规模,我们将继续研究这些多样性维度和长尾分布对 Policy 性能及泛化能力的影响。
附录
名称
不同拼写形式统一使用同一个标签(例如 zipper bag → zip bag)。动词则保留原始标注形式。
有效数量(Effective Number)
有效数量定义为 Shannon 熵的指数:
该指标也称为一阶 Hill 数(Hill number of order 1),记作 (Hill, 1973; Jost, 2006)。
当所有类别所占比例相同时,该指标等于类别总数;当少数几个类别占据主导地位时,该指标则会下降。
Vendi Score(Friedman & Dieng, 2023)采用相同的思想,但计算依据是样本之间的两两相似度,而不是标签数量。
AMI
AMI 表示两种分组方式之间经过随机性校正的互信息。
动词标签和物体标签的分布并不均衡:最常见的 50 种动词覆盖了 99.8% 的文字标注,而最常见的 50 种物体仅覆盖 56.0% 的文字标注。
向量与可视化地图
对于每种模型,我们首先对向量进行中心化处理,再通过 PCA 将其降至 128 维,随后进行单位长度归一化,并使用余弦相似度进行比较。
π0.5 的向量还经过 Whitening(白化)处理,即将每个方向上的方差重新缩放至相同水平,因为其原始向量中有少数几个方向占据了主导地位。
所有可视化地图均使用 UMAP 绘制。
κ(最近邻一致性)
κ 表示一段录制视频的 10 个最近邻中,与其具有相同标签的邻居所占比例,并经过重新缩放,使随机邻居对应的得分为 0。
该指标以子任务为单位计算。
多样性最高的任务
为了公平比较不同规模的任务,我们为每种任务抽取规模相同的随机样本。
从每种任务的 200 段录制视频中,我们统计六个维度:
不同采集站点的数量;
场景类型的数量;
光照条件的数量;
任务物体的数量;
背景物体的数量;
动词的数量。
第七个指标是该任务 2,000 个视频片段在 VLM video Embedding 空间中的 Vendi Score。
每个数量指标通过 100 次随机抽样计算平均值,Vendi Score 则通过 5 次计算取平均值。
随后,我们分别按照七个指标对所有任务进行百分位排名,一个任务的最终多样性得分,就是其七项百分位排名的平均值。
Vendi Score(Friedman & Dieng, 2023)表示一个集合中不同样本的有效数量,通过计算集合中每一对样本之间的相似度得出。
由于 Vendi Score 的数值取决于所使用的 Embedding 模型,因此它适合在同一个模型内部比较不同集合,而不适合直接比较不同模型的结果。
来源:human five