哪些是真进展,哪些只是营销?
——从架构、数据到具身智能
三年,足以让一个技术领域更换整体结构。
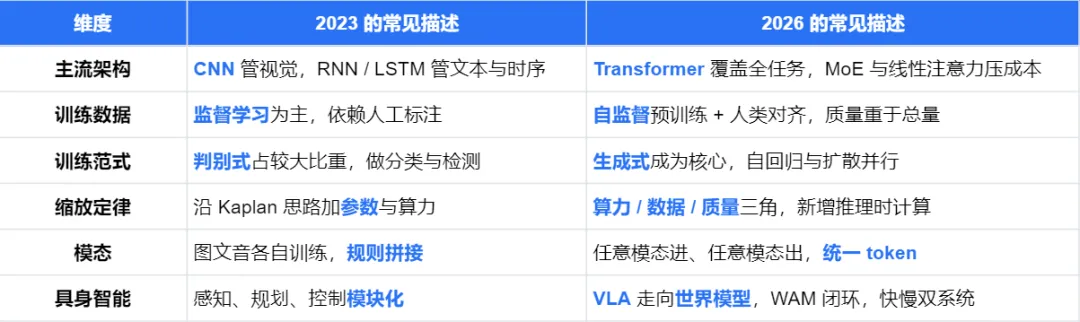
2023 年做模型选型,文档里写的是 CNN 提特征、LSTM 管时序、BERT 做微调;2026 年同一份文档,热词换成了 Transformer、MoE、VLM。
不少项目借着热词疯狂融资,融不动了换个概念继续。
当下流传比较广的,就是一套工整的进化逻辑:
CNN → Transformer、监督 → 自监督、判别 → 生成、堆参数 → 算力数据质量三角、模态拼接 → any-to-any、模块化具身系统 → VLA → 世界模型。
三年时间,确实足够一个领域完成底层架构更迭,但也够一套说辞完成自我美化。
这套说法里,哪些是已经“落地的机制”,哪些只是“概念先行”?
不急着下结论,先看四条辅助佐证的标准。
能复现、能消融、能外推、能省钱
结合当前工程研究中对技术有效性的主流核验思路,大多有如下四个维度的判断标准:
第三方能复现同一结论;
消融实验显示抽掉该组件后指标明显下降;
规模放大一个数量级后结论仍然成立;
真实部署中延迟或成本确有下降。
营销则是,旧概念改名,借用认知科学隐喻,使用无法度量的形容词,把尚未实现的目标写成现状。
打个比方,如果用这套标尺审视整张对比图,第一个需要警惕的陷阱,就是基线选择。
2023 年并不是“判别式为主”的一年:
扩散模型(生成式)当时已是图像生成的主线,RT-2 在同年证明网络数据上预训练的视觉语言知识能迁移到机械臂动作。
如果把2023年定义为“判别式主导”,等于把参照系往前挪。这种做法叫调低基线,放大所谓进步幅度。
整体复盘后我们发现:真正“靠得住”的是架构和缩放定律中的一部分;多模态只守住输入端;具身智能的营销属性占比可能更多一些。
这六个维度没有一个能完全划分为“真 or 营销”。
因此,更实用的做法是把每个维度切分成已实现的机制和未实现的承诺,而不是整体接受或整体否定。
按照这个标准,先来看第一个维度:主流架构。
主流架构:主干是真的,统一是夸张修辞
Transformer 在视觉和语言主干上的地位不必过多赘述。典型的如ViT,把视觉和语言塞进了一个模型里,而且效果还行。
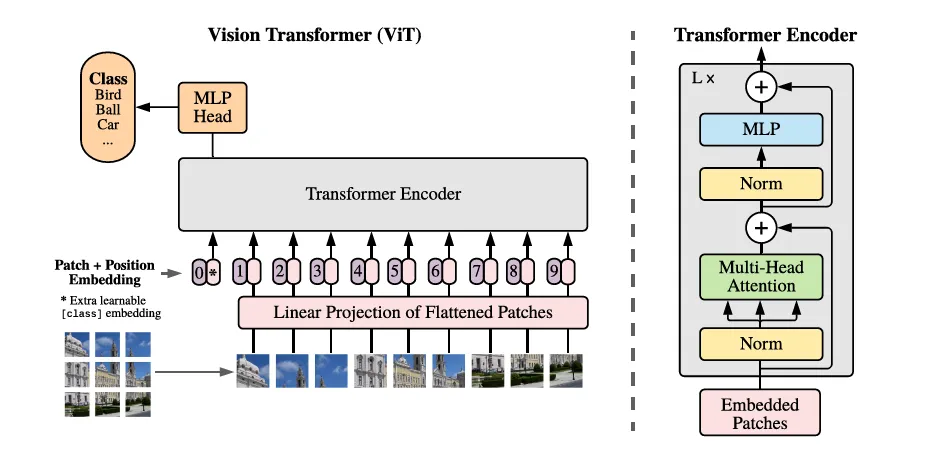
▲图 | ViT是Transformer在视觉方面的应用
存疑的是“一统所有任务”这个论断。
卷积网络在边缘设备和实时视觉里仍是主力,参数量与延迟的硬约束决定了它不会被替换。
与此同时,真正构成挑战的是状态空间模型体系:
“线性注意力补充”这半句需要单独拆开
标准 softmax 注意力能精确回忆序列中任意位置的内容,这项能力被称作关联召回(associativerecall),测试方法很直白:
先给出一串键值对,随后只给键,看模型能否原样取回值。纯线性注意力把注意力压成固定大小的状态,在长上下文回忆任务上明显落后。
这属于结构决定的差距,与实现细节的粗糙无关。
把它写成通往统一的路径,等于把一条受限制的支线抬高成主干。
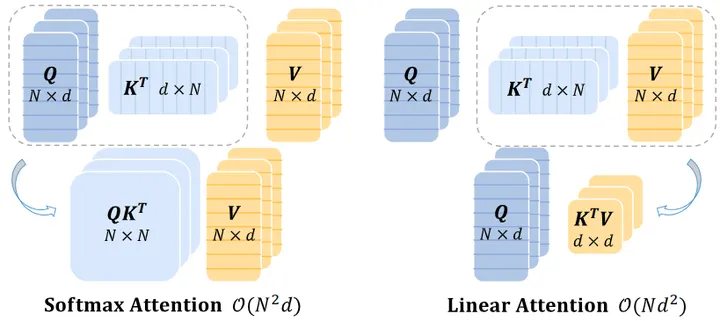
▲图 | 线性注意力是循环神经网络RNN思路,来自网络
混合专家(MoE)是三年里最扎实的工程进展之一
稀疏激活让参数量与计算量脱钩,同样算力可以换来更大容量。代价也同样具体,全部专家需要驻留显存,专家并行引入跨卡通信,路由塌陷时少数专家被挤爆而其余闲置,因此需要负载均衡手段约束。
DeepSeek用无辅助损失的路由方案缓解了这个问题,可复现。
评价一个架构变化,其实看它在既有约束下换来了多少实际吞吐,比看它是否统一更有意义。
训练数据:自监督是真范式变革,数据质量却沦为难以量化的托词
自监督预训练取代纯监督学习,这一点也许是三年里最没有争议的变化,它改变了整个行业的生产方式:
模型先在无标注语料上获得通用表征,再拿少量标注数据做适配,数据的标注从瓶颈变成可选项。
图像侧的掩码重建是同一思路的视觉版本,遮住一块区域让模型补全,补全得好意味着它理解了构图与材质。
数据治理的收益同样可以复现:
FineWeb和DCLM这类工作把过滤、去重、语言识别、质量分类做成流水线,同规模下确实带来更好的下游指标。
问题出在“质量胜过数量”这句
质量本身无法度量,一旦成为共识,它就变成给任何筛选策略背书的万能理由:谁都说得通,谁都无法被证伪。
它还掩盖了真实情况:前沿模型的数据量仍在上涨,Llama3一类模型的训练token数比三年前高出一个数量级,只是过滤更狠。
这句口号在工程上成立,在叙事上被用来解释一切。
人类对齐这方面需要降温
RLHF 分三步:先让人对两个回答做取舍,再用这些取舍训一个打分模型,最后用强化学习把语言模型推往高分方向。
它压缩的是标注者关于“哪个更好”的判断,与价值观本身并不等同。把偏好优化叫成人类对齐,抬高的不是技术,是承诺。要检验就一句,对齐之后模型在分布外场景的价值观稳定性有没有测过。
多数论文没做。
训练范式:判别与生成是个假二分
把 2023 年说成判别式为主、2026 年说成生成式为核心,这个对照三年前就失效了。
更根本的问题是两者从来不是对立的路。
同一次前向里模型同时在判断和生成:
嵌入模型与重排器做纯判别,CLIP用对比学习把配对的图文拉近、不配对的推远,相似度就是余弦值;
扩散模型每步都在估计噪声方向,这本身就是判别过程。把两者排成时间轴上的前后两段,是分类学上的偷懒。
▲图 | 训练范式从简单到复杂
真正发生的变化在接口层面
过去每个任务配一个专用模型,现在一个生成式底座接上不同提示和解码约束,就能覆盖分类、抽取、改写、翻译。
统一起来的是接口而非能力。这解释了为什么精度敏感的检测与分割仍在用专用小模型,它们只是被包进了更通用的调用方式。
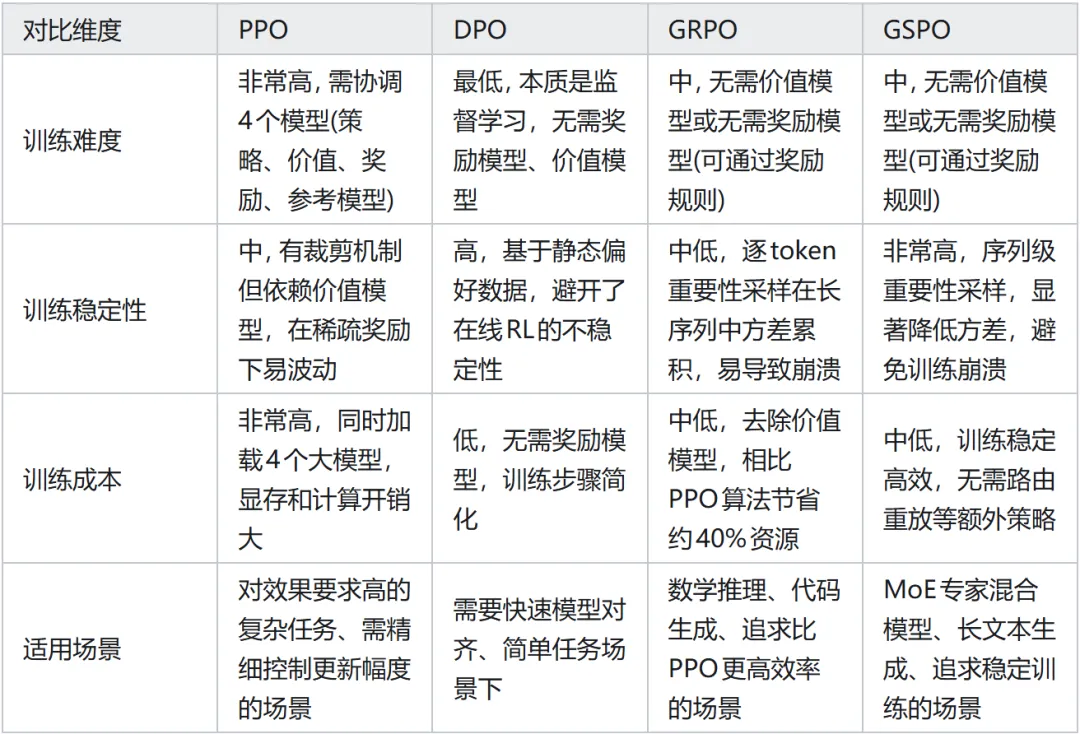
▲图 | 各种训练范式对比
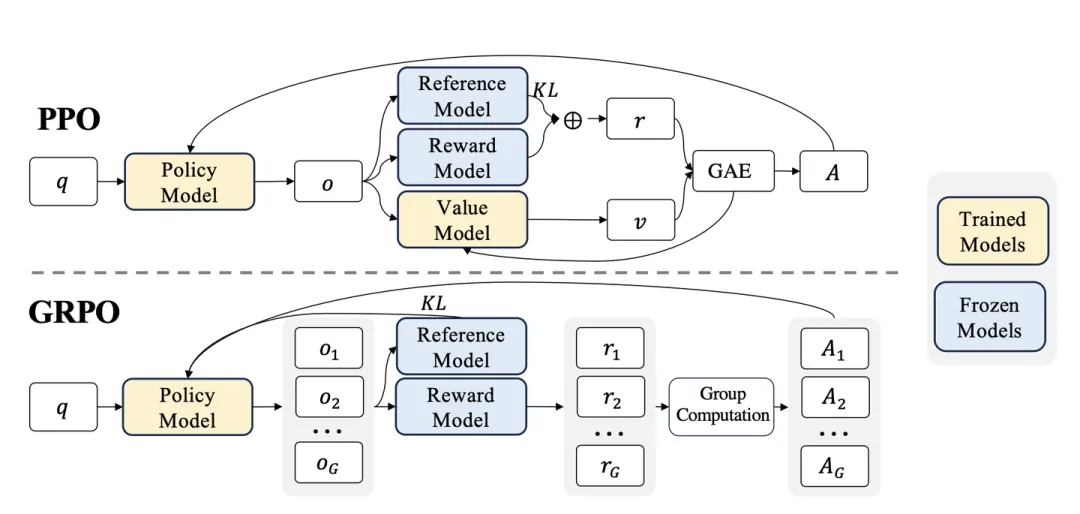
对齐算法的演进是三年里可复现的方法进展
DPO的关键一步是把“人类更喜欢哪个”直接写成损失函数:提高偏好回答的相对概率,压低被拒回答的概率,省掉打分模型和强化学习两段流程。
GRPO再进一步,对同一问题采样一组答案,用组内平均分当作基线代替价值网络,显存和调参成本都降下来。
每次简化都对应一个被验证的效果与成本权衡。这类工作比较纯粹,可以复现,同时也能用反例挑战。
缩放定律:从单一最优点到双轨修正
提到缩放定律,就不得不提 Chinchilla,DeepMind 在 2022 放出的一个大模型,第一次系统性地纠正了 Kaplan 缩放定律中“参数优先”的偏差。
它给出的结论可以用一句话概括:给定算力预算,参数量和训练token数存在一个最优比例(大约一个参数配二十个token)。
此前全行业参数给得太多、数据给得太少。这条结论改变了一整代模型的数据配比,也让一批按旧配方训出来的大模型显得浪费。
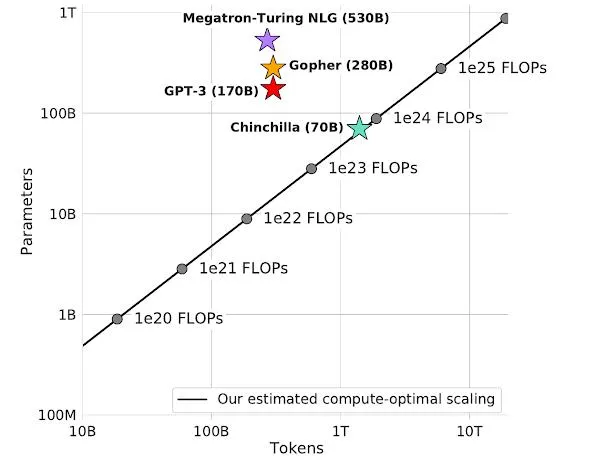
▲图 | Chinchilla 既是 DeepMind 在 2022 放出的一个大模型,同时也是一套改写行业路线的缩放定律(Chinchilla Scaling Laws),原文:Training Compute-Optimal Large Language Models
后续还有一次更重要的修正。业界发现,为了摊薄推理成本,故意把模型训练得远超算力最优点反而更划算。
这种做法叫过度训练。
Llama38B用了15Ttoken,是算力最优配比的好几倍,换来一个能在廉价硬件上长期服务的模型。缩放的最优点取决于训练成本与推理成本的比例,这条结论比任何一条固定曲线都实用。
所谓“算力数据质量三角”站不住脚
质量不是缩放定律里的变量,它无法度量,放不进公式。硬塞进三角,是把比喻放到了公式的位置。
真正该进公式的是推理预算,也就是每个token愿意付出多少算力,它可测可调,在推理时计算这条线上已成独立维度。
推理时计算是这一维度真正的转折
做法是让模型生成多条候选,再由验证器挑选,验证器可以是另一个模型,也可以是单元测试这类可执行的结果检查。评估口径随之变化:
pass@k只看k次采样里有没有一次答对,等于奖励运气;
maj@k要求k次里多数一致答对,才真正反映稳定能力。
它确实改变了算法形态,也很早撞上收益递减,两倍左右的提升之后投入产出迅速坍塌,这一点常被刻意忽略。
多模态:输入端在合并,输出端没有
先看输入端
输入端比三年前宽得多。图像、视频、音频、文档都能进同一个模型。语音这块出现了无分词器路线,Moshi直接把音频波形编码进语言模型,去掉了“先识别成文字再合成语音”这一层转写,延迟和语气信息保真度都改善,是真实突破。
再看输出端
输出端没有统一。主流做法仍是晚融合:每种模态先由自己的编码器转成向量,再在语言模型输入层拼进同一条序列。LLaVA是这个范式的起点。图像和视频生成基本还是外挂扩散模型,靠提示把两段流水线串起来。
真正尝试早期融合的模型撞上硬问题,Chameleon在图像token上有进展,文本性能却退化,原因是离散视觉token与文本token共享同一个预测头,词表容量被摊薄,两边互相干扰。
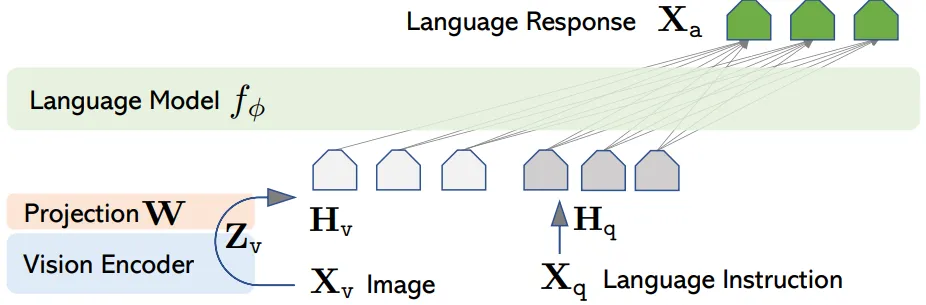
▲图 | LLaVA架构图,输入多模态实际是把不同模态输入编码到同一空间
所以“任意模态进任意模态出”更接近“宣传”文案。
可复现的事实是模态更多、连接更紧,不可复现的是统一。
判断这类声称有个直接办法:看输出端是否真由同一个解码器产生。如果图像要靠另一个模型生成,那这个系统就是流水线。
具身智能:承诺跑在证据前面的领域
视觉语言动作模型是真研究
RT-2证明网络数据上预训练的视觉语言知识能迁移到机械臂动作;OpenVLA把这条路线开源复现。
π0用流匹配生成动作序列,流匹配学的是一个从噪声到动作的连续速度场,采样步数比扩散少,控制频率因此能提上去。扩散策略同样可复现,它把动作生成建模成去噪过程,能从随机噪声收敛到一条动作轨迹,对多峰分布的拟合明显优于直接回归,代价是推理更慢。
从实验室到落地有三道关没过。
泛化时,换台面换光照换物体,成功率断崖式下跌。数据角度说,真机采集成本极高,一个任务动辄上千条示教,规模化路径没有共识。安全上,大模型输出的动作没有可验证边界,出错代价是物理损伤。
三关未解之前,任何通用机器人的宣称都缺证据。
世界模型这一块更“抽象”
Genie和Cosmos一类工作展示的是视频预测,画面逼真,但预测下一帧像素与理解物理因果之间的距离没有实验填平。
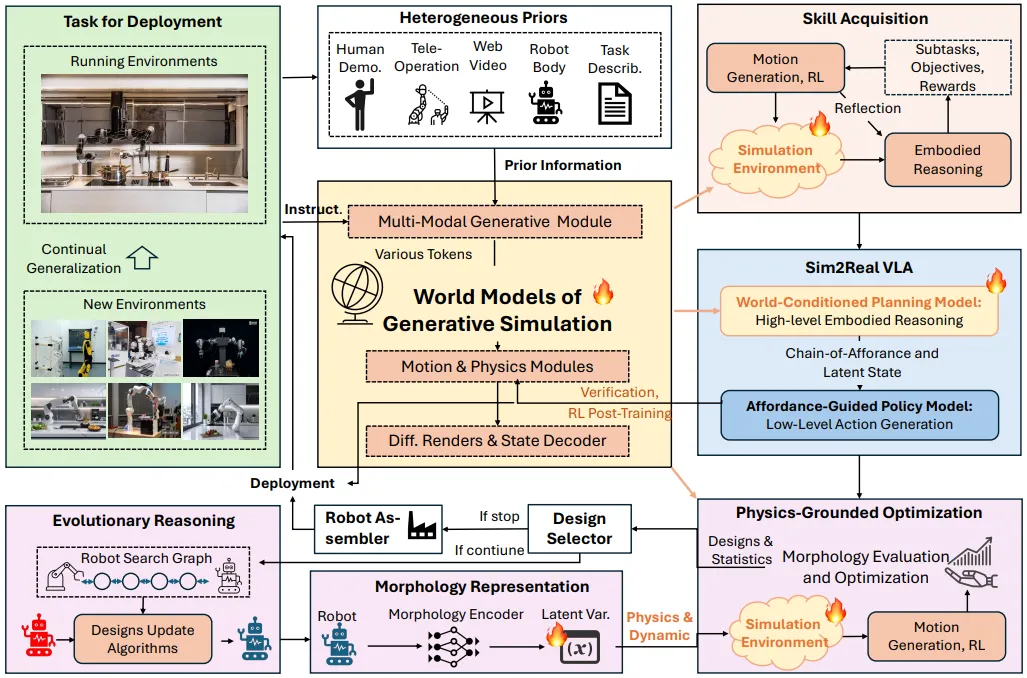
▲图 | 世界模型几乎成了一切推理的核心,衍生出众多概念©【深蓝具身智能】编译
把视频预测当作机器人训练的数据源,目前是设想。过得了视觉检查,不等于给得出可执行动作。
▲图 | WAM路线图,世界动作模型这个概念其实更加增加了世界模型的混乱理解©【深蓝具身智能】编译
概念嫁接在这里格外明显
快慢双系统直接挪用Kahneman的系统一与系统二隐喻,听起来顺,实际耦合方式是工程问题,隐喻帮不上忙,反而掩盖了延迟预算这个真问题。
把真进展从叙事里筛出来
六个方向的成色差异更大。有些叙事确实属于部分营销,比如调低基线,把过去写得比实际更原始,落差就是卖点;
再就是隐喻太多了,世界模型、记忆、系统一与系统二,借认知科学的现成说服力绕开技术论证,不能从计算机和数学原理加以阐释;
缩写泛滥:WAM和any-to-any这类词的功能是造出一个可讨论的实体,哪怕该实体尚未存在。
当然,概念营销不等于完全没有价值,口号就是方向。
术语压缩是复杂系统的必要产物,一个行业没有“黑话”就无法高效协作,也难把研究进度对外同步。
分界点在于它指向什么,指向可复现的实验结果,缩写就是工具;指向尚未存在的目标,缩写就是口号。
技术确实在扎实往前走,架构、数据、多模态、具身控制都积累了大量可核验的进展。只是我们很容易把零散的突破,整理成一条顺滑整齐的进化故事。
我们乐于画出 CNN、Transformer 到 VLA、世界模型的连续箭头,但技术真实路径,从来不是一条“干净”的递进路线。
真实进步往往是局部的、碎片的,让该肯定的继续放大,让该存疑的回到实验。
路线可以不“干净”,进步必须可核验。这比一条漂亮的进化箭头,更接近技术真正走出来的样子。
本文基于论文、技术报告与行业公开资料,部分判断带有主观视角,并非否定该领域方向、团队以及具体研究工作的价值。欢迎同行指正、补充讨论。
编辑|咖啡鱼
审编|具身君
来源:深蓝具身智能