


RoboLab 是 NVIDIA 的模拟基准测试平台。 |来源:NVIDIA
根据 NVIDIA 的说法,机器人基础模型已经取得了显着的进展。当今最好的系统可以遵循自然语言指令来拾取、放置、排序和操作各种对象。
但随着这些模型的能力变得越来越强大,严格评估它们已成为该领域最难解决的问题之一。在这篇博文中,我们介绍了关键问题以及解决这些问题的方法。
为什么当前的基准测试不合格
现实世界的测试成本高昂、缓慢且难以重现。为了彻底评估机器人在现实世界中的表现,我们需要一个合理的代理。仿真是进行大规模机器人评估的自然场所。然而大多数现有的长凳标记有一些关键问题。
训练和评估中的视觉领域重叠
首先,政策训练和评估中使用的数据和环境几乎总是来自相同的视觉源。当模型根据模拟数据进行微调并在相同的模拟环境中进行评估时,强大的性能仅表明模型记住了设置,而不表明它可以泛化。这仍然是机器人评估中的一个关键问题,因为模拟的视觉质量尚未达到与真实世界图像观察同等的水平。
Real2sim 方法通过使用修复或高斯泼溅等技术从真实世界图像重建真实感环境来解决这个问题,但每个场景的设置可能超过一个小时,使得大规模测试不切实际。
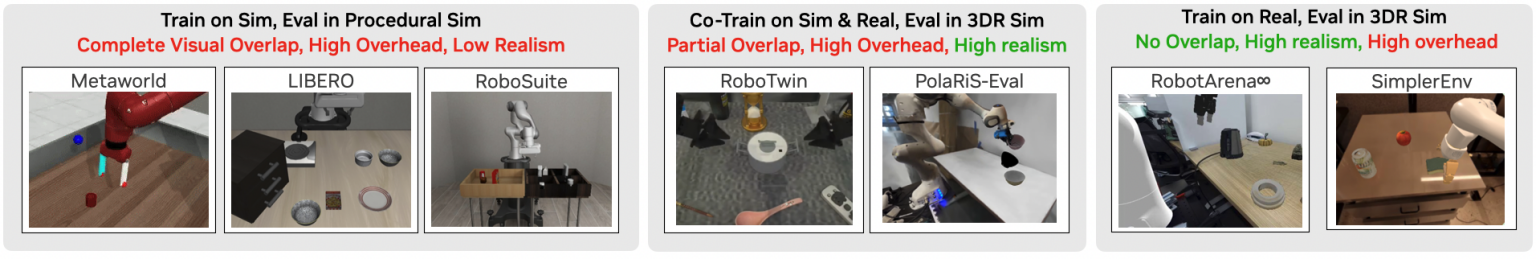
图 1。现有的 sim 基准测试存在视觉和任务域重叠、真实感低的问题,传统的程序场景生成通常会受到渲染质量较低的影响,从而产生较大的 3D 重建 (3DR) 环境,从而为模拟环境带来更多真实感,但通常会以生成每个场景所需的人力为代价。
NVIDIA 引用基准饱和度
其次,生成任务是一项繁琐的工作。st 基准测试有一个很少更新的固定任务集。这很快就会导致性能饱和:模型很快就会在静态任务集上获得最大分数,从而无法区分哪个模型真正更有能力。当每个系统在同一基准上报告成功率超过 90% 时,这些数字就变得毫无意义。
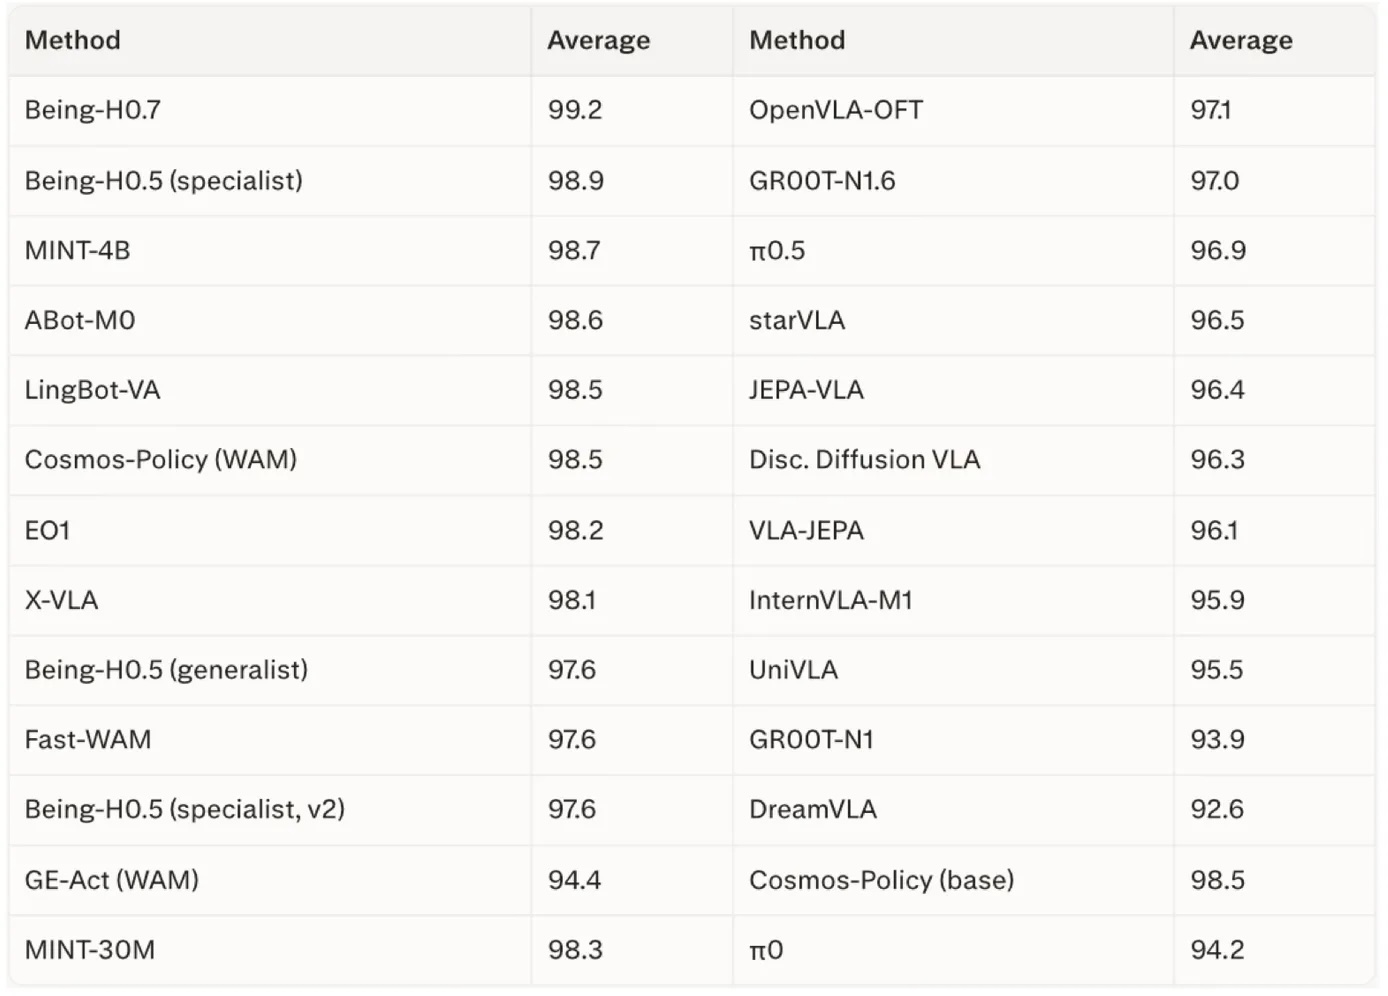
图 2. 几乎所有模型论文都报告了该基准测试的结果,但饱和度使得很难提取有关模型 p 的有意义的结论性能。 |来源:NVIDIA
诊断差距
还有更深层次的诊断差距。二元成功/失败分数并不能解释机器人失败的原因。
它是否被物体的颜色混淆了?指令措辞?移动相机?它是否根据特定的语言指令有效地执行任务?
如果没有这些问题的答案,研究人员就无计可施。

图 3. 策略 pi0.5 的任务“将橙色量杯和蓝色量杯放在盘子外面”的示例评估集。 |来源:NVIDIA
统计可信度
每个物理引擎和策略都受到一定的随机性的影响。 N 次推出的单一成功率几乎无法告诉您对保单的真实表现应该有多大的信心。如果一项政策十分之九成功,那么它是“90% 成功”的政策,还是很容易成为在小样本上幸运的 80% 或 95% 的政策?为了研究这个问题,我们研究了 Clopper-Pearson 方法。
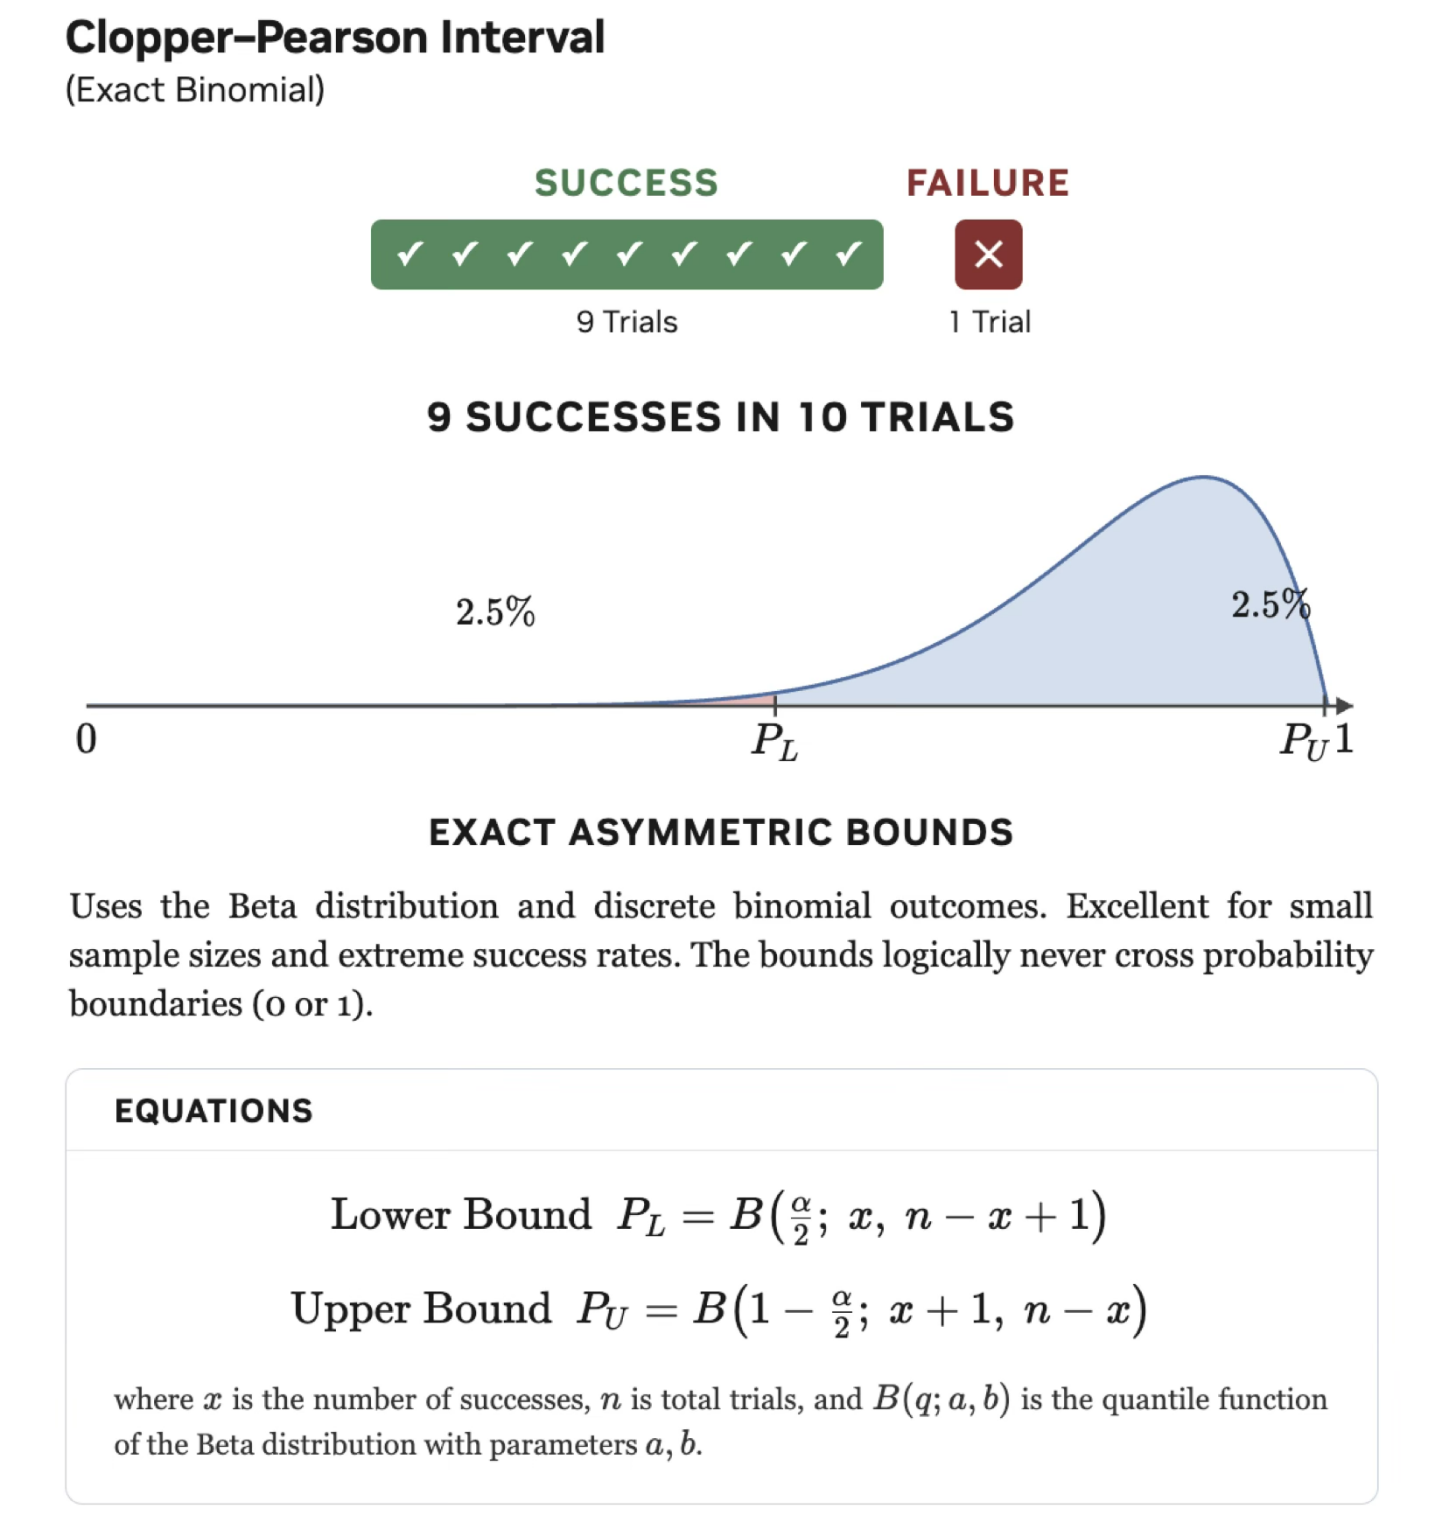
图 4.Clopper-Pearson 区间是一种限制二项式成功率的方法。 |来源:NVIDIA
Clopper-Pearson 方法是一种围绕成功率构建二项置信区间的“精确”方法,直接根据二项分布计算。
让我们看一下以下示例:对于观察到的 90% 成功率(仅 70 次部署),95% Clopper-Pearson 置信区间跨越了整整 15.4 个百分点(80.5% 到 95.9% 的成功率)。经过 1,030 次部署后,该误差缩小至 ±2 个百分点(成功率 88.0% 至 91.8%)。
在比较两种策略的性能时,大多数已发布的基准测试都没有运行足够数量的部署来实现统计显着性。
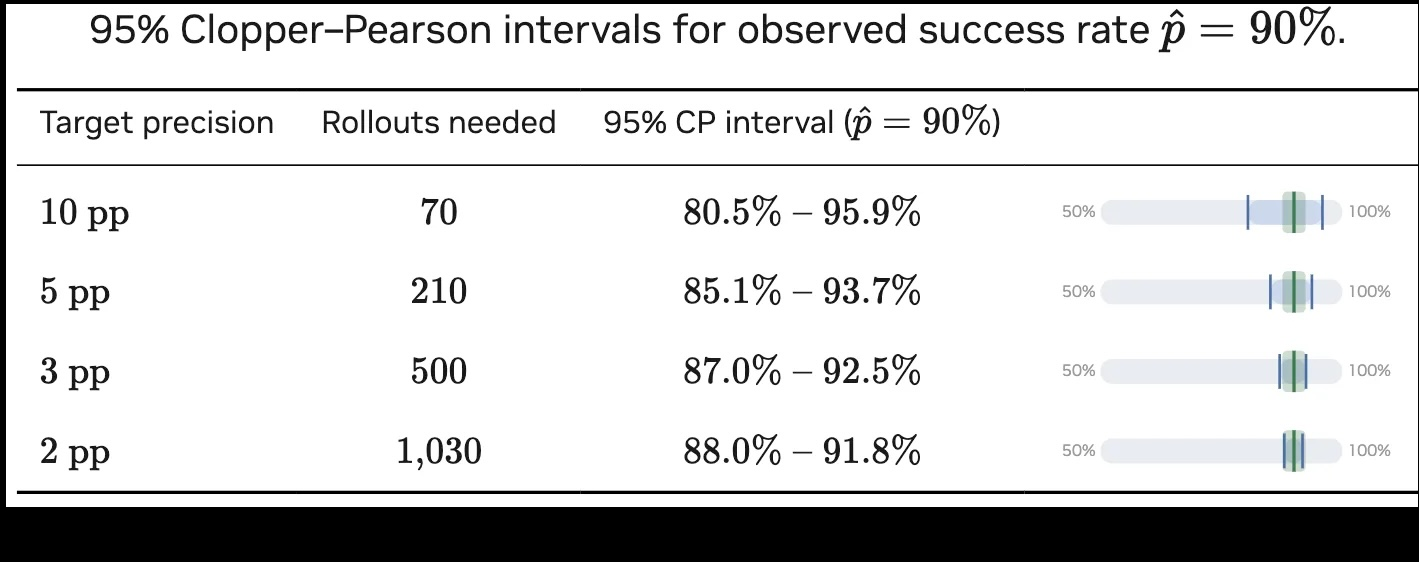
图 5. 95% 的 Clopper-Pearson 区间成功率为 90%,蓝色虚线表示 CP 区间约为 90%。缩小c置信区间从 10 到 2 个百分点需要大约 15 倍的部署量(70 到 1,030)。 |来源:NVIDIA
NVIDIA 推出 RoboLab
NVIDIA 构建了一个名为 RoboLab 的模拟基准测试平台来解决这些问题。 RoboLab 围绕三个原则构建:
- 在提供有意义的指标的同时,实现与机器人无关的任务评估
- 支持代理 AI 工作流程,快速生成新任务以避免基准饱和
- 提供全套分析工具,全面了解策略的执行情况、何时失败以及失败的原因。
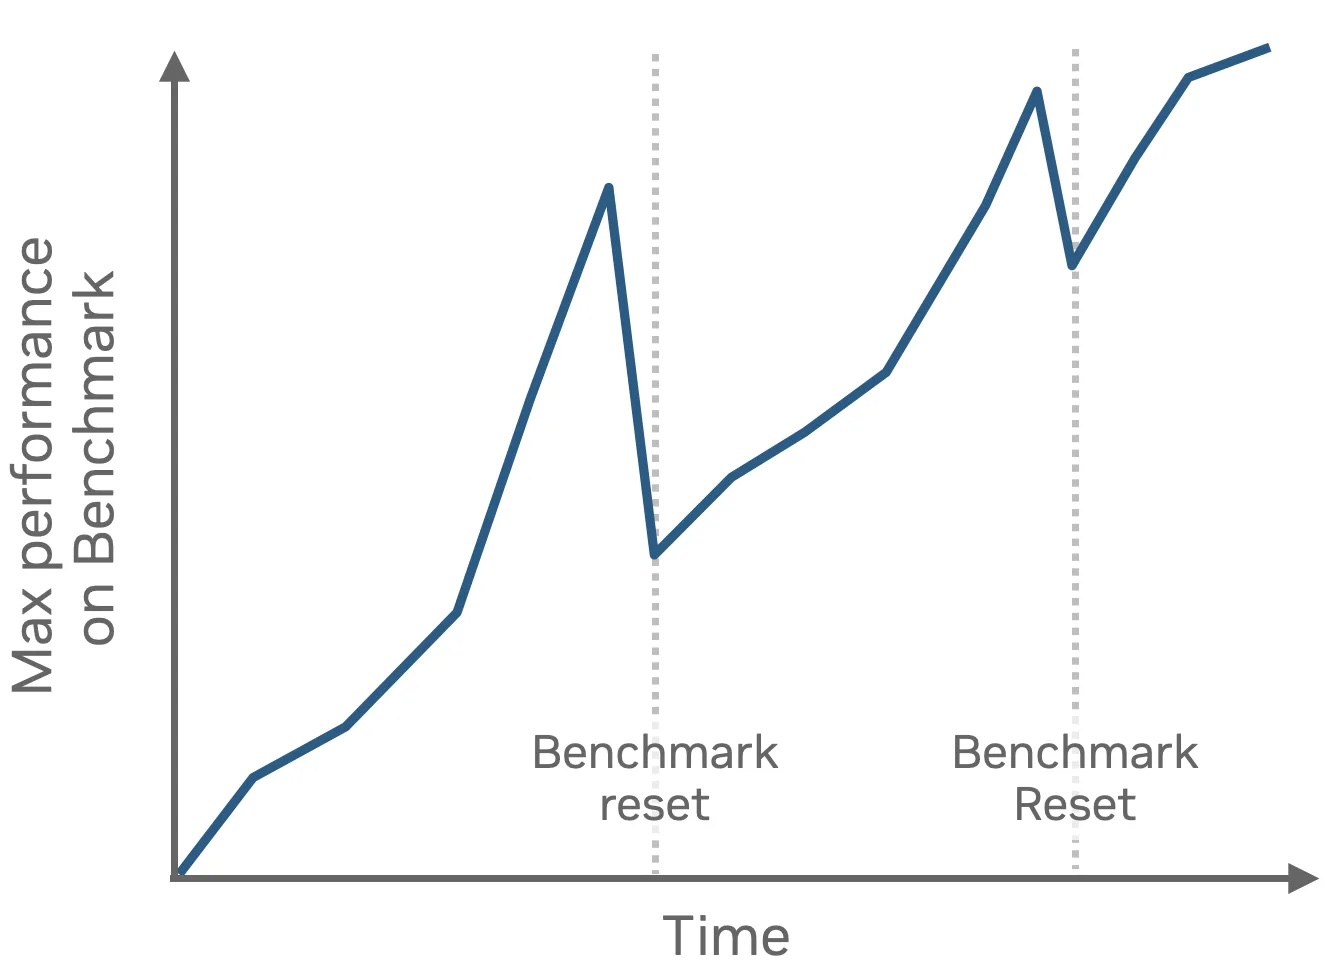
图 6.随着领域的发展,基准测试需要适应新的功能。一旦现有基准性能饱和,就需要调整和扩展基准。| 来源:NVIDIA
代理 AI 时代的机器人基准测试

图 7. RoboLab 的 3 步场景、任务和环境生成过程。 NVIDIA
RoboLab 反映了现实世界的设置过程:放置对象、添加语言指令并运行策略。给定一个对象库,用户只需将对象放置在场景中并为任务指定一个或三个语言指令,整个过程只需几分钟。
RoboLab 还配备了代理技能,编码代理可以使用该技能直接在用户的工作流程中生成新任务。效率也是面向未来的基准:随着通才模型的改进,可以添加新任务并淘汰过时的任务。
带上你自己的机器人
建立通才机器人策略需要解决长尾的特定任务,并且没有一个团队拥有跨每个实施例的丰富数据。实验室在弗兰卡手臂上可能有数千小时的时间,但在人形机器人上几乎没有时间,反之亦然。与一个特定机器人相关的基准测试迫使每个用户陷入相同的数据差距,无论他们实际尝试构建或测试什么。
RoboLab 任务与机器人和策略无关,这意味着无论机器人实施方式或策略架构如何,都可以评估同一组任务。用户可以自由做出自己的设计选择; RoboLab 只需针对他们带来的任何机器人编译相同的场景和任务。
随着未来机器人实施例选择数量的增加,这也是有意义的;使用哪个机器人进行数据生成和训练并不重要g,只是它解决了任务。
特定于功能的任务
有用的基准需要隔离不同的功能,而不仅仅是衡量机器人是否完成任务。我们观察到,通用操作至少依赖于三种不同的能力:
- 视觉能力测试策略是否能够识别颜色、大小和语义类别等感知属性并对其采取行动,例如区分小红杯与桌子上的其他物体。
- 程序能力评估面向操作的推理:堆叠对象、重新定向它们或推断如何与工具交互。
- 关系能力探究空间和语言逻辑,包括连词(“挑选橙子和酸橙”)、计数以及相对位置(例如左侧或内部)。
通过设计每个针对一项或多项特定能力的任务,我们可以确保广泛覆盖通用政策所需的全部技能空间。在RoboLab-120 是我们 120 项人工策划的桌面拾取和放置任务的初始基准,每个任务都标记有其所需的多种功能,因此基准对各个能力的覆盖范围保持明确和平衡,并随着新任务的添加而进行调整。
| 能力 | 测试内容 | 示例任务 |
|---|---|---|
| 视觉 | 颜色、大小、语义识别 | “将红色小杯子放入垃圾桶中” |
| 程序 | 堆叠、重新定向、可供性 | “将所有杯子正面朝上放置,并将红色杯子放在垃圾桶上架子” |
| 相对化 | 空间逻辑、计数、连词 | “摘橙子或酸橙并将其放入碗中” |
评估机器人策略
哪些指标表明机器人策略是好的?
成功率本身几乎无法告诉您机器人如何执行任务,只能告诉您它是否越过终点线。抓住正确对象但过早放弃的策略可以被视为失败,而只有在急躁、蜿蜒或慢动作后才成功的策略可以被视为成功。这两种情况都不会使用二进制成功捕获。
为了解决这个问题,RoboLab 使用了三个额外的评估综合描绘出更完整的政策行为图景的离子工具:
- 分级任务分数:在多步指令中完成子任务会给予部分评分,因此抓住正确物体但错过掉落目标的机器人与什么都不做的机器人的得分不同。
- 轨迹质量:通过路径长度和 SPARC(光谱弧长)测量运动效率与人类一致的度量,通过速度的傅里叶谱捕获平滑度。更短、更平滑的运动是首选。
- 执行速度:测量末端执行器速度,这是另一个与人类相关的指标,可捕捉人类对较快运动是首选的感知。
NVIDIA 识别机器人策略何时失败
了解任务出错的原因与知道任务出错同样重要。除了通常的绩效指标之外,RoboLab 还更深入地研究策略成功或失败的原因以及确切的原因在此过程中,事情会发生故障。
失败事件日志记录会自动跟踪错误的对象抓取、掉落的对象和夹具碰撞,精确定位任务执行脱轨的位置。
让我们观察这个任务:“将所有塑料瓶放入垃圾桶”任务。该政策捡起所有塑料瓶并将其放入垃圾箱。不过,它还在垃圾箱里多放了一个橙子。
可以看出,从技术上来说,任务成功完成了!技术上可以按照规范完成任务,但机器人在恢复之前仍可能沿途抓取错误的物体。

图 8. 三个单独的失败在成功推出“将所有塑料瓶放入垃圾桶”的政策执行过程中发生了一些事件。来源:NVIDIA
为了检查这些事件,RoboLab 包含一个内置仪表板,可显示事件期间发生的事件,以便用户可以直接跳转到发生故障的帧。这将诊断从手动的事后猜测游戏转变为更接近机器人行为调试器的东西。
而不是问“它有效吗?”用户可以询问:“它到底在哪里停止工作,导致该事件的上下文是什么?”

图 9.RoboLab 包含一个内置仪表板,用于查看剧集期间的事件。这允许用户可以快速查看故障何时发生及其背景。 |来源:NVIDIA
针对日益增加的复杂性,您的机器人策略有多稳健?
现实世界的部署很少能提供干净、受控的基准条件。指令的措辞方式多种多样,场景通常是混乱的而不是稀疏的,任务可以跨越多个步骤而不仅仅是一两个步骤。
要了解策略是否真正强大,我们必须针对语言、场景和任务范围日益复杂的情况来分析性能。
语言复杂性
仅理解精确措辞的命令的机器人在实验室外的用途有限,因为人们自然会以各种且不精确的方式表达指令。针对多种语言指令的测试揭示了策略在多大程度上依赖于准确的措辞与真正的任务理解。
RoboLab 使用户能够在其任务规范中指定多种语言指令并选择设置运行时使用哪个变体。在其最初的基准测试中,NVIDIA 提供了三种变体:模糊、默认和特定。
该公司发现模糊的指令始终会导致失败,这表明当前的模型在措辞方面仍然很脆弱。它还了解到,说明中包含太多细节有时也会导致性能下降。

图 10:随着语言命令变得更加模糊,策略会陷入困境。任务是从垃圾箱中取出所有三根香蕉,但随着说明变得更加模糊并且需要更多推理,政策难以理解预期的任务目标。 |来源:NVIDIA
场景复杂性
真实环境很少像训练场景那样整洁,通常包含干扰对象、杂乱和视觉噪声,这些可能会混淆对象识别。随着场景复杂性的增加而评估性能,可以显示策略是否仍然可以在视觉干扰中分离出正确的目标。
任务复杂性:短任务与长任务范围
许多现实世界的任务不是单步操作,而是一系列相互依赖的子任务,其中早期的小故障可能会导致后来的完整任务失败。例如,诸如“将杯子放入柜子中”之类的任务可能需要先打开柜子,然后再拿起杯子。
测量性能随着任务范围的增长而下降的情况可以揭示策略在扩展推理链上维持准确性的程度。任务设计者可以指定 RoboLab 任务中子任务的预期顺序,并跟踪策略的进展情况。我们发现大多数策略都难以处理长期任务,没有任何策略能够成功执行四个以上的复杂子任务。
您的机器人策略对变化的敏感程度如何?

图 11. 可能影响性能的场景变化。在单次部署中测试每个变体的实验数量呈指数级增长。 NVIDIA 引入了敏感性分析,使其能够查明影响性能的变量,而无需单独进行测试。 |来源:NVIDIA
某些环境变化可能会导致性能下降,但规模会很大,单独测试每个变量很快就会变得棘手。相反,我们同时对许多场景变化进行评估,并应用敏感性分析,确定哪些环境变量与成功或失败最相关,将诸如“相机放置可能很重要”之类的直觉转化为量化的结果。
给定变化 𝜃 下的剧集推出以及观察到的结果 𝑥 — 例如,任务成功 — 后验分布 𝑝(𝜃 ∣𝑥) ∝𝑝(𝑥 ∣𝜃)𝑝(𝜃) 描述了哪些条件 𝜃 与结果 𝑥 最相关。
NVIDIA 使用神经后验估计 (NPE) 来估计后验,这让公司能够准确地确定哪个环境变量导致了给定的性能下降,而不是逐一猜测每个因素的影响
为什么重要
机器人基准测试仍然远远落后于其他人工智能研究,并且如果没有现场标准基准测试平台,就很难来衡量进展。随着政策的能力越来越强,单靠成功率并不能告诉我们模型是否真正概括或只是记住了其测试条件,而且这种差距只会随着模型的改进而扩大。
前进的道路需要与它所衡量的模型一样快地发展的评估:扩展而不是饱和的基准,诊断而不是简单评分的指标,以及不仅告诉研究人员政策执行情况如何,而且告诉研究人员如何改进政策的分析。 RoboLab 通过模拟建立了一条可扩展的路径,用于评估现实世界政策的诊断机器人评估。
 作者简介
Xuning Yang 是一名高级研究员NVIDIA 西雅图研究实验室的科学家。她的研究兴趣包括机器人基础模型,特别是评估方法和泛化能力,以及广泛的应用程序现场机器人、室内导航和机器人操作的应用场景。在加入 NVIDIA 之前,她获得了博士学位。卡内基梅隆大学机器人学博士学位。
编者注:本文摘自 NVIDIA 博客。