

论文信息
标题:Vision-Guided Outdoor Flight and Obstacle Evasion via Reinforcement Learning
作者:Shiladitya Dutta, Aayush Gupta, Varun Saran, Avideh Zakhor
机构:UC Berkeley
导读
本文提出了一种基于强化学习的视觉引导无人机室外自主飞行与避障框架。系统由预训练自编码器和LSTM规划控制网络组成,以立体视觉深度图和视觉惯性里程计作为输入,直接输出无人机的速度控制命令。训练采用两阶段策略:第一阶段利用特权学习(privileged learning)在仿真中加速策略收敛,第二阶段通过域随机化和奖励塑形将策略迁移到仅依赖视觉观测的设置。实验表明,训练得到的策略能够零样本迁移到训练中从未遇到的室外障碍环境和不同的无人机硬件平台,展现了强大的泛化能力和实际部署潜力。
效果展示
图 1 实际测试平台:大疆 M300 无人机搭载 Zed2i 传感器用于深度估计与视觉惯性里程计(VIO),并配备 Jetson AGX Xavier 作为计算单元。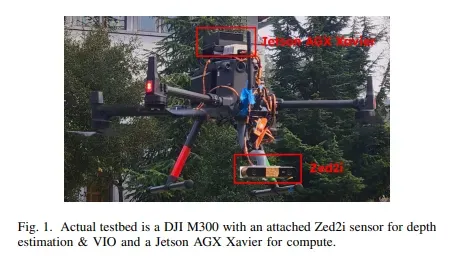
引言
无人机自主飞行是机器人学和人工智能交叉领域的核心研究课题。随着深度学习和强化学习技术的快速发展,基于学习的飞行控制策略逐渐展现出超越传统方法的潜力。与基于几何模型和人工规则的传统方法相比,学习型策略能够从数据中自动发现复杂的感知-决策映射关系,在面对未见过的环境时具有更强的适应性和鲁棒性。
近年来,基于深度强化学习(DRL)的无人机导航取得了显著进展。一些方法使用端到端的深度网络直接从原始图像学习控制策略,另一些则采用模块化设计将感知和规划分离。然而,大多数现有工作集中在室内环境或结构化的室外场景中,面对真实室外环境的复杂性(如光照变化、动态障碍物、纹理缺乏区域等)时,这些方法的性能往往大幅下降。仿真训练加现实迁移(sim-to-real)是目前最主流的训练范式,但如何有效跨越仿真与现实的鸿沟仍然是该领域的核心挑战。
现有方法的局限性主要体现在三个方面:一是视觉感知的鲁棒性不足,在光照变化和纹理缺失区域容易产生深度估计误差;二是策略的泛化能力有限,在训练分布外的环境中容易失效;三是端到端训练的样本效率低下,直接在仿真中从视觉输入学习飞行策略需要海量的交互数据。
本文的核心思路是利用特权学习来加速训练过程,并通过精心的域随机化和奖励塑形来增强策略的泛化能力。特权学习允许在训练阶段使用额外的信息(如地面真值深度),使策略快速学到有效的避障行为,然后在部署阶段仅依赖可用的视觉输入。结合自编码器的视觉特征压缩和LSTM的时序建模能力,最终实现了高效的实时推理和强大的零样本迁移能力。
主要贡献
本文的主要贡献包括以下三个方面:
• 提出了一种两阶段强化学习训练框架,第一阶段利用特权信息(地面真值深度和障碍物位置)加速策略学习,第二阶段通过域随机化和奖励塑形将策略迁移到仅依赖视觉输入的设置,有效解决了端到端视觉导航训练样本效率低的问题。
• 设计了由预训练自编码器和LSTM组成的感知-规划-控制网络架构,自编码器将高维深度图压缩为紧凑的特征表示,LSTM利用时序信息进行平滑的速度命令预测,实现了从视觉输入到控制输出的高效端到端映射。
• 在室外真实环境中实现了强化学习飞行策略的零样本迁移,策略能够成功部署到训练中从未遇到的障碍物类型、环境布局和无人机硬件平台上,展现了前所未有的泛化能力和实际部署价值。
方法
本文的方法框架包含感知模块、策略网络和训练流程三个核心组件。感知模块使用立体相机获取深度图,结合VIO提供无人机的位姿估计。策略网络由预训练自编码器和LSTM规划控制网络组成,接收深度图特征和目标方向作为输入,输出前向速度、侧向速度和偏航角速度三个控制命令。整个系统在机载计算机上以实时频率运行。
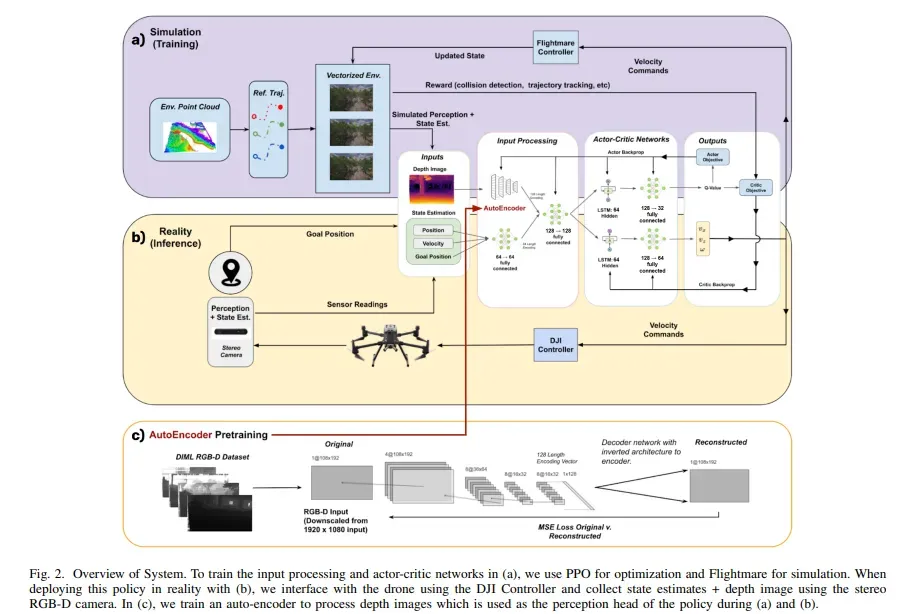
自编码器的预训练是方法的关键步骤之一。作者首先在大量合成和真实深度图上训练自编码器,学习将高维深度图压缩为低维紧凑特征表示的编码能力。编码后的特征保留了障碍物的空间分布信息,同时大幅降低了后续LSTM网络的输入维度和计算负担。LSTM网络接收编码特征序列和目标方向向量,利用其时序建模能力捕捉环境的动态变化趋势,输出平滑的速度控制命令。
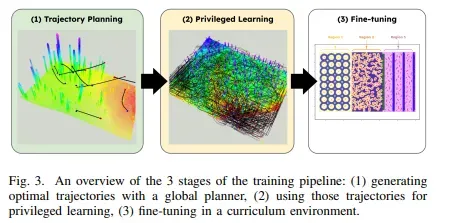
训练流程分为两个阶段。第一阶段(特权学习阶段)在仿真环境中使用地面真值深度和障碍物位置等特权信息作为策略网络的额外输入,通过PPO算法进行强化学习训练。特权信息帮助策略快速理解环境结构和避障逻辑,大幅提升了训练效率。第二阶段(迁移阶段)移除所有特权输入,仅保留视觉观测,同时引入域随机化(随机化光照、纹理、障碍物形状和大小等)和精心设计的奖励塑形(接近目标奖励、避障奖励、速度平滑奖励等),使策略学会仅从视觉输入中做出正确的飞行决策。
实验结果
实验评估在仿真和真实室外环境中分别进行。仿真实验使用AirSim构建了多种室外场景,包括森林、城市街道和开阔田野等,包含静态和动态障碍物。真实实验在校园和公园等室外环境中进行,测试了策略在未见过的环境布局和障碍物类型下的泛化能力。对比方法包括传统几何规划方法和已有的基于学习的导航方法。
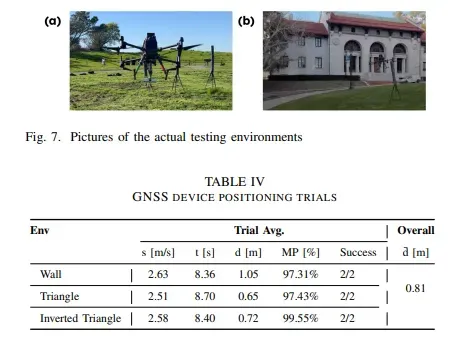
实验结果表明,本文方法在仿真和真实环境中均显著优于对比方法。在室外真实环境的零样本迁移测试中,本文方法在所有测试场景中均成功完成了自主避障飞行任务,成功率远超其他基于学习的方法。特别值得注意的是,策略在训练中从未见过的环境和无人机平台上依然表现出色,验证了域随机化和特权学习策略的有效性。
消融实验验证了各组件的贡献。移除特权学习阶段后,策略的训练时间显著增加且最终性能下降;移除域随机化后,策略在真实环境中的性能大幅退化;移除LSTM后,策略输出的速度命令出现剧烈抖动,飞行轨迹变得不平滑。这些结果证明了两阶段训练框架、域随机化和时序建模对于实现鲁棒的零样本迁移都是不可或缺的。
总结 & 未来工作
本文提出了一种基于强化学习的视觉引导无人机室外自主飞行框架,通过两阶段训练策略(特权学习+域随机化迁移)实现了从仿真到真实室外环境的零样本迁移。预训练自编码器和LSTM的组合架构保证了从视觉输入到速度命令的高效映射,策略在从未见过的障碍环境和无人机平台上均展现出强大的泛化能力,为学习型无人机导航的实际部署迈出了重要一步。
未来工作将探索以下几个方向:引入更丰富的感知模态(如光流、语义分割)以提升策略在复杂视觉条件下的鲁棒性,研究多无人机协同避障的强化学习方法,以及将框架扩展到更高速和更动态的飞行场景中。此外,结合大型语言模型的指令理解能力,实现自然语言引导的无人机自主飞行也是值得探索的方向。
对更多实验结果和文章细节感兴趣的读者,可以阅读一下论文原文~
本文仅做学术分享,如有侵权,请联系删文。
来源:3D视觉工坊