

作者介绍
本文第一作者是李浩东,香港中文大学计算机系一年级博士生,曾入选美团 LongCat 北斗计划、腾讯混元青云计划,师从 Prof. Pheng-Ann Heng;本文通讯作者是 Pheng-Ann Heng 教授,香港中文大学卓敏计算机科学与工程学教授,谷歌学术引用量 8 万余次。
让视频看起来真实,不等于让它符合常识
黄油落进热锅后迟迟不化,密封塑料瓶被抽走空气却纹丝不动,干冰在室温中始终保持原样 —— 这些画面单看每一帧或许足够精致,连起来却很容易让人出戏。对影视制作来说,这意味着镜头缺乏可信度;对具身智能和物理仿真来说,问题则更严重,因为模型需要理解的不是像素如何平滑移动,而是事件为什么发生、又将怎样继续。
现有文生视频模型通常从一句高度压缩的提示词直接生成画面。提示词告诉模型 “发生了什么”,却很少交代变化的速度、先后次序、物体之间的作用关系,以及过程结束时应当呈现的状态。模型不得不一边补全这些隐含信息,一边合成视频。香港中文大学与中国科学技术大学的研究团队把这道缺口概括为 “因果不透明性”:人的意图被压缩在短短一句话里,但视频需要展开为完整、连续的时空过程。
VideoCoCo 的切入点由此变得很直接:与其让生成模型在像素空间里凭经验猜测,不如先用一段真正能够运行的代码,把提示词中省略的物理过程写出来,再据此生成视频。代码在这里并不是附加工具,而是一条可执行、可检查的 “过程级思维链”。
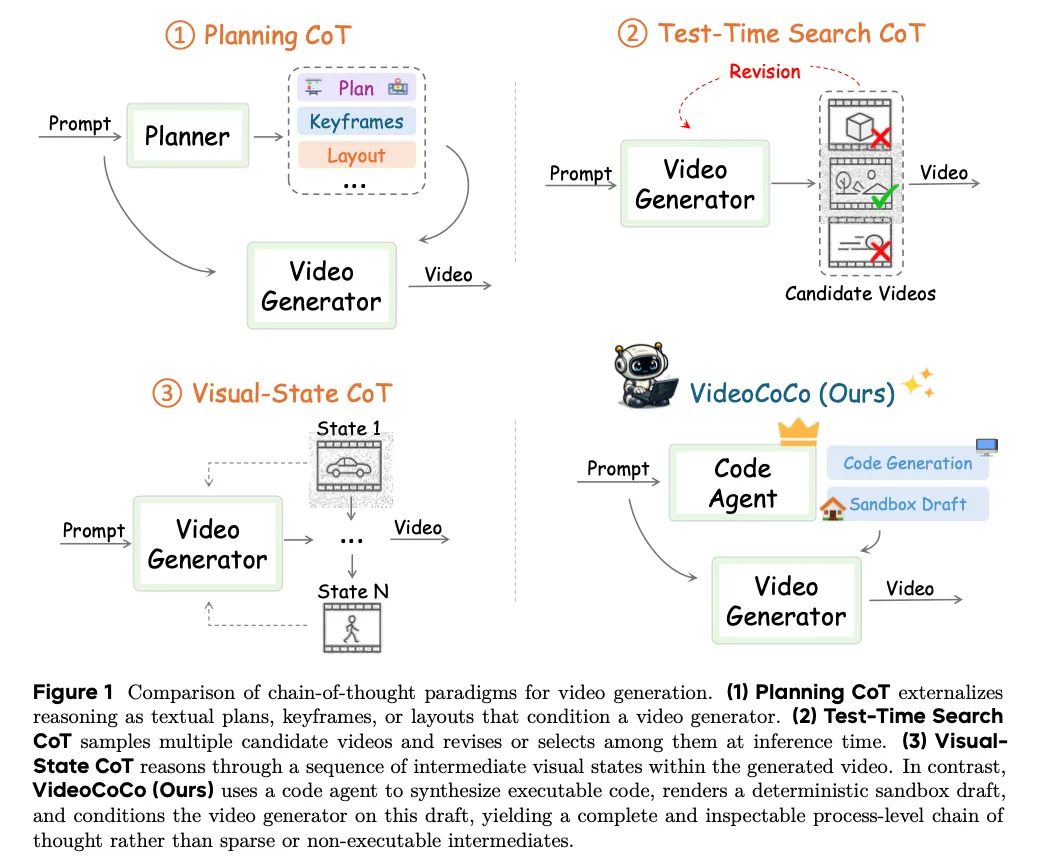
文生视频传统范式与 VideoCoCo 范式对比图
论文标题:VideoCoCo: Code-as-CoT for Physically-Consistent Video Generation via an Agentic Dual-Engine System
从 CoCo 到 VideoCoCo:
把一张预览图扩展成一段过程
这项工作的思路并非凭空出现。团队此前提出的 CoCo(Code-as-CoT for Text-to-Image Preview and Rare Concept Generation)已被 ECCV 2026 收录。面对复杂空间关系或罕见概念,CoCo 不急着生成最终图像,而是先写出可执行程序,渲染一张包含布局和物体关系的预览图,再让图像模型围绕这张预览图补足细节。
这一步的价值在于,原本停留在语言层面的推理被转化成了可以运行、查看和修改的视觉结果。哪里摆错了、关系是否成立,不必等到最终成图后再猜原因,而是可以回到程序和预览图中定位。
VideoCoCo 延续了这条思路,但视频比图像多出了一条时间轴。一张图只需要解决某个瞬间的空间布局,一段视频却要交代状态如何连续变化。于是,代码不能只描述物体 “在哪里”,还要描述它 “接下来怎么动”:受热后何时开始融化,形状如何摊开,容器在内外压差变化后怎样变形。把静态预览扩展为连续动力学,正是 VideoCoCo 相比前作更关键的一步。
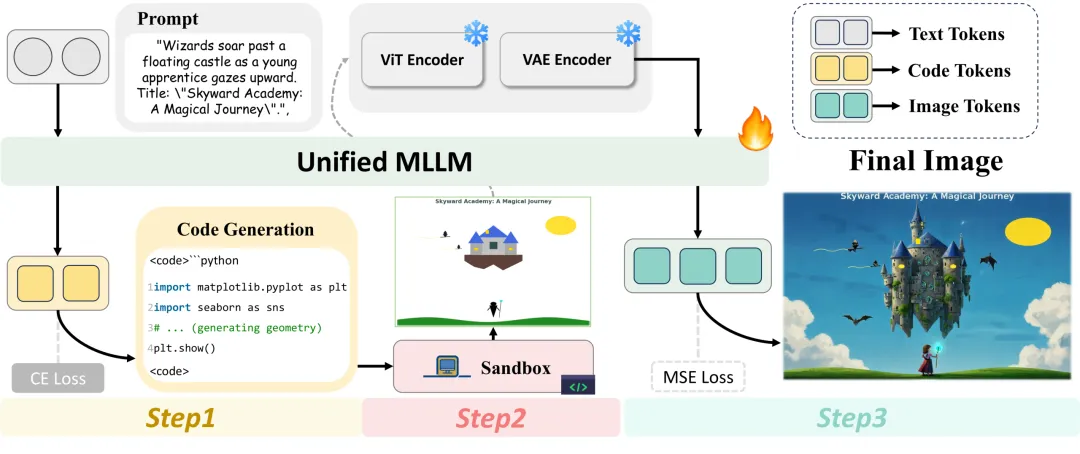
前置工作 CoCo pipeline 图
两个智能体接力,
把 “动得对” 和 “看得真” 分开处理
VideoCoCo 采用双引擎框架,将过程推理与视觉呈现拆成两个相对独立的环节。Coding agent 负责确定事件如何发生,Visual agent 则负责把这个过程变成具有真实质感的画面。这样的分工并不复杂,却避开了让一个模型同时承担物理推演和视觉合成的压力。
以 “黄油在滋滋作响的热锅里融化、变褐并逐渐摊开” 为例,Coding agent 会先生成一段自包含的 Bl
来源:机器之心