

本文第一作者为香港大学博士生丁凯欣。团队成员包括香港大学博士生陈汐、徐致远、汪逸阳、陆宇翔、李俊奕,香港中文大学蔡明宏,浙江大学陈书扬,以及快手可灵团队的高远、陶鑫和万鹏飞。通讯作者为香港大学助理教授赵恒爽。
世界模型应该如何评测?答案是:像真实用户一样去 “玩” 它。
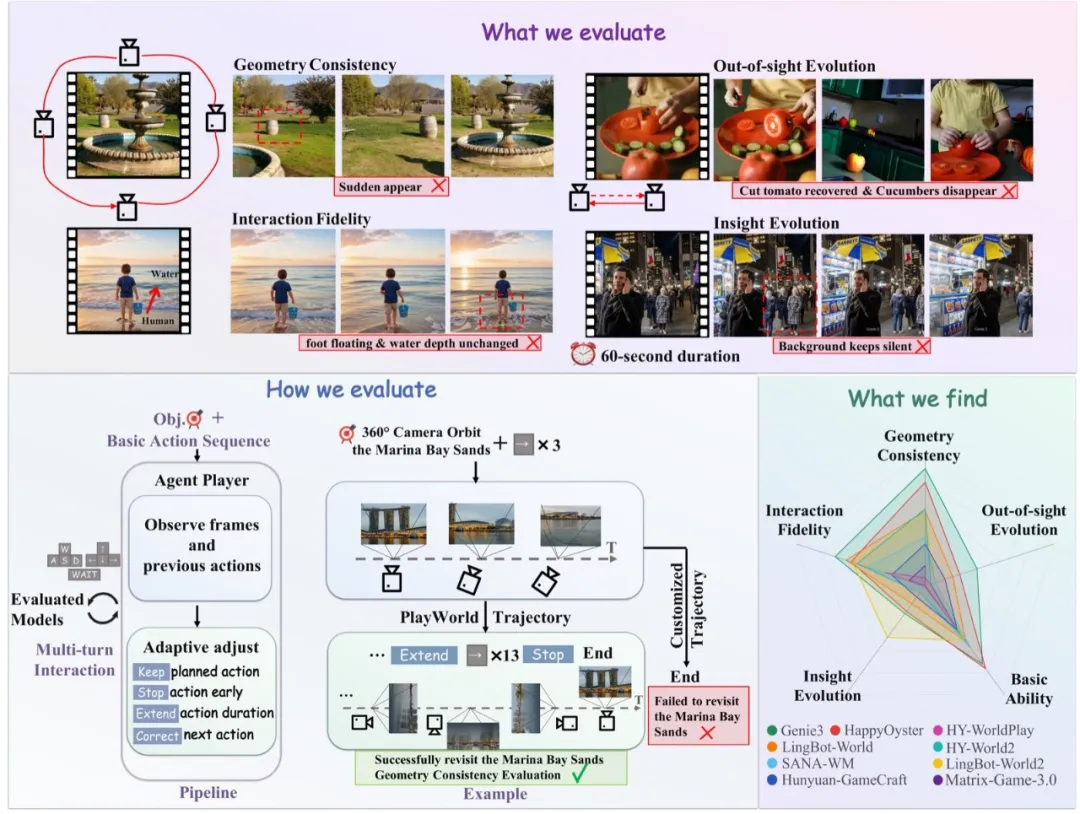
例如,在虚拟世界中绕房子一周,回到原点后检查场景是否一致;走入水中,观察是否激起水花;或在不同房间之间来回穿梭,看看每次返回时,客厅里画画的人是否取得了新的进展。然而,要完成这些 “长程操控目标”,不同模型所需的操作序列并不相同。
为此,来自香港大学、香港中文大学、浙江大学和快手可灵团队的研究者使用 Agent Player 操作世界模型:只给定 “场景” 和 “长程目标”,由 Agent Player 在交互过程中观察生成视频的几何一致性、交互正确性和事物演化的合理性。他们对多个 SOTA 模型进行了系统评测与分析,并已开源评测集和代码。
论文标题:PlayWorld: Benchmarking World Models with Agent Players over Long-Horizon Objectives
测评集:
为什么固定动作轨迹不够公平?
人类试玩世界模型时,通常不会关心 “是否严格执行了三次右转”,而会关心 “是否完成了绕场一周并回到原来的地标”。这两种评测思路看似接近,实则回答的是不同问题。以 “围绕中心雕塑转一圈” 为例,固定轨迹只能保证所有模型收到相同的按键,却不能保证它们都到达相同的视角。如果模型并未真正到达目标视角,后续的几何一致性评分就失去了可比性。
PlayWorld 因此把评测单位从 “固定动作序列” 升级为 “场景相关的长期目标”:所有模型面对同一个初始世界、同一个目标,但允许 Agent Player 根据实时观察作出必要调整。
图为围绕中心雕塑转一圈,再观测雕塑形状有无改变:
核心创新:
会观察、会调整、会喊停的 Agent Player
Agent Player 由多模态模型与接口转换器组成。每一步,它都会查看生成帧、已执行的动作、场景描述和长期目标,再从五种决策中选择一种:
Keep:按计划继续当前动作,或进入下一个动作;
Stop:目标视觉状态已经出现,提前结束当前动作;
Ext
来源:机器之心