

我们理想中的具身智能模型,是什么样的?
或许可以归结为几个关键词:足够通用,理解真实世界,具备自主决策与行动能力,同时还能自然、高效地与人和环境持续交互。
这些关键词共同指向了一类模型:世界动作模型(WAM)。视频生成模型正在变成机器人世界模型底座,而想要真正让具身智能模型 Scaling 起来,对真实物理世界的理解深度就格外重要。
而这,是具身世界动作模型的新进展,机械手能够稳健地完成相对复杂、精细的现实任务:
刚刚,穹彻智能发布具身智能预训练模型 Noe-0 ,一个训练全链路采用无本体采集数据的世界动作模型。
技术博客链接:
所有自采训练数据都来自人在真实环境中直接完成操作的记录。超 50 个城市、数十万小时、数十万种任务类型。
这是一个相当激进的策略。Noe-0 证明了完全不依靠传统的遥操数据,也可以完成具身世界模型的预训练、后训练,并在真实机器人上形成执行真实任务的能力。
Noe-0:全链路「真实操作」训练的具身模型
什么是真正的「真实操作」
传统的遥操数据,往往是在一个集中场地内搭建大量标准化工位:相似的桌面、有限的物体,以及提前设计好的任务流程。这样的环境虽然也可以被称为「真实场景」,但本质上仍是为了数据采集而人为构造出来的。
换句话说,数据工厂可以复制工位,却很难复制真实世界本身。
因此,要想让机器人学习真实世界的知识,就必须摆脱机器人本体和固定工位。数据采集真正进入家庭、门店等日常环境,采集员直接面对真实空间中的物体和任务,数据才能自然包含不同的视角、光照、摆放方式、操作习惯以及大量难以预先设计的长尾情况。相比标准化工位,这类数据更接近机器人未来实际面对的世界,也更能体现真实世界的复杂性和多样性。
此外,研究团队观察到,同一任务通过遥操作完成通常需要直接操作的 3 至 5 倍时间,不仅增加采集成本,也容易产生缓慢、机械的动作数据。所以,在摆脱标准化工位的数采势在必行。
为了实现在真实世界里的数据采集,穹彻智能打造了高效,自然,设计优化的数据采集设备 RoboPocket(RP)。
团队发现,如果直接沿用面向机器人执行设计的夹爪形态,会限制采集员在真实环境中的操作范围。为此,RP 将夹爪、末端形态、传感器和采集方式放在一起设计,强调「同构设计」:采集端与机器人末端尽可能保持一致,同时兼顾人的操作舒适度和采集效率。
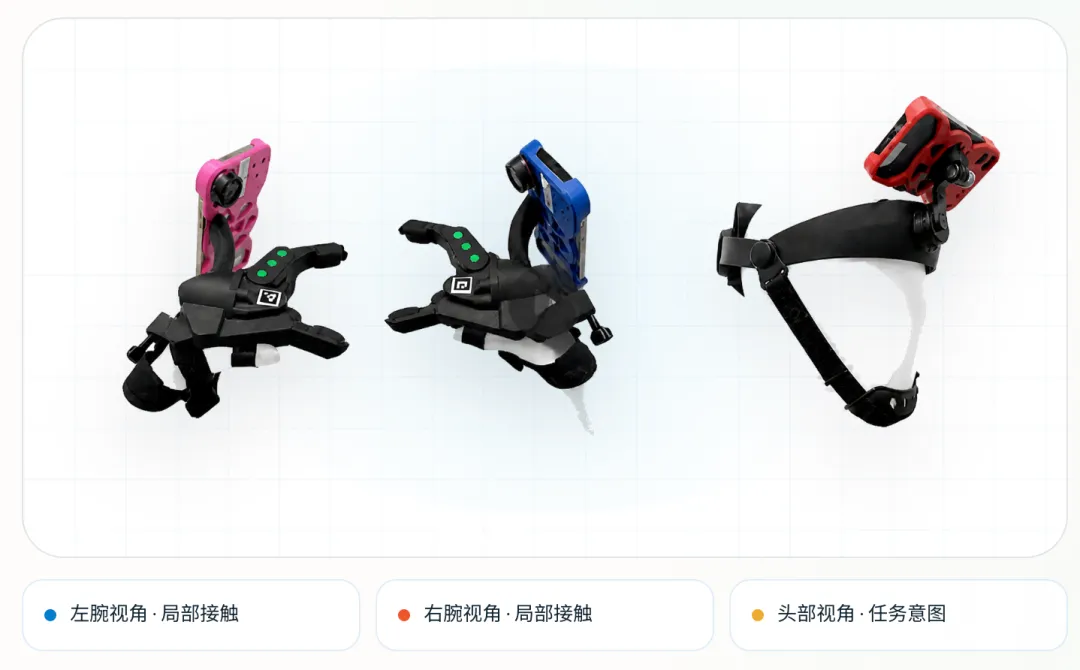
RoboPocket(RP)示意图
全链路无本体数据
对 Noe-0 而言,无本体数据,「真实操作」的数据,是同时支撑预训练和后训练的数据基础。
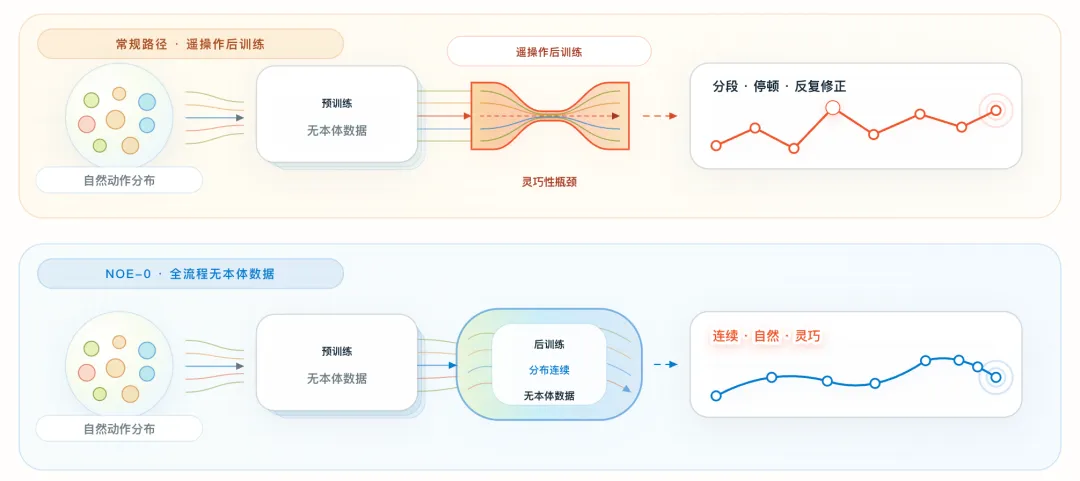
众所周知,大模型的训练链路较长,预训练和后训练都对模型的最终能力有巨大的影响。值得注意的是,Noe-0 在预训练和后训练阶段都使用无本体数据。
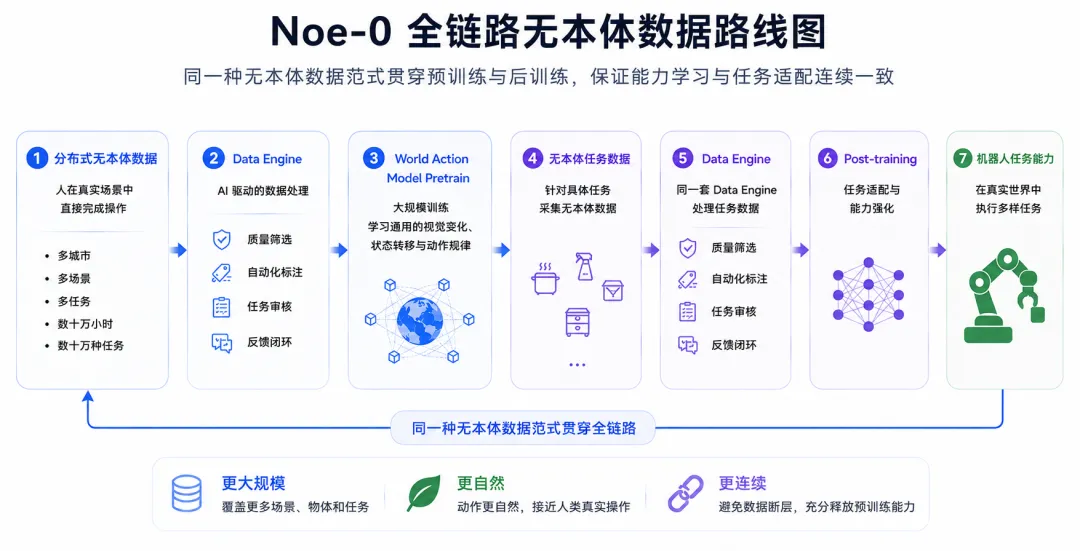
预训练阶段,Noe-0 使用大规模分布式无本体数据,让模型尽可能见到更多场景、物体和任务,从中学习跨任务的视觉变化、状态转移与动作规律,建立面向真实世界的基础能力。进入后训练阶段后,团队再围绕具体任务采集更聚焦的无本体数据,用于任务适配和能力强化。
更重要的是,这种数据范式贯穿了整个训练链路。
如果预训练使用无本体数据,后训练却重新切回遥操作数据,两个阶段之间就会出现数据分布和动作模式的断层:模型在预训练中学到的自然操作规律,还需要在后训练中重新适配一套不匹配的动作表达。
Noe-0 从预训练到后训练始终沿用同一种无本体数据路线,让基础能力学习和具体任务适配保持连续,也避免后训练重新成为整条链路的能力瓶颈。
World Action Model:真实世界经验的转化
当数据真正走出标准化工位、进入真实世界后,数据的丰富性也随之带来了新的挑战,传统的 VLA 技术路线因其泛化能力受限早已不再能够满足需求。不同环境、物体、光照、视角,以及更加复杂、连续的交互过程,都要求模型具备更强的多样视频理解与世界建模能力。
这也是为什么,真实世界数据越丰富,对新一代的 World Action Model 的需求反而越迫切。
在最近的 Robotics'
来源:机器之心