

如今大家常用的 Harness,通常都默认你接的是一线大模型 API,比如 Fable 5、Sol、Kimi K3……
Perplexity 推出的 Portable Computer 却在想办法利用 Qwen 3.8 27B 这样可以本地部署的模型,实现接近的效果。
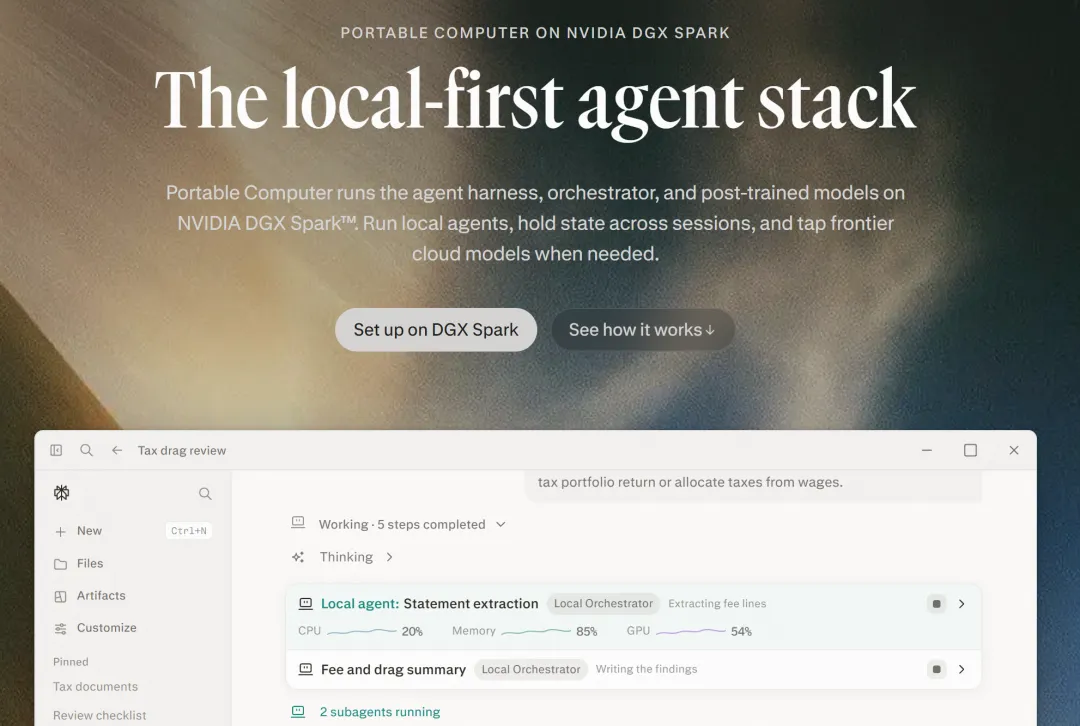
默认情况下,Portable Computer 的整个技术栈在本地运行。模型、框架、对话和轨迹都位于用户的计算机上。需要外部访问的功能如网络搜索、连接器或升级到云端更强大的顾问模型,仅在必要时才会调用,并且始终由用户控制。因此,敏感数据未经许可绝不会离开设备,本地模型也不产生推理费用。
一个高效的局部优先智能体需要模型和框架协同设计。通用框架假定模型具有前沿能力,能够理解长上下文、驾驭大量工具并进行长链规划。本地模型在这些要求下可靠性较低。Perplexity 没有让小模型管理为大模型设计的框架,而是让两者相互配合:框架根据模型的能力特性量身定制,模型经过后训练以有效使用框架。
近几个月来,智能体在各种知识工作任务中迅速发展。虽然这些进步带来了生产力和效率的大幅提升,但也带来了新的挑战。
Token 消耗量正迅速增长,整体支出也随之攀升。当通过运行在服务器集群上的闭源模型 API 访问数据时,每次请求都会将用户的私有信息和知识产权带离设备。随着智能体程序扩展到各个工作流程乃至整个组织,Token 消耗和数据流动的管控难度也日益增加。
与此同时,开源模型的发展速度甚至更快。进步在 NVIDIA Nemotron 3.5 Lightning(总参数 300 亿)、Qwen 3.6(350 亿)和 Qwen 3.8(270 亿)等小模型中尤为显著。小模型性能越来越好,如今已能处理复杂的智能体工作流程。本地推理硬件也在同步发展:NVIDIA DGX Spark、M5 Ultra 的 Mac Studio 等系统现在可以在本地运行这些模型。这些趋势共同促成了完全在设备端运行的可行性。
当然,你在需要时也可以选择使用外部功能,例如网络搜索、连接器或云模型升级。
这种本地优先的方法能够显著降低成本,它还能自然地解决隐私和知识产权问题,私有 token 无需传输到远程集群,始终安全地保留在本地设备的边界内。
今年六月,Perplexity 推出了首个混合本地 - 服务器推理编排器,它可以决定哪些任务应该在设备端运行,哪些任务应该交给云端的智能体执行。本文将详细介绍 Perplexity 如何构建这样一个本地优先的智能体,包括框架以及相互优化的模型。
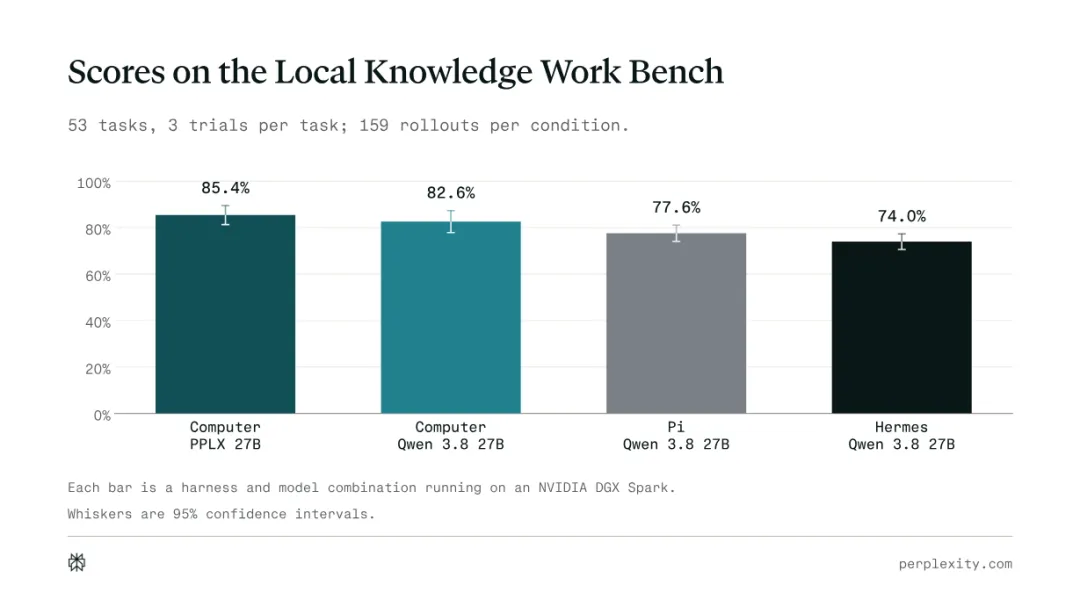
Perplexity 概述了关键的设计选择,并在三个公开基准测试和 Perplexity 内部的本地知识工作台 (Local Knowledge Work Bench) 上,将 Portable Computer 与流行的开源通用框架(Hermes 和 Pi)进行了比较。在基准测试中,使用运行在 NVIDIA DGX Spark 上的 Qwen 3.8 27B 模型,Computer 取得了最高分,Perplexity 基于 Qwen 3.8 27B 模型进行后训练的 PPLX 27B 模型,进一步将得分提升至 85.4%。
根据本地模型设计 Harness
尽管本地模型已经相当强大,但其绝对性能仍不及大参数的前沿模型。因此,需要精心设计的 harness 才能有效操控它们并克服其局限性。
像 Pi 和 Hermes 这样的流行开源 harness 已被证明具有很强的通用性:它们可以很好地兼容各种尺寸和类型的模型,但它们并未针对设备端模型进行优化。Perplexity 围绕几个关键原则,专门针对这种场景设计了本地 harness。
上下文效率
Perplexity 在设计 harness 时的主要重点是充分利用模型的背景信息。
尽管像 Qwen 3.8 27B 这样的设备端模型提供了 26 万 token 的上下文窗口,但 Perplexity 通过实验发现,当 token 数量超过 10 万时,它们的性能就开始下降。因此实际使用时需要保持核心框架的简洁性:仅包含一个最小的系统 harness 和一套核心工具。
其他所有能力都模块化为按需技能,可在整个学习过程中随时加载和卸载。Perplexity 设计的这些技能适用于常见的知识型工作任务:研究、数据科学、数据可视化、文档创建、软件工程等等。
该框架还支持上下文压缩,当轨迹变长时,它会总结过时的上下文,以便模型保持在有效窗口内。
连接器作为命令行工具
日常知识工作通常需要用到 Gmail、GitHub、Outlook 和 Google Cal
来源:机器之心