

近年来,视觉语言模型(Vision-Language Model, VLM)在图像理解、语义推理等任务中展现出了强大的能力。然而,当这些模型真正进入物理世界,让机器人根据一句自然语言指令完成自主导航时,仍然面临巨大挑战。
例如,机器人完成一句简单的指令:
“穿过走廊,在窗户旁边找到椅子。”
机器人不仅需要 “理解” 这句话,还需要知道:“走廊在哪里? 窗户和椅子之间是什么空间关系?当前视角是否被遮挡?应该先往哪里移动?接近目标时如何避免碰撞?” 这就是视觉语言导航(Vision-and-Language Navigation, VLN)面临的核心问题:如何让智能体将自然语言指令转化为现实世界中的连续行动。
为此,AgentVLN 提出 “VLM-as-Brain” 的理念,让 VLM 负责高层认知决策,同时通过模块化技能库完成具体执行,从而实现更加高效、灵活的机器人导航,即:VLM Agent → Skill Calling → SLAM/Perception → Robot Navigation。
论文提出的 AgentVLN 在 R2R-CE 和 RxR-CE 等主流 VLN 基准上取得领先性能,同时仅使用 3B 规模模型,并支持 Jetson 等边缘设备实时运行。 该成果已被计算机视觉顶级会议 ECCV 2026 (European Conference on Computer Vision)录用。
论文标题:AgentVLN: Towards Agentic Vision-and-Language Navigation
数据集链接:https://huggingface.co/datasets/allenxinn/AgentVLN-Instruct
核心思路
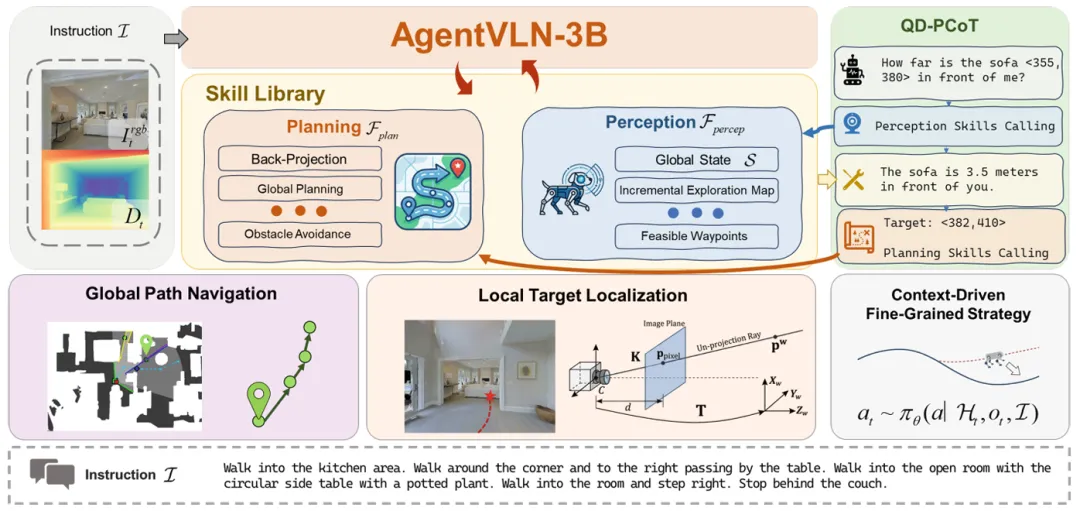
AgentVLN 使得机器人不再要求一个巨大模型直接完成所有事情,而是让视觉语言模型负责:“理解任务目标、分析环境与调度不同技能”。 而具体执行,例如建地图、避障、移动和定位等功能则交给专门设计的技能模块完成。该工作将导航过程建模为部分可观测半马尔可夫决策过程,并将技能划分为感知层技能和规划层技能,让智能体根据环境状态动态调用不同能力。这种设计类似人类完成导航任务的方式:
看到环境 → 思考路线 → 行动 → 根据反馈调整。
机器人不需要每一步都重新学习,而是像人一样调用已有能力。同一个 AgentVLN “大脑”,可以根据不同机器人的身体能力,替换对应的底层技能模块,从而快速适配不同机器人平台。
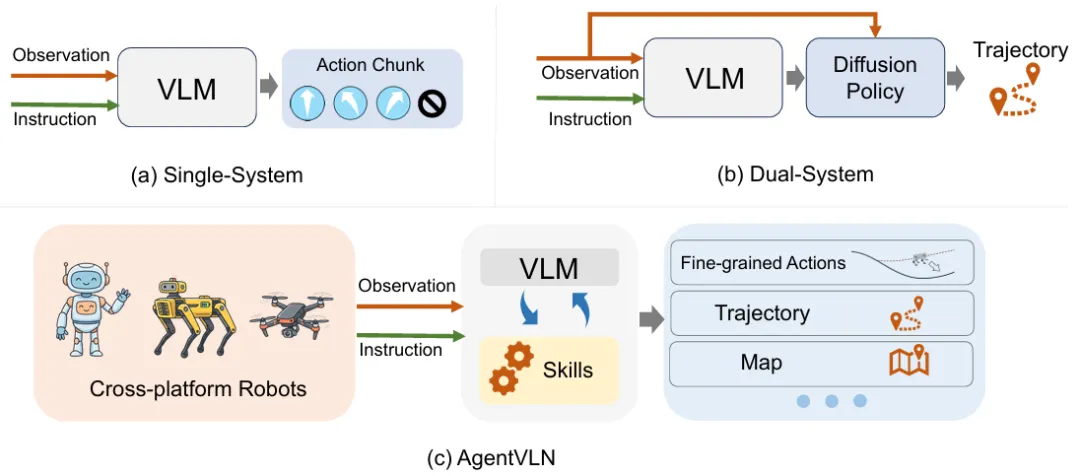
通过插件式底层技能库设计,AgentVLN 可以在不重新训练大规模视觉语言模型的情况下,通过扩展或替换技能实现对新环境和新任务的适应。
把 3D 世界 “翻译” 为 VLM 能看懂的 2D 提示
视觉语言模型最大的优势,是理解二维图像中的语义信息。 但机器人导航的问题在于:真实世界是三维的。机器人需要知道:“应该往哪里走?”,而 VLM 看到的是:“图片里的哪个位置代表目标方向?”,如何连接这两个空间,一直是机器人自主导航领域的重要挑战。
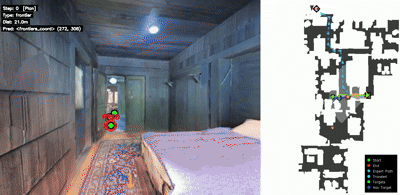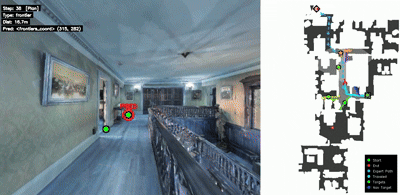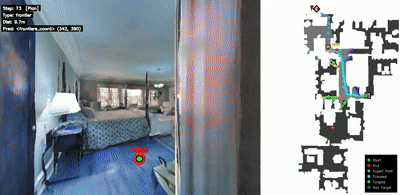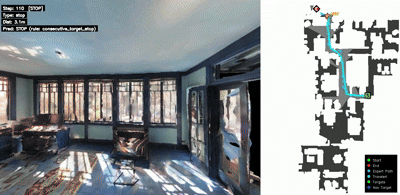
为此,AgentVLN 提出:跨空间表示映射机制(Cross-space Representation Mapping)。其核心思想是:先利用 SLAM 作为感知技能计算真实环境中的可行路径,再将三维路径信息映射回二维图像空间,让 VLM 直接在视觉空间中进行决策。
机器人首先调用感知技能,对当前环境进行分析:1)构建三维空间地图;2) 获取环境拓扑结构;3)计算可通行区域;4)生成候选导航路径点。 随后,AgentVLN 利用相机模型,将这些三维可行路径点投影到当前摄像头视角下的二维图像中。最终,原本复杂的三维路径规划问题,被转换为:
“在图像中选择最符合语言指令的路径点。”
也就是说,模型不再需要直接从开放空间中预测一个精确坐标,而是将:开放性的精细点坐标生成问题(open
来源:机器之心