

过去一年,具身智能的数据路线在快速转向。
遥操作数据贵、慢、难以规模化,越来越多的团队开始把目光投向人类视频。英伟达等团队的 EgoScale 用 20854 小时第一视角人类视频预训练机器人策略,拟合出一条对数线性曲线;HumanScale 等工作更进一步,认为在同等数据量下,第一视角视频作为预训练数据可优于真机遥操作数据。
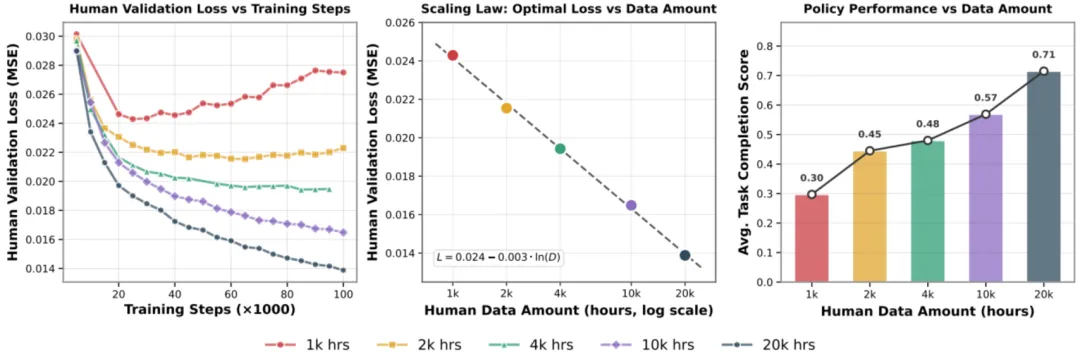
使用人类数据预训练的 Scaling 行为,arXiv:2602.16710
对于夹爪抓取,这条路线的逻辑相对顺畅。但当执行器换成一只有二十多个自由度的灵巧手,问题变得复杂起来,因为视频会记录手是怎么动的,却不会记录用了多大的力。而对于拧瓶盖、插接头、削苹果这类需要精细操作的任务来说,成败恰恰取决于接触发生之后的几毫米运动。

Sharpa Wave 灵巧手
灵巧操作的数据难题,本质上是接触的难题。
围绕这个问题,专注灵巧操作的机器人公司 Sharpa 明确了三条探索主线:
软硬件协同设计将以机器人为中心的数据采集转移到以人为中心的数据采集
解耦「运动」与「交互」,把接触交给高频、带触觉的底层控制
以触觉为锚,学习跨机器人本体的通用操作表征
沿着这几大方向,Sharpa 的硬件平台也成为众多前沿研究的重要载体。过去一段时间,谷歌、英伟达等团队基于 Sharpa 硬件开展了一系列具身智能实验与前沿探索。比如,前两天谷歌最新发布的 Gemini 4 Argon,展示案例中的机器人丢沙包实验,用到的正是 Sharpa 的灵巧手。
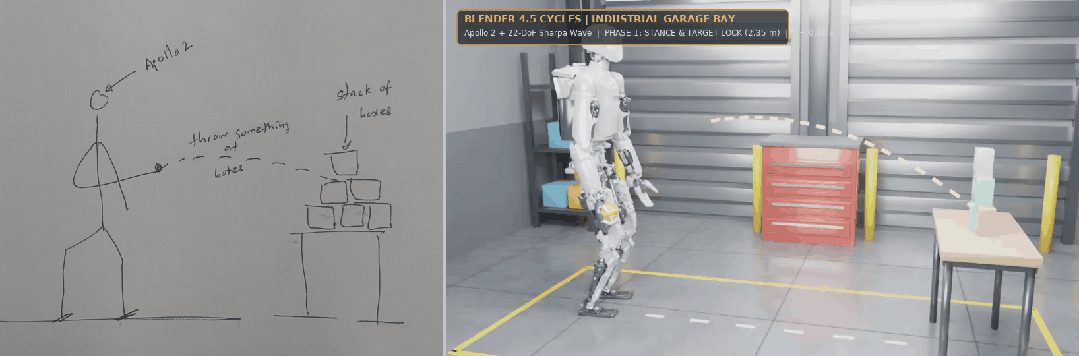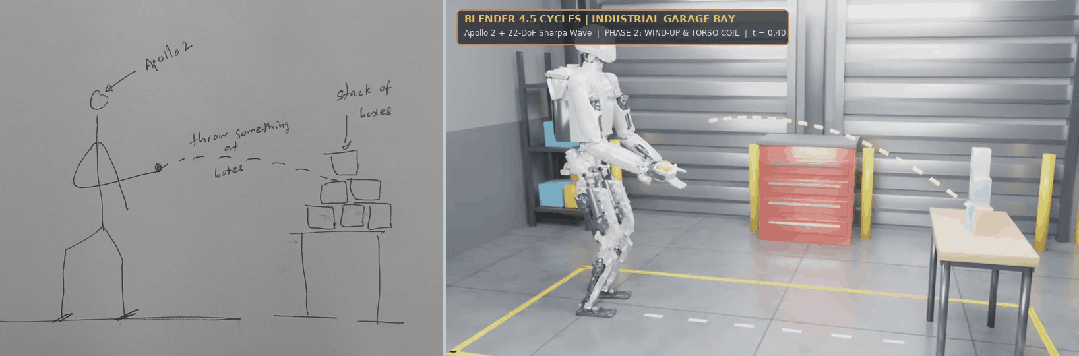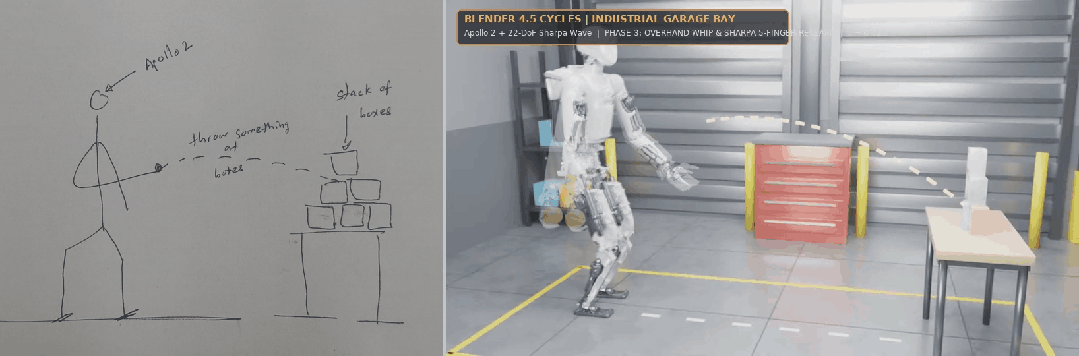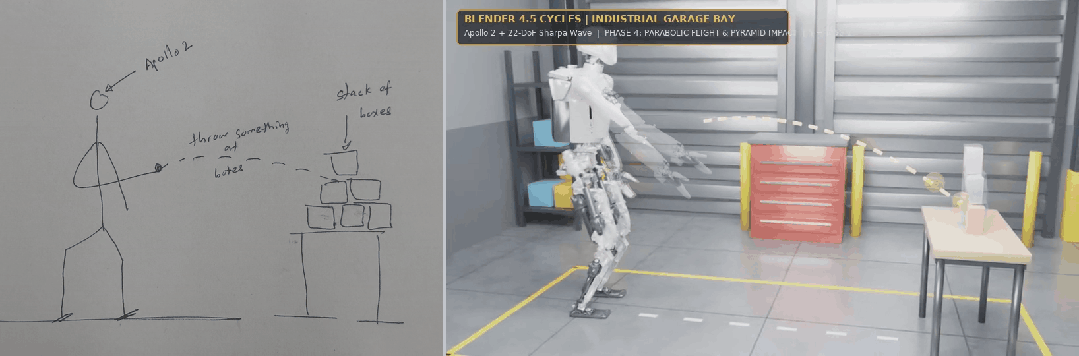
与此同时,Sharpa 与香港大学、加州大学伯克利分校、清华大学、上海交通大学等团队展开合作,共同推进灵巧操作领域的数据采集、模型学习与跨本体泛化研究。
机器之心近日与 Sharpa 学术负责人张凯峰进行了交流,试图理清这些工作在回答什么问题,以及它们如何拼成一幅完整图景。
一只苹果,难住了 VLA
先看一个具体任务:用两只灵巧手削一个苹果。
这个任务里,一只手要握住苹果并持续转动,另一只手控制削皮器,沿着苹果表面推进。苹果的曲率在变,果皮的厚度在变,持握的力度和削皮的角度都要随之调整。两只手做的不是对称动作,一只手负责「稳」和「转」,另一只手负责「削」,彼此还要配合节奏。
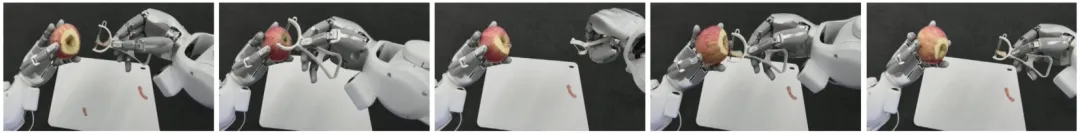
MoDE-VLA 论文中的双手削苹果序列图
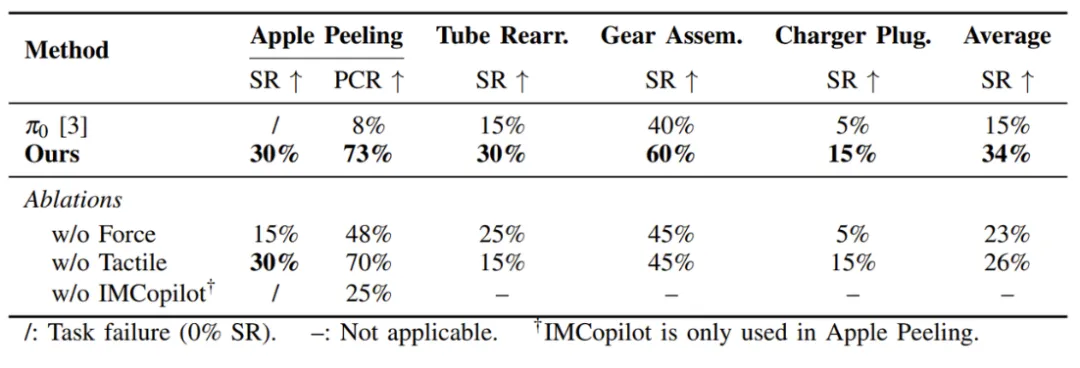
在 Sharpa 与上海交通大学、上海人工智能实验室等机构合作的 MoDE-VLA 论文中,研究者把这个任务交给了 π0 这一主流 VLA 模型作为基线。结果成功率 0%,削皮完成度只有 8%。
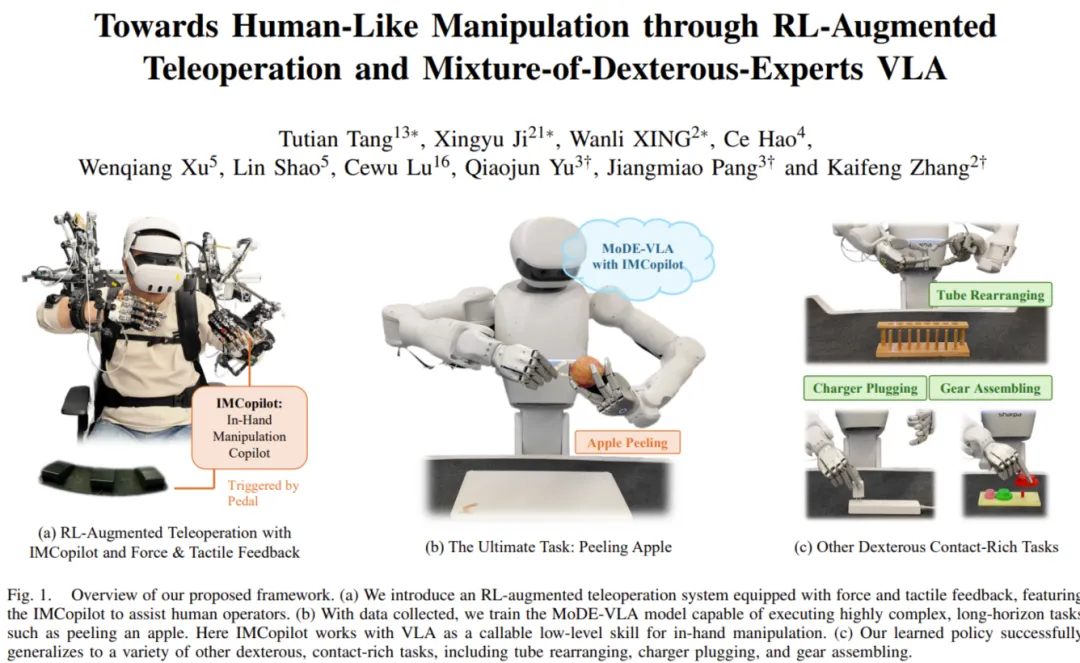
论文标题:Towards Human-Like Manipulation through RL-Augmented Teleoperation and Mixture-of-Dexterous-Experts VLA
这并不意外。这篇论文在开篇就指出,VLA 模型在使用平行夹爪的抓取放置任务上已经相当成熟,但面对接触丰富、需要双手协同和手内操作的灵巧任务时,能力明显不足。问题出在哪里?是模型不够大,数据不够多,还是别的什么?
要回答这个问题,首先要讲清楚灵巧手和夹爪究竟有什么不同。
在张凯峰看来,二者的区别不只是自由度的多少。他说:「传统的机械臂和夹爪,把所有的操作问题简化成了运动学上可以解决的问题。而灵巧手有动力学的问题。」夹爪的动作空间基本只有开和合,只要把它移动到正确的位置、在正确的时刻闭合,任务就大体完成了。灵巧手则要调用抓、拉、拧、捏等各种底层的原子技能(motion primitive),张凯峰估计人手的这类技能接近几十种。
这意味着,灵巧操作不能只靠「看准位置再执行」。力的大小、接触的状态、物体在手中的滑动,都会实时影响下一步动作。
在硬件层面,高自由度、带触觉的灵巧手已经逐渐成熟。张凯峰认为,硬件之后的最大瓶颈在于数据,「尤其是类人的这种灵巧操作的数据」。而灵巧操作数据之所以难,恰恰是因为它需要包含接触信息。
两种数据,一个两难
目前,灵巧操作数据主要有两种来源。
第一种是遥操作(teleoperation):人通过视觉设备或外骨骼远程控制机器人完成任务,记录下机器人自身的动作。过去几年,学术界提出了 AnyTeleop、Open-TeleVision、Bunny-VisionPro、HOMIE 等一系列遥操作系统,在沉浸感和易用性上不断改进。这类数据与机器人本体对应,可直接用于训练。
MoDE-VLA 论文中的双手削苹果遥操作 demo
但遥操作有一个难以绕开的问题:操作员感受不到机器人的接触。「操作员很难获得高保真的、机器人在操作时的感受,」张凯峰说,因为机器人指尖的力和触觉很难实时反馈给操作员。在精细操作中,这意味着操作员只能凭视觉猜测力度,效率和数据质量都受到影响。
第二种是以人为中心的数据采集:人直接用自己的手完成任务,通过动捕设备、数据手套或头戴相机记录下来。DexCap、DexUMI、DEXOP、OSMO 等工作都属于这一方向。人手本身有完整的触觉反馈,操作自然,数据也更容易扩大规模。
问题在于,人手和机器人手不是同一个本体。张凯峰把其中的差距拆成两层。
第一层是视觉上的:画面里是人手,不是机器手。
第二层是动作上的,也更根本。「不管通过最先进的动捕设备、动捕场,还是任何方式,你能得到的其实是 hand state,而不是动作,」他解释道,「动作和状态之间差了什么?差了力和触觉的信号。」驱动灵巧手电机需要的是力矩和关节角信号,而人手数据里并不直接包含这部分信息。
于是,研究者面对一个两难:数据采集方式越贴近人的自然动作,操作越舒适,与机器人之间的本体差异(embodiment gap)就越大;采集方式越贴近机器人结构,对操作者的要求就越高,体验也越差。
围绕「Towards Human-Like Dexterous Manipulation(迈向类人的灵巧操作)」这一长期目标,Sharpa 学术团队针对这个两难确立了三条主线:
解决以人为中心的数据与遥操作数据之间的本体差异,回答「数据如何转化为机器人能力」;
解耦「运动」与「交互」,通过仿真与原子技能重构接触控制;
跨本体的不变表征学习,回答「模型如何在不同机器人和传感器之间迁移」。
张凯峰的说法是,三条主线「是一个并行、且会相互促进的状态」。
主线一:击穿「具身鸿沟」,让人类数据成为机器人的动作燃料
要跳出「采集越舒适,数据越难用」的两难,首先要回答:能否既保留以人为中心采集的自然与高效,又补上缺失的力和触觉信息?一个直接的思路,是在采集端就把触觉记录下来,这就需要无本体的数据采集。
为此,需要无本体的数据采集。
所谓「无本体」,是指采集数据时不需要机器人在场,人戴上传感设备直接操作。这类方案的关键在于,既要保留人手操作的自然和触觉,又要让采集到的数据最终能被机器人使用。
UVTA (Unified Visual-Tactile-Action Modeling / 统一视觉 - 触觉 - 动作建模)是这一方向的代表性工作,由上海交通大学、北京通用人工智能研究院、Sharpa 与北京理工大学合作完成。据张凯峰介绍,研究团队在 Sharpa AE01 外骨骼数据手套的基础上加装了指尖触觉传感:22 自由度的被动连杆记录手指运动,每个指尖的力敏电阻阵列记录触觉,腕部相机记录第一视角画面。
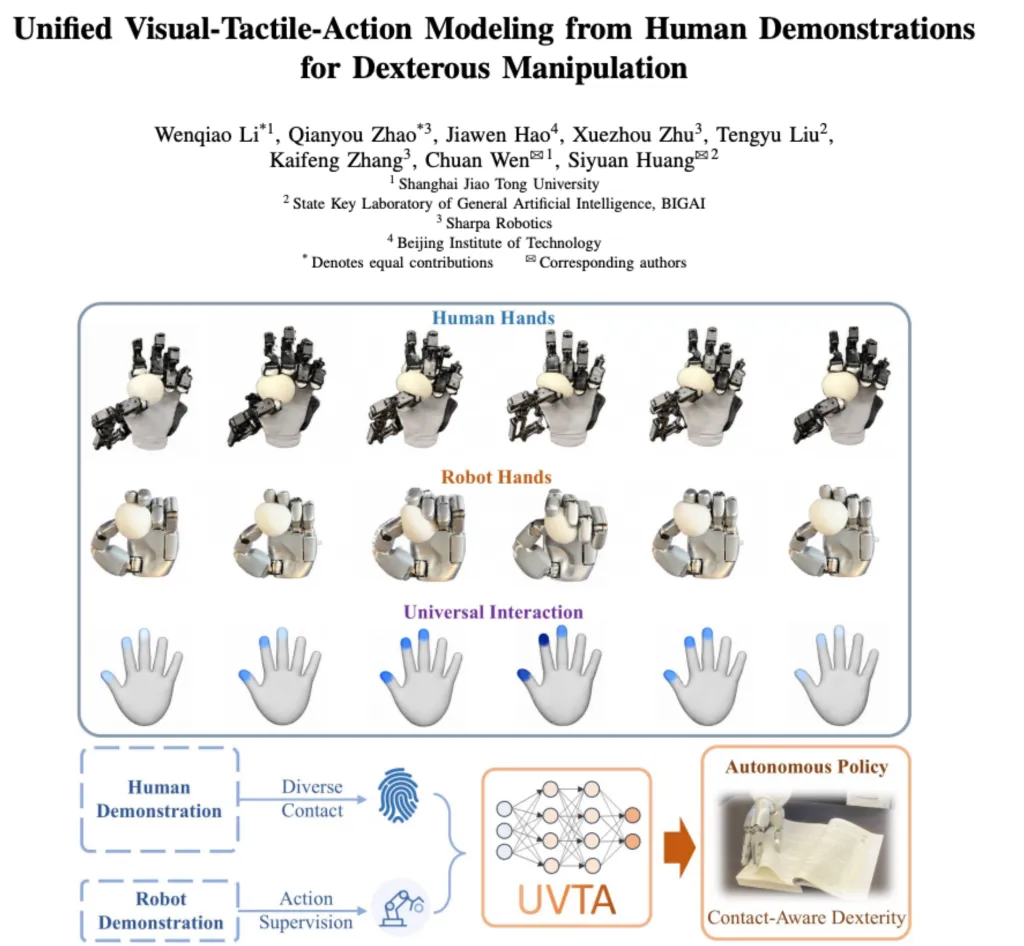
论文标题:Unified Visual-Tactile-Action Modeling from Human Demonstrations for Dexterous Manipulation
数据采回来之后,怎么证明它有用?UVTA 的做法是把人类演示和少量机器人遥操作数据放在一起联合训练,将二者映射到共享的视觉 - 触觉 - 动作空间,让模型同时预测未来的动作和触觉信号。人类数据只作为训练监督,部署时机器人执行的始终是自己的动作。用张凯峰的话说,是「联合建模视觉和触觉之间的关系,去预测未来的状态和触觉信号,最后再 grounding 到动作信号上去」。
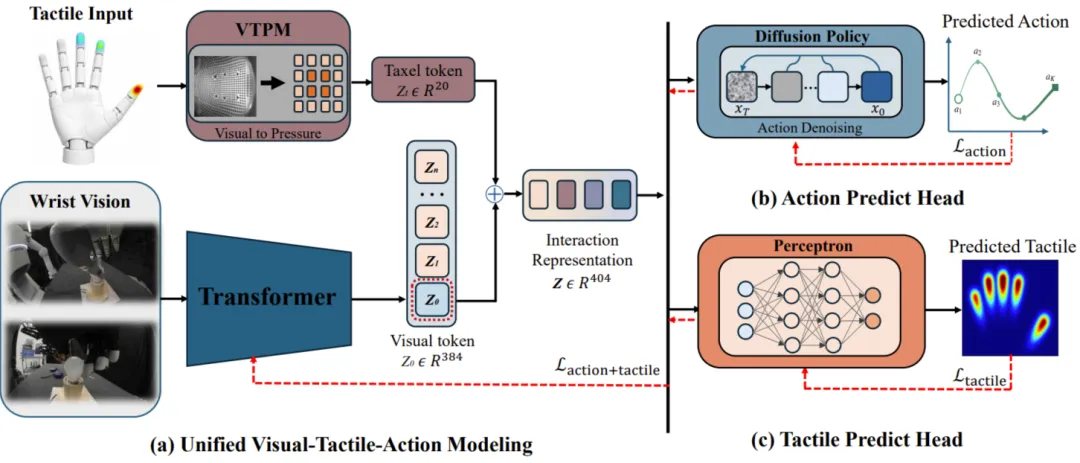
UVTA 概况。VTPM 将视觉 - 触觉输入转换为 20 维压阻式触觉单元 token,而 Transformer 提取 384 维视觉 token。这两个 token 被拼接为统一的 404 维交互表示,并传递给扩散动作头和触觉回归头。动作损失和触觉损失分别监督各自的预测头,而它们的联合目标优化共享的 Transformer,以学习统一的触觉感知视觉表示。
在翻书、拧灯泡、拨开关、小球分类、液体转移五个接触丰富的任务上,UVTA 的平均成功率为 70%,作为对照的 T-Rex 为 29%。更值得注意的是一组 Scaling 实验:固定每个任务 150 条机器人演示,把人类演示从 0 条逐步增加到 1000 条,三个任务的平均成功率从 0% 上升到 84%,论文称在 1000 条时仍未观察到饱和。
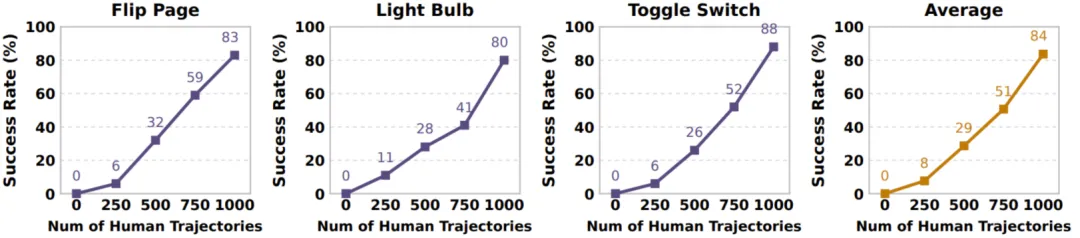
UVTA 论文人类演示数量与成功率的 Scaling 曲线
另一项工作 DexEMG 则尝试进一步降低采集门槛。它用前臂的表面肌电信号推断手部姿态,再实时重定向到 22 自由度的 Sharpa Wave 灵巧手上,替代笨重的外骨骼和视觉动捕。由于不依赖摄像头,手指被物体遮挡时依然可以正常遥操作。
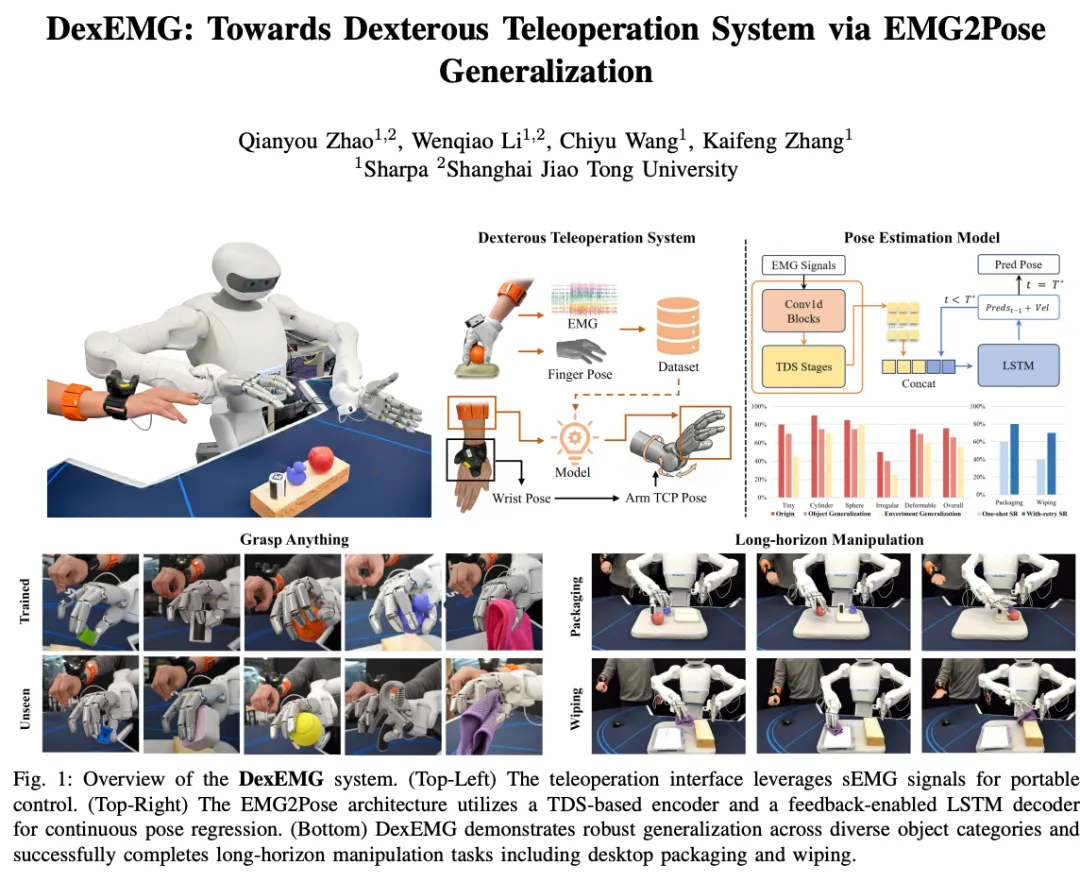
论文标题:DexEMG: Towards Dexterous Teleoperation System via EMG2Pose Generalization
但同时,真实世界中还存在另一类体量更庞大的资产:互联网上数以万小时计的无触觉人类单目视频,如果视频里根本没有记录触觉,人机动作鸿沟又该如何弥合?
在 Sharpa 与清华大学徐梦迪团队合作的 Dex-X 方案中,研究者开辟了另一条路径:从单目 RGB 人类视频中精准提取人手与物体的三维空间运动轨迹,再将这段轨迹导入物理仿真环境中,仿真引擎通过碰撞体与接触动力学,反向补足了真实视频中不可见的手 — 物交互力学信息,从而实现了从纯人类视频到真机触觉策略的有效迁移。
论文标题:Learning Visual-Tactile Dexterous Manipulation From Human Videos with Simulated Interaction
可以看出,从 UVTA 的真机触觉增强,到 DexEMG 降低采集门槛,再到 Dex-X 的仿真力学补全,主线一正在把数据采集的重心从「逼迫人适应机器」彻底转向「让系统理解人类的手感」。这类工作的意义在于,它们把「人类数据到底能不能用于灵巧操作」这个定性问题,变成了一个可以用 Scaling 曲线来回答的定量问题。
但视频里始终没有力。动作可以重定向,接触却无法凭空生成。这一环怎么补,是第二条主线要回答的问题。
主线二:解耦「运动」与「交互」,重构接触控制的通用底座
即使拿到了数据,灵巧操作的难点依然集中在接触的那一刻。张凯峰提到,遥操作最困难的地方,就在于和物体接触时,机器人的感受无法高保真地传递给操作员。
既然接触是瓶颈,一个自然的思路就是把运动和交互拆开处理:运动部分,可以从人类视频甚至互联网视频中学习;交互部分,也就是接触丰富的那一段,交给仿真和强化学习。
这种拆分有其物理上的合理性。接触前的大范围移动更接近运动学问题,人类视频能提供丰富的先验;接触后的挤压、滑动和力控则是动力学问题,对误差高度敏感,而这恰恰是视频最缺失的信息。
这个思路体现在 Sharpa 于 CES 2026 公开的 CraftNet 分层模型中。
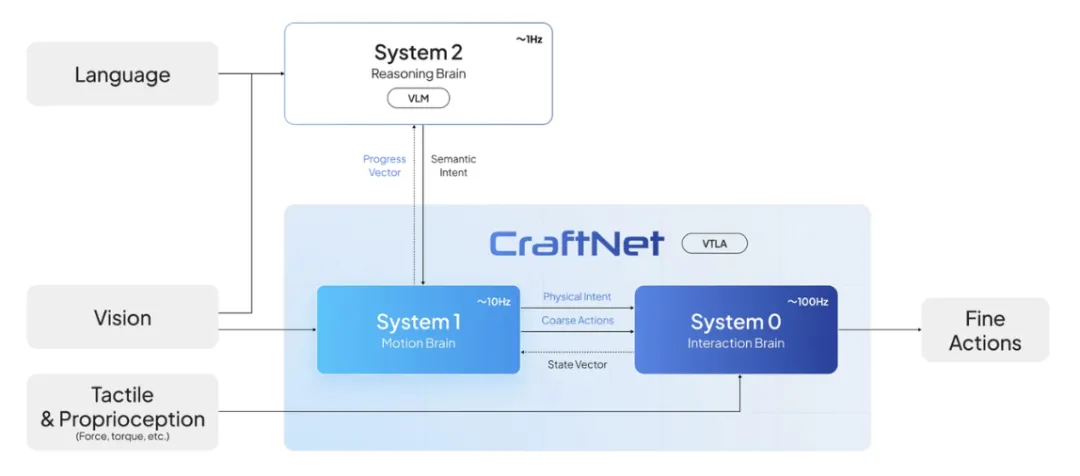
CraftNet 三层架构示意图
CraftNet 把机器人的决策分为三层:
System 2 是「推理脑」,由视觉语言模型负责理解指令、拆解任务,运行频率约 1 Hz;
System 1 是「运动脑」,负责运动规划和接触前的粗略控制,约 10 Hz;
System 0 是「交互脑」,在接触阶段利用实时触觉反馈持续调整手指,约 100 Hz。
拆开之后,新的问题随之而来:运动和交互之间,用什么接口连接?上层要给底层传递什么信息,底层又该如何响应?
围绕这个问题,Sharpa 和合作团队的工作探索了几种不同的答案。
第一种接口是一块踏板。这要回到开头的苹果。MoDE-VLA 论文中,研究者先用强化学习训练了一组手内操作的原子技能,称为 IMCopilot,包括保持稳定抓握、让物体绕指定轴旋转等。采集数据时,操作员用外骨骼控制手臂动作,需要转动苹果时,用脚踩下踏板,手内旋转就交给 IMCopilot 自动完成。张凯峰形容这是「手脚并用」:脚踩踏板驱动底层转苹果,手上专心控制削皮。
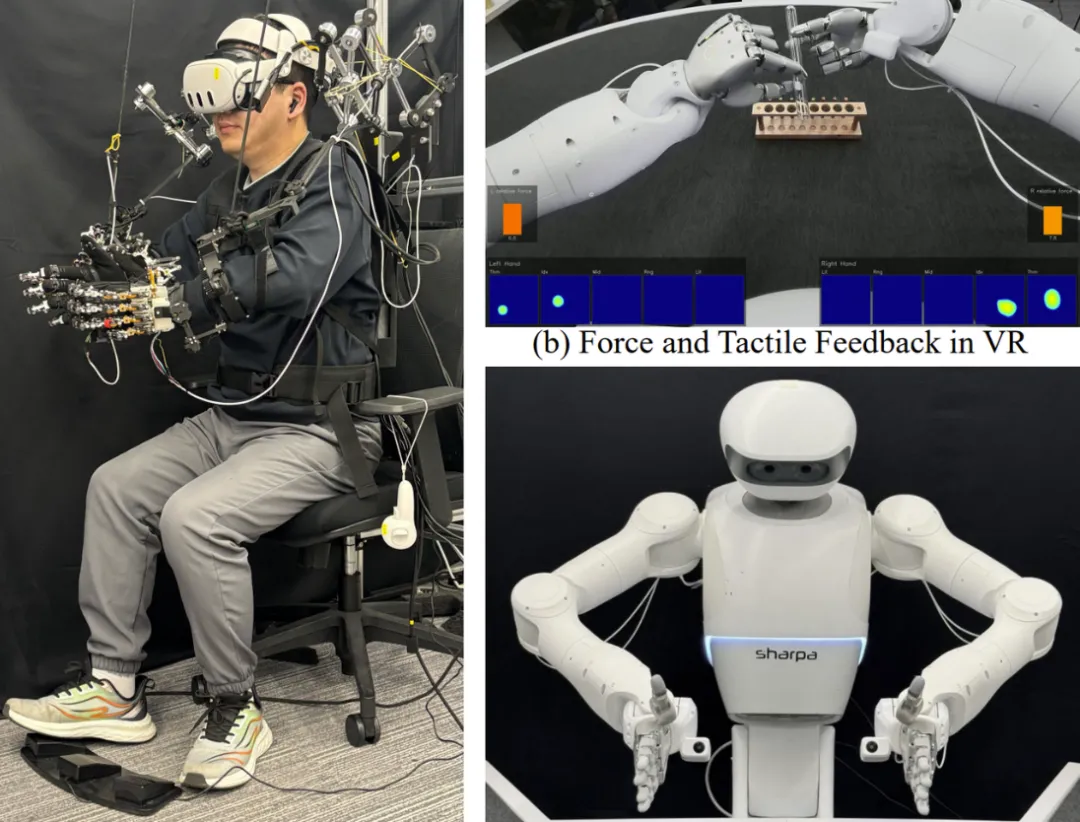
系统概述。(a) 遥操作系统,包含外骨骼、VR 头显和脚踏板。(b) VR 视图,将机器人摄像头画面与实时力和触觉反馈叠加层集成在一起。(c) 用于执行富接触任务的机器人平台。
效果相当好。在手内操作试验中,IMCopilot 辅助下的成功率为 89%,直接遥操作仅为 34%。高质量的削苹果数据由此得以采集。到了自主执行阶段,VLA 模型同样可以调用 IMCopilot 这一底层技能,再配合一条专门处理力和触觉信号的专家通路,就构成了 MoDE-VLA。在削苹果、试管整理、齿轮装配、充电器插接四个任务上,MoDE-VLA 的平均成功率从基线的 15% 提升到 34%,削苹果的成功率从 0% 提升到 30%,削皮完成度从 8% 提升到 73%。
张凯峰认为,这只是第一步。「将来我只要给一些目标点、一些操作意图,就能够驱动灵巧手底层的 controller 去做一些比较灵巧的类人操作,」他说,「把接触丰富的这些操作交给底层的 controller,上层只需要给一些意图和粗糙的轨迹动作。」
第二种接口是点云。典型的便是 Dex-X,其走的是一条自上而下的路线。它从单目人类视频中重建手与物体的交互过程,然后在仿真中让强化学习策略去跟踪这段参考动作。视频里缺失的接触力信息,在仿真里被物理引擎补全,论文把仿真称为「触觉补全引擎」(tactile completion engine)。最后,仿真中的策略被蒸馏为一个以点云、本体感知和指尖触觉为输入的学生策略,部署到真实的 Sharpa Wave 灵巧手上,在真机方块抓取任务中取得 93% 的成功率。
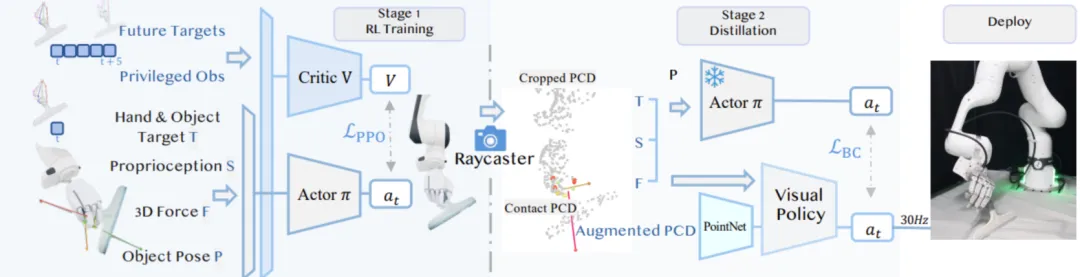
DEX-X 的训练框架。将人类演示迁移到仿真环境后,利用强化学习训练一个基于特权状态的专家,并结合演示参考、物体状态和触觉接触信息。随后,该专家被蒸馏为一个多任务视觉 - 触觉策略,运行在统一的接触点云表示上,该表示将指尖触觉反馈嵌入场景几何中,并融合视觉、力和本体感觉以进行策略学习。所得策略能够零样本迁移到多种真实世界的灵巧操作任务中。
同样的自上而下思路,也出现在其他团队基于 Sharpa 硬件的研究中。伯克利 Jit
来源:机器之心