

技能人工智能 通过使用S1机器人基础模型,通过超过140年的模拟游戏来学习足球.
该公司表示,该技术最终可以让机器人在工厂,建筑物,房屋和其他物理环境中获得越来越复杂的技能,
Skild使用英伟达艾萨克·西姆创建模拟环境,给模型一个目标:打进一个目标.
而不是指明个人行为,如球,球或摔倒后恢复,研究人员允许该政策与逐步更有能力的版本竞争.
史基尔德说: 政策随后通过与最新版本进行比赛来学会得分. 随着其进步,它的对手也随之进步了. 将每种能力的增长变成越来越困难的对手.
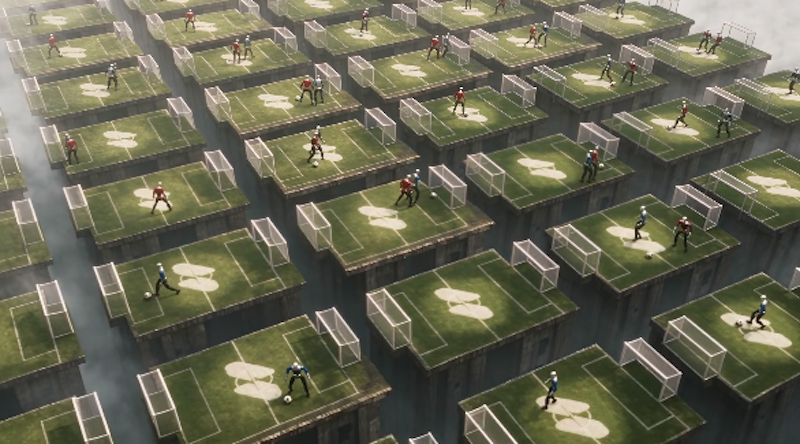
在最初的几个模拟月里,机器人几乎无法行走. 随着训练的继续,它学会了在摔倒后恢复,随后发展出了行为,包括围绕防守者冲刺,保护球和对手的攻击.
根据Skild的说法,这些能力源于得分的目标,而不是每个行为的个别设计的奖励.
经过140多年的模拟游戏,Skild将来自模拟的政策转移到一个物理的人形机器人,
该公司表示:"我们认为从模拟到人形机器人的成功转移,以及任务的巨大复杂性,
这项工作代表了该公司8月推出的S1机器人基础模型的培训后扩展.
S1预先使用包括人类视频,手套数据,模拟和远程操控在内的数据进行训练,并且旨在从文本中的示范中学习任务.
然而,Skill认为,从人为生成的数据中进行培训,最终将模型限制在这些数据中所代表的能力上.
该公司表示:"然而,由于S1类型的模型以人类数据进行预训练,因此它们仅限于人类的能力.我们相信物理自动游戏将使机器人能够远远超越人类的能力.
自动游戏以前在基于软件的AI系统中取得了显著进展.
DeepMind在AlphaGo系统中广泛使用了这种方法,而自动游戏随后为能够玩多人游戏的系统提供了贡献,包括StarCraft II和Dota 2.
机器人不仅必须学习策略,还必须学习在现实世界中执行它们所需的物理运动.
足球是一个艰巨的考验,因为它结合了运动,操纵,从身体上的障碍中恢复和与对手的战略互动.
该公司表示,这种方法不仅限于体育,
根据该公司的说法,早期的四个代理足球实验已经开始产生包括通过和协调在内的行为.
预计未来的工作将探索协作操纵和导航,因为互动机器人数量增加.
史基尔德说:"这个模拟已经运行了超过一个世纪,但这个目标是微不足道的.
研究指向扩大机器人学习的另一种方式:使用人类数据和示范来建立广泛的基础能力,然后通过大量的模拟经验,允许机器人自主提高这些能力.
如果这种方法成功地转移到实际任务,它可以减少对机器人越来越复杂的行为教学所需的人类生成数据的数量.