

把模型部署到昇腾 NPU 上,计算逻辑确定之后,还有一道难题:怎样让底层实现充分利用硬件?同一个注意力计算,分块、搬运、并行和同步方式不同,运行时间就可能明显不同。
大模型能够生成代码,Coding Agent 还能调用工具、编译运行并迭代修改,但当其面对知识储备不足的硬件平台,应该怎样完成编译、纠错到性能优化的完整流程,再把经验用于下一个算子?围绕这个问题,复旦大学与华为小艺团队提出 SAGE,将知识冷启动、工具增强诊断与经验学习连接起来。
论文标题:From Experience to Expertise: Adoption-Aware Memory Learning for Data-Scarce NPU Kernel Synthesis
一、从代码生成到高性能实现,还缺什么?
1. 算子开发为什么需要硬件经验?
深度学习模型中的矩阵乘法、归一化、注意力等计算,最终都由硬件上的程序执行。算子内核(kernel)就是承担这些计算的底层实现。数学公式描述 “算什么”,算子开发还要决定 “数据放在哪里、每个核处理多少工作、搬运和计算怎样配合”。
对工程师而言,优化往往涉及几类判断:
数据分块:一个张量不能总是一次放进片上存储,需要拆成合适大小的块;块太大可能超过容量,太小又可能增加搬运和调度开销。
并行划分:任务能否分给更多计算核,核之间是否均衡,有没有只用到少量核的情况。
搬运与计算:能否减少中间结果的重复读写,或者让数据准备与计算重叠。
同步依赖:哪些等待是保证正确性所必需的,哪些等待过于保守,限制了流水执行。
这些选择相互影响。改变分块可能需要重新安排缓冲区;增加并行度可能改变同步关系;减少一次数据块搬运,也可能要求调整后续计算的读取方式。一个能运行的实现,只是性能优化的起点。
2. Agent 怎样完成这条开发流程?
本文中的 Coding Agent,是能够写代码、调用工具并依据反馈迭代修改的大模型开发助手。算子开发包含以下环节:
生成实现:根据输入、输出和计算逻辑,组织 host 侧配置与 kernel 侧代码。
编译修复:处理接口、类型、模板参数和配置问题,得到可执行候选。
正确性验证:在真实设备上运行,与参考结果比较,检查数值误差及运行异常。
性能优化:建立正确版本的时延基线,定位瓶颈,尝试更快的实现。
每次修改都可能重新引入错误,因此优化后的候选仍要重新编译、验证和测量。同步少了一次,程序可能快了,也可能读取尚未写完的数据;并行多开几个核,可能提升吞吐,也可能破坏工作划分。性能收益必须建立在正确性通过的基础上。
这也意味着,Agent 不仅需要代码生成能力,还需要理解诊断信息、选择工具、保留测试记录,以及从多次尝试中识别可复用的做法。
3. 已有方法走到了哪一步?
大模型算子开发已经形成了几条互补路线。理解它们各自解决的问题,有助于看清 SAGE 的出发点。
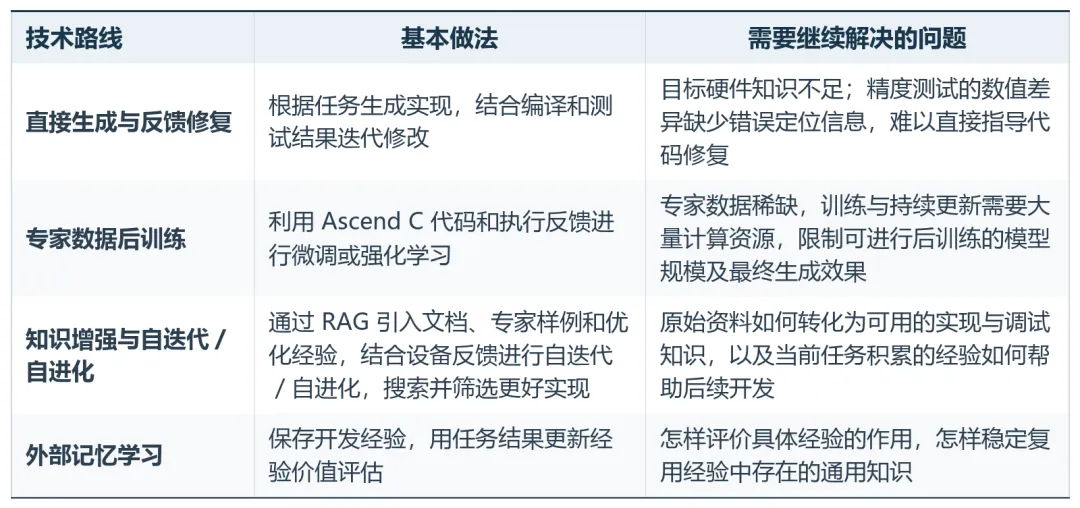
这些路线已经让模型从 “一次生成” 走向 “在设备上反复验证”。但在公开代码较少的平台上,仍然需要解决一个基础困难:模型在熟悉平台上的能力,不能直接等同于它在新硬件上的开发能力。
论文引言引用的一项研究报告显示:GPT-5.2 在 KernelBench Level-1 任务上的 CUDA 正确率为 92%,Asc
来源:机器之心