

来自新加坡国立大学、可灵 AI 和香港科技大学的研究团队提出了 DiffusionART,一种面向图像和视频生成的在线 Diffusion RL 算法。该方法支持采用 ODE 采样,不要求奖励模型可微,也无需额外调参,可自然适配标量奖励、二值偏好奖励等多种奖励形式,具有极高的样本效率。在 HunyuanVideo-13B 的视觉质量和运动质量实验中,DiffusionART 达到 DiffusionNFT 和 Flow-GRPO-Fast 后期平均奖励水平的速度分别快 12.02 倍和 11.72 倍。DiffusionART 曾在论文公开当天登顶 Hugging Face Daily Papers 日榜 Top 1。
作者介绍:该工作的第一作者为新加坡国立大学(NUS)计算机系博士生万政霖,主要研究方向为多模态理解与生成、强化学习,指导老师为 NUS 校长青年教授尤洋老师。通讯作者为可灵 AI 算法研究员陈佳煜,本科及博士均毕业于清华大学电子工程系。
Hugging Face 模型链接: https://huggingface.co/collections/vanzl/diffusionart
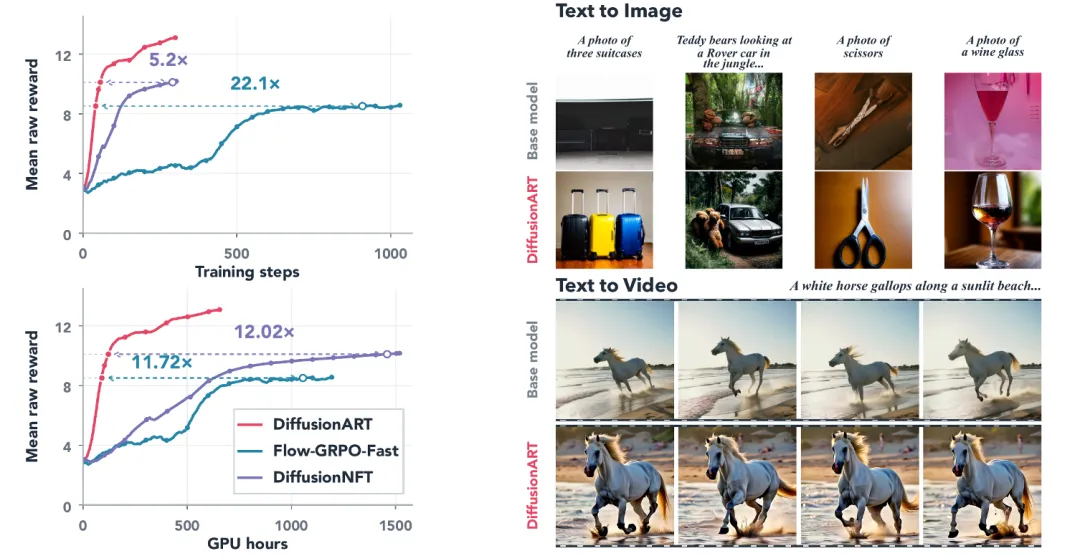
图 1|左侧展示 HunyuanVideo-13B 在等权 VQ/MQ 下的训练曲线与 GPU-hour 效率;右侧展示相同 prompt 的图像和视频生成案例。
一、现有路线的缺陷:有的更新太慢,有的更新快却不稳定
扩散模型后训练技术在视频生成业界的地位越来越重要,它主要分为两种范式:
Reverse-process RL,以 Flow-GRPO 为代表,更接近传统 RL 范式。它将反向去噪过程建模为 MDP,通过 ODE-to-SDE 转换计算策略梯度。但最终 reward 被无差别地分配到轨迹中的每一步,导致信用分配不佳,训练效率受限。
Forward-process RL,以 DiffusionNFT 为代表,更接近 Diffusion 的监督训练范式。它对生成结果重新加噪,通过 reward 加权的正负双分支进行回归,无需转移概率,可沿用高效采样器。但其稳定性依赖正负分支联合训练和需要按任务调参的 EMA off-policy 策略:单分支训练或直接 on-policy 更新都容易崩溃。
这里出现了 DiffusionNFT 原文尚未探索清楚的现象:
1. 在理想推导中,朝正样本分布靠近、远离负样本分布,本来指向相同的梯度方向。为什么实践中少一个分支就不行?
2. 为什么一定要 off-policy 训练才能稳定?On-policy 和 off-policy 在 Diffusion 这种连续空间 RL 里面的本质区别是什么?
二、三个机制洞察
从理解前向 RL 的本质和不稳定性来源出发,作者得到三个关键洞察:
洞察 1:前向速度与反向速度之间的差距,会在优化过程中带来一项隐藏的力
模型生成的样本可以通过直线加噪定义理想前向速度场,但它并不等于模型实际生成时使用的反向速度场。
论文将 NFT 的更新在输出空间展开,发现除了 reward-improving guidance,还存在一项由两个速度场差异产生的 forward–reverse consistency force(前向 — 反向一致性力)。这项力并不直接改善奖励,却可能产生较大的参数梯度,干扰奖励优化,引发 gradient spike 甚至 reward collapse。问题不在于缺少正确的奖励方向,而在于优化过程中混入了额外的一致性力。
洞察 2:双分支的作用是在相互抵消这个危险的力
正、负分支的 reward guidance 方向一致,但携带的一致性力方向相反。因此,联合训练能够部分抵消额外的一致性力,解释了为什么单独训练任一分支都容易崩溃。
然而,这种抵消并不彻底。Reward normalization 只能保证样本组内的系数平衡,无法保证每个 state 的一致性力相互抵消。经过不同 state 的模型 Jacobian 映射到参数空间后,仍可能留下较大的残余梯度。因此,双分支只能缓解一致性力的干扰,无法从目标构造上彻底消除它。
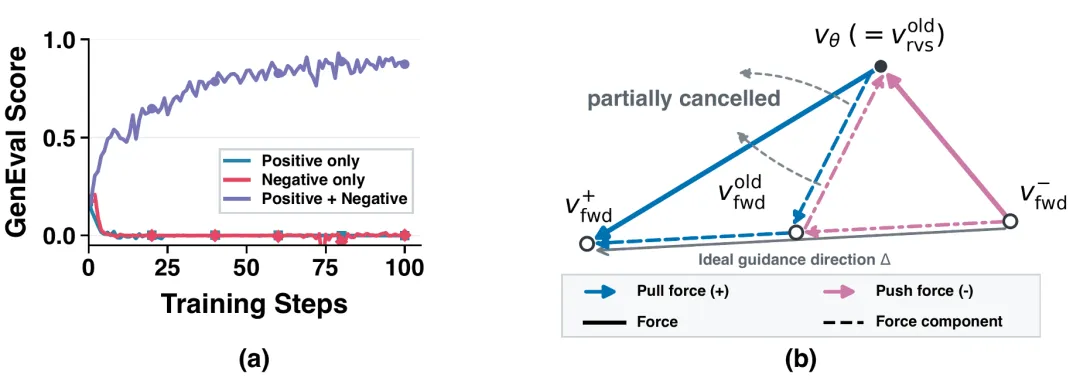
图 2|左侧:单独训练正分支或负分支都会发生崩溃,联合训练表现更好。右侧:两分支沿奖励方向相互增强,却只能部分抵消一致性力。
洞察 3:EMA 的关键稳定机制,是 loss 中的恢复力,而不只是 off-policy 数据
EMA 同时改变了两个因素:生成 rollout 的策略,以及 loss 中作为参照的 old policy。究竟哪个因素带来了稳定性?消融实验发现,即使保留 EMA rollout,只要将 loss 中的 old-policy anchor 替换为 current policy,训练仍然崩溃。进一步的梯度分解揭示:EMA 的关键作用是引入一项将当前模型拉回 old policy 的 restoration force(恢复力),而非仅仅使用 off-policy 数据。模型偏离旧策略越远,恢复力就越强。
研究团队进一步发现,即使不使用 EMA,将每轮 rollout 数据拆成两个互斥 minibatch、连续更新两次,也能自然产生恢复力,在实验观察区间内避免崩溃。但代价是训练效率明显下降:仅仅是将一次 rollout 的模型更新次数从 1 变成 2,导致 OCR 任务的训练效率降低 15 倍。更反直觉的是,恢复力在输出空间的 RMS 比 guidance 小 9.4 倍,聚合到参数空间后的梯度范数却大 4.9 倍。
这揭示了恢复力极强的梯度转化效应:即使输出空间的恢复力很小,也可能压过有效的奖励梯度。因此,稳定训练需要 Restoration,但过强的恢复力又会压制 Reward Guidance,导致训练稳定却低效。
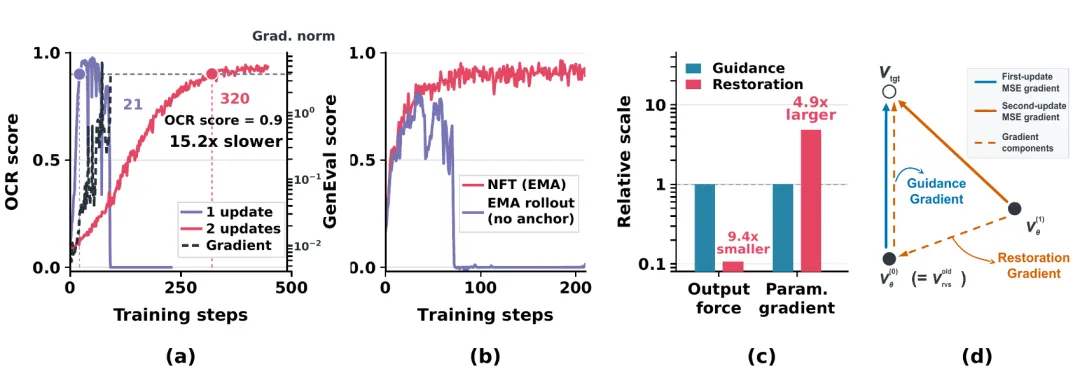
图 3|从左到右:NFT 单次更新与两次更新的 OCR 曲线;保留 EMA rollout、移除 anchor 后的崩溃;输出力与参数梯度的尺度对比;第二次 MSE 更新如何分解为 guidance 与 restoration。
三、DiffusionART:先聚合奖励方向,再让恢复力随漂移出现
前面的分析给出了两个设计目标:从目标构造上消除一致性力,而非依赖跨样本梯度抵消;无需 EMA 调参,也能获得适度的恢复力。
基于此,研究团队提出 DiffusionART(Diffusion Reinforcement with Aggregation-First Reward Tilting),保留简单的 MSE 回归接口,但重新设计奖励方向的构造方式与作用位置。
1. Aggregation-First:先聚合奖励,再指导真实去噪 States
对同一个 prompt,ART 首先根据一组生成结果及其奖励,计算共享的奖励改善方向:
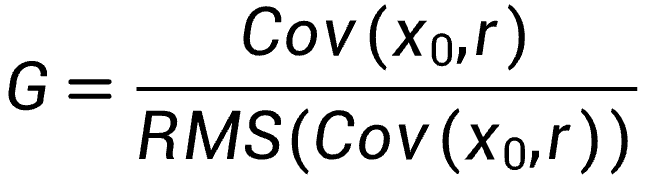
从 reward tilting 的角度看,提高高奖励样本的权重,生成分布均值的一阶变化方向正是该协方差。RMS 归一化则统一 guidance 尺度,减少不同 reward 范围的影响,无需额外调节 guidance strength。
随后,将共享 guidance 作用于真实 ODE rollout 经过的 states,通过冻结目标进行 MSE 回归:
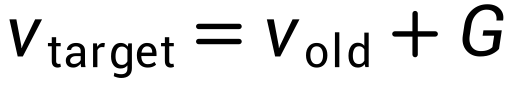
与 NFT 不同,该目标不依赖前向加噪得到的理想速度场,因此从目标构造上消除额外的一致性力。
这正是 Aggregation-First 的关键:不是先在每个 state 引入带有一致性力的 guidance,再依赖梯度聚合抵消干扰;而是先在
来源:机器之心