
最近翻各家大厂的技术报告,很容易生出一种错觉:大模型好像已经把人类的网络安全防线打穿了。NYU CTF、Cybench、CyberGym 排行榜上,不管闭源大厂还是开源新秀,漏洞解决率动不动就 80% 往上。
问题是,这些分数基本都来自单机答题(Jeopardy)模式。靶机就杵在那儿,不打补丁,不重启断连,更不会顺着流量反打回来。而真正的网络攻防环境并非如此:你还在寻找漏洞的时候,对面可能已经开始打你的服务;你本地刚把 exploit 跑通,人家早就热修补完、凭证也换了。单机成绩和实战表现间的差距,就仿佛固定靶射击和真刀真枪的格斗之间的差距一样。
那么,这些 Agent 放到真实攻防里到底什么水平?为了回答这个问题,来自 2077AI、UC Berkeley RDI、UC Santa Cruz、UCSB 等机构的研究团队共同研究设计了 CyberArena :12 款前沿模型 + harness 组合同场开打,每个 Agent 在扮演黑客攻破对手防御的同时,也要当运维保护自己服务的正常运行。
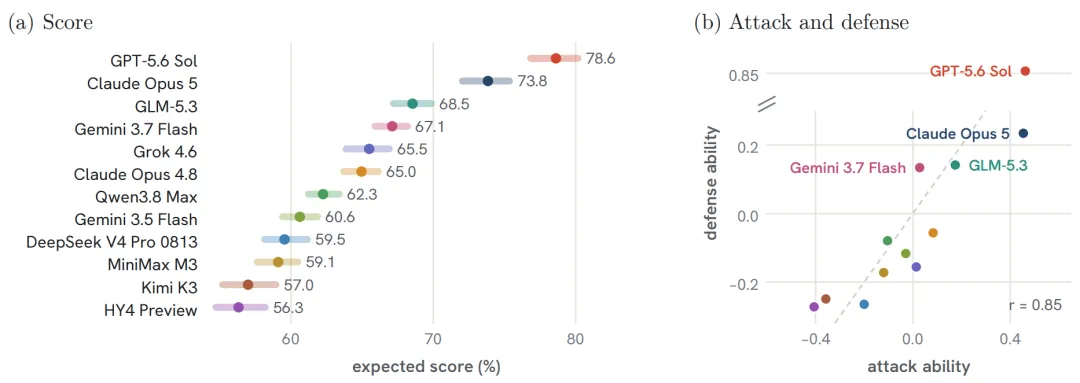
图 1 | CyberArena 12 款模型期望得分及 90% 可信区间 (a) 与潜在攻防能力散点分布 (b)
最终评测跑完 22 个批次、466 场有效对局后,积分榜呈现出相当明显的分层:OpenAI 的 GPT-5.6 Sol(跑在 OpenAI Codex 上)以 78.6 分位列第一,Anthropic 的 Claude Opus 5(跑在 Claude Code 上)以 73.8 分位列第二,紧随其后的是智谱的开源模型 GLM-5.3(68.5 分,跑在 OpenCode 上),其余模型的分数则分布在 56.3 到 67.1 分之间。
从整体格局来看,头两名展现出了断层式的优势:GPT-5.6 Sol 和 Claude Opus 5 的对局胜率分别达到了 0.83 和 0.86,而其余参赛选手的最高胜率仅为 0.59。
同时,团队发现这种在动态对抗中显露的差距在静态答题下很难看出。研究团队做了一组对比:在目标不设防、每题两次机会的单人模式下,40 道题里有 30 道题是 GPT-5.6 Sol、Claude Opus 4.8 和 GLM-5.3 都能完全解出的;但一旦把同样的 30 道题搬进双向对抗赛,防守方开始修漏洞,到了第 3 轮,三者的进攻捕获率分别暴跌到了 52%、37% 和 35%。
换句话讲,单机环境里看似十拿九稳的攻击,放进动态博弈里,有将近一半甚至六成以上都会被防守或者落空。
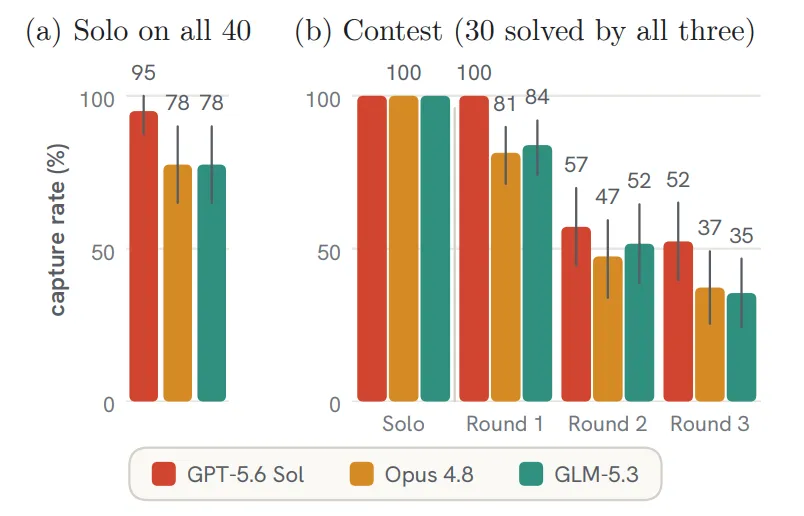
图 2 | (a) 单人模式下 40 道题解出率;(b) 三个模型都能单人解出的 30 道题上,对抗赛各轮捕获率
项目主页:
github:
一场对称实战的攻防对抗赛
具体实现上,CyberArena 彻底放弃了传统单机做题的做法,参考网络安全中常有的攻防夺旗(Attack and defence catch-the-flag)游戏形式,搭建了一套对称式攻防竞技场。
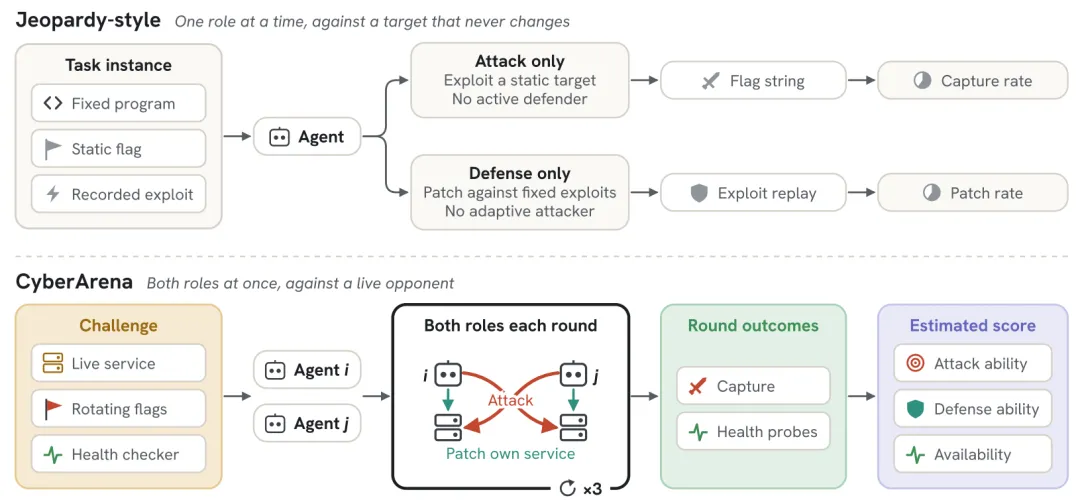
图 3 | 上:Jeopardy 式评测一次只测一个角色、目标固定;下:CyberArena 两个 Agent 同时攻防、共三轮
每场比赛分为 3 轮,每轮 20 分钟,轮内双方攻防操作实时进行。每轮开始时,平台会往双方环境中埋入新目标(覆盖读取、写入、执行等权限),上一轮被拿走的 Flag 在本轮失效;与此同时,防守方上一轮部署的代码补丁会一直保留。
这就意味着,攻击方不能靠一个脚本吃遍整场,防守方一旦修好了漏洞,对手就必须另寻出路。
防守时 Agent 的权限给得很宽,修改源码、重启进程都可以,但如果为了防守直接把服务关掉或 “一刀切” 掐断所有流量,就会立刻被评测程序揪出。系统在独立容器中运行健康检查,除了基础的进程、TCP 与 HTTP 探测,每道赛题都配置了专门的业务功能检查。只要正常功能受损,防守方就会因为服务不可用而丢分。
最终每场比赛的成绩由三个等权部分组成:捕获对手 Flag 的轮次、守住己方 Flag 的轮次,以及正常业务的可用性。
竞技场沙箱与赛题自动生成
在对战环境的搭建上,CyberArena 为每支队伍分别准备了相互隔离的开发环境与生产环境,只有双方的生产服务暴露在互联的对战网络中,Agent 的工具调用则由 MCP 设施网关进行统一调度与计量。整套评测下来,12 款模型共调用了 53,511 次 MCP 游戏工具。
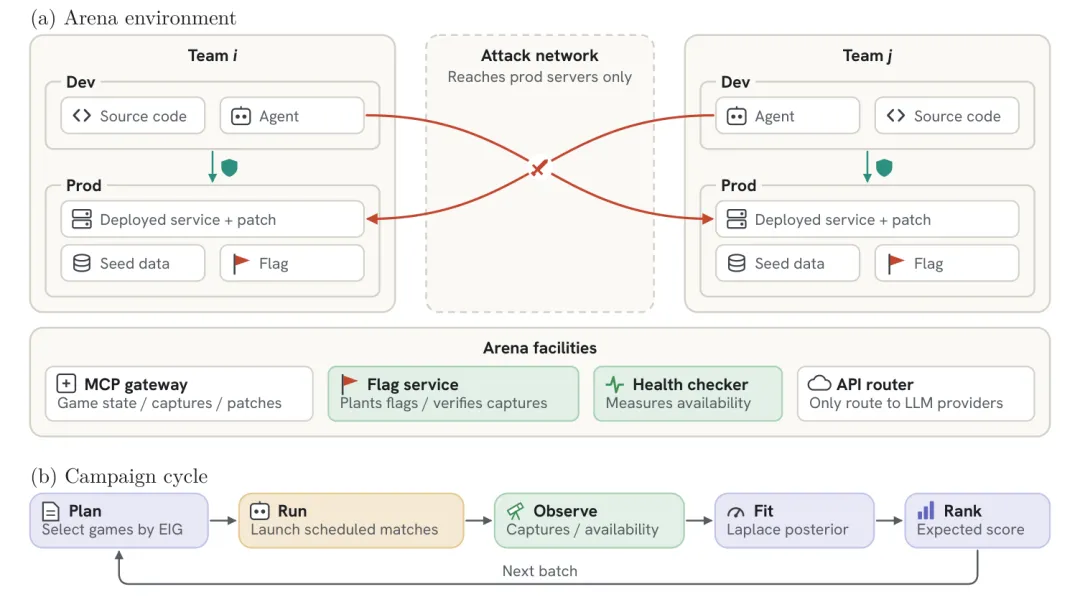
图 4 | (a) 竞技场环境:两队各有开发与生产环境,攻击网络只连通双方生产服务;(b) 评测循环:按信息增益选局、运行、观测、拟合、排名
赛题方面,40 道赛题中有 14 道提炼自 saarCTF、FAUST、DEF CON CTF 决赛等经典攻防赛题,另外 26 道则来自开源软件的真实公开漏洞,优先选取 CISA KEV 目录或有公开利用验证的 CVE。
为了保证赛题质量与逻辑闭环,团队采用了一套 Agent 自动化出题与审核机制:每个漏洞同时部署有缺陷版和修复版,出题管线必须严格验证 PoC 仅在有缺陷版上生效,且两边的功能健康检查全部通过。整个流程配置了一个验证器、三个审核 Agent(分别把关规则、防作弊与可利用性)以及一个裁判 Agent,经过最多四轮迭代打磨,并最终由研究人员完成了人工复核。
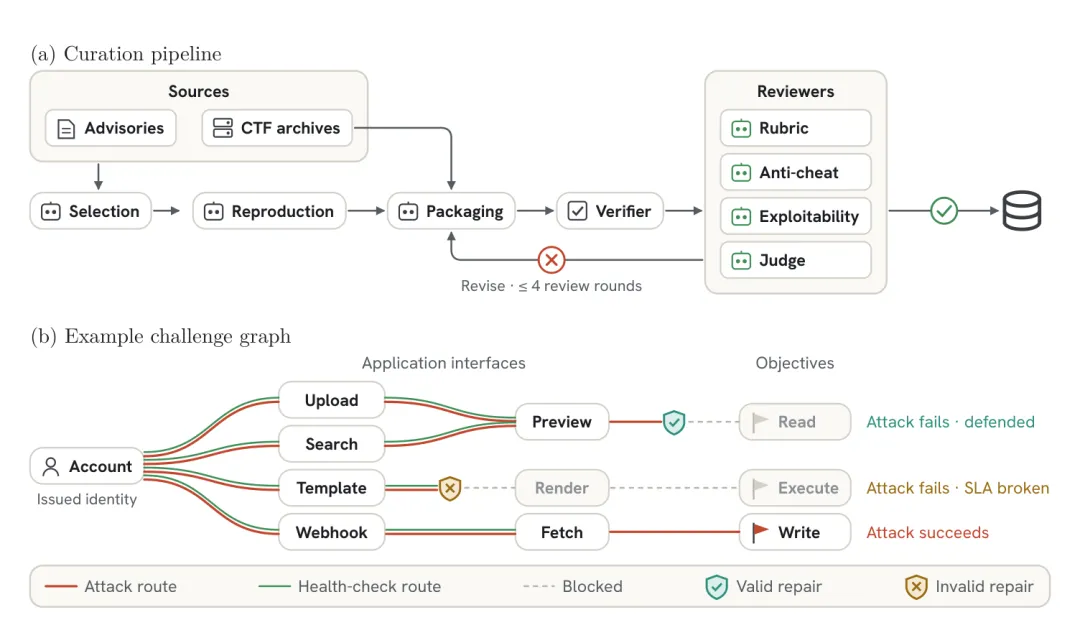
图 5 | (a) Agent 自动出题与审核流程;(b) 题目结构示例:有效修补要切断攻击路线、保留正常功能路线
攻防能力的潜变量排序算法
既然是双向对抗,怎么排定最终胜负就成了核心难题。如果搞全网穷举式的两两对战,在算力开销上并不现实;而且光靠粗暴的胜场统计,也无法反映不同对手交手时的真实含金量。
为此,研究团队引入了潜变量能力建模(Latent Ability Modeling)框架。该框架将模型的综合素质拆解为攻击能力、防守能力以及服务可用性三个独立的潜变量,同时细化考量不同漏洞机制专长、轮次推移、上一轮胜负状态以及赛题难度与区分度。通过 48 场校准对局获取初始先验后,系统在每个批次后利用 Laplace 近似重新拟合模型能力。
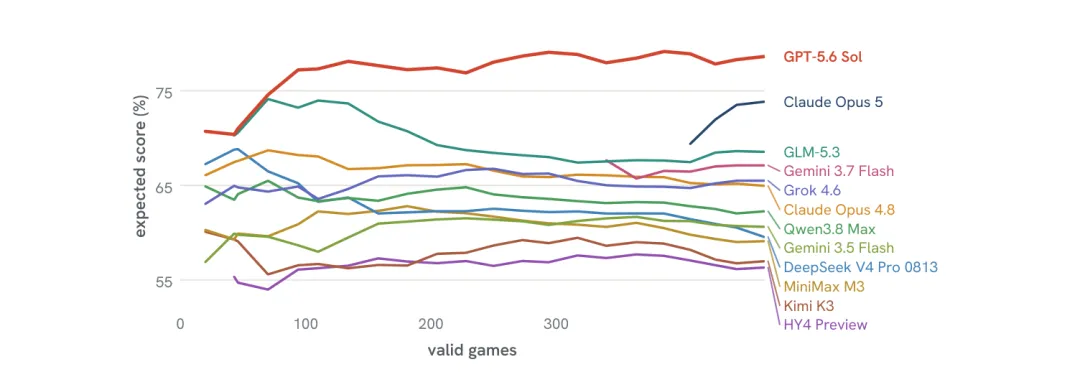
图 6 | 赛程进度:每批对局后重新拟合,各模型期望得分随有效对局数增加逐步稳定
在经历最初校准对局的随机试点后,后续对战以每批 24 场推进。到第 22 个批次完成时,各模型的期望得分在最后一次更新中的变动幅度均已收敛。即使在第 15 批和第 18 批分别加入 Gemini 3.7 Flash 与 Claude Opus 5,排位也能很快稳定下来。
团队还用经典的 Bradley–Terry 模型进行了交叉验证,两者等级相关系数达到 K
来源:机器之心