
引言
今天,我们发布 Perceptron Egocentric 1.0。这是一款自助式 API,可将人类和机器人的第一视角视频转化为机器人训练所需的结构化数据。它提供具有前沿水平的子任务时间线、每只手的连续活动标签,以及最先进的 3D 手部重建,每小时视频收费 29 美元,不到 GPT-6 Astra 仅生成子任务时间线费用的一半,后者约为 76 美元。所有功能均可通过同一个 API 使用。
家务
家务:洗碗
家务:戴手套洗碗
家务:冲洗托盘
机械臂
机械臂:机器人分拣
机械臂:机器人整理
制造业
制造业:电路板组装
制造业:装箱
制造业:连接器组装
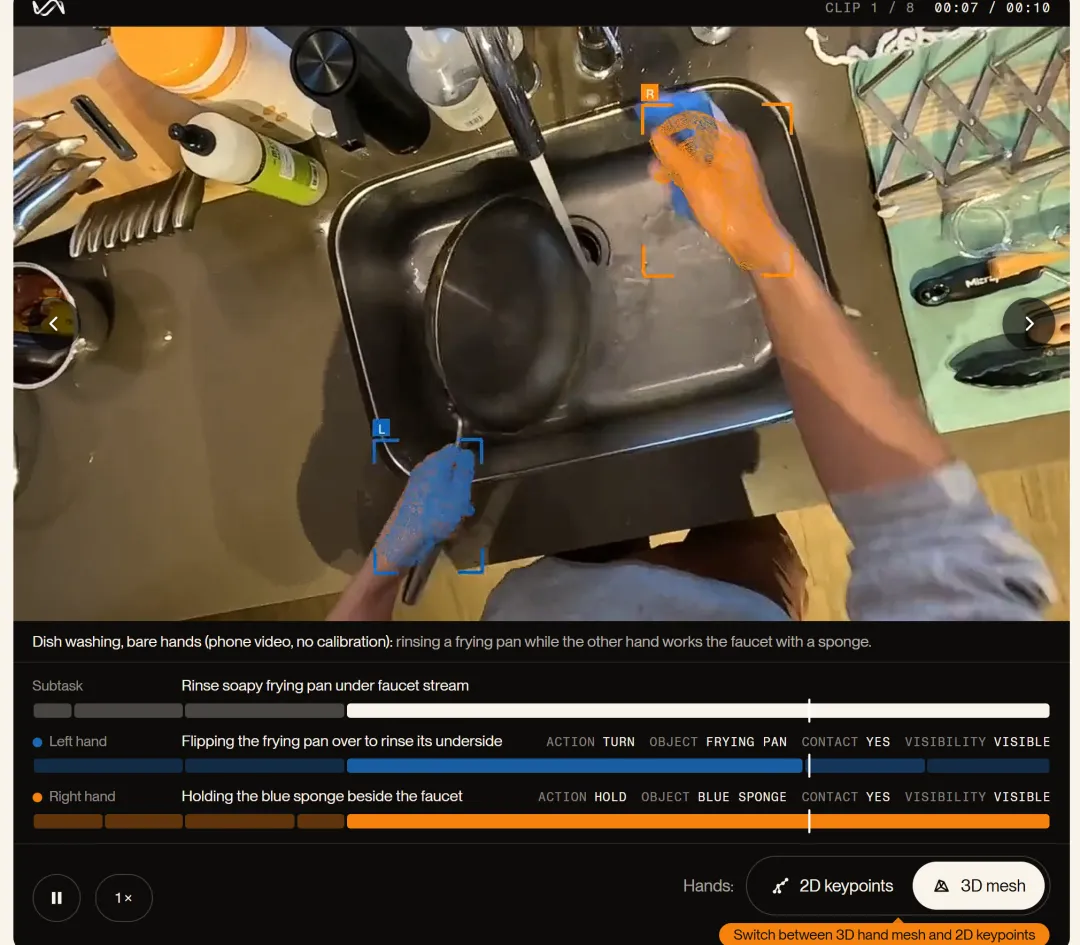
洗碗,徒手操作(手机拍摄,未经标定):冲洗平底锅,同时另一只手拿着海绵操作水龙头。
子任务
在水龙头的水流下冲洗蓝色海绵。
左手
握住平底锅的手柄,使其在水槽中保持稳定。
| 字段 | 标注 |
|---|---|
| 动作 | 握持 |
| 物体 | 平底锅手柄 |
| 接触 | 是 |
| 可见性 | 可见 |
右手
在水龙头的水流下冲洗蓝色海绵。
| 字段 | 标注 |
|---|---|
| 动作 | 清洗 |
| 物体 | 蓝色海绵 |
| 接触 | 是 |
| 可见性 | 可见 |
1 倍速
手部:
2D 关键点
3D 网格
在 3D 手部网格与 2D 关键点之间切换。
探索 Perceptron Egocentric 在家务、机器人和制造业视频上的输出:选择一个片段并播放,点击任意步骤即可跳转到对应时刻,还可以在 2D 关键点与 3D 手部网格之间切换。机器人片段来自 Galaxea Open-World 数据集;制造业片段来自 Build AI 的 Egocentric-10K。
尽管第一视角视频理解近期取得了进展,大规模、高质量的标注仍然困难。Perceptron Egocentric 弥补了三方面的不足:
以低廉成本提供子任务标签。 GPT-6 Astra 等前沿模型能够生成高质量的子任务标注,但在大型数据集上运行的成本过高。标准基准无法评估不足一秒的片段。在 EgoHome 上,我们与 GPT-6 Astra 的得分差距小于 0.01,成本仅为其八分之一,每小时视频分别为 9 美元和 76 美元。我们还在 WGO-Bench 上取得了已报告结果中最高的片段 F1。
按手分别提供结构化标注。 很少有 pipeline 能够同时提供每只手的连续活动标签、一致的动作分类体系、精确的 2D 关键点和 3D 手部重建。我们提供上述全部功能,其中包括一个新的 3D 手部重建模型,其手部形状精度在 HOT3D 和 ARCTIC 上达到最先进水平。
简单、自助式的接入。 开源工具将计算、扩展和部署工作留给你的工程师,而托管服务提供商通常需要定制化合作。通过我们的 API,你可以提交视频、跟踪作业并下载结构化标注,价格透明,无需人工协助开通。
这些能力共同构成了相较于我们 7 月抢先体验版本的一次重大升级。在 API 背后,我们定制的第一视角标注框架整合了用于子任务分割、单手活动标注以及 2D/3D 手部跟踪的专用模型,以经济高效的方式大规模提供高质量标注。
以低廉成本标注子任务
在第一视角视频中,抓取、释放或转动物体可能只需要不到一秒。以整秒为时间分辨率的标注会将这些动作混在一起,使机器人更难学习每个步骤的时序。Perceptron Egocentric 将每段视频分割为带时间戳的子任务,其中也包括这些短时动作。
以八分之一的成本提供前沿水平的时间线
在默认的 4 fps 设置下,Perceptron Egocentric 在 EgoHome 上取得 0.787 的得分。EgoHome 是我们新推出的亚秒级家务步骤基准,下文将进一步介绍。该得分与同样采用 4 fps 的 GPT-6 Astra(0.797)相差不到 0.010,而每小时视频的费用分别为 9 美元和约 76 美元。在 8 fps 下,得分达到 0.798,与 GPT-6 Astra 持平,费用估计为 15 美元。两种设置均超过 NVIDIA 的 FLORA(0.747)。
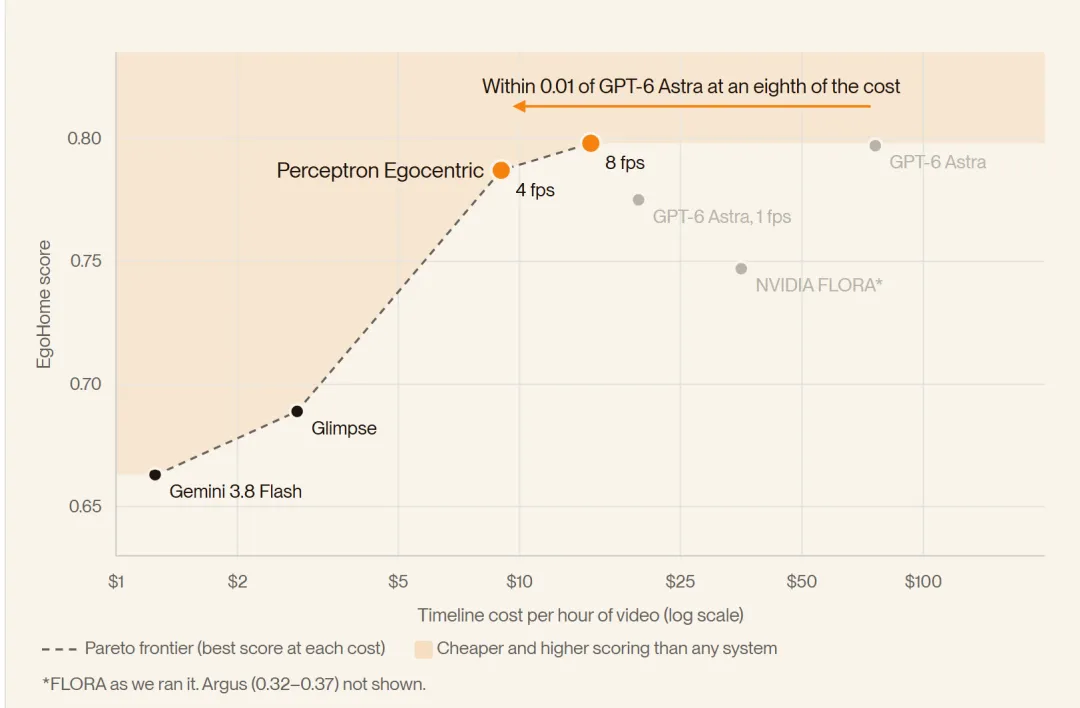
图 1: EgoHome 标注质量与每小时视频成本的关系,成本采用对数刻度。虚线表示 Pareto 前沿,即不存在其他系统能够同时在得分和成本上超越的系统;其左上方的橙色区域代表更低成本和更高得分,我们测量的系统均未进入该区域。Perceptron Egocentric 的两种设置均位于前沿上。Pantheon Argus 的得分为 0.32–0.37,低于图表范围,因此未展示。
在公开的 WGO-Bench 基准上,Perceptron Egocentric 取得了最高的片段 F1(0.583)和第二高的语义 F1(0.474)。前者衡量片段的时间定位,后者同时衡量时间定位和标签。
表 1: WGO-Bench,100 段视频,数值越高越好。语义 F1 仅在步骤的时间定位和标签均匹配时将其计为正确;片段 F1 仅检查时间定位。两者均采用汇总计算:先统计全部 100 段视频中的匹配,再计算 F1,而非对每段视频的 F1 求平均,以与其他团队报告 WGO-Bench 结果的方式保持一致。最佳结果以粗体标出。
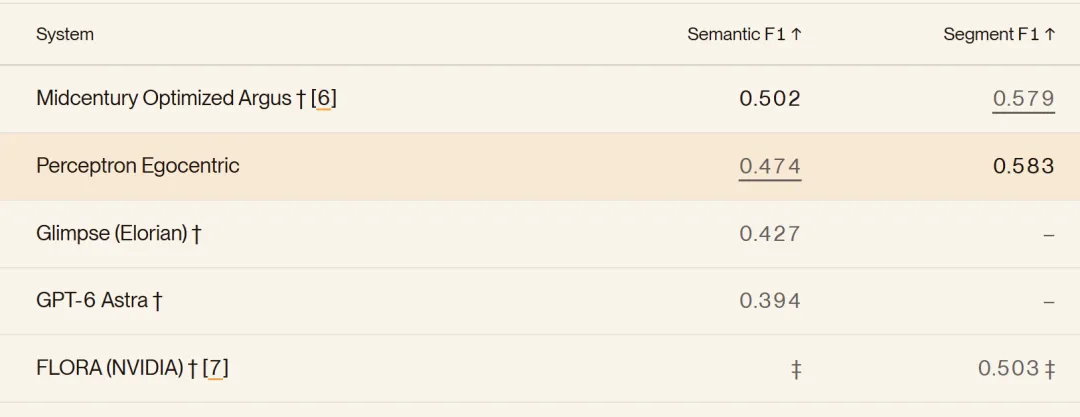
† 由相关团队自行报告,我们未复现。
‡ FLORA 使用其自己的评估协议报告 WGO-Bench 结果,因此不能直接比较:我们省略了其语义 F1,仅展示其报告的片段 F1。
捕捉不足一秒的步骤
WGO-Bench 没有短于一秒的参考片段,因此无法判断是否捕捉到了短时动作。为衡量这一点,我们构建了 EgoHome,这是一个新基准,包含 137 段经过人工核验的片段,覆盖约两小时的第一视角家务视频。其中 24 段至少包含一个短于半秒的步骤。
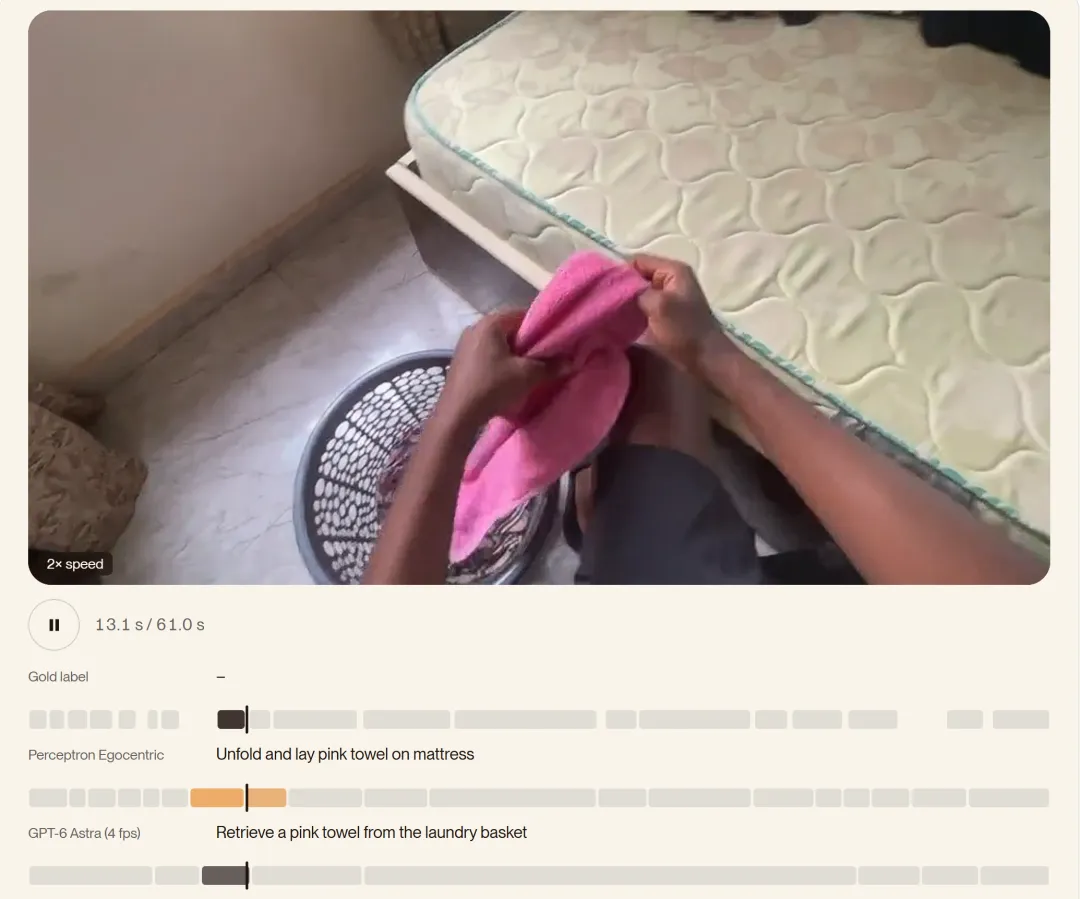
图 2: EgoHome 中一段叠衣视频的子任务时间线,以两倍速播放:参考标签(真值)、默认设置下的 Perceptron Egocentric,以及每秒 4 帧的 GPT-6 Astra。真值和 Perceptron Egocentric 均将片段划分为 19 个步骤;GPT-6 Astra 返回 8 个步骤,将 30 秒的叠毛巾过程标注为一个步骤。在这个片段上,Perceptron Egocentric 得分为 0.77,GPT-6 Astra 为 0.59;在整个 EgoHome 上,两者得分大致相同,见表 2。完整视频。
我们还提出了一项新指标,称为允许子片段匹配的 Jaccard 指标(permissible subsegment Jaccard),用于考虑标注粒度的差异。同一段 45 秒的过程可以被标注为“洗碗”,也可以被拆分为“刷洗”“冲洗”和“擦干”;两种标注都有效。该指标不会惩罚其中任何一种,而是使用 LLM 评判器判断粗粒度和细粒度描述是否涵盖相同活动,然后衡量预测时间线与参考时间线的一致性。我们将在未来几天发布 EgoHome,以及该指标的详细说明和代码。
表 2: 全部 137 个片段上的 EgoHome 结果。子任务得分越高越好,表示预测步骤与参考步骤一致的视频时间占比,使用 permissible subsegment Jaccard 衡量;表中展示总体结果,以及按参考步骤时长划分的结果。成本为每小时视频的费用,越低越好。最佳结果以粗体标出,次优结果以下划线标出。
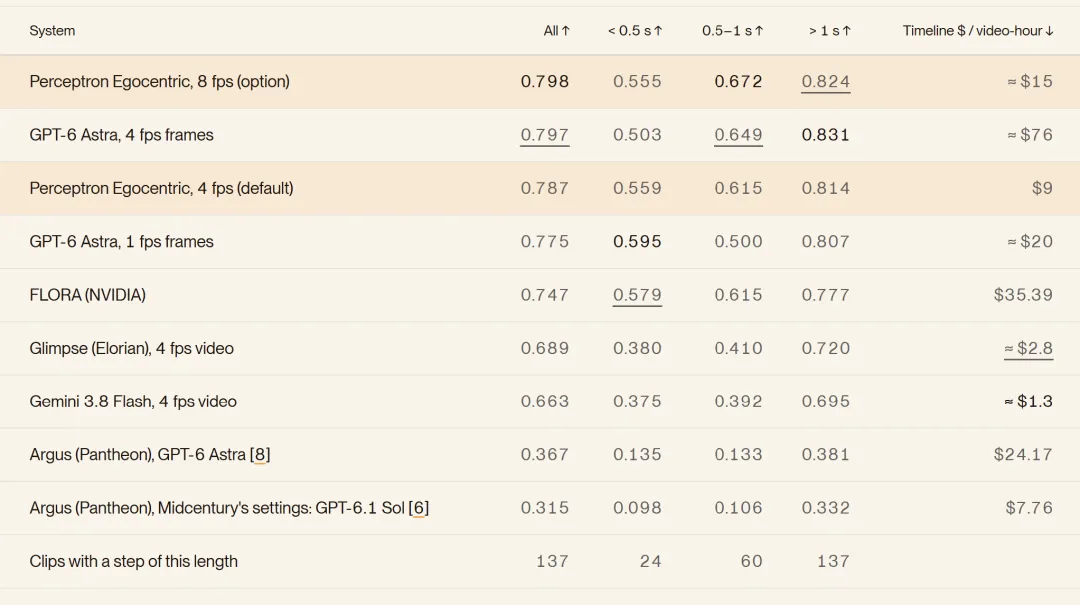
所有系统均使用同一个评分器,在全部 137 个片段上评分。Perceptron 的结果在 4 fps 下取三次运行的平均值,在 8 fps 下取两次运行的平均值;其他系统均运行一次。GPT-6 Astra 接收带时间戳的图像帧;Gemini 和 Glimpse 接收原生视频。Argus 的标签描述物体状态,例如“马克杯已放入上层碗架”,而非动作,EgoHome 的评判器会将这些标签计为不匹配。
成本指各系统为一小时视频生成时间线的费用:Perceptron 使用面向客户的价格,GPT-6 Astra、Gemini 和 Glimpse 使用 API 费用,FLORA 使用 GPU 运行费用。Argus 的成本还包括手部标签。标有 ≈ 的成本为估计值。GPT-6 Astra、Gemini 和 Glimpse 将所有任务合并计费,因此我们仅计入时间线对应的份额:视频作为输入处理一次的费用,加上时间线输出的费用。对于 8 fps,我们按照模型开销增至 1.7 倍的比例,对 9 美元的价格进行了相应放大。
对于不足半秒的步骤,1 fps 的 GPT-6 Astra(0.595)和 FLORA(0.579)得分略高于我们(0.559);对于半秒到一秒的步骤,我们的 8 fps 设置得分最高,为 0.672。
每只手的 3D 跟踪与活动标注
Perceptron Egocentric 分别处理每只手:对双手进行 3D 重建,并标注每只手随时间进行的活动。
对手部进行 3D 重建,可以将人类示范转化为机器人操作的监督信号。EgoMimic 等近期工作表明,使用配有 3D 手部跟踪的第一视角视频共同训练操作策略,可以提升长时程单臂和双臂任务的表现。VideoDex 从互联网视频中挖掘数据,将估计的 3D 手部运动重定向到机器人灵巧手,作为策略学习的先验。
最先进的手部形状重建,无需标定
Perceptron Egocentric 直接从第一视角视频中重建 3D 手部。我们的模型基于 Mk1.5 构建,估计每只手的 3D 形状、手指关节构型,以及相对于相机的位置。在全部四种设置下,其手部形状重建精度均比表 3 中最强的既有方法 ACE-Ego-Hand 高出 12%–25%,且无需相机标定:无论是否提供标定信息,其在 HOT3D 上的手部形状误差均为 5.21 毫米。
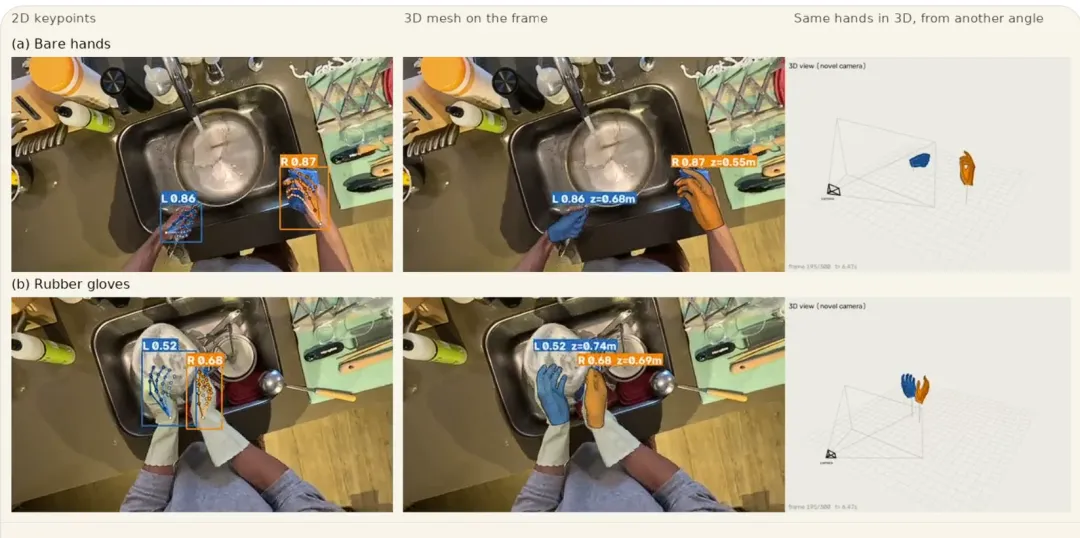
图 3: 两段使用手机拍摄、未经相机标定的第一视角洗碗视频上的手部跟踪:(a)徒手;(b)佩戴橡胶手套。每只手都有独立的 3D 网格,并标注左右手、检测置信度及其与相机的距离。每行左侧为 2D 关键点;右侧为叠加在视频帧上的 3D 网格,以及从另一个角度观察到的同一双手。完整的 10 秒视频:徒手 2D、徒手 3D、橡胶手套 2D、橡胶手套 3D。
表 3: 在 HOT3D 和 ARCTIC 上测量手部形状与姿态精度。这两个标准基准均包含展示手部操作物体的第一视角视频。误差以毫米为单位,越低越好。手部形状指标 PA-MPJPE 对平移、旋转和尺度进行对齐,以单独衡量手指关节构型误差。手部姿态指标,即腕部对齐的 MPJPE,仅对齐手腕位置,因此会惩罚整体朝向和尺度误差。“已标定”表示向模型提供相机参数,例如焦距和图像中心;“未标定”表示模型必须估计这些参数,我们的 API 会自动完成这一过程。最佳结果以粗体标出,次优结果以下划线标出。
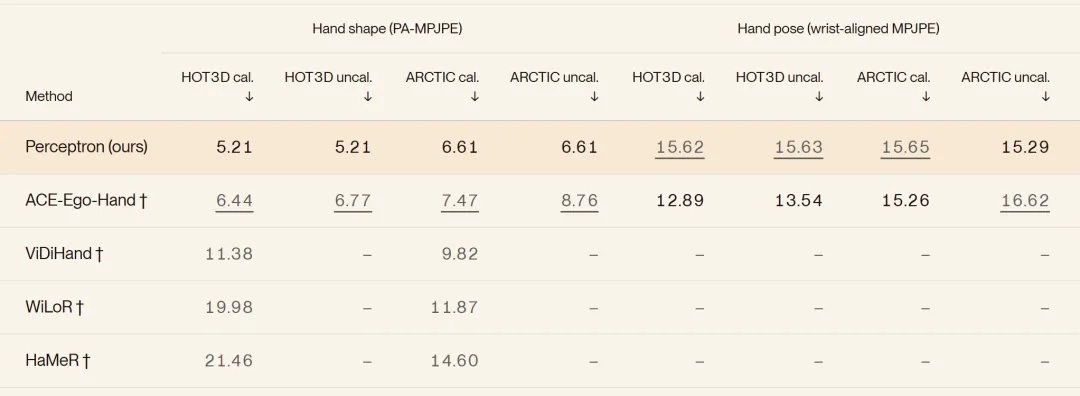
† 数据来自 ACE-Ego-Hand 论文的表 1,我们未复现。该论文仅报告了 HaMeR、WiLoR 和 ViDiHand 在已标定设置下的手部形状结果。其片段列表尚未公开,因此我们使用的片段与其不同。
每只手都有独立的活动时间线
每只手还会获得自己的活动标签:每只手各有一条独立时间线,以简短描述说明该手在每个步骤中进行的活动。机器人夹爪也采用相同方式,每个夹爪各有一条时间线。在图 4 中,人的左手握住平底锅并将其倾斜到水流下,右手则打开水龙头并冲洗海绵,两只手分别获得各自的标签。对于双臂机器人,左夹爪将一个杯子和一个泵头瓶移入一个篮子,右夹爪则将一个桃子移入另一个篮子。
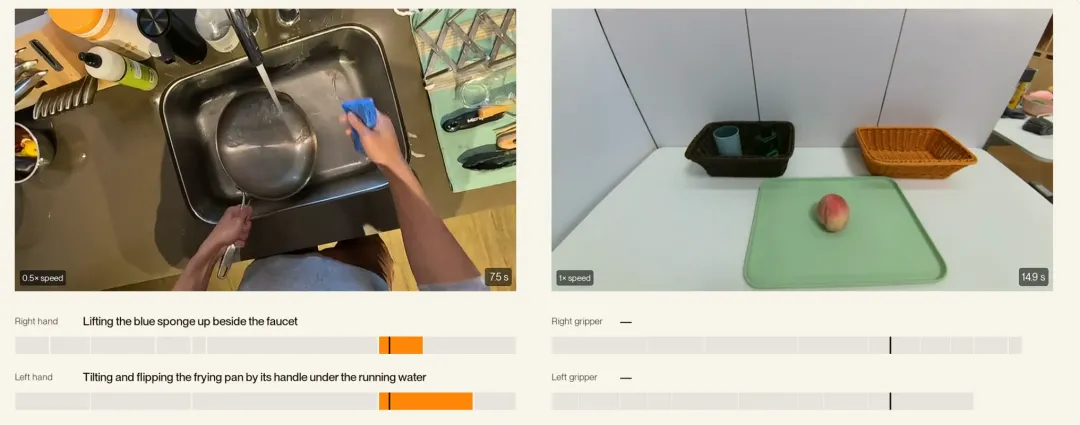
图 4: Perceptron Egocentric 生成的单手活动标签:(a)图 3 中的徒手洗碗片段,以半速播放;(b)双臂 Galaxea 机器人将物体分拣到篮子中的片段,以正常速度播放。每只手或每个夹爪都有自己的时间线;橙色步骤表示当前正在发生的步骤,其标签显示在时间条上方。短横线表示该手或夹爪不在视野内。标签为未经编辑的模型输出。完整视频。
即刻开始标注
Perceptron Egocentric 开箱即用,提供子任务分割、单手活动标签以及 2D/3D 手部跟踪。它以异步批处理 API 的形式运行。你可以在一个请求中发送最多 1,000 个视频链接,选择所需输出,然后轮询每个作业,并在完成后下载结果。每个作业均包含子任务片段;2D 或 3D 手部跟踪以及单手活动标签是按批次选择的附加功能。Perceptron 控制台列出每个批次和作业的状态、已处理的视频小时数和扣除的额度,并在旁边显示你的冻结余额和可用余额。
Perceptron 控制台中一个已完成的批次:240 个作业、172.8 个计费视频小时、按输出类型划分的费用明细,以及作业列表。
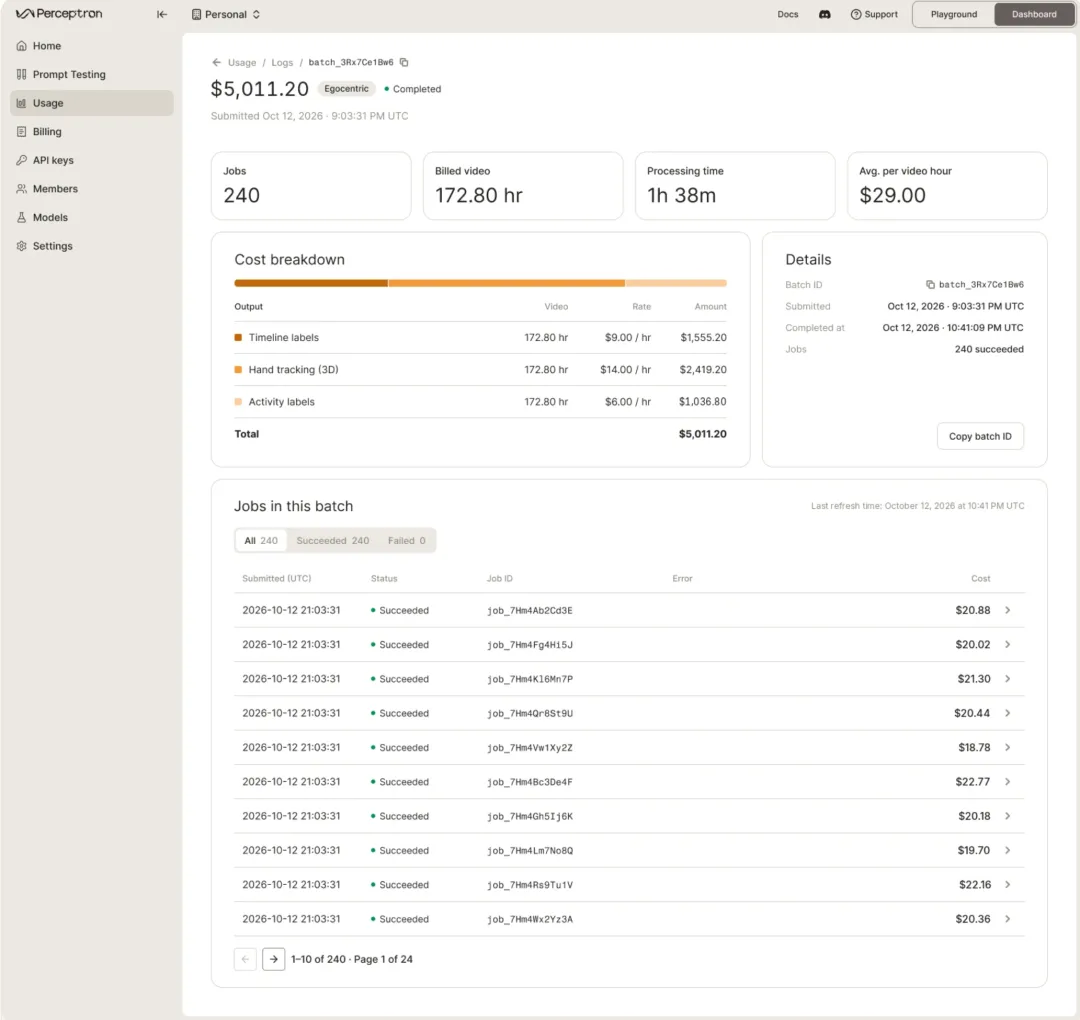
图 5: Perceptron 控制台中的一个批次,展示按输出类型划分的标注费用,包括子任务时间线、3D 手部跟踪和活动标签,以及每个作业的状态和费用。
该 API 提供七个端点:
提交批次(Submit Batch):
POST /v1/egocentric/batches——在一个请求中发送最多 1,000 个视频链接,并附带幂等键;整个批次会被整体接受或拒绝。列出批次(List Batches):
GET /v1/egocentric/batches——分页浏览你所在组织的批次。获取批次(Retrieve Batch):
GET /v1/egocentric/batches/{batch_id}——获取批次的状态和时间信息。列出批次作业(List Batch Jobs):
GET /v1/egocentric/batches/{batch_id}/jobs——按输入顺序列出批次中的作业。列出作业(List Jobs):
GET /v1/egocentric/jobs——按创建顺序列出你所在组织的全部作业。获取作业(Retrieve Job):
GET /v1/egocentric/jobs/{job_id}——获取作业的状态、输入元数据、错误和执行时间信息。获取作业结果(Retrieve Job Result):
GET /v1/egocentric/jobs/{job_id}/result——作业成功后,下载其 JSON 格式的结果。
有关身份验证、限制和错误处理,请参阅第一视角功能指南。
使用 POST /v1/egocentric/batches 提交视频:
curl  \
  -H "Authorization: Bearer $PERCEPTRON_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $(uuidgen)" \
  -d '{
    "inputs": [
      {
        "type": "video_url",
        "video_url": { "url": " }
      }
    ],
    "hand_tracking": { "output": "3d" },
    "hand_activity": true
  }'
使用 GET /v1/egocentric/jobs/{job_id} 检查作业状态:
curl  \
  -H "Authorization: Bearer $PERCEPTRON_API_KEY"
使用 GET /v1/egocentric/jobs/{job_id}/result 下载结果:
curl  \
  -H "Authorization: Bearer $PERCEPTRON_API_KEY" \
  -o result.json
输出: 始终包含子任务时间线。2D 或 3D 手部跟踪和单手活动标签为可选附加功能,按批次选择。
按输出类型,以每小时视频为单位计费:
Egocentric 各类输出的每小时视频标准价格
评估说明
手部姿态: 我们遵循 ACE-Ego-Hand 的评估协议,在 HOT3D 的参与者 P0001 数据上使用 244 个片段,在 ARCTIC 的受试者 s05 数据上使用 302 个片段。所有模型和评估设置均在独立验证数据上确定,随后仅进行一次测试评估。
EgoHome: 我们使用 Gemini 3.5 Flash 作为评判器。表 2 中的所有系统均在同一轮评估中评分,并缓存每一对标签的评判结果,以确保评分一致。Perceptron 的各项设置运行了两次或三次;竞争系统均运行一次。在 EgoHome 上评估的模型,其训练数据不包含 EgoHome 片段。
WGO-Bench: 我们遵循该基准公开的评估规则。在将外部边界与参考边界对齐之后,如果预测步骤与参考步骤的时间交并比满足 ,则视为匹配。语义 F1 还要求由 Gemini 3.5 Flash 评判器验证预测标签是否与任务指令匹配。F1 在全部 100 段视频上汇总计算,而非对每段视频的 F1 求平均;后者会使得分虚高 0.14–0.19。
自行报告的结果: 标记为自行报告的得分来自外部来源,未经独立复现。
引用
@article{perceptron2026egocentric,
  author = {PerceptronAI},
  title = {Introducing Perceptron Egocentric 1.0},
  journal = {PerceptronAI Research Blog},
  year = {2026},
  note = {
}
参考文献
T. Jiang, T. Yuan, Y. Liu 等。Galaxea Open-World Dataset and G0 Dual-System VLA Model。2025 年。arXiv:2509.00576。
Build AI。Egocentric-10K。Hugging Face 数据集。huggingface.co/datasets/builddotai/Egocentric-10K。
Macrodata Labs。Segmenting Robot Video into Actionable Subtasks (WGO-Bench)。2026 年 6 月。macrodata.co/blog/annotating-robot-video-subtasks。
P. Banerjee, S. Shkodrani, P. Moulon 等。HOT3D: Hand and Object Tracking in 3D from Egocentric Multi-View Videos。CVPR 2025。arXiv:2411.19167。
Z. Fan, O. Taheri, D. Tzionas 等。ARCTIC: A Dataset for Dexterous Bimanual Hand-Object Manipulation。2022 年。arXiv:2204.13662。
Midcentury。Optimizing Argus for Action Labelling。2026 年 10 月。midcentury.xyz/blog/optimizing-argus。
S. Leng, Y. Man, Z. Li 等。FLORA: An Open Model Suite for Scaling Robotics Data Engines。2026 年。arXiv:2610.31779。
Pantheon Industries。Argus: an open source harness for annotating robot learning data。GitHub 仓库。github.com/Pantheon-Industries-Inc/argus。
S. Kareer, D. Patel, R. Punamiya 等。EgoMimic: Scaling Imitation Learning via Egocentric Video。2024 年。arXiv:2410.24221。
K. Shaw, S. Bahl, D. Pathak。VideoDex: Learning Dexterity from Internet Videos。CoRL 2022。arXiv:2212.04498。
Y. Liu, X. Wang, H. Li 等。ACE-Ego-Hand: Repurposing Video Diffusion Models for Occlusion-Robust Egocentric 3D Hand Motion Recovery。2026 年。arXiv:2608.20308。
G. Pavlakos, D. Shan, I. Radosavovic 等。Reconstructing Hands in 3D with Transformers (HaMeR)。CVPR 2024。arXiv:2312.05251。
R. A. Potamias, J. Zhang, J. Deng 等。WiLoR: End-to-end 3D Hand Localization and Reconstruction in-the-wild。CVPR 2025。arXiv:2409.12259。
Y. Wang, C. Jin, Y. Liu 等。The Surprising Effectiveness of Video Diffusion Models for Hand Motion Reconstruction (ViDiHand)。2026 年。arXiv:2606.30308。
来源:human five