
前几节中,我们学习了如何训练 Flow Matching 或扩散模型来从分布 中采样。这套配方是通用的,可以应用于多种不同的数据类型和应用。
本节中,我们深入考察大规模图像和视频生成的特定情形,包括 FLUX 2.0、Stable Diffusion 3、Nano Banana 和 VEO-3 或 Meta Movie Gen Video 等知名模型。
最后,我们将在实验课中应用所学,从零构建我们自己的版本。本节大致结构如下:
神经网络架构:我们首先讨论如何把原始输入(包括时间 和引导变量 ,即离散类标签或原始文本)转换(嵌入)为 自身可处理的向量形式。然后讨论 的流行架构选择,包括 U-Net 和 diffusion transformer。
隐空间:我们讨论变分自编码器,它允许在低维隐空间中进行生成式建模,从而实现超高分辨率图像生成。
案例研究:最后,我们深入考察前面提到的两个最先进的图像和视频模型——Stable Diffusion 3 与 Meta MovieGen——让你一窥大规模生产的实现方式。
6.1 神经网络架构
让我们首先把注意力转向面向图像类模态(如图像和视频)的可扩展神经网络架构设计。
具体地,我们将探索如何在实践中实现(引导)向量场 ,其参数为 。注意神经网络必须有 3 个输入:一个向量 、一个条件变量 、一个时间值 ,以及一个输出 。
对于低维分布(例如前几节中见过的玩具分布),用一个多层感知机(MLP,即全连接网络)参数化 就足够了。
也就是说,在这个简单设定中,前向传播就是把输入 拼接后送入 MLP。
然而,对于复杂的高维分布,如图像、视频和蛋白质,MLP 很可能不够。因此,通常会使用特定于应用的架构。
本节余下部分,我们考虑图像的情形(并推广到视频)。
首先,我们考虑原始条件信息——时间 和条件变量 ——如何被嵌入为模型可处理的向量值形式。其次,我们讨论这种模型的两种常见架构选择:U-Net 和 diffusion transformer(DiT)。
6.1.1 嵌入条件变量
嵌入时间。对于简单玩具模型,把 的原始值拼接到输入上就足以训练一个表现合理的网络。实践中,标量时间常通过 Fourier 特征嵌入到更高维空间,使模型能更忠实地捕捉高频时间依赖。显式地,特征化为
其中频率 按下式设置:
这种 TimeEmb 的选择是标准做法,但这个精确形式并非严格必要。上面只是获得一个维度为 的归一化嵌入的便捷方式,即 (因为 )。
嵌入类别标签。当 只是类标签时,通常最简单的做法是直接为 的 个可能值各学习一个嵌入向量,并把 设置为该嵌入向量。我们会希望这些嵌入的参数被包含在 的参数 中,并在训练中学习它们。
嵌入文本输入。当 是文本提示时,情况更复杂,方法主要依赖冻结的预训练模型。这种模型经过训练,能把离散文本输入映射为一个捕捉相关信息的连续向量。一种这样的模型是 CLIP(Contrastive Language-Image Pre-training)。
CLIP 被训练来在图像和文本提示之间学习一个共享嵌入空间,训练损失旨在使图像嵌入与其对应提示的嵌入靠近,同时与其他图像和提示的嵌入远离。我们可以取 作为由冻结预训练 CLIP 模型产生的嵌入。
在某些情况下,把整个序列压缩成单个表示可能不可取。在这种情况下,可以额外使用预训练 transformer 对提示进行嵌入,以获得嵌入序列。也常见于条件化时组合多个这种预训练嵌入,以同时利用每个模型的优势。对我们的目的,可以简单假设应用提示嵌入后形状为
6.1.2 Diffusion Transformer
在深入这些架构的细节之前,让我们回顾一下引言中关于图像的说明:图像本质上是一个向量 。这里 表示通道数(RGB 图像通常有 个颜色通道), 和 分别表示图像高度和宽度(以像素为单位)。特别突出的架构类是 diffusion transformer(DiT) 及其变体,它们使用注意力机制来构建网络。diffusion transformer 有不同流派。这里我们解释一种通用设计,并注意特定实现可能因模型和应用而异。
本节余下部分,我们用 表示隐藏维度, 表示 transformer 层数, 表示每层的头数。
diffusion transformer 基于 vision transformer(ViT),其主要思想本质上是把一幅图像切分为 patches、嵌入这些 patch 以得到一个 token 序列,然后通过标准注意力处理得到的 token。最后在末尾施加一个反 patchify 操作,以恢复正确形状的图像。初始 patchify 操作只是把图像张量 重排为:
其中 ,, 是 patch 大小。接下来,我们对输出施加一个线性变换,得到最终的 patch 嵌入:
其中 是可学习权重矩阵。diffusion transformer 的输入然后是时间嵌入、提示嵌入和 patch 化图像张量(见 6.1.1 节):
注意所有元素现在都具有 transformer 所需的隐藏维度。diffusion transformer 然后通过 DiTBlock 中的 transformer 层()迭代更新 (细节见备注 29):
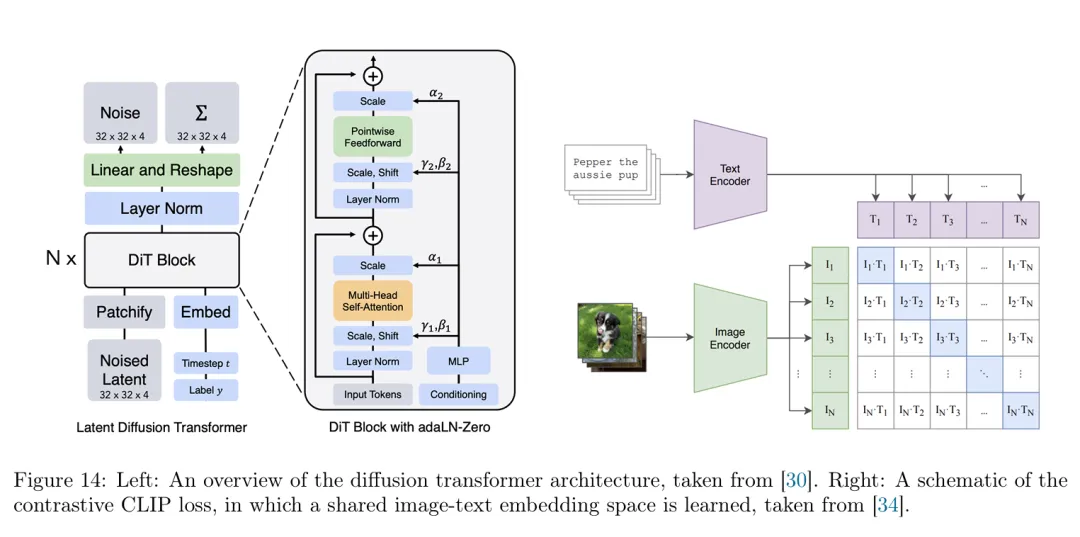
图 14:左:diffusion transformer 架构概览。右:共享图像-文本嵌入空间中对比 CLIP loss 的示意图。
其中 是层数。最后,一个最终操作施加反 patchify 操作,把 DiT 输出映射回期望的输出形状:
其中 。最终张量 然后作为模型的输出和预测速度 。
备注 29(DiT Block)
为完整起见,我们简要给出单个 DiT 层的数学描述。虽然我们试图包含足够细节以理解 DiT 模型族,但读者应注意,DiT 模型族强调算法选择而非架构细节。
令 表示 patch token 的当前序列(这里 ), 表示嵌入的引导变量(这里 )。然后一个典型的 DiT block 用 (i) patch 上的自注意力、(ii) 对提示的交叉注意力,以及 (iii) 通过自适应归一化(AdaLN)的时间条件来更新 。
缩放点积注意力。给定查询 、键 、值 ,
其中 softmax 按行施加。
多头注意力。令 表示头数, 表示每头维度。对每个头 ,学习投影矩阵 。定义
其中源序列 要么是
拼接各头并施加输出投影 :
通过自适应归一化进行时间条件化。令 为时间步嵌入。DiT 中的一个标准选择是用 产生逐通道缩放/偏移参数,以调制归一化激活。具体地,令 为一个 MLP,并设
其中 (或取决于实现,是不同子层(如注意力和 MLP)的 对)。给定 token 矩阵 和一个归一化算子 (如 LayerNorm),定义调制归一化
其中 表示在 token 维度上按广播的逐元素乘法。
整合在一起。组合操作(即 DiTBlock)为
其中 MLP 是逐位置前馈网络, 是可学习门控参数。输出 成为 patch-token 序列中的下一个(我们的记号中 )。最后,我们注意到,像实验课中实现的那种类条件 DiT 通常更简单,它倾向于用时间和类基 AdaNorm 条件化来代替交叉注意力层。
6.1.3 U-Net
U-Net 架构是 DiT 架构的一种替代,是一种特定类型的卷积神经网络。最初为图像分割设计,其关键特点是输入和输出都具有图像形状(可能通道数不同)。这使得它非常适合参数化向量场 ,因为固定 时其输入形状是图像,输出形状也是图像。因此,U-Net 在扩散模型早期文献中被广泛使用。
U-Net 由一系列编码器 和相应的一系列解码器 组成,中间有一个我们称为 midcoder 的隐处理块。为方便说明,让我们走一遍图像 (我们取 )经过 U-Net 的路径:
注意,当我们把图像经过编码器时,通道数增加,而图像的高度和宽度减小。编码器和解码器通常由一系列卷积层(带激活函数、池化操作等)组成。
上面未显示的两点:第一,输入 常被送入一个初始预编码块,以在送入第一个编码器块之前增加通道数。第二,编码器和解码器之间通常通过残差连接连接。
高层来看,大多数 U-Net 都涉及上述描述的某种变体。然而,某些设计选择在实践中可能因实现而异。特别地,纯卷积架构中常见的是在整个编码器和解码器中都加入注意力层。U-Net 因其"U"形堆栈而得名(见图 15)。
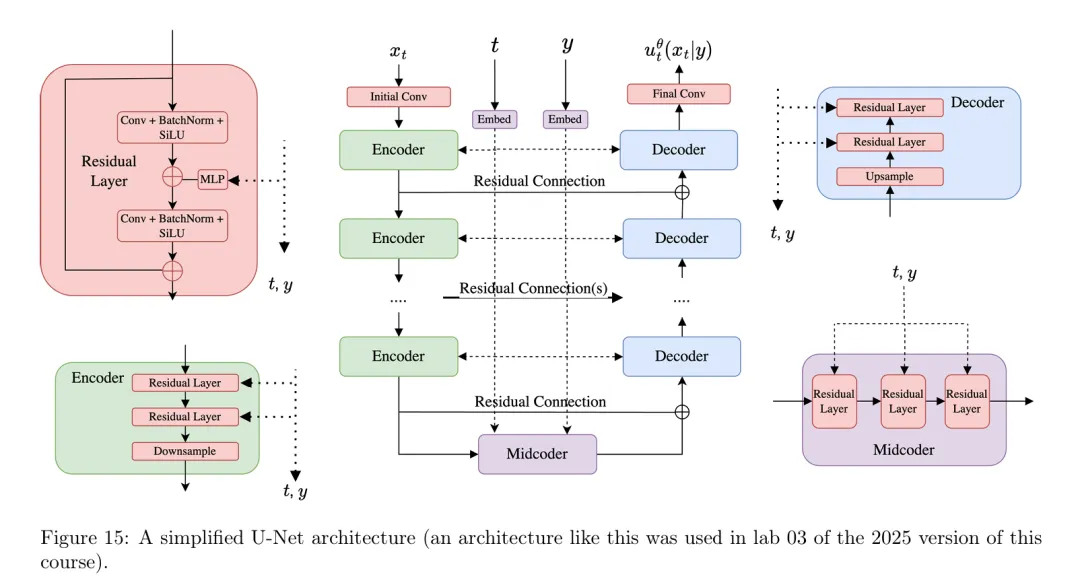
图 15:一个简化的 U-Net 架构(2025 版本课程的实验课 03 中使用了类似架构)。
6.2 在隐空间中工作:变分自编码器
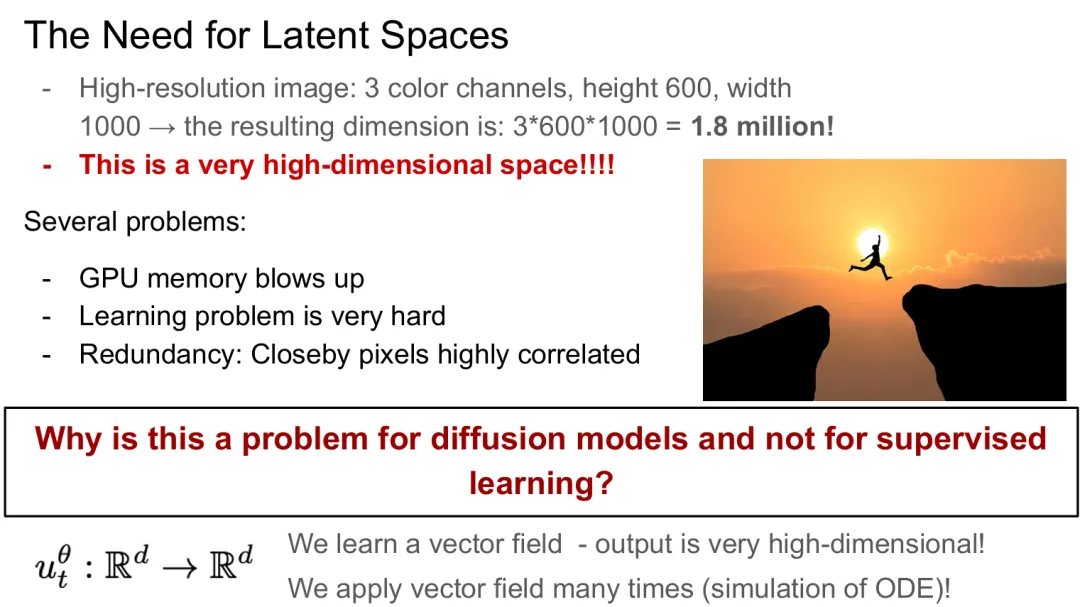
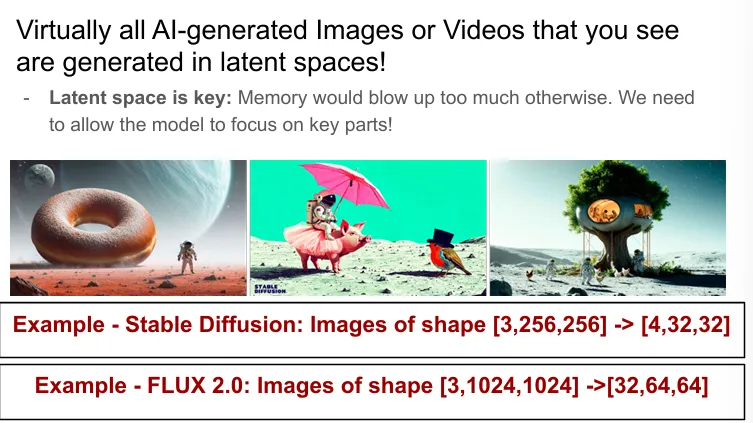
到目前为止,我们一直在数据空间 中操作。然而,当我们把这种空间中的建模扩展到越来越高分辨率的图像时,成本迅速变得高得离谱。
例如,一幅 1024×1024、3 个 RGB 颜色通道的图像对应总维度 。注意,随着视频中帧数 的增加,该维度会进一步增大。你可以想象,在这样的空间上训练很快变得不可行。
与图像分类不同,低维输出不允许缩小卷积堆栈,而我们的 flow 建模方法要求输出 与输入大小相同。
因此,重要的问题变成了:我们如何在合理的内存和计算预算内对高维图像建模?
6.2.1 标准自编码器
这个问题的一个自然答案是压缩:例如,实际图像空间位于高维图像空间中一个低维流形附近。更具体地,我们可以考虑一个编码器,以及一个解码器,它们一起把原始图像 映射为隐变量 (反之亦然)。维度 通常选得远小于 。
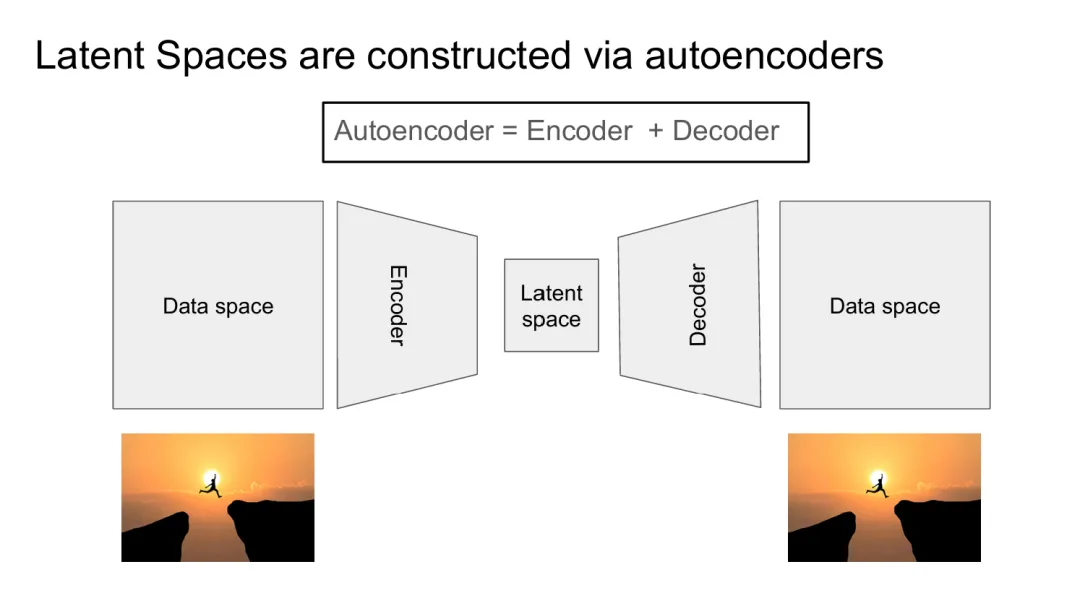
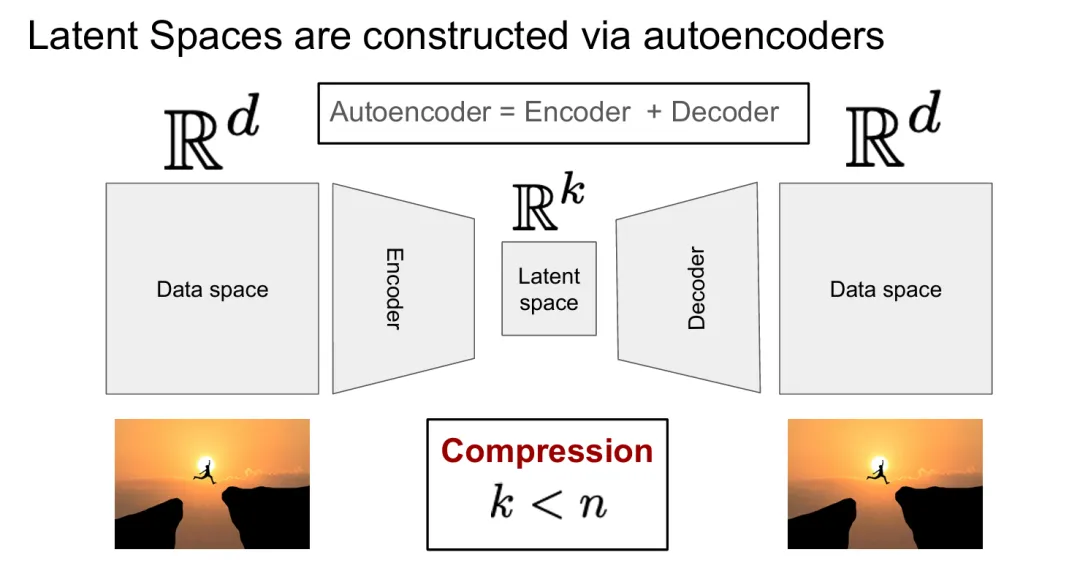
对于图像,例如 ,常见做法是下采样到例如 。 和 合称为自编码器。理想情况下, 和 被选择为在平均意义下达到高重建质量,使得 看起来像 。因此,自编码器通常用重建损失训练:
它衡量原始数据点 与重建结果 之间的平方误差。
对生成式建模的适用性。遗憾的是,仅有重建损失不足以训练一个"好"的自编码器。回顾我们的最终目标是在隐空间中训练一个生成模型,并瞄准由 、 给出的隐分布 。一个对 的生成模型通过把隐生成模型的输出通过解码器 来实现。
但是,正如我们目前构建的自编码器所带来的一个微妙问题是:我们几乎无法控制 ,因此不能保证 行为良好以至于适合训练一个生成模型(即漂亮、简单、类高斯)。
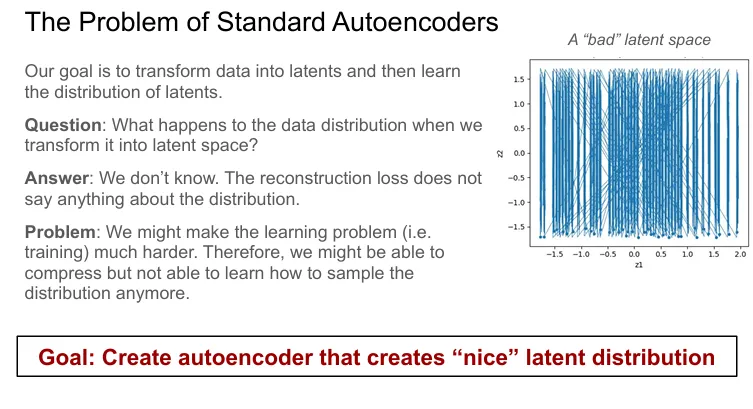
虽然我们把数据压缩到了隐空间中,但可能把数据分布 变换成了一个很难学习的分布 。
因此问题是:我们如何确保隐分布 行为良好且易于学习?为了允许对隐分布进行显式正则化——这将引出自编码器到更一般概率框架的概念——我们接下来引入变分自编码器。
6.2.2 变分自编码器
变分自编码器(VAE) 是通过放宽编码器和解码器是确定性函数这一约束,从(确定性)标准自编码器形式化得到的。
具体地,考虑一个带参数 的编码器 和一个带参数 的解码器 。最常见的选择是取
其中 、、、 作为神经网络参数化,diag 表示对角矩阵。要编码或解码一个变量,我们采样
最后注意,当 且 时,我们恢复标准自编码器。让我们考察重建损失的样子。一个自然的目标是:
注意两处变化:从确定性编码变为随机编码,我们现在采样 。此外,我们取 在解码下的负对数似然,即损失有效地问:给定所有可能的解码/编码,我们原始数据点 有多可能被编码然后解码回来?现在一切都是随机的。对高斯情形,该重建损失变为:
其中我们使用了正态分布(高斯)的密度(见方程 (97))。因此,VAE 重建损失与标准 AE 重建损失的不同之处在于,我们必须考虑所有可能编码 下的平均。
第二项(解码器方差)控制重建精度和预测不确定性之间的权衡。许多实现(包括实验课中的)取 和 为学习的标量常数(与 和 无关),从而避免学习方差时的病理行为和数值不稳定性。
因此,这种情形下的 VAE 重建损失基本上就是标准自编码器重建损失加上编码的随机性和常数:
现在让我们重新审视目标:我们想创建数据分布 的编码,使得映射到隐空间后分布变得"漂亮"且易于学习。
为此,我们现在对隐变量 引入一个先验分布。为了我们的目的,取 作为各向同性高斯。
这种先验分布的选择有效地代表了隐分布"理想"的样子。正态分布很容易学习,因此能满足获得"可训练"隐分布的目标。基本思想是正则化编码器,使编码数据分布尽可能接近 ,我们通过辅助损失来实现:
其中 是Kullback-Leibler(KL)散度。
KL 散度是衡量两个概率分布差异的基本方法。详细解释超出了本工作的范围,但我们在备注 30 中给出简要背景作为提醒。
方程 (75) 中定义的损失非常直观:我们希望编码后的分布看起来像高斯分布。如果我们对所有 都这样做,自然会期望我们的隐分布看起来也像高斯分布。
备注 30(KL 散度背景)
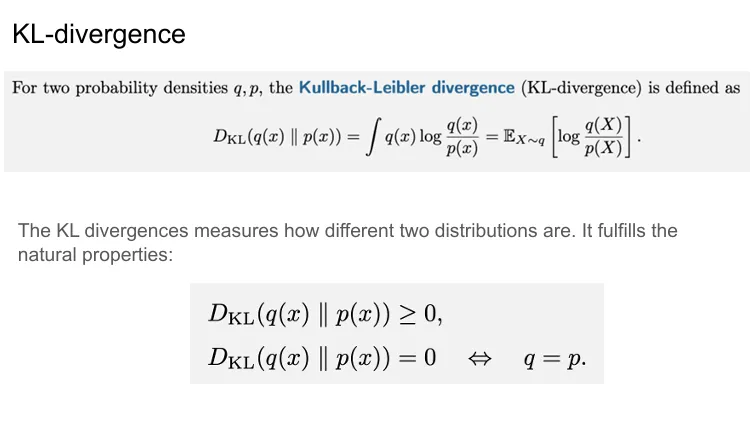
对两个概率密度 ,Kullback-Leibler 散度定义为
KL 散度是分布间不相似性的标准度量。特别地,KL 散度满足以下有用性质:
即它总是非负的,且当且仅当两个概率分布重合时为零。
要定义变分自编码器的损失函数,我们现在可以用参数权重 结合重建损失和先验损失,得到 VAE 训练目标:
其中第一项迫使隐变量可被高效解码回数据,第二项迫使我们的隐分布接近高斯。参数 控制每一项的强度。为使损失更具体,我们推导高斯情形下的 KL 散度:
例 31(各向同性高斯之间的 KL 散度)
设 , 为对角协方差矩阵的高斯,其中 ,。则
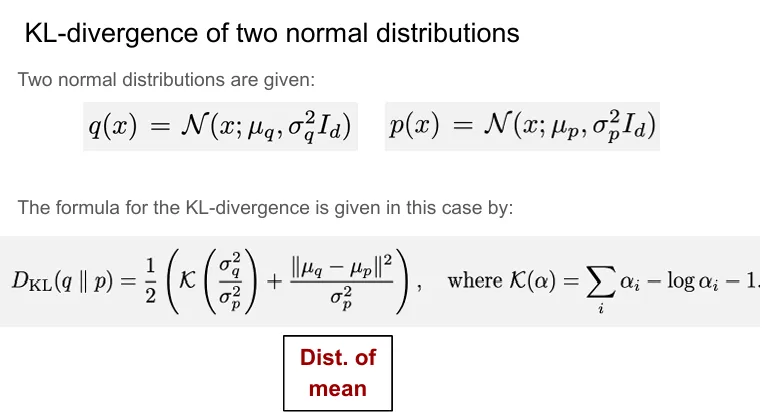
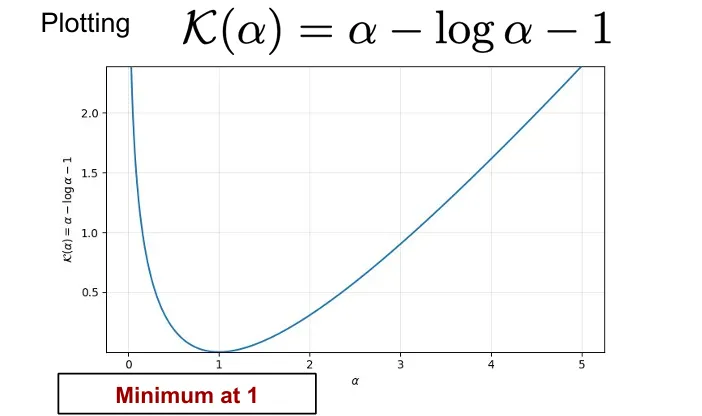
上面的表达式很直观。如果均值和方差重合,则 。此外,它随均值向量之间的平方误差 增大而增大。最后,函数 在 处有唯一最小值,因此当 时 最小。
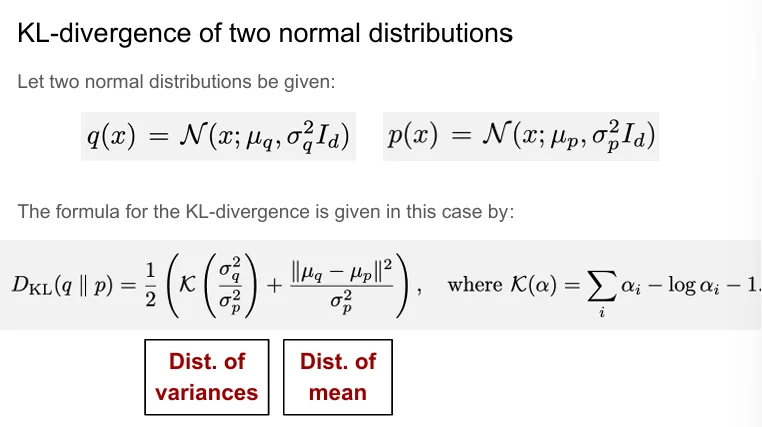
证明。我们对 证明( 的证明通过对每个维度求和类似)。给定正态分布的密度,我们知道(见方程 (97)):
则
对 有
结合 以及 ,我们得到
代入方程 (81) 即得 (80)。
现在假设编码器为高斯形状。于是:
这个损失很直观:均值 因偏离零而受惩罚,方差因偏离 1 而受惩罚。作为 VAE 的总损失,我们得到
上面损失函数的四项都非常直观。第一项只是重建误差。第二项描述解码器的不确定性:方差越小,解码器越"自信",但也更严厉地惩罚重建误差。此外,我们希望把均值方差设为 1,把均值设为 0——以强制隐空间中的分布接近高斯。
训练 VAE。剩下的问题是讨论如何最小化 VAE 损失 。问题在于到目前为止,分布 的期望( 本身依赖于参数 )。然而,我们可以应用所谓的重参数化技巧来重写它。具体地,对
我们可以通过以下方式采样:
注意这个方程中,唯一的噪声/随机性来源是 ,其分布与 无关。因此我们可以把损失重写为:
重参数化后,随机性仅来自 ,其分布不依赖于 。因此,我们现在可以用标准深度学习工具最小化损失。
为了进一步简化,我们可以处处设 为常数,再次得到:
算法 6 中我们总结了 VAE 的训练流程。
实践备注。我们上面开发的构造展示了自编码器设计的原理。当然,实践中人们可能会加入更多损失项或其他约束。因此,我们最后给出关于自编码器的实践备注:
选择 (以及 KL warm-up)。大 迫使隐状态更接近先验,但可能损害重建并触发后验坍缩(编码器忽略 ,输出 )。一种常见稳定化方法是 KL warm-up:从 开始,在前几个 epoch 内逐渐增加到目标值。然而,在所有现代自编码器中, 都非常小,即 。
解码器方差。学习高斯解码器方差 在数值上很微妙,除非正则化,否则可能导致退化解。为稳定起见,许多实现固定 为常数方差 ,这使得重建损失与均方误差成正比(常数项除外)。
超越像素 MSE 的重建损失。对图像,逐像素高斯似然(均方误差)常产生过于平滑的重建。实践中,人们使用感知损失(特征空间损失),用预训练网络来改善锐度和保真度。
对抗与混合目标。为进一步改善视觉真实感,可以用 adversarial loss(VAE-GAN 风格)结合 VAE 目标,在解码样本上使用判别器。这通常会锐化输出,但会引入额外的优化不稳定性和额外超参数。
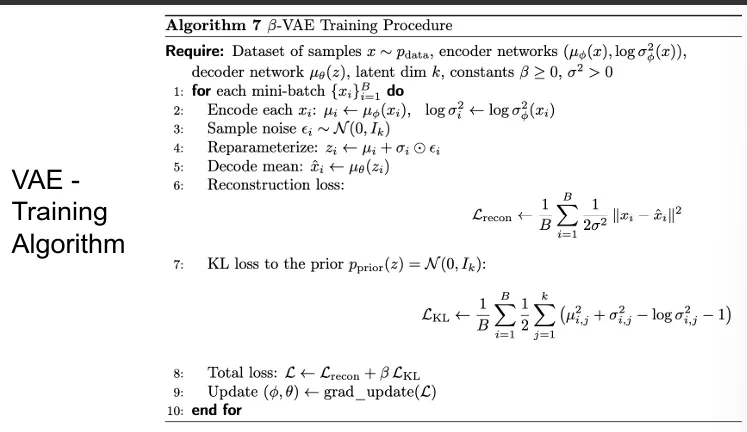
算法 6-VAE 训练流程(固定方差高斯解码器 )
备注 32(在隐空间中工作)
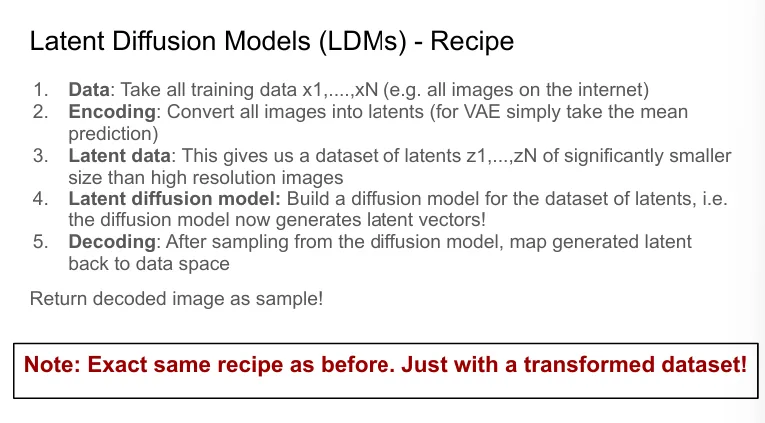
要训练 latent 生成模型,我们只需遵循现有训练配方,但直接在隐空间中工作。训练时,我们从 中采样,其中 ;推理时,我们从 latent diffusion 或 flow 模型中采样 ,然后用解码器解码 (注意我们取均值而非随机样本以避免噪声伪影)。
直觉上,一个训练良好的自编码器可以被看作滤除高频或其他语义上无意义细节的过滤器,使生成模型"聚焦"于重要的、感知相关的特征。
在本讲义撰写时,几乎所有最先进的图像和视频生成方法都遵循所谓的 latent diffusion 范式,即把 flow 或扩散模型训练在自编码器的隐空间中。
然而重要的是,人们仍需先训练自编码器,然后再训练扩散模型。关键是,性能现在还取决于自编码器把图像压缩到隐空间以及美观地恢复图像的能力。
我们在附录 D 中提供关于 VAE 的额外讨论。
6.3 案例研究:Stable Diffusion 3 与 Meta Movie Gen
我们最后简要考察两个大规模生成模型来结束本节:用于图像生成的 Stable Diffusion 3 和用于视频生成的 Meta Movie Gen Video。
正如你将看到的,这些模型使用了我们在本工作中描述的技术,并在架构上做了额外增强,以两者都能容纳丰富结构化的条件化模态,如文本输入。
6.3.1 Stable Diffusion 3
Stable Diffusion 3 是一系列最先进的图像生成模型。这些模型属于最早在图像生成中使用大规模 latent 扩散模型的模型之一。
Stable Diffusion 3 使用了我们在本工作中研究的相同条件 Flow Matching 目标(见算法 4)。
正如其论文中概述的,他们广泛测试了各种 flow 和扩散替代方案,发现 Flow Matching 表现最好。对于训练,它使用无分类器引导训练(去掉类别标签)。
此外,Stable Diffusion 3 遵循 6.1 节中概述的方法,在预训练自编码器的 latent 空间中训练。训练一个好的自编码器是第一版 stable diffusion 论文的一大贡献。
为增强文本条件化,Stable Diffusion 3 同时使用两种不同类型的文本嵌入:CLIP 嵌入,以及 Google T5-XXL 编码器预训练实例产生的序列输出。CLIP 嵌入提供输入文本的粗粒度、覆盖性嵌入,而 T5 嵌入提供更细粒度的条件化,使模型能关注文本的特定元素。
为了容纳这些序列嵌入,作者提出扩展 diffusion transformer 以 attend 到图像 patches,同时也 attend 到文本嵌入,从而在原类基 DiT 方案之上扩展条件化能力。这个提议的修改版 DiT 被称为多模态 DiT(MM-DiT),图 16 中描述。其最终最大模型有 80 亿参数。采样时使用 50 步,即需要用欧拉模拟方案评估网络 50 次,分类器引导权重在 2.0–5.0 之间。
图 16:多模态 diffusion transformer(MM-DiT)架构。
6.3.2 Meta Movie Gen Video
接下来我们讨论 Meta 的视频生成器 Movie Gen Video。由于数据不是图像而是视频,数据 位于空间 ,其中 表示新的时间维度(即帧数)。正如我们将看到的,这个视频设置中的许多设计选择可以看作是把现有技术(自编码器、diffusion transformer 等)从图像设置适配到这个额外维度。
Movie Gen Video 使用相同的直线调度器 、 的条件 Flow Matching 目标。与 Stable Diffusion 3 一样,Movie Gen Video 也在冻结预训练自编码器的 latent 空间中运行。
注意,自编码器对减少内存消耗的重要性在视频上甚至比图像更重要——这就是为什么大多数视频生成器目前在生成视频长度上还比较有限。
具体地,作者通过引入一个时间自编码器(TAE)来处理额外的时间维度,它把原始视频 映射到隐变量 ,其中 。
为适应长视频,提出了一种时间 tiling 过程,视频被切成多块,每块单独编码,然后把隐变量拼接在一起。模型本身(即 )由一个 DiT 风格的骨干给出,其中 沿时间和空间维度被 patchify。图像 patches 然后通过一个 transformer,该 transformer 既在图像 patches 之间使用自注意力,又通过类似 Stable Diffusion 3 中 MM-DiT 使用的语言模型嵌入进行交叉注意力。
对于文本条件化,Movie Gen Video 使用三种文本嵌入:UL2 嵌入用于细粒度的文本推理;ByT5 嵌入用于 attend 到字符级细节(例如明确请求特定文本的提示);以及 MetaCLIP 嵌入,在共享文本-图像嵌入空间中训练。其最终最大模型有 300 亿参数。要获得显著更详细和广泛的处理,建议读者参阅 Movie Gen 技术报告本身。
来源:human five