
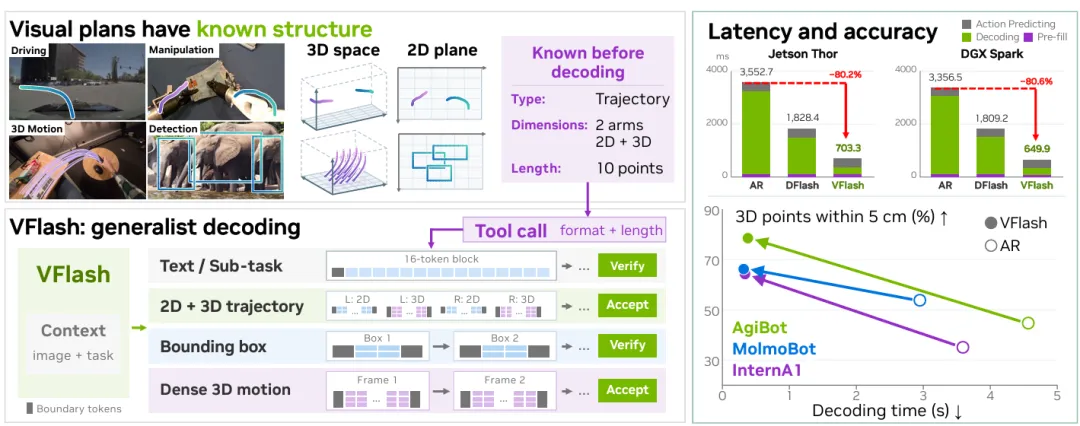
图 1:VFlash 是一个通用解码框架,面向机器人和自动驾驶等 Physical AI 任务,实现快速、准确的视觉规划。通过使预测块与视觉图元的已知结构对齐,VFlash 能够并行解码常见的结构化输出,例如边界框、变长 2D/3D 轨迹和稠密点运动,同时保留对文本和子任务计划进行验证的推测解码。与自回归(AR)解码相比,VFlash 提高了 3D 机器人轨迹规划的准确性,同时大幅降低了 NVIDIA 平台上的解码延迟,包括 Jetson Thor、DGX Spark 和 H100。
摘要
用于机器人和自动驾驶等 Physical AI 任务的模型,无需仅通过语言进行推理。它们可以使用视觉计划——点、边界框和轨迹——来表示空间目标并预测运动。然而,自回归视觉语言模型逐个坐标 token 地生成这些计划,使得更丰富的预测越来越昂贵。
我们提出 VFlash,一种通过 Flash Primitive Decoding 实现快速、准确视觉规划的方法。VFlash 利用视觉图元的已知结构,通过一个轻量级草稿模型在一次前向传播中生成完整图元,从而联合预测其坐标。其布局会根据图元的类型、维度和长度进行调整,既支持紧凑的边界框,也支持较长的变长轨迹。
关键在于,实现空间精度不一定需要复现自回归模型的精确 token 序列。因此,VFlash 使用带标注的图元进行训练,并直接接受结构有效的预测,无需与目标模型的 token 一致。在所评估的 2D 和 3D 机器人轨迹任务中,与自回归解码相比,VFlash 始终能够降低预测误差。初步的单次 rollout 测量表明,3D 点运动预测的生成速度约提升了 25 倍。以 VFlash 计划为条件的世界动作模型在四个 MolmoSpaces 任务套件上取得了 70.2% 的平均成功率,而基线为 62.6%。
1. 引言
VLM越来越多地被用作 Physical AI 系统的高层大脑:它们理解视觉观测和任务指令,从而指导机器人和自动驾驶系统的行为。它们的推理不一定只能通过语言表达。VLM 可以将中间预测表示为视觉计划:点和边界框用于标识相关位置或物体,轨迹则用于描述预期运动,或预测场景将如何演变。近期工作使用空间轨迹和视觉图元来指导动作生成。这些计划在执行动作之前,明确表达了空间目标和预期运动。每个视觉图元都有可识别的边界和有组织的坐标布局。
随着空间细节越来越丰富,高效生成这些计划变得愈发重要。更长的轨迹、更多的物体,以及联合进行的 2D 图像与 3D 预测,都需要更多坐标 token,而自回归 VLM 必须按顺序解码这些 token。对于需要随着新观测到来而更新计划的物理智能体,在固定延迟预算下,顺序解码限制了空间细节和更新频率。因此,我们需要一种解码方法:以更少的顺序前向传播生成完整的视觉计划,同时保持其空间准确性。
并行解码为降低这种顺序计算成本提供了一条有前景的路径,对于 batch size 为 1、对延迟敏感的 Physical AI 系统尤其如此。现有方法包括通过并行验证进行推测解码,以及通过并行去噪进行扩散语言模型(dLLM)解码。不过,相较于自回归模型,dLLM 通常需要在速度与质量之间进行权衡。DFlash 将这两种方法结合起来:使用轻量级块扩散草稿模型,在一次前向传播中预测草稿 token,然后通过目标模型验证,以保留自回归模型的输出分布。对于视觉输出,LocateAnything 通过并行边界框解码利用了空间结构。
在这项工作中,我们提出 VFlash:一个面向 Physical AI 的通用解码框架,如图 1 所示。它同时支持文本,例如子任务计划,以及多种视觉图元,例如边界框、变长轨迹和稠密 3D 运动预测。我们的研究发现了一个有趣的现象:轻量级扩散草稿模型不仅解码速度快得多,甚至还能在视觉计划的空间精度上超过其自回归目标模型。
视觉图元的结构有助于解释这一发现:一旦指定了图元的类型、维度和长度,其边界和坐标布局也就确定了。使草稿块与这些边界对齐,就可以联合预测整个几何对象,并在一次前向传播中解码数十至数百个 token。这些观察促使我们在训练和解码时与完整图元的边界对齐,并直接接受结构有效的草稿,而不要求它与目标模型在 token 级别保持一致;对于文本,则继续保留经过验证的解码。
VFlash 的核心是 Flash Primitive Decoding(FPD)。它根据请求的输出结构组织草稿模型的训练和推理。工具调用指定变长预测的大小,而图元类型决定其坐标布局。轻量级扩散草稿模型以冻结的目标 VLM 特征为条件,从带标注的空间数据中学习预测完整图元。推理时,解码器施加与布局对应的约束,并完整接受有效图元。目标 VLM 为后续预测提供上下文,普通文本则继续使用由目标模型验证的推测解码。
我们在 2D 和 3D 机器人轨迹、边界框以及稠密 3D 点运动预测上评估 VFlash,并研究它在下游操作和驾驶任务中的应用。在所评估的机器人轨迹任务中,VFlash 相较于其自回归目标模型始终能够降低预测误差。在图 1 所示的下游机器人操作 pipeline 中,VFlash 在 Jetson Thor 和 DGX Spark 上都将推理延迟降低了约 80%。这些视觉计划也能为动作模型提供有用的条件信息:在 MolmoSpaces 上,以 VFlash 计划为条件的世界动作模型在四个任务套件上取得了 70.2% 的平均成功率,而基线为 62.6%。
除了加速之外,我们的工作还表明,并行解码在多模态系统中可能发挥更广泛的作用。无损推测解码保留了自回归目标模型的输出分布;而对于结构化视觉规划,可以根据预测的空间精度及其对动作的实用性来判断预测结果,这与放宽接受标准的思路一致。VFlash 使 VLM 能够以 System-1 模式进行视觉规划,通过联合坐标解码快速生成结构化空间预测。这个视角与近期的 System-1 模型有一个有趣的联系,例如 Jev 强调快速的类型化决策。VFlash 将这一视角引入完整的几何预测,利用每个图元内部的结构。由此在速度和空间精度上同时获得的提升表明,自回归解码不一定定义了视觉输出的质量上限。
2. 方法
本节介绍 VFlash 面向 Physical AI 的通用解码框架,内容涵盖 DFlash 的预备知识,以及 Flash Primitive Decoding 的详细设计,如图 2 所示。
2.1 预备知识
在推测解码中,草稿模型 提出 个 token,目标模型 并行验证这些 token。平均每个 token 的延迟为:
其中, 是每个周期预期接受的 token 数量。DFlash 使用一个轻量级块扩散草稿模型降低分子部分的计算开销。目标模型选定层的特征 被融合,并作为 key 和 value 注入草稿模型的每一层。给定起始 token ,草稿模型通过一次双向前向传播预测 个被 mask 的 token,因此有:
其中, 是逐 token 顺序生成草稿的开销。
不过,更长的草稿不一定能增大 :贪心验证只接受到第一个与目标模型不一致的位置为止:
通常在远低于 的位置就达到饱和。因此,增大块的长度不一定能提高最终吞吐量。
对于文本生成,目标是通过验证保留目标模型的输出分布。但 token 级别的一致性不一定能够反映空间精度。VFlash 保留了草稿生成架构,并将上述验证方式替换为直接接受结构有效的视觉图元。
2.2 Flash Primitive Decoding
给定视觉观测和任务指令,VLM 预测边界框、机器人轨迹或未来点位置等空间对象。每个预测都是一个视觉图元,其 schema 指定了图元的类型、坐标维度和范围。这样,每个坐标的作用便被固定下来,而具体数值仍需根据输入进行推断。
一条轨迹的 2D 图像坐标和 3D 空间坐标可以组成一个图元并联合预测。对于变长预测,工具调用声明其范围;这一范围与图元类型共同决定布局。对于边界框等固定大小的预测,仅凭类型即可确定布局。因此,结构在坐标预测之前就是已知的,每个解码块覆盖一个完整图元。
Schema 定义了一个长度为 的块:一个已观测的起始 token ,后接 个被 mask 的 token。自回归目标模型将块分解为:
并需要 次顺序前向传播。相比之下,给定布局和目标模型上下文,VFlash 通过一次前向传播,以条件独立的方式预测所有位置:
因此,完整图元是并行预测的基本单位,推测预算 由请求决定,而不是由固定窗口决定。同样的原则也适用于以普通文本形式输出坐标的目标模型:我们在固定宽度的布局中对齐其数值字段,再将预测结果转换回目标模型的文本格式。附录 A 给出了每项任务的坐标约定和序列化格式。
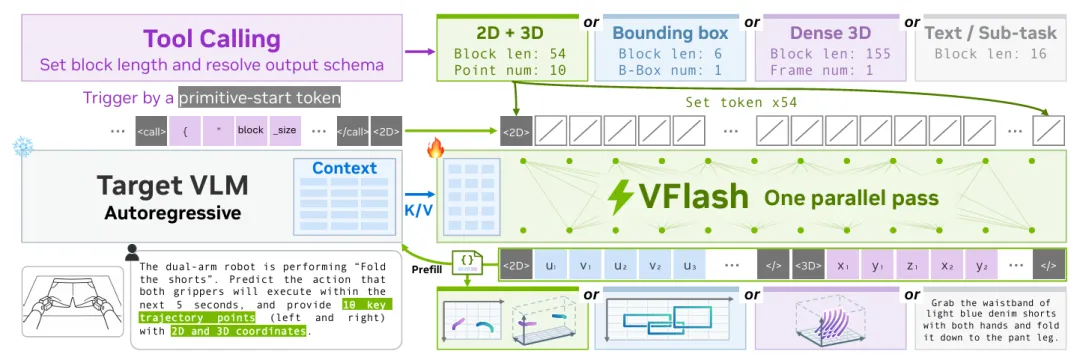
图 2:FPD 的设计。图元起始 token 触发一个预测块,其布局由图元类型和此前的工具调用共同决定。通过使预测块适应每种图元的结构,VFlash 无需与 VLM 在 token 级别保持一致,即可支持不同的空间格式和长度。
2.3 Token 表示
视觉计划通常需要较大且长度可变的草稿块。例如,NAVSIM 需要预测 4 秒内的 8 个航点,而 Waymo 需要预测 5 秒内的 20 个航点。生成这类块会给格式遵循和空间精度带来挑战。我们发现,两项设计原则有助于应对这些挑战:
边界对齐决定哪些内容一起预测。每个草稿块覆盖一个完整图元,避免固定长度窗口造成的切分。工具调用声明块的长度,由此可以确定航点数量 。共享的布局模板能够容纳不同长度,使整个图元可以在一次前向传播中生成。
位置对齐决定每个位置预测什么。在解码之前,每个位置的作用都是已知的:它可能对应航点、坐标轴或分隔符。这支持以一致的布局进行并行预测,并在推理时施加逐位置约束。
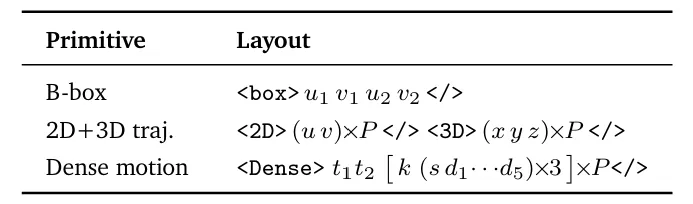
表 1:图元布局。每个块都以起始 token 开始。 表示点的数量; 和 分别表示由特殊 token 表示的图像平面坐标和以米制单位表示的坐标。
要维持这一布局,每个坐标都必须占据固定数量的位置。近期 VLM 将图像坐标归一化到 0–1,000,并将其写作普通文本;围绕视觉图元构建的模型则通常使用特殊 token。一个特殊坐标 token 占据一个位置,而文本 tokenization 的结果会随数值变化,从而改变后续坐标的位置。VFlash 支持这两种表示方式。
对于我们的基础模型,类型化的起始和结束 token 标记图元边界,以及文本解码和图元解码之间的切换。每个坐标使用 1,001 个特殊 token 中的一个,从而可以将预测限制在其合法词表内。
对于采用文本 tokenization 的目标模型,VFlash 为每个坐标分配一个符号位和五个数字位,未使用的高位由 mask token 填充。这个固定宽度网格保留了各位置的作用,随后被转换回目标模型的文本格式,其分隔符用于标记块边界。表 1 和附录 A 给出了格式细节。
2.4 训练
我们首先使用 next-token 监督,使一个自回归 VLM 适应空间响应格式;随后冻结该模型,并基于其特征训练一个浅层非因果草稿模型。对于一个带标注的块 ,我们最小化公式 3 的加权交叉熵:
所有 logits 都在一次前向传播中联合计算。图元位置使用均匀的权重 ,这与公式 2 下偏向前面位置的递减权重不同。关键在于,标签 来自标注坐标或转换后的网格,而不是目标模型的后续输出。因此,草稿模型优化的目标是空间精度,而非 token 级别的一致性。
每个带标注的图元对应一个完整块。如果响应还包含文本,则通过采样短块训练普通草稿生成路径,使同一个草稿模型同时服务于需要验证的文本路径和直接接受的图元路径。Packed attention 在保留每个图元内部注意力的同时,将不同样本和独立块隔离开来。骨干模型、数据、有效性权重和适配方案见附录 B。
2.5 推理
解码过程首先使用长度为 16 的 DFlash 块运行,直到接受一个图元起始 token。随后,解码器解析已声明的 schema,并在一次前向传播中生成长度为 的完整块。
逐位置约束将坐标和分隔符限制在各自的合法词表内;跨位置规则则对画面外坐标进行配对。两类约束都作用于已经计算出的 logits,不增加额外的神经网络计算。
设 为得到的预测结果, 为其接受测试:包括 schema 验证器,以及对于边界框额外使用的 LocateAnything 空间置信度检查。VFlash 将公式 2 替换为:
其中,前 个草稿位置被保留,其余部分由带约束的目标模型自回归解码重新生成。对于轨迹,;对于边界框,保留第一个不确定坐标之前的位置。
被接受的图元无需与目标模型在 token 级别一致即可提交。随后,目标模型执行一次前向传播,更新缓存和上下文特征,并输出下一个 token。文本仍遵循公式 2;附录 C 给出了两种流程。
将上述公式代入公式 1,一个有效图元的平均每 token 开销为:
而自回归解码中的每个坐标都需要一次耗时为 的目标模型前向传播,此外还有前缀和后续生成的开销。两次前向传播的计算量都只会随 温和增长,但前向传播的次数不会增加,因此更精细的计划不会增加顺序解码步骤。
3. 实验
基础 VLM。大多数实验使用一个定制的具身 VLM,它结合了 Qwen3-4B、原生分辨率 MoonViT 编码器和 MLP 连接器。该模型依次在通用视觉语言任务、视觉定位(grounding)、具身空间理解和联合 2D/3D 轨迹预测任务上进行训练。边界框和轨迹坐标使用特殊 token 表示,其中 2D 图像坐标被归一化到 0–1,000,3D 坐标则在预先定义的范围内进行均匀量化。对于稠密运动预测,我们使用已发布的 MolmoMotion-AR 模型,并保留其基于文本的坐标表示方式。
各任务训练。为了进行清晰的消融研究,我们在任务专用数据上微调 AR 目标模型,然后将其冻结,并在相同数据上训练一个五层的 VFlash 草稿模型。对于 MolmoMotion,我们仅在冻结的已发布目标模型上训练草稿模型。各任务数据集、训练数据混合配比和优化设置的详细信息见附录 B。
视觉计划条件输入。尽管 DiT/WAM 的架构及其与 VLM 的接口不同,但它们有一个共同点:动作模型通过交叉注意力读取编码了生成视觉计划的 VLM 特征。这些特征通过冻结的目标 VLM 处理 VFlash 接受的图元得到。附录 D 详细介绍了模型架构和条件输入机制。
3.1 视觉图元预测
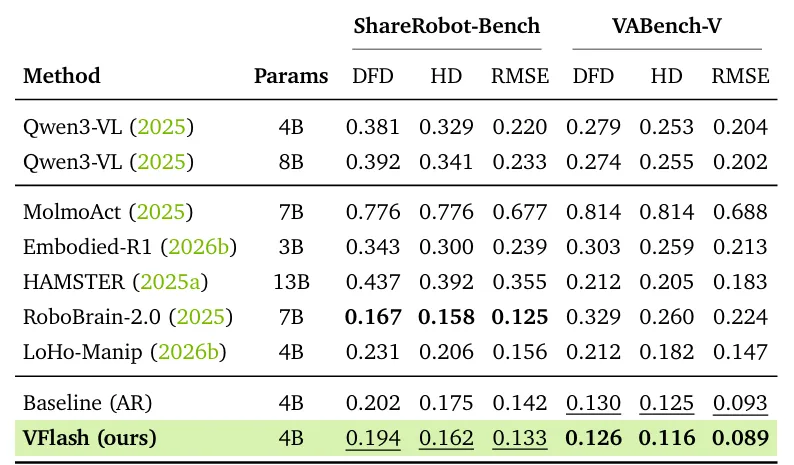
表 2:开环 2D 轨迹预测。DFD、HD 和 RMSE 均在归一化图像坐标下计算,数值越低越好。参考方法的数据来自先前工作;Baseline(AR)和 VFlash 使用相同的 4B 目标模型,仅解码器不同。粗体和下划线分别表示最佳和第二佳结果。
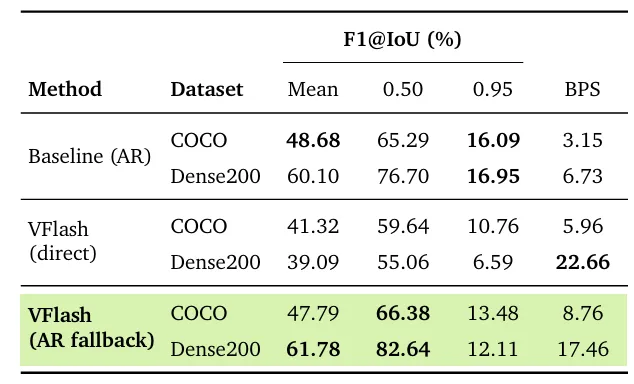
表 3:以类别为条件的边界框生成。指标为 F1(%,越高越好)和每秒生成的边界框数量 BPS(越高越好)。Direct 直接接受每个符合 schema 的边界框,不进行验证;AR fallback 对未通过空间置信度检查的边界框,使用带约束的 AR 解码重新生成,详见附录 F.4。BPS 在每个数据集上分别测量。
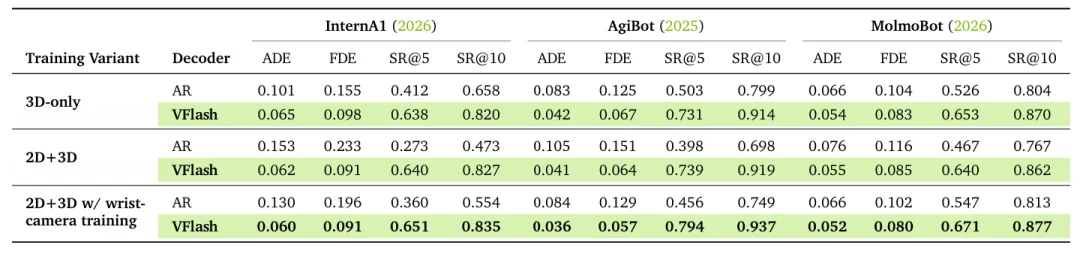
表 4:开环 3D 机器人轨迹预测。ADE 和 FDE 的单位为米,数值越低越好;SR@5 和 SR@10 分别表示误差在 5 cm 和 10 cm 以内的航点比例,数值越高越好。三个变体的区别在于模型生成的内容——仅 3D 或 2D+3D——以及训练时是否加入腕部相机视角。所有组都使用相同的单视角输入进行评估。粗体表示每列的最佳值。
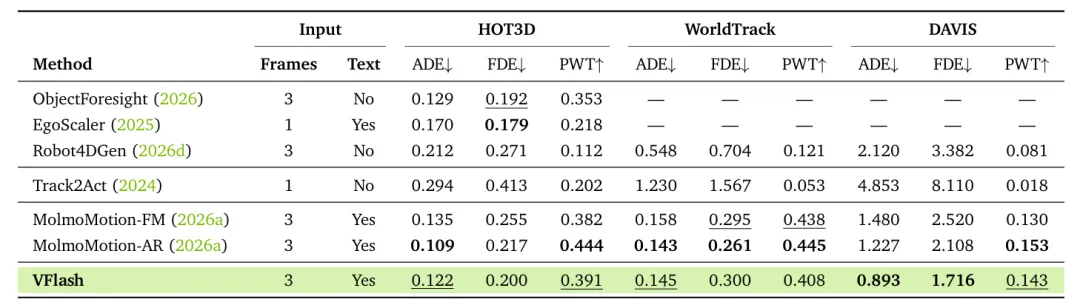
表 5:PointMotionBench 上的 3D 点运动预测。VFlash 使用 MolmoMotion-AR 作为目标模型。与 AR 相比,VFlash 的单次 rollout 生成速度约提升 25 倍,详见附录 F.3。ADE/FDE 的单位为米,数值越低越好;Frames 和 Text 分别表示观测历史帧数和是否使用语言输入。粗体和下划线分别表示最佳和第二佳结果。
2D 轨迹预测。在 ShareRobot-Bench 和 VABench-V 上,VFlash 降低了其 AR 目标模型的全部六项误差指标,如表 2 所示。在两个 benchmark 上,HD 降低了 7%,DFD 和 RMSE 降低了 3%–6%。
在 VABench-V 上,相较于此前表现最好的模型 LoHo-Manip,VFlash 的每项误差都降低了约 40%;不过,我们的 AR 目标模型已经优于表中列出的基线。在 ShareRobot-Bench 上,VFlash 的表现仅次于 RoboBrain-2.0。
2D 边界框预测。在 COCO 和 Dense200 上,采用 AR fallback 的 VFlash 在平均 F1 上与 AR 相当,同时解码速度提升了 2.6–2.8 倍,如表 3 所示。在 IoU 为 0.50 时,VFlash 的 F1 更高,在物体密集的 Dense200 场景中尤其如此;但在 IoU 为 0.95 时,F1 较低。如果不使用 fallback,Dense200 上的平均 F1 会下降约 20 个百分点。
3D 轨迹预测。在 InternA1、AgiBot 和 MolmoBot 上,VFlash 改进了全部三种目标模型变体的四项指标,如表 4 所示。
对于仅输出 3D 的目标模型,ADE 降低了 18%–49%;对于输出 2D+3D 的目标模型,ADE 降低了 28%–61%。在 AgiBot 上,5 cm 阈值内的航点准确率分别从 50% 提高到 73%,以及从 40% 提高到 74%。
当联合输出 2D+3D 时,AR 的 3D ADE 比仅输出 3D 时高出 15%–51%;而 VFlash 通过一次并行前向传播预测两个部分,保持了相近的准确率。在训练时加入腕部相机视角,可使 VFlash 的 ADE 进一步降低 3%–12%;评估时仍仅使用主相机。
稠密 3D 运动预测。在 PointMotionBench 上,我们冻结 MolmoMotion-AR 的骨干模型,将查询点在每个未来帧中的预测作为一个块,并采用固定宽度的数字布局,详见附录 A。
如表 5 所示,VFlash 在 DAVIS 上分别将 ADE 和 FDE 降低了 27% 和 19%,并将 HOT3D 上的 FDE 降低了 8%。在 HOT3D 和 WorldTrack 上,其 ADE 排名第二,落后于 AR,但优于 Flow Matching 变体。不过,WorldTrack 上的 FDE 增加了 15%,三个数据集上的 PWT 下降了 7%–12%。
这些结果将 VFlash 扩展到了使用文本 tokenization 坐标的稠密运动预测:相较于 AR,多个误差指标得到改善,同时单次 rollout 的生成速度约提升 25 倍,详见附录 F.3。
3.2 下游应用
实验设置。我们优先对视觉计划条件输入进行受控比较,而不是通过额外的模型增强来最大化 benchmark 分数。在所有配置中,VLM 都保持冻结;动作策略以其编码了生成计划和视觉上下文的隐藏状态为条件。在每项应用内部,我们在不同对比中保持动作模型架构不变。
MolmoSpaces。对于 MolmoSpaces,策略是一个世界动作模型(World Action Model,WAM),通过对 Cosmos-Predict2.5 进行面向机器人控制的后训练得到。我们将其中的 Cosmos-Reason 文本编码器替换为我们的 VLM。
WAM 读取 VLM 在问题、生成的子任务以及包含 10 个航点的 2D+3D 轨迹视觉计划处的隐藏状态。这些状态经过线性投影后,输入 WAM 现有的文本交叉注意力路径。WAM 保留其自身的相机和机器人状态输入,预测长度为 20 步的 Action Chunk,并在每执行三个 Action Chunk 后请求一个新计划。基线是未修改的 WAM,保留其原始文本编码器。
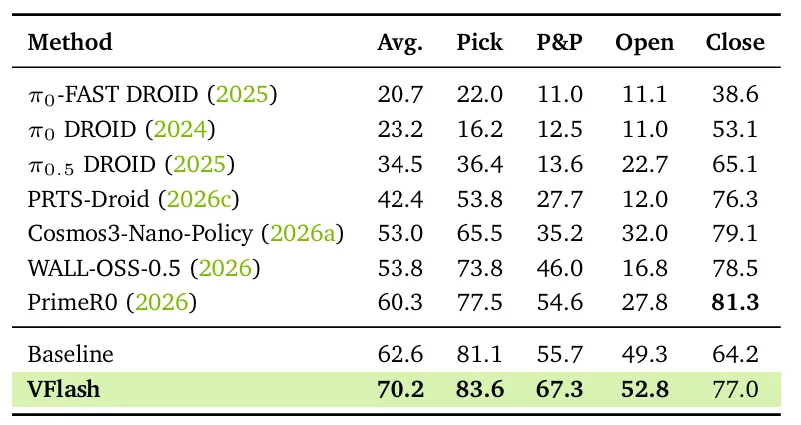
表 6:MolmoSpaces 操作任务结果。Baseline 和 VFlash 使用相同的 WAM;Baseline 保留其原始文本编码器,VFlash 则将其替换为我们的 VLM,并以生成的计划为条件。粗体表示每列的最佳值。
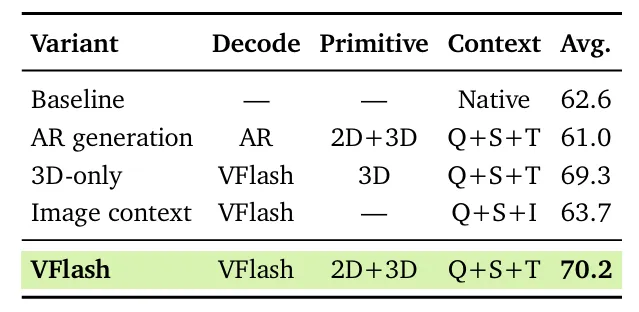
表 7:所有变体均使用相同的 WAM,但采用不同的解码器、图元类型或条件特征。Baseline 使用 WAM 原始的文本编码器。Q、S、T 和 I 分别表示问题、子任务、轨迹和图像 token 对应的 VLM 隐藏特征。图像上下文基线使用 VFlash 解码子任务。
如表 6 所示,以视觉计划为条件使平均成功率从 62.6% 提高到 70.2%,平均高于表中列出的公开模型 PrimeR0 9.9 个百分点,并且在四项任务中的三项上取得更高分数。
相较于基线,提升最大的任务是 Pick & Place 和 Close,分别提高了 11.6 和 12.8 个百分点;Pick 提高了 2.5 个百分点。这表明,对于涉及多个相互依赖动作的任务,视觉计划带来的收益可能更大。
表 7 比较了不同的计划表示和条件输入选择。使用 AR 生成的 2D+3D 计划替代 VFlash 计划,平均成功率从 70.2% 降至 61.0%。使用图像状态替代轨迹状态,成功率下降 6.5 个百分点至 63.7%。仅使用 3D 计划达到 69.3%,而联合 2D+3D 计划取得了最高的平均成功率。
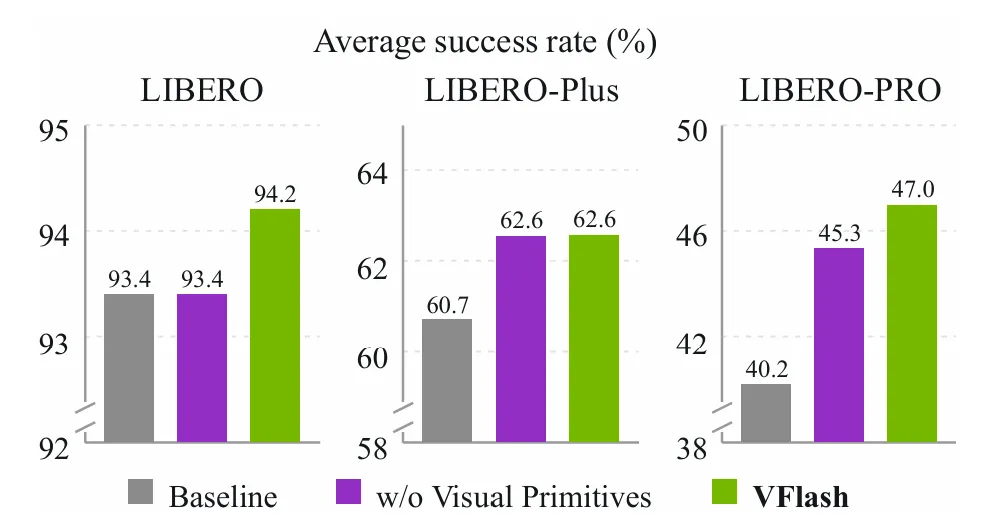
图 3:LIBERO 系列 benchmark。比较同一个 PIv3 head 在不同条件输入下的平均成功率(%):冻结的 Qwen3-VL-4B(Baseline);我们的 VLM 中截至生成子任务的状态(不使用视觉图元);以及完整视觉计划(VFlash)。
LIBERO 系列。在 LIBERO、LIBERO-Plus 和 LIBERO-PRO 上,我们在 StarVLA 中训练一个基于 Flow Matching 的 PIv3 Action Head,并在每一层通过交叉注意力读取冻结的 VLM。
给定主相机和腕部相机图像,VLM 在生成每个包含 8 个动作的 Action Chunk 之前,先生成一个子任务和一条包含 10 个航点的 2D+3D 轨迹。我们比较以截至子任务的 VLM 状态为条件,以及以完整计划的 VLM 状态为条件。基线使用相同的 Action Head,但由冻结的 Qwen3-VL-4B 仅对图像和指令进行编码。
如图 3 所示,相较于基线,成功率提升从 LIBERO 上的 0.8 个百分点,增加到 LIBERO-Plus 上的 1.9 个百分点,以及 LIBERO-PRO 上的 6.8 个百分点,表明在存在扰动的情况下收益更大。
在 LIBERO-PRO 上,相较于基线,视觉计划使 Spatial、Object 和 Goal 分别提高了 11.1、9.4 和 6.9 个百分点。与仅以子任务为条件相比,视觉计划使 Spatial 提高 2.6 个百分点、Goal 提高 1.2 个百分点、Long 提高 2.0 个百分点。这表明,轨迹在生成的子任务之外提供了有用信息。
表 8:NAVSIM 和 Waymo 测试集上的自动驾驶结果。RL 表示强化学习;↑ 和 ↓ 分别表示越高越好和越低越好。
自动驾驶。对于 NAVSIM 和 Waymo,策略是一个基于 ReCogDrive 的 Diffusion Transformer。它通过交叉注意力读取 VLM 在 prompt 和生成计划上的最后一层状态,同时读取自车历史信息和车辆状态,并输出一条连续轨迹。
VLM 保持冻结,并在每个数据集各自的原生网格上生成一条 2D+3D 轨迹。我们分别在 Waymo、NAVSIM 和 Alpamayo 衍生数据上训练不同的 head。随后,RL 仅微调 head,并分别以 PDMS 和 RFS 为奖励。因此,SFT 和 RL 对应行使用的计划相同。
如表 8 所示,VFlash 使用冻结的规划 VLM 和一个小型 Action Head,取得了具有竞争力的驾驶性能。经过监督训练后,它在 NAVSIM 上达到 87.1 PDMS,高于 ReCogDrive 的 86.8;在 Waymo 上达到 7.79 RFS,与 Qwen-Drive-1.0-SFT 的 7.78 相当。
对 Action Head 进行 RL 后,这两项分数分别提高到 90.7 PDMS 和 7.86 RFS:在 NAVSIM 上与 Qwen-Drive-1.0-RL 持平,在 Waymo 上与表中最佳结果相差 0.05 RFS。获得这些提升无需更新 VLM 或它生成的计划。
这些结果共同表明,VFlash 在大幅降低解码延迟的同时,能够支持以计划为条件、具有竞争力的驾驶性能,详见第 3.3 节。
3.3 吞吐量分析
图 4 将 Jetson Thor、DGX Spark 和 H100 上、batch size 为 1 时的每步延迟拆分为视觉编码、prefill、解码和动作模型四个部分。
Thor 是面向机器人和车辆的嵌入式平台,Spark 是桌面级系统,二者是第 1 节所述 System-1 视觉规划的典型端侧硬件;H100 则作为服务器端参考。附录 E 给出了计时范围和完整表格。
在不同设备上,VFlash 将 MolmoSpaces 的每步延迟在 Thor 和 Spark 上缩短了 5.1–5.2 倍,在 H100 上缩短了 3.6 倍;在 NAVSIM 上分别缩短了 3.4–3.6 倍和 2.6 倍。在 Waymo 上,如图 5 所示,H100 的每步延迟缩短了 4.5 倍。
收益几乎全部来自解码阶段:在 Thor 上,AR 解码占每步总时间的 75%–87%;VFlash 将这部分时间缩短了 12–42 倍,而其他阶段保持不变。
AR 解码每生成一个 token,都需要运行一次 4B VLM 前向传播:Thor 上为 35–39 ms,Spark 上为 33–40 ms,H100 上为 4.7–6.0 ms。因此,解码时间与 token 数量大致呈线性增长。
草稿生成则通过一次前向传播预测一个包含 36–84 个 token 的图元中的剩余 token,在 Thor 上耗时 13–23 ms,在 H100 上耗时 1–3 ms。验证仍然需要对每个块运行一次目标模型前向传播,因此其收益取决于每轮实际提交的 token 数量。
图 4:VFlash 在 Jetson Thor、DGX Spark 和 H100 上处理不同下游任务时的延迟。图中将延迟拆分为预处理与 ViT、prefill、解码以及 WAM/DiT。
在 MolmoSpaces 上,DFlash 处理子任务文本时,每轮提交 5.5 个 token;但在轨迹块内部,每轮仅提交 2.2 个 token:即使几何误差很小,只要某个坐标与目标模型选择的量化区间相差一个 bin,就无法通过公式 2 的验证。因此,DFlash 只能将解码时间大约减半。
VFlash 跳过视觉图元的 token 级验证,每个图元只使用一次草稿模型前向传播和一次目标模型前向传播。目标模型的前向传播用于更新缓存,并为 Action Head 提取隐藏状态;其开销分摊到整个块上。
在 Thor 上,当驾驶图元从 36 个 token 增加到 84 个 token 时,解码耗时为 72–78 ms。因此,在这一范围内,更密集的计划只会增加很少的延迟。
4. 相关工作
具身 VLM 与视觉计划。具身 VLM 越来越多地被用作高层模块,将视觉观测和语言指令转换为计划、可供性和轨迹。空间预测是这些模型的核心:点和边界框用于定位物体或可供性,轨迹则描述预期或预测的运动。
这些视觉计划可以作为操作策略的条件输入,也可以作为 prompt 反馈给模型。其他工作在行动前进行空间推理、预测未来状态,或根据场景理解规划驾驶轨迹。
这些研究关注具身模型应该预测什么,而我们关注此类空间预测能够以多快的速度生成。逐 token 的坐标生成意味着,每增加一个航点、物体或维度,就需要增加一个解码步骤。
并行解码与推测解码。推测解码通过并行验证多个草稿 token 来加速 LLM 推理。Medusa、EAGLE、TIDAR 和 DFlash 探索了生成这些草稿的不同方式。
对于视觉输出,LocateAnything 以点和边界框为单位进行解码,但仅限于固定大小的 2D 图元。与本工作最接近的是 Spec-VLA:它通过接受量化区间接近目标模型输出的草稿动作 token,来加速 OpenVLA。不过,它仍需针对目标模型验证每个动作 token,并且每次前向传播仅提交 2.10–2.94 个 token。
我们的发现是:对于视觉轨迹预测,一次前向传播得到的草稿比自回归目标模型更准确。基于这一发现,VFlash 在一次前向传播中生成整个视觉图元,而不依赖与目标模型的一致性。
具身模型与 System-1 模型。在部署后的感知—动作闭环中,VLM 的延迟直接限制智能体的反应速度。此前的效率研究主要加速动作执行 pipeline,例如使用动作压缩、并行 Action Chunk 或 Flow Matching。然而,此前基于 VLM 的规划通常仍依赖高度自回归的 token 解码。
Jev 等 System-1 模型能够快速做出带类型的决策,供下游应用直接使用;Visual Jev 在一次图像编码后,并行回答多个相互独立的视觉问题。我们的工作可以被视为使 VLM 能够进行 System-1 空间预测的一项相关探索。
在这一背景下,我们系统研究了经过优化的 token 表示和解码方案,同时支持专用特殊 token 和普通数字。
总之,VFlash 使用 DFlash 风格的草稿生成,但不要求与目标模型的 token 一致。它将 LocateAnything 的并行边界框解码所实现的快速、准确视觉计划生成,扩展到更丰富、更通用且对下游具身应用有用的视觉图元。通过系统研究,VFlash 还实现了更高效的解码并行化。
5. 结论
我们提出了 VFlash,它利用视觉图元的已知结构,以并行预测替代顺序坐标生成。
实验结果表明,有用的空间预测不一定需要复现自回归模型的输出:直接生成的草稿降低了机器人轨迹误差;单次 rollout 的计时估计则表明,3D 物体点预测的生成速度约提升 25 倍。以计划为条件的操作任务进一步展示了这些预测如何支持下游动作生成。
未来工作将研究:在固定延迟预算下,根据共享观测生成多个互补图元,是否能够改善控制效果。
来源:human five