
行为空间基准:评估机器人的空间理解
——把'问、指、做'拆开量
VLA(视觉-语言-动作)模型几乎都从一个假设出发:预训练 VLM 主干的空间理解,会自动迁移成机器人的行为。但这个假设很少被直接验证。
策略可能只是记住了熟悉布局里"哪个物体在哪、该抓谁",根本没理解"从左边数第二个"这种空间关系;也可能选对了目标却在执行中失败。
斯坦福李飞飞团队在 BEHAVIOR-1K 之上建了 BEHAVIOR-Spatial,把这件事拆成三层同一场景的评测:
空间问答(能不能答对"哪个最大")、点级目标指向(能不能指对"最大那个在哪")、机器人行动(能不能真去够它),共用同一批物体和空间关系。
实验结果显示,基线策略在全新场景配置上软成功率 41.6%,但在训练过的布局里换一句话(换目标),直接掉到 16.1%,70% 的回合还去够错了东西:策略依赖的是"场景-动作"联想,不是指令本身。

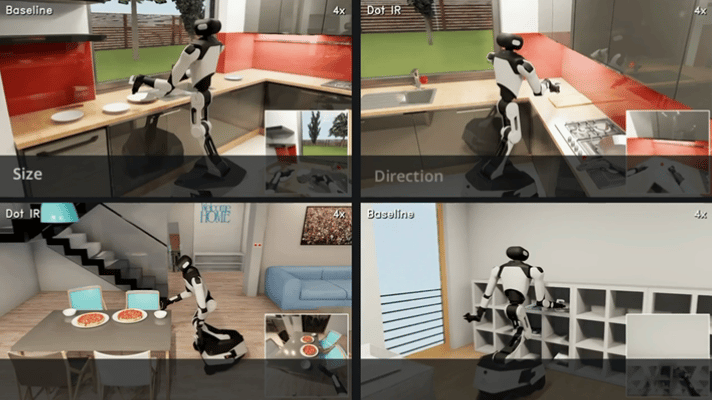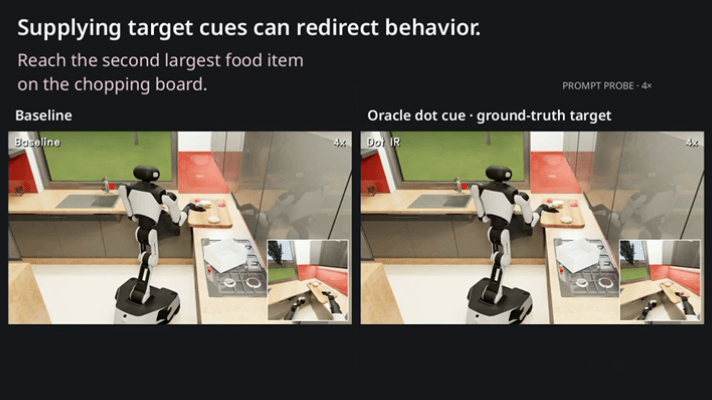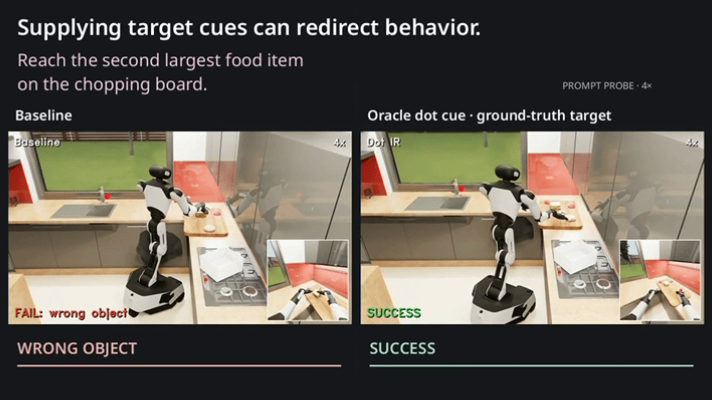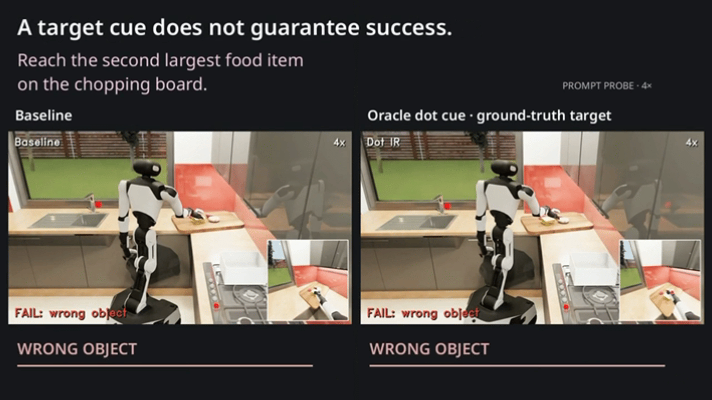
▲图 | BEHAVIOR-Spatial 将视觉问答(理解)、目标指向(定位)与执行(行动)串联起来,检验 VLM 空间能力能否预测 VLA 任务性能 ©【深蓝具身智能】编译
为什么"任务成功"这个指标不够看
一个机器人"把手伸向最大的盘子"且成功了,你无法知道它是真听懂了"最大",还是因为那个盘子恰好总在熟悉的那个位置。反过来,指令换了目标,它要是还去够老位置,就露馅了。所以评测必须把三个层次分开:
问(Understand):只看模型能不能答对空间问题;
指(Ground):看它能不能把"目标"落到一个具体的点/区域;
做(Act):看它能不能真的执行到位。
而这三个层次恰恰可能互相矛盾——答得对不代表指得准(选择题和定位是两种能力),指得准不代表做得成(执行还有另一层难关)。
BEHAVIOR-Spatial 把这三件事放回同一批场景、同一批物体、同一批空间关系里,让它们能一一对应着比。
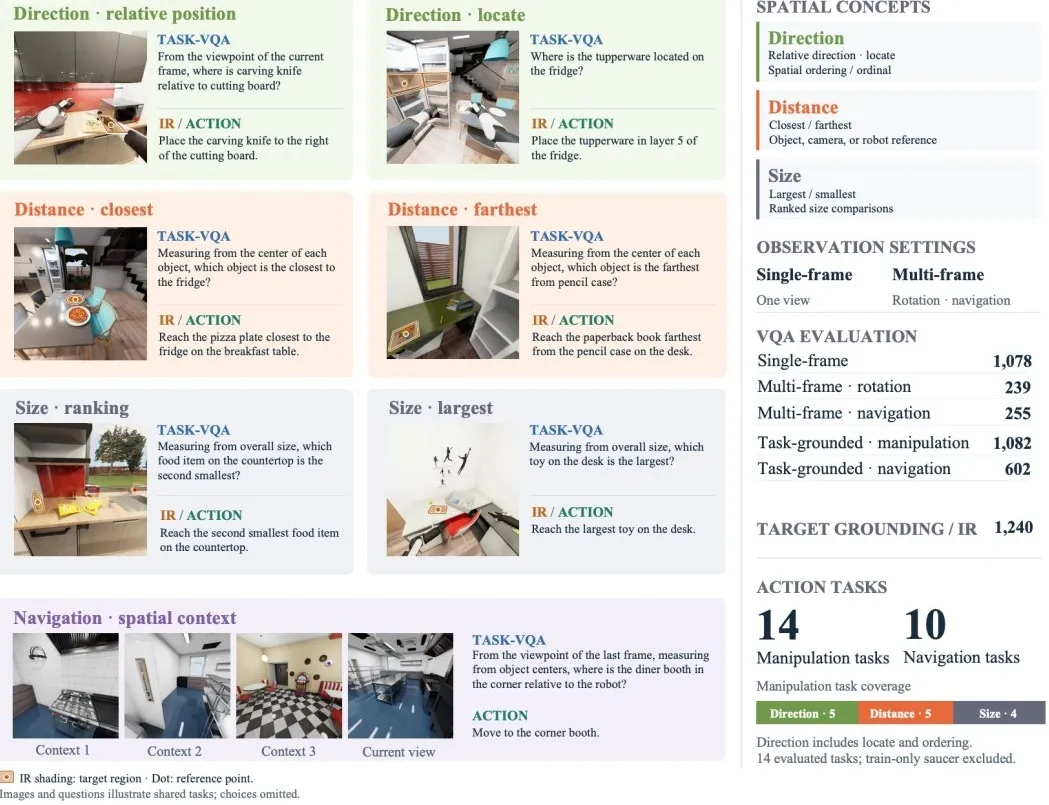
▲图 | BEHAVIOR-Spatial 数据集展示。左:覆盖方向、距离、尺寸的成对任务 VQA、指向与行动示例,导航展示三张上下文视角与当前视角;右:空间分类、VQA 数量、指向/中间表征与任务覆盖 ©【深蓝具身智能】编译
数据集:三层套件 + 诊断式评测协议
数据集分三块:
BEHAVIOR-Spatial-VQA(3,256 个空间问题、49 个活动,分通用 1,572 个 + 任务相关 1,684 个,含单帧与多帧);
BEHAVIOR-Spatial-IR(14 个操纵任务、1,240 个目标指向查询);
BEHAVIOR-Spatial-Action(14 个操纵 + 10 个导航任务)。
全部从 BEHAVIOR-1K 的演示里用仿真几何 + 元数据自动生成,做了可见性检查和关系边际过滤来控歧义。
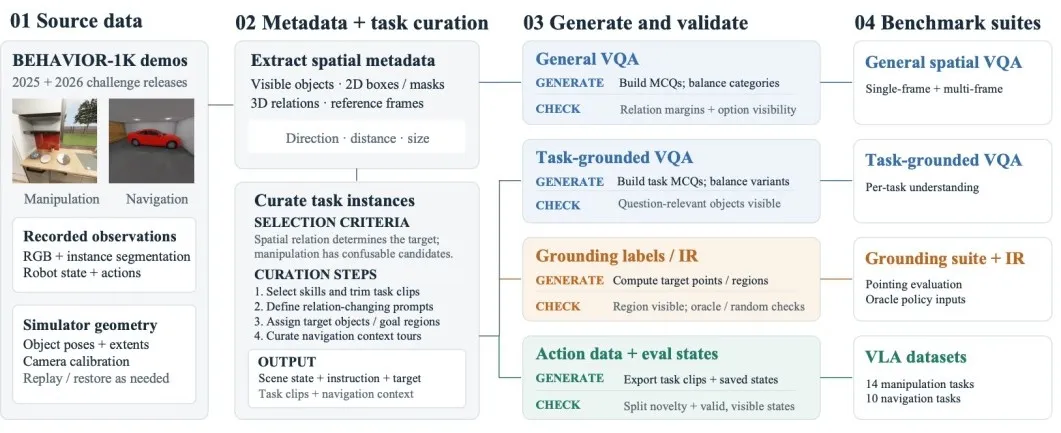
▲图 | 数据构建管线。演示观测与仿真几何支撑通用 VQA 与精选空间任务;任务实例产生任务级 VQA、指向标签与 VLA 数据集;选择标准引导筛选,每个套件校验样本©【深蓝具身智能】编译
评测协议分两种:
留出(held-out):未见过的新场景配置 + 未见过的指令变体,测"泛化";
提示探测(prompt-probe):训练布局原封不动,只把指令换成另一个合法目标,测"到底听不听话"。
行动指标也拆得很细:软成功(有正确目标意图的代理指标)、严格成功(真正完成任务)、错目标率(够到了没被指定的东西)。
软/硬/错目标三件套,把"选对"和"做成"彻底分开。
模型与实验:几个反直觉的关键发现
VLA 用 π0.5 架构、换 Qwen3.5-4B 主干,冻结 VLM + 从头训流匹配动作专家;另测了 LoRA 适配、DROID 预训练初始化、以及三种 oracle 目标指向接口(点 IR、点 IR+首帧锚、注意力图 IR)。注意指向信号是仿真算出的真值,专门用来隔离"给对了目标,执行还差多少"。
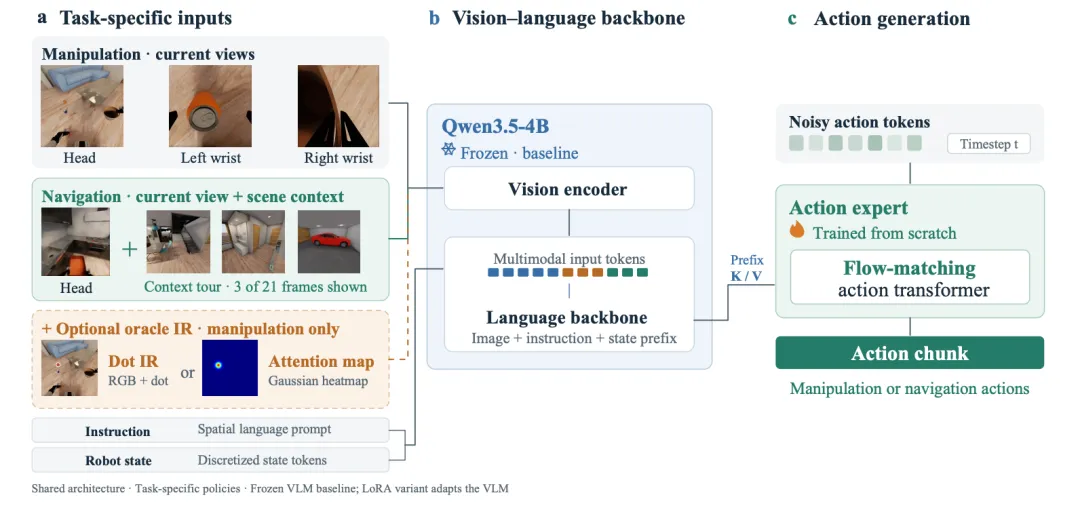
▲图 | BEHAVIOR‑Spatial‑VLA 模型架构。不同任务视图共用 Qwen3.5‑4B 主干网络与流匹配动作专家;仅操纵任务可选用可选的真值目标定位输入©【深蓝具身智能】编译
VLM 空间 VQA:单帧还行,多帧崩
14 个 VLM(5 闭源 + 9 开源)里,单帧最好的是闭源 GPT-6 Astra(82.1%),开源最强 Molmo2-8B 只有 51.8%。
多帧上:好几个开源模型在方向类问题上直接掉到随机猜(25%)以下。而把 VLA 里抽出来的骨干拿去测,普遍更低。
说明通用 VQA 分高,不等于任务级空间感知强。
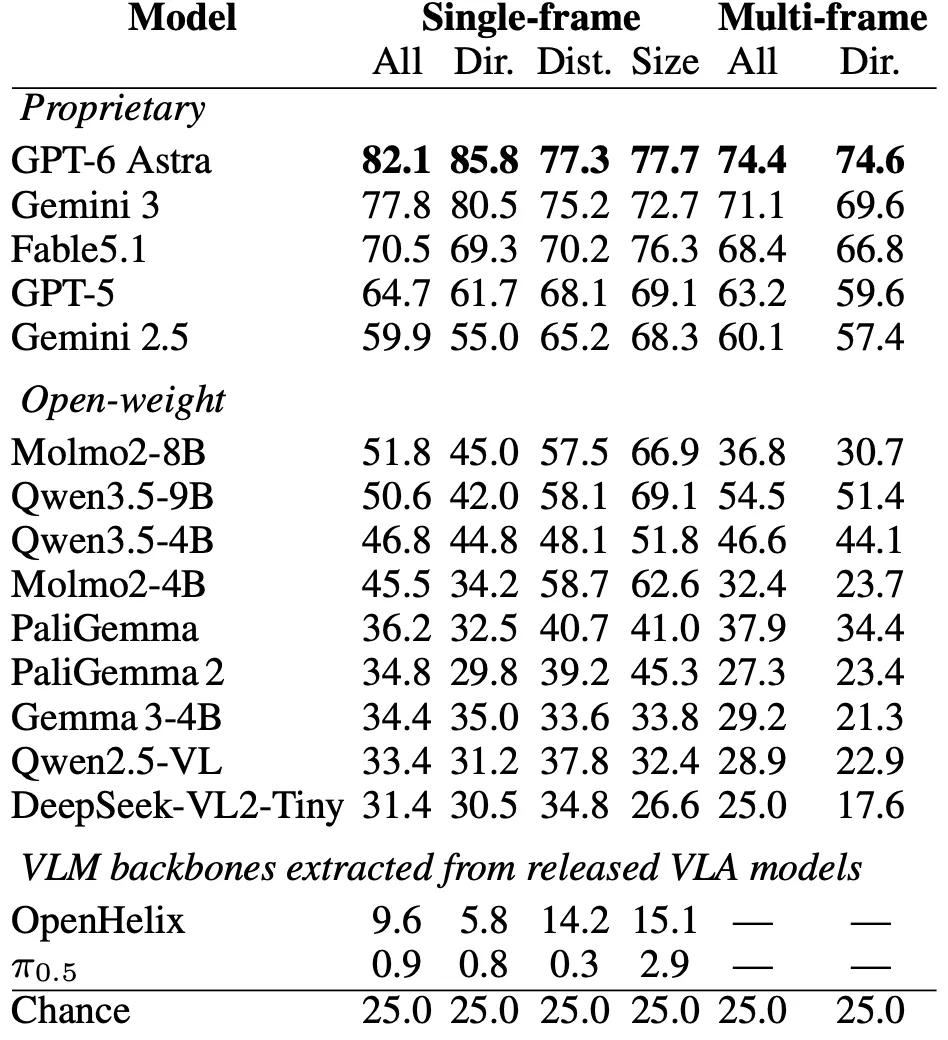
▲表 | 各 VLM 在 BEHAVIOR-Spatial-VQA 上的准确率。单帧方向包含其 locate 子类;All 为所有问题汇总 ©【深蓝具身智能】编译
行动更是重灾区:换句话,成功率腰斩再腰斩
冻结 VLM 基线:留出集软成功率 41.6%、严格 27.9%、错目标率 38.2%;
但 prompt-probe 上软成功只剩 16.1%、严格 10.0%,错目标率飙到 70.0%。
它去够的往往不是新指令要的目标,而是训练时和场景绑定的。"能对没见过布局泛化"和"在熟布局里听话"是两个独立的坑。
前者还能凑合,后者几乎全军覆没。
更关键的是后续两组对照:
LoRA 适配 / DROID 预训练:几乎没用。
prompt-probe 软成功 16.1→17.9%、16.6%,严格成功 9.6%/8.9%,甚至没超基线 10.0%——调骨干救不了"不听指令"的病;
Oracle 目标指向:立竿见影。
点 IR 把留出软成功拉到 60.3%、probe 拉到 38.0%,错目标率从 70% 降到 43.9%。问题不是"不会执行",而是"根本不知道要去哪"——一旦把目标点喂给策略,行为立刻被拽回正轨。
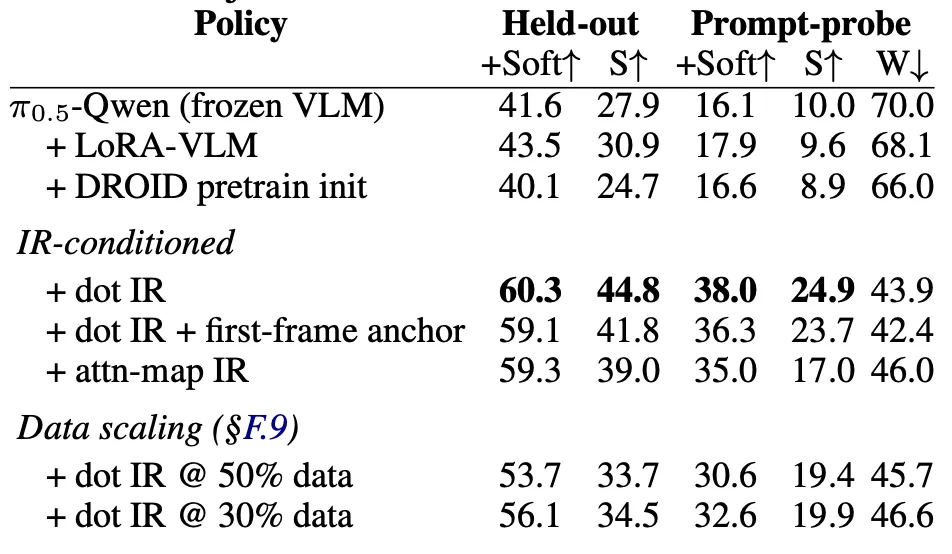
▲表 | 所有策略变体在两个评估集上的成功率。+Soft=软成功率;S=严格成功率;W=提交到非指定对象的片段占比 ©【深蓝具身智能】编译
感知-行动相关性:跟策略挂钩的指标是"生成",不是"回答"
论文用 Spearman 相关量了 VQA/IR 分数和策略成功的关系(表3)。最有信息量的结论:
对最强的两个策略(点 IR 和注意力图 IR),指向准确率比问答准确率更跟成功相关(ρ=0.701 vs 0.560,0.753 vs 0.608)。
也就是说,能真实预测机器人行为的是"VLM 得生成的那个点"(定位),而不是"它得选对的那个选项"(问答)。
这个相关性因策略而异,导航任务里方向类问答准确率和 10 个导航任务的成败几乎不相关(16.7%~40%,弱相关)。VQA 分数解释不了导航成功的差异——场景规模、路线长度、过门这些才更可能是主因。
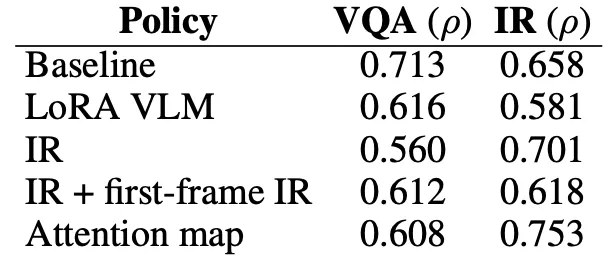
▲表 | 任务级感知-行动相关性。14 个操纵任务上 VQA 或容差 IR 准确率与策略成功率之间的 Spearman 相关系数;并列取平均秩 ©【深蓝具身智能】编译
代码即策略:写完的代码也会"迷路"
用代码即策略的 agent(用语言模型写 Python 控制机器人)也测了。
闭源作者模型软成功率 50–66%,开源作者只有 37–39%;但开源模型 83–87% 的回合是"朝目标动了却始终没做成互动",严格成功率惨到 5.1%/5.3%,而闭源 Gemini/GPT-6/Fable 能到 33–51%。
说明"软成功"只是一个意图代理,离真正完成任务还有一大截——同一个指标,不同 agent 背后的"没做完"比例天差地别。
▲表 | 代码即策略智能体性能。+Soft=软成功率;S=严格成功率;W=提交到非指定对象的片段占比 ©【深蓝具身智能】编译
总结
BEHAVIOR-Spatial 把一句被业界默认成立的话翻出来验了一遍,结果是"VLM 空间能力 → VLA 行为"这条路远没有想象中顺畅。
它给出的信号很明确:其一,换目标就崩是普遍现象,而调骨干(LoRA、DROID)救不了,真正管用的是把目标"指清楚";其二,能预测行为的指标是"定位"而不是"问答",做 VLA 该盯生成的点,而不是刷选择题分。
当然,仿真验证、特权标注、意图代理这些边界也在提醒:这个基准更像个"体检报告",替这个赛道标出了"空间理解到底有没有落地成行动"这个真问题——而答案目前是,还差得远。
相关研究:李飞飞团队新作:首个闭合感知‑行动回路的具身空间智能基准
编辑|小小怪博士
审编|具身君
Ref:
论文标题:BEHAVIOR-Spatial Benchmark: Evaluating Spatial Understanding for Robotics
论文链接:https://arxiv.org/pdf/2610.34051
来源:深蓝具身智能