
机器人领域的每个人都在争论,哪一种数据最终会胜出。
Adam Patni(@adam_patni)于 2026 年 11 月 8 日在 X 上发布。没错,也包括我们。
有些团队押注第一视角视频:人们在进行日常工作时佩戴摄像头。有些团队押注 UMI 式示范:人们使用形状与机器人夹爪相似的手持夹爪完成任务。有些团队押注遥操作:人直接操控机器人。还有人认为,这三种方式都是暂时的,因为部署到真实环境中的机器人很快就能产生超越任何人类采集工作所能获得的经验。
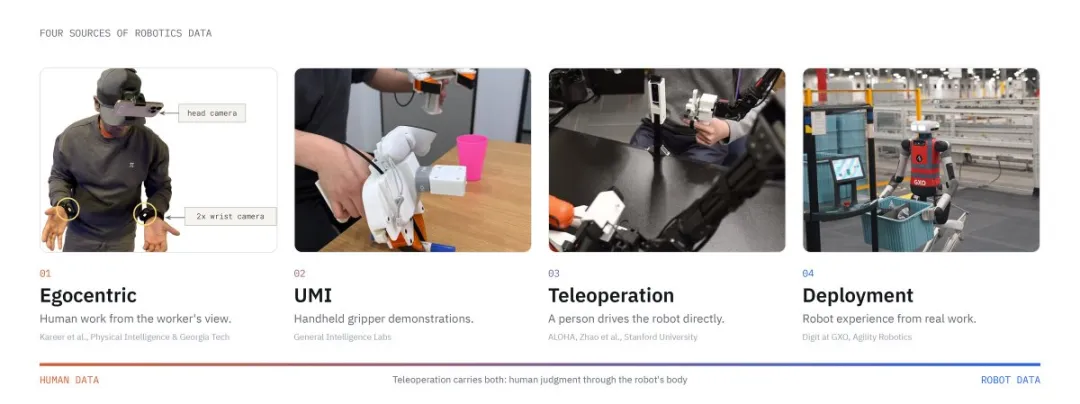
机器人数据的四种来源。第三方图片仅作为示例展示,版权归其所有者所有;这并不意味着其与 GI 有任何关联。
这些争论背后有一个问题:当有足够多的机器人在真实环境中工作时,人类数据是否就会过时?
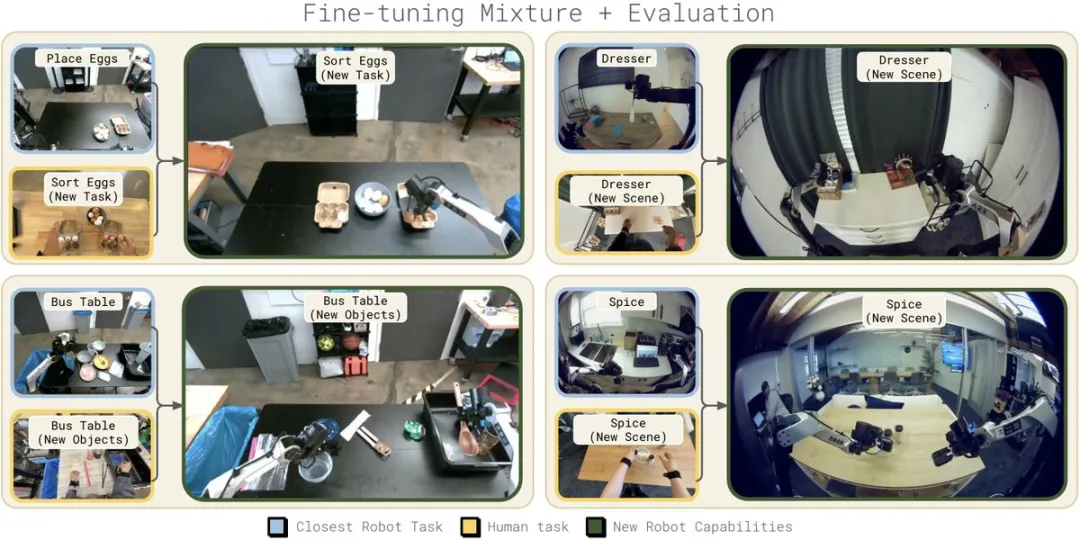
人类示范及用于测试的机器人任务。图片来自 Kareer 等人的研究,Physical Intelligence 与 Georgia Institute of Technology。
我认为答案是否定的。这个问题假设机器人数据只有一个作用:教机器人如何运动。但它还有第二个不会消失的作用:教机器人如何在人身边行动。第二个作用涉及对齐问题,这也是为什么我认为,争论“哪种数据会胜出”并没有问对问题。
两个指向相反方向的类比
支持机器人数据的观点通常会用 Tesla 作类比。一家拥有庞大道路车队的公司,可以从自己实际交付的车辆,以及这些车辆实际行驶的地点中学习。没有其他数据能够像这样,与训练数据最终要应用的部署场景如此契合。
我这里只是把它作为一个类比。这一观点并不依赖于 Tesla 是否纯粹从自动驾驶中学习,也不依赖于自动驾驶是否已经被解决。核心很简单:机器人能从自身经验中,学到关于自身本体的最多知识。
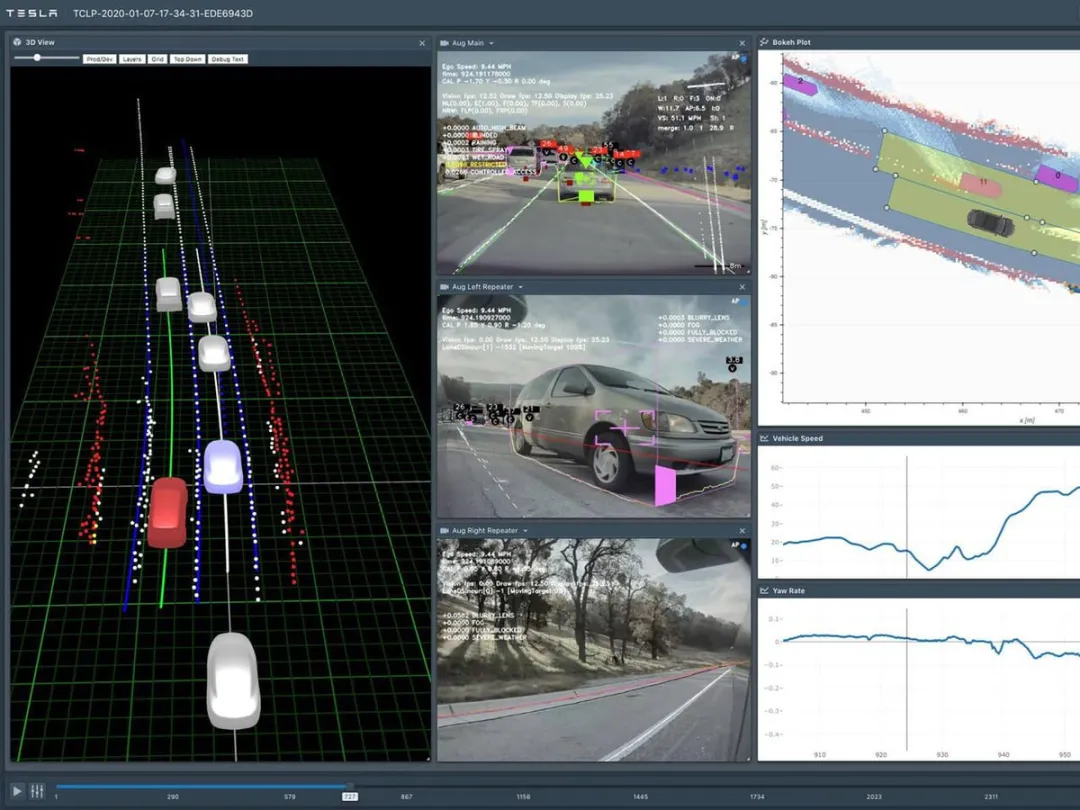
自动驾驶可视化。图片:Tesla AI & Robotics。此处仅作为类比:车队数据可以包含人类驾驶和人工干预,本文也没有声称自动驾驶已经被解决。
支持人类数据的观点则会用 LLM 作类比。语言模型建立在人类写作内容之上,而且在它们具备能力之后,并没有停止对人的需求。OpenAI 的 InstructGPT 工作是一个清晰的例子。基础模型已经具备了相关知识,而真正让它变得有用的,是额外加入的人类示范以及人类对模型输出的排序。这些数据教会模型去做用户真正想要的事情。随着模型不断进步,人类提供的输入变得更有针对性,但并没有消失。
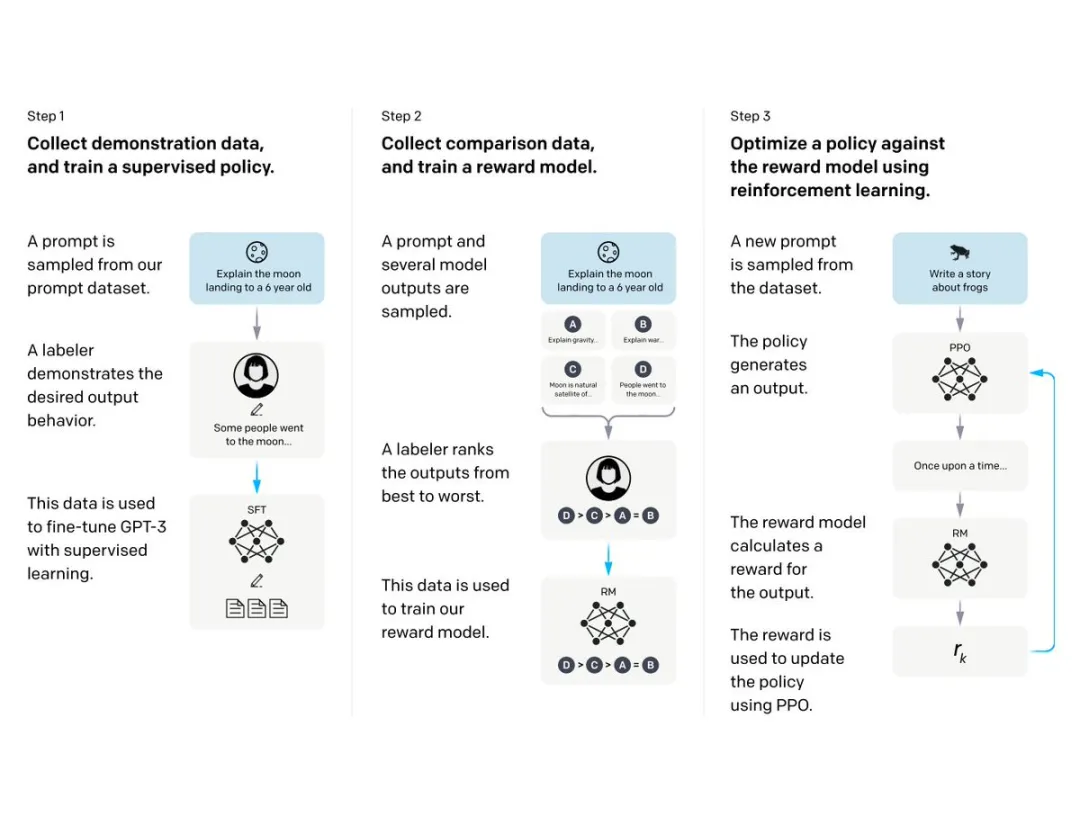
InstructGPT 的训练方式:先使用人类示范,再使用人类排序,接着针对这些排序进行 RL。图片为 Ouyang 等人 2022 年论文中的图 2,OpenAI。这只是一个类比,并不能证明机器人以相同方式学习。
这两个类比都成立,因为它们描述的是不同的事情。Tesla 关乎如何学习本体和环境;InstructGPT 关乎如何学习人的意愿。
每种数据教会模型不同的东西
我们的立场介于这两种观点之间。
机器人经验教会模型关于本体、物理约束和行动结果的知识:这个身体能做什么,以及它尝试这样做时会发生什么。
人类数据教会模型工作是如何完成的、人们如何合作、他们的意图是什么,以及他们偏好什么。
遥操作兼具两者的一部分:人的判断通过机器人的身体表达出来。
人类数据本身也不是单一的。第一视角记录展示了工作自然展开的过程,包括那些没人会想到写进脚本的停顿、目光和交接。一次示范展示了完成特定任务的一种好方法。显式反馈,例如对两种行为进行排序,则表明人们更喜欢哪一种。这是三种不同的信号,模型可以同时利用它们。
这些信号还能相互增强。Physical Intelligence 和 Georgia Tech 的研究人员发现,使用多样化的机器人数据进行预训练,可以提高模型从结构化人类示范中迁移的效果。在这项研究中,更多的机器人数据让人类数据变得更有用。
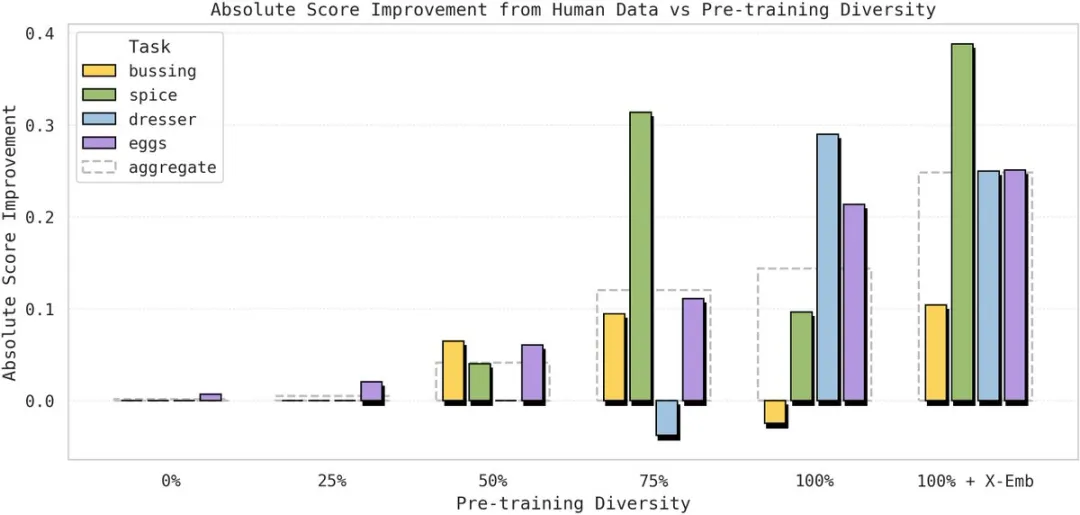
加入人类数据带来的分数提升,以及机器人预训练数据多样性与这一提升之间的关系。图片来自 Kareer 等人的研究,Physical Intelligence 与 Georgia Tech。在这项研究中,机器人预训练数据越多样,人类数据带来的收益越大;结果仅适用于该研究中的任务,并非普遍适用的 Scaling Laws。
即使有十亿台机器人,它们仍然生活在人群中
先来看机器人数据观点最有力的一种表述。想象有十亿台机器人,每一台每天都在记录经验。运动数据不再稀缺。
但这些机器人仍然在人身边工作,工作地点包括厨房、医院、仓库和家庭。它们向人递东西、等待人,也会被人打断。机器人机群可以记录机器人做过的一切,但仅靠这些记录,无法知道机器人身边的人是否希望它以那种方式完成任务。
这个缺口不会随着规模扩大而消失。只有当人们向机器人展示、告诉机器人什么是好的行为时,这个缺口才能被填补。
物理对齐
我把这称为物理对齐(physical alignment)。当机器人的行为符合周围人的意愿,而不仅仅是完成交给它的狭义任务时,这台机器人就实现了物理对齐。
在实践中,这意味着机器人需要学会何时行动、等待、调整、询问、让步或停止。这也意味着机器人需要把选择权和控制权留给人。
完成操作任务只是成功的一部分。下面五个例子可以具体说明其中的区别。
1. 薯片袋
在 UC Berkeley 和 Carnegie Mellon 的实验中,一台机器人能够稳定地拿起一袋薯片。但它经常抓住袋子的中间,这样可能会压碎里面的薯片。从机械操作的角度看,拿取成功了,但它依然没有满足人的意愿。
研究人员利用人类偏好排序,引导机器人抓住袋子的边缘。机器人原本就具备拿取的技能,人提供的是对“怎样才算做得好”的定义。
2. 辅助进食
给一个人喂食需要处理餐具和食物,这本身就已经足够困难。与此同时,机器人还需要知道对方接下来想吃什么、是否准备好吃下一口,以及对方到底希望获得多少帮助。
FLAIR 是由 Cornell、Stanford 和 UBC 研发的一个系统,它在规划进食顺序时,既考虑用户的要求,也考虑食物是否容易夹取。University of Washington 早前针对行动不便人群开展的一项研究发现,机器人拥有更多自主权,并不总是参与者所偏好的。
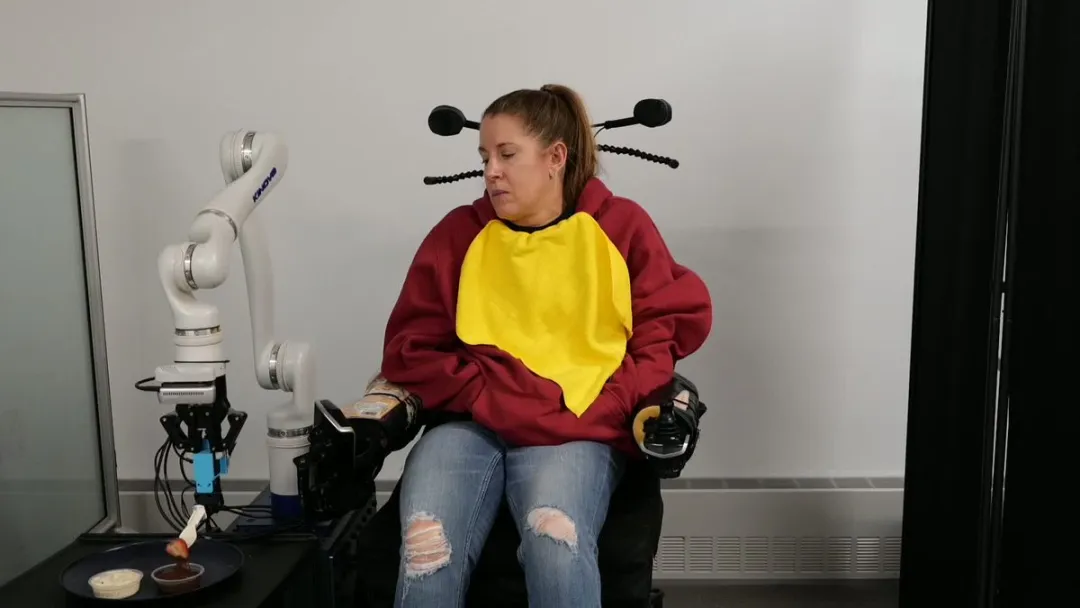
FLAIR 正在为一位接受照护的人辅助进食。图片:FLAIR 项目,Cornell University、Stanford University 与 University of British Columbia。这些辅助进食研究的参与者是行动受限的人群,并非专门针对养老护理。
养老护理是这一经验可能发挥作用的场景之一。但准确地说,这些研究讨论的是为行动受限的人提供辅助进食,而不是针对养老护理开展的研究。
3. 服务员和调酒师
端着一杯饮料而不洒出来,是工作中相对容易的部分。一位优秀的调酒师会注意到谁想点单,以公平的顺序为顾客服务,并在需求不明确时进行确认。
JAMES 项目围绕这一想法开发了一台机器人调酒师。研究人员认为,面向公众提供服务的机器人不仅要完成任务,还必须满足社会交往中的预期,并处理多位顾客同时争取其注意力的情况。
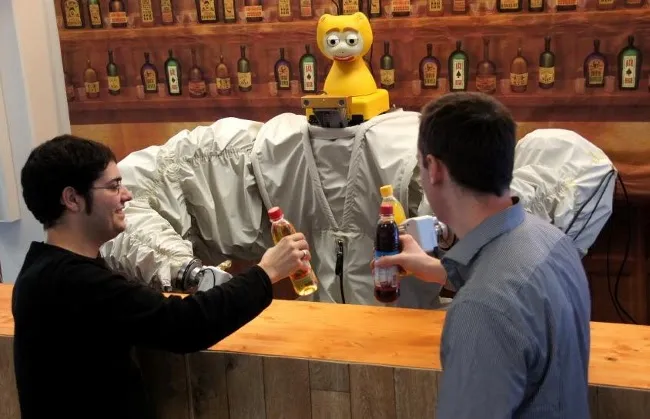
JAMES 机器人调酒师,一个研究原型。图片:JAMES 项目,University of Edinburgh、Heriot-Watt University、Bielefeld University、fortiss 与 FORTH。
4. 导航引导
一位引导者把你带到正确的地方,只完成了一半的工作。另一半是配合你的步速,并在你更希望自己找路时退到一旁。
来自 Carnegie Mellon、Miraikan(日本国家科学博物馆)和 IBM Research Tokyo 的研究人员,在三周时间里跟踪观察了六位使用博物馆导航机器人的盲人或低视力访客。访客始终在选择什么时候跟随机器人、什么时候自己处理,而这些选择会随着情况变化。有些人在拥挤或嘈杂的区域更依赖机器人。
研究人员得出结论:辅助系统应当优先保证灵活性和用户控制权,而不是追求最大程度的自动化。
5. 共同组装
想象两个人一起把一块面板安装到框架上。一个人扶住面板,另一个人对准孔位。扶住面板的人会根据同伴的动作不断做出微小调整。
扮演扶持角色的机器人不能只是把面板保持在正确的高度。它必须配合同伴的动作时机,也不能过早松手。TU Bergakademie Freiberg 和 Arizona State 的研究人员通过记录两个人共同完成任务的过程,教会机器人这种协调能力。
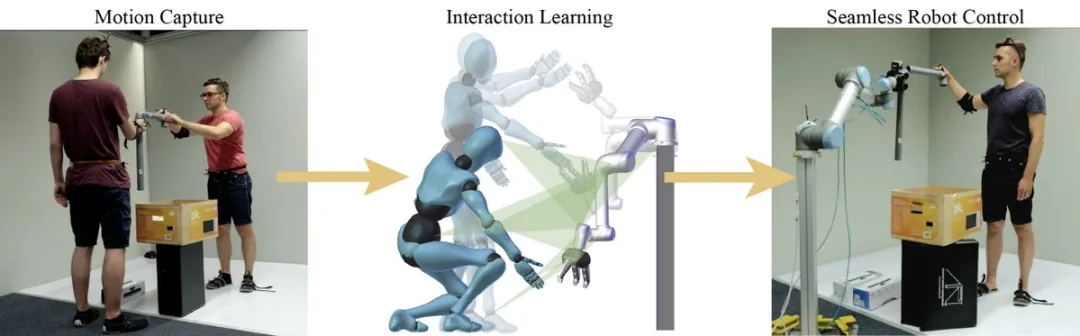
人类示范、交互学习与机器人控制。研究图片:David Vogt。来自 Vogt 等人在 ICRA 2017 发表的研究,TU Bergakademie Freiberg 与 Arizona State University。图中展示的是受控研究案例。
在这五个例子中,运动都是必要的,但仅有运动还不够。缺少的是关于人的信息,而这些信息必须由人提供。
证据说明了什么,又没有说明什么
这些研究说明了我们的观点,但它们并不能证明人类数据会永远不可或缺。其中大多数是受控实验,也没有任何一项研究对大规模机器人机群进行测量。
人类数据将持续发挥作用,是我们提出的一个判断。我希望明确将它表述为一个观点:只要机器人与人共享空间,它们需要学习的某些东西就只能由人提供。我们正基于这一判断构建 GI。
这对数据采集意味着什么
如果机器人数据是一个对齐问题,那么采集小时数就不是合适的衡量指标。更好的问题是:数据是否改善了机器人的行为,包括机器人在人身边时的行为。
这正是我们在 General Intelligence Labs 所做的工作。我们提供第一视角数据、UMI 数据和触觉数据,以及记录这些数据的采集设备。我们完全自主进行硬件研发和制造,因此能够控制采集哪些内容以及采集质量。
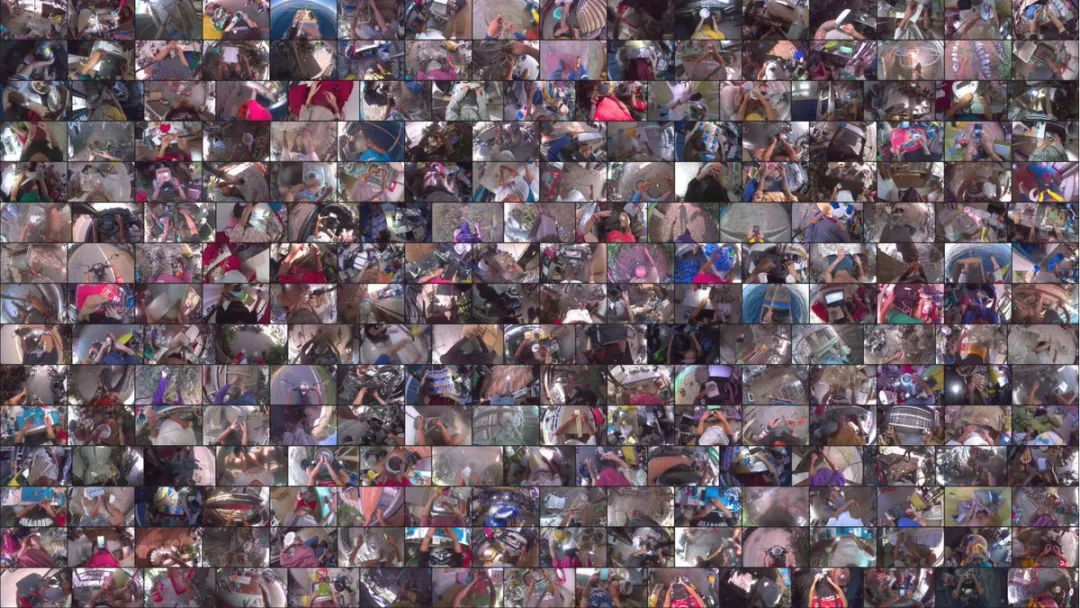
上:GI 在真实世界中采集的第一视角数据帧。
下:GI 的采集设备,包括 EGO2 系列头戴设备、腕部相机、UMI 和触觉手套。
我们不认为会有某一种模态胜出。机器人经验、遥操作、示范、第一视角视频和人类反馈各自提供不同的信号。做得最好的团队将知道自己缺少哪一种信号,然后去采集它。
机器人会从多种来源学习如何运动。只有当我们向它们展示如何与我们协作时,它们才能学会这样做。
来源:human five