
6篇获奖论文,看技术演进趋势。
——全球科研风向
CoRL 2026 于当地时间 11 月 9 日至 11 日在美国得克萨斯州奥斯汀举行。
CoRL 的论文奖只有两个:最佳论文(Best Conference Paper Award)与最佳学生论文(Best Student Paper Award),另外设杰出领域主席与杰出审稿人表彰。今年进入最终候选池的是 6 篇,两个大奖在 11 月 11 日的 Awards & Farewell 上揭晓。
我们围绕本届全部 6 篇入围论文做了一次盘点:2 篇获奖、4 篇入围,覆盖人形全身控制、长上下文策略、灵巧装配预训练、世界模型造数据、多物体重排规划,以及一次对基准本身的审计。
欢迎关注【深蓝AI】 将持续分享人工智能领域前沿动态👇深蓝AI1—最佳论文奖🏆 CoRL 2026 Best Conference Paper Award
SuperMimic:用一个可微世界模型扩展人形机器人全身控制
关键词:可微世界模型、共享动力学、BPTT 想象推演、训练成本摊销
发文团队:加州大学伯克利分校(Qiayuan Liao, Yiyang Shao, Junfeng Long, Kevin Zakka, Roberto Horowitz, Pieter Abbeel, Koushil Sreenath)
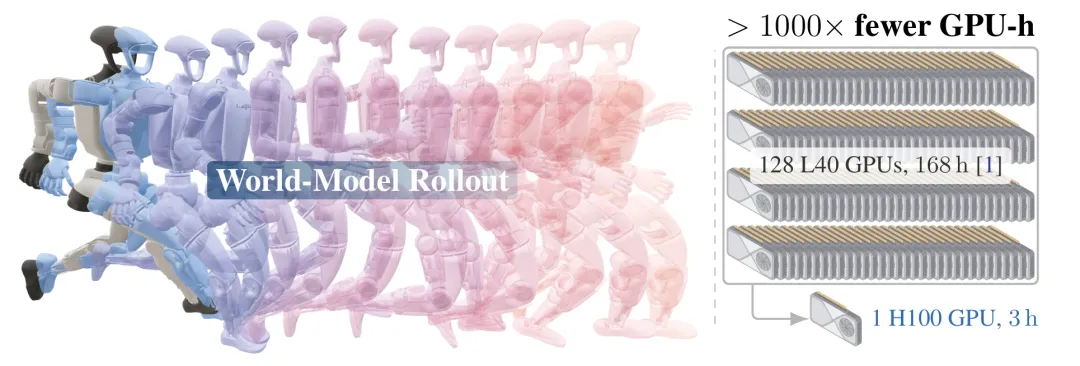
研究内容:人形机器人全身动作追踪依赖大规模强化学习训练,如SONIC需约2.1万GPU小时。SuperMimic提出用与动作无关的可微世界模型替代物理仿真器。它从仿真日志中拟合共享刚体动力学,让策略在模型内做短时程“想象推演”,利用解析梯度更新,绕开了仿真器不可微的难题。在12.9万条动作基准上,单卡3小时即超越SONIC集群模型,失败动作从179降至25,算力骤降超千倍。策略直接部署宇树G1,完成高难度翻滚与跳跃动作。
论文链接: https://arxiv.org/abs/2610.28480
项目链接:https://supermimic.github.io/
深蓝AI2—最佳学生论文奖🏆 CoRL 2026 Best Student Paper Award
RoboTTT:机器人策略的上下文扩展
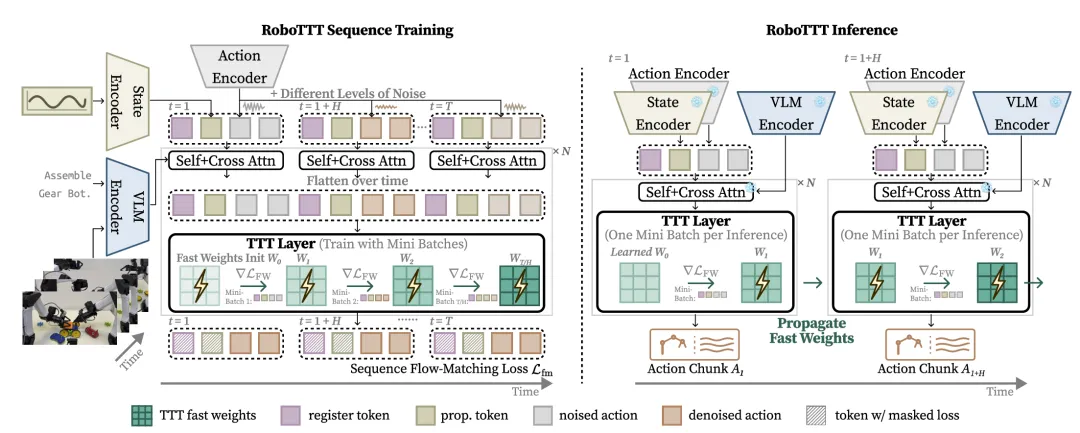
关键词:测试时训练、快权重、截断反传、序列动作强制
发文团队:英伟达 / 斯坦福大学 / 得克萨斯大学奥斯汀分校(Yunfan Jiang, Yevgen Chebotar, Ruijie Zheng, Fengyuan Hu, Yunhao Ge, Jimmy Wu, Tianyuan Dai, Scott Reed, Li Fei-Fei, Yuke Zhu, Linxi ,Jim Fan)
研究内容:机器人策略受限于KV cache导致的推理延迟与RNN的容量瓶颈,难以处理长上下文。RoboTTT将记忆存放在参数中:引入“快权重”与测试时训练(TTT),每步通过内层梯度更新将历史写进参数。工程上结合序列动作强制与截断反传,成功训练8000步上下文。在真机装配任务中,完成分达79%(单步基线42%)。它还支持把人类视频作一次性模仿,或将失败轨迹作上下文、纠正作目标进行蒸馏,100条轨迹利用率是标准DAgger的三倍。
论文链接: https://arxiv.org/abs/2607.15275
两篇最佳论文解读可详见CoRL 2026双料最佳论文|单卡3小时击败128卡7天,把算力成本打下来了!
以下为最佳论文入围奖深蓝AI3—灵巧手插不准,是不是因为它没先学会“玩”?Play2Perfect:精密装配的灵巧预训练里,什么才是真正起作用的?
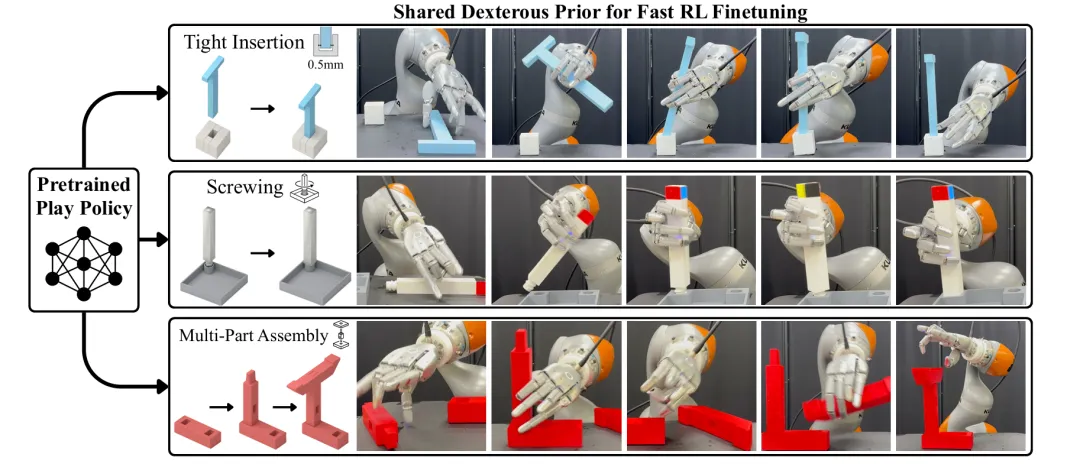
关键词:手内重定向、任务无关预训练、稀疏奖励、零样本 sim-to-real
发文团队:斯坦福大学(Tyler Ga Wei Lum, Kushal Kedia, C. Karen Liu, Jeannette Bohg)
研究内容:精密装配属接触密集任务,稀疏奖励让强化学习极难探索,传统方法多依赖专用夹爪或结构化环境。Play2Perfect提出“先玩后装”的预训练框架:先通过任务无关的强化学习,让多指手在多样物体上练习抓取与手内重定向,建立通用操作先验;再在装配任务上微调。研究表明,该先验比从零训练的强化学习样本效率高33倍。在零样本sim-to-real中,针对接触间隙仅0.5毫米的紧配合插接,实现了60%的成功率。
论文链接:https://arxiv.org/abs/2606.26428
项目链接:https://play2perfect.github.io/
深蓝AI4—人形机器人的训练数据,能不能全部在虚拟世界里长出来?GRAIL:从世界模型生成人形移动操作
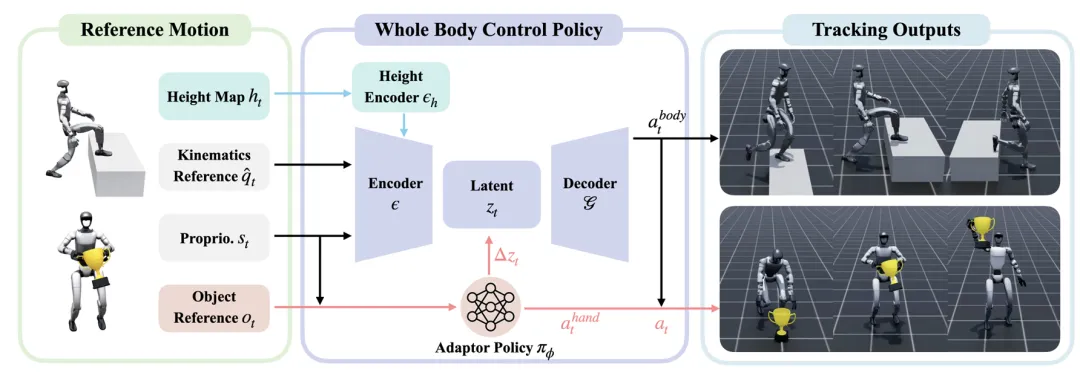
关键词:视频世界模型、4D 交互重建、动作重定向、场景感知跟踪器
发文团队:英伟达 / 加州大学洛杉矶分校(Tianyi Xie, Haotian Zhang, Jinhyung Park, Zi Wang, … Chenfanfu Jiang, Sanja Fidler, Jan Kautz, Linxi ,Jim Fan, Yuke Zhu, Zhengyi Luo, Umar Iqbal, Ye Yuan)
研究内容:人形移动操作数据严重依赖物理采集,遥操作与动捕难以规模化。GRAIL构建了一条完全在虚拟世界中生成数据的流水线。它从已知的三维配置出发,利用视频生成模型恢复具备米制尺度与物理交互的4D人机轨迹,再通过动作重定向训练出具备物体感知与场景通行能力的通用跟踪器。目前已生成超35000段经物理校验的素材库,并在真机上成功展示了桌面取物、越障行走与上楼梯等能力,为数据规模化提供新路径。
论文链接:https://arxiv.org/abs/2606.05160
深蓝AI5—先放哪个物体,决定了后面还能怎么放——这个顺序能学出来吗?DISCO:在连续动作空间上做蒸馏树搜索的长程多物体重排
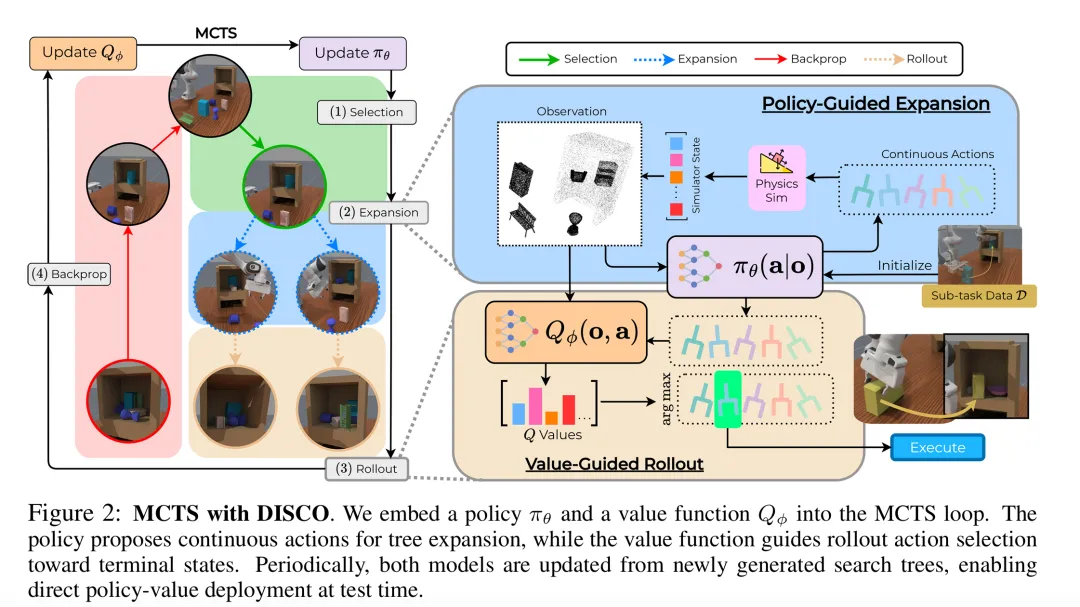
关键词:渐进加宽 MCTS、策略—价值模型、GPU 并行仿真
发文团队:卡内基梅隆大学 / 斯坦福大学(Kallol Saha, Yining Hong, Amber Li, Yejin Choi, Maxim Likhachev, David Held)
研究内容:长程多物体重排难在连续动作空间下同时兼顾误差累积与全局可行性。DISCO提出让搜索与策略相互促进:在物理仿真中利用渐进加宽的蒙特卡洛树搜索(MCTS)生成长期方案,由学到的策略提出连续动作,价值函数评估进度;借助GPU并行,周期性将MCTS方案蒸馏回策略-价值模型。收敛后,策略模型可脱离搜索直接部署,节省在线算力。在仿真与真机桌面收纳任务中,它显著优于行为克隆基线。
论文链接:https://arxiv.org/abs/2610.25785
项目链接:https://distilled-search.github.io/
深蓝AI6—一个没有语言编码器的小模型,为什么能在 LIBERO 上摸到最高分?我们在机器人操作(任务)中,到底在评什么?
关键词:基准审计、捷径可解性、统计显著性、渐进过拟合、数据来源依赖
发文团队:芝加哥丰田技术学院 / 芝加哥大学 / 阿贡国家实验室(Tianchong Jiang, Xiangshan Tan, Samuel Wheeler, Luzhe Sun, Tewodros W. Ayalew, Matthew Walter)
研究内容:主流机器人操作基准(如LIBERO、CALVIN)被广泛用于验证模型,但缺乏对其有效性的审视。该研究对基准进行了系统审计:发现9000万参数探针无需理解指令即可逼近LIBERO的SOTA(捷径可解性);多数基准未报告方差,缺乏统计显著性;且在分布内的轻微扰动就会导致模型性能大幅下降(渐进过拟合)。这些发现指出,高分可能并非源于真实泛化,从而引发了对“评测到底在测什么”的深刻反思。
论文链接:https://arxiv.org/abs/2606.04233
项目链接:https://ripl.github.io/manipulation_benchmark_audit/
来源:深蓝具身智能