
概要:我们在公开 Benchmark 和自行采集的头戴相机工作视频上,测试了四个开源 3D 手部追踪模型:WiLoR、HaWoR、EgoForce 和 Dyn-HaMR。它们在 Benchmark 上表现出色,但在真实工作场景中反复出现几类相同的失误:弱光下左右手混淆,运动模糊下手部消失或被凭空补出,部分遮挡的手被漏掉,脚和前臂被识别成手,以及深度估计不符合物理现实。这些失误大多始于手部检测,这也是我们正在构建自己的检测器的原因。
如果希望机器人向人类学习,手就是数据。基于第一人称视频训练的策略需要逐帧知道每只手的各个关节在哪里,以及哪只是左手、哪只是右手。一旦左右手混淆,就会教机器人使用错误的手臂。
四个近期的开源模型是自然的起点:WiLoR、HaWoR、EgoForce 和 Dyn-HaMR。我们先考察了这四个模型在知名 Benchmark 上的表现,再不作任何修改地将它们用于我们自行采集的工作视频。简单来说:它们在 Benchmark 视频上表现出色,但在我们的视频中会失效,而且反复失效于相同的几种情况:弱光、快速运动和模糊、遮挡、杂乱场景,以及不可能正确的深度估计。
问题:看似已经解决的手部追踪,在真实工作场景中失效
在 Benchmark 视频中,手部追踪看似已经解决
Meta 的 HOT3D 在动作捕捉实验室中录制。Lightwheel 的 EgoStandard 展示了人们在桌边组装和操作物体。两者光照都很充足,视野宽阔,手部大多数时候都处于画面之内。
这些模型在此类场景中表现良好。对于检测到的手,HaWoR 正确标注左右手的比例为 99.9% 至 100%,每只手的形状误差中位数仅为 6 至 11 毫米。Dyn-HaMR 在 EgoStandard 上的误差为 4 至 8 毫米,在我们运行的五段视频中从未混淆左右手。EgoForce 和 WiLoR 在各自的 Benchmark 上报告了当前最优结果。
在受控条件下拍摄的视频中,数据表现非常出色。手部形状误差是指在对齐位置、旋转和尺度后,预测关节与真实关节之间的距离。HaWoR 和 Dyn-HaMR 使用不同的 EgoStandard 视频片段进行评估,因此它们的数据不能直接比较。
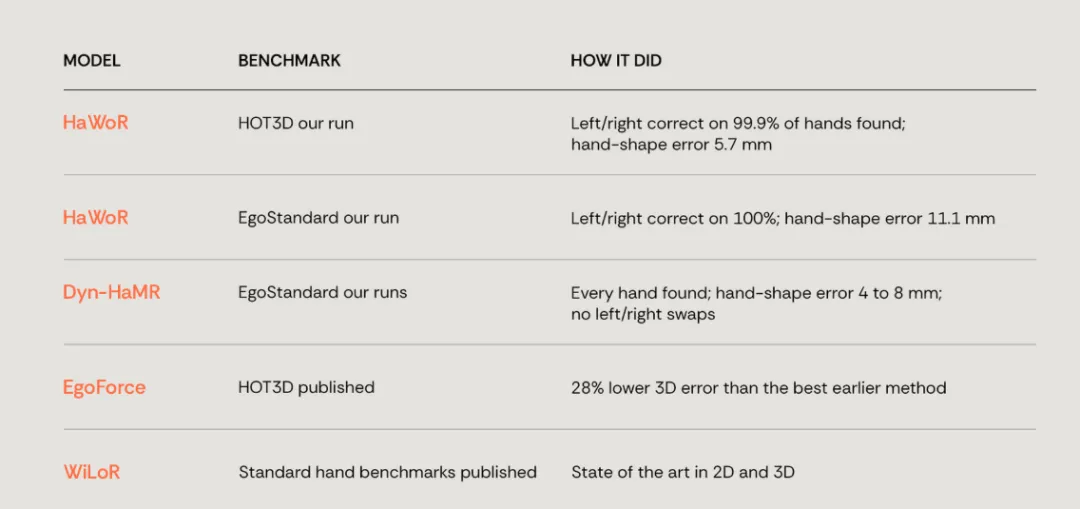
表 1. 在受控条件下拍摄的视频中,数据表现非常出色。手部形状误差是指在对齐位置、旋转和尺度后,预测关节与真实关节之间的距离。HaWoR 和 Dyn-HaMR 使用不同的 EgoStandard 视频片段进行评估,因此它们的数据不能直接比较。
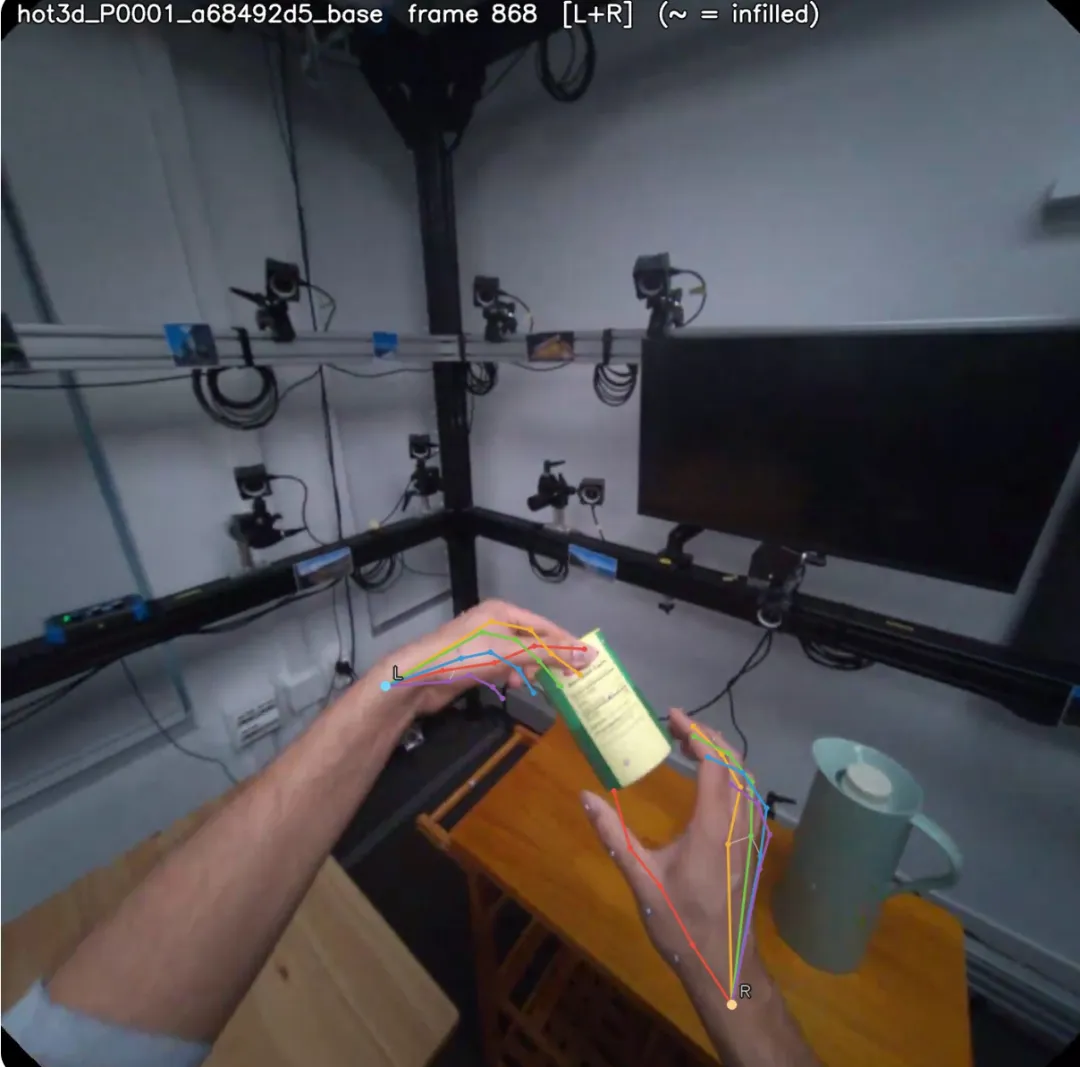
图 1. HaWoR 在 HOT3D 上的表现:在明亮、整洁的动作捕捉实验室中,双手均被检测到并正确标注。来源:HOT3D(Meta),序列 P0001_a68492d5,CC BY-SA 4.0;鱼眼图像经过去畸变并旋转至正向,模型输出叠加在图像上。
在真实工作视频中,手部追踪会失效
我们的视频来自佩戴头戴式双目相机的人们,他们从事的都是日常工作:在家里的厨房洗碗、给仓库补货、在建筑工地刮除填缝材料,以及用吹叶机清理落叶。没有人会为了相机放慢动作。光线时明时暗,手部会变得模糊、滑到画面边缘或消失在箱子里,而脚和工具也会同时出现在画面中。
我们在没有重新训练的情况下,将同样四个模型用于这些视频。同样的几类失误反复出现,每个模型都至少出现了其中两类。
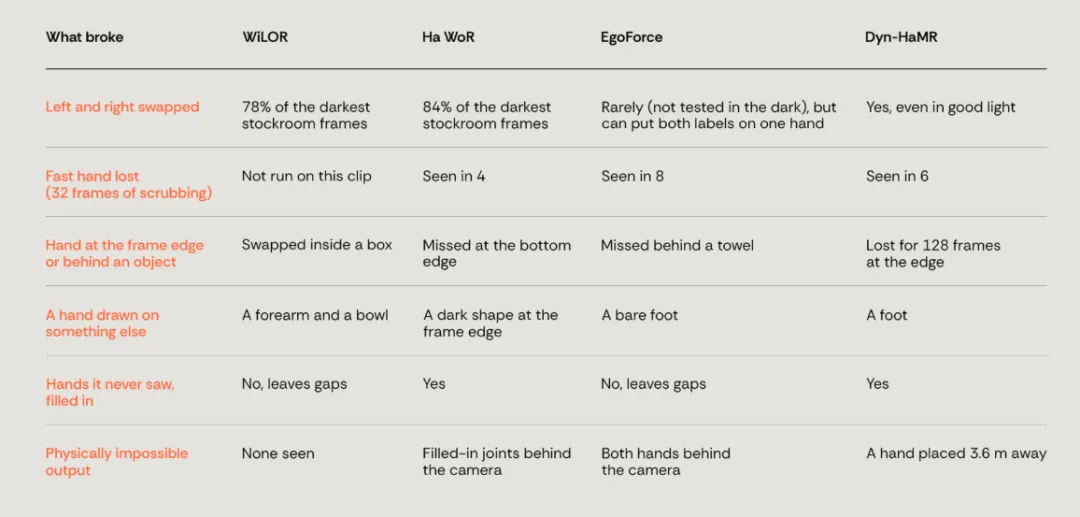
表 2. 模型在我们的视频中出现的问题。百分比以模型检测到双手的帧为统计对象。EgoForce 和 Dyn-HaMR 没有在仓库视频片段上运行,WiLoR 没有在洗碗视频片段上运行。
下面展示每类失误在我们的视频中是什么样的。我们将在后文解释它们发生的原因。
弱光:左手变成右手
最明显的失误出现在仓库里:一名工作人员把手伸进昏暗的纸箱。该视频片段中,超过四分之一的帧比两个 Benchmark 视频片段中的任何一帧都要暗。在最暗的帧中,以检测到双手的帧为统计对象,HaWoR 在 84% 的帧中混淆了左右手,WiLoR 的比例为 78%。WiLoR 还在其中近四成的帧中完全没有检测到手。在同一视频片段的明亮帧中,两个模型几乎从未出错。
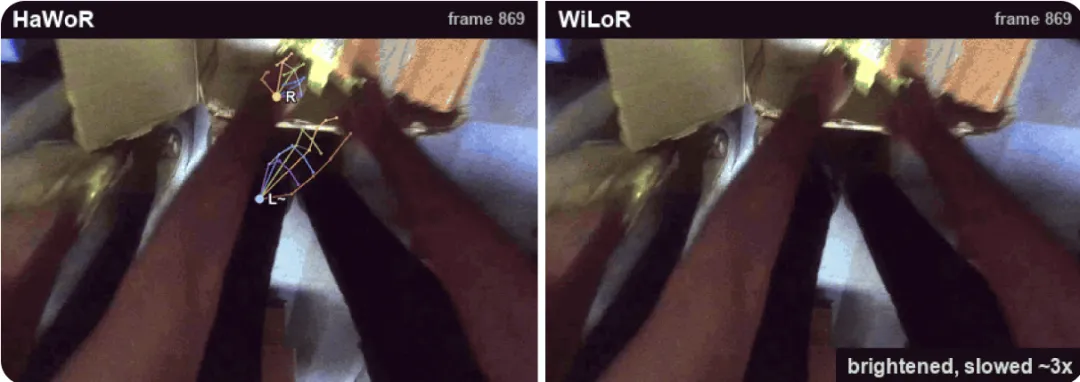
序列 1. HaWoR(左)和 WiLoR(右)在仓库场景中的表现,画面经过提亮和慢放。双臂从未交叉,但标签发生了交换。
快速运动和模糊:手部消失,或被凭空补出
在家用厨房中,佩戴者的右手在毛巾下快速擦洗盘子,速度快到产生模糊。在擦洗过程的 32 帧中,HaWoR 检测到手的帧数为 4,EgoForce 为 8,Dyn-HaMR 为 6。
在其余帧中发生的情况因模型而异。EgoForce 不会填补缺失片段,WiLoR 也不会,因此它们大多直接漏掉这只手。HaWoR 和 Dyn-HaMR 则根据前后的运动估计出一只手,填补缺失片段。它看起来像一只手,运动起来也像一只手,但在这里,它飘在微波炉上方。
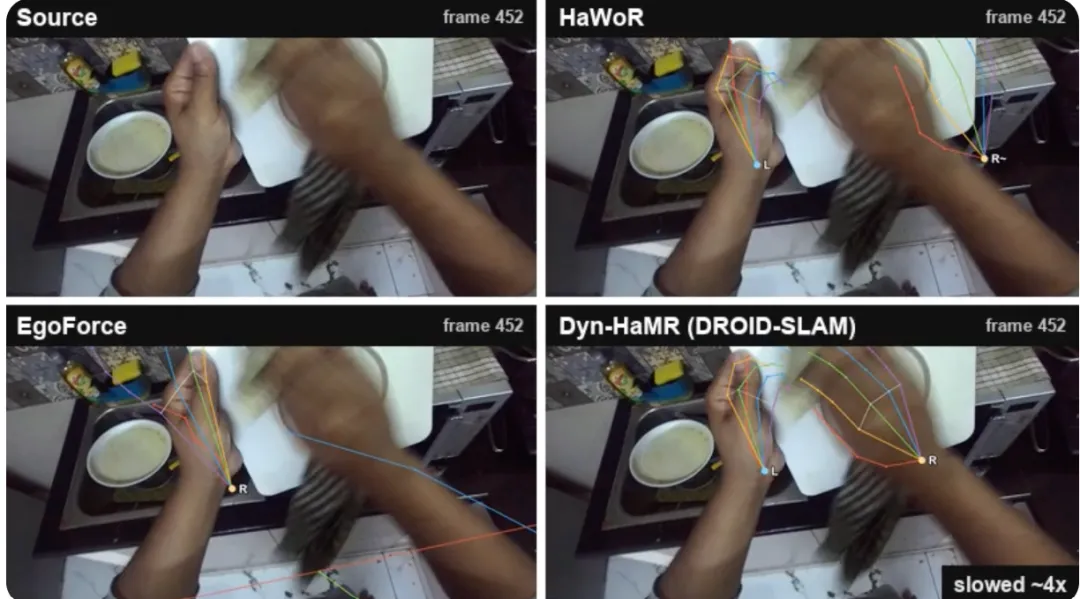
序列 2. 洗碗过程中的同一时刻,画面经过慢放:原始画面(左上)、HaWoR、EgoForce 和 Dyn-HaMR。“R~”表示模型补出而非实际检测到的右手。EgoForce 面板中散乱的线条来自被放置在相机后方的手。
手不一定要运动,图像才会模糊。当佩戴者快速转头时,整个画面都会模糊。在洗碗视频片段中,快速转头期间,HaWoR 平均每帧检测到约一只手;而头部几乎静止时,平均每帧检测到超过 1.5 只手。在另一段厨房视频中,HaWoR 补出的左手在转头过程中落到了佩戴者的脚上。
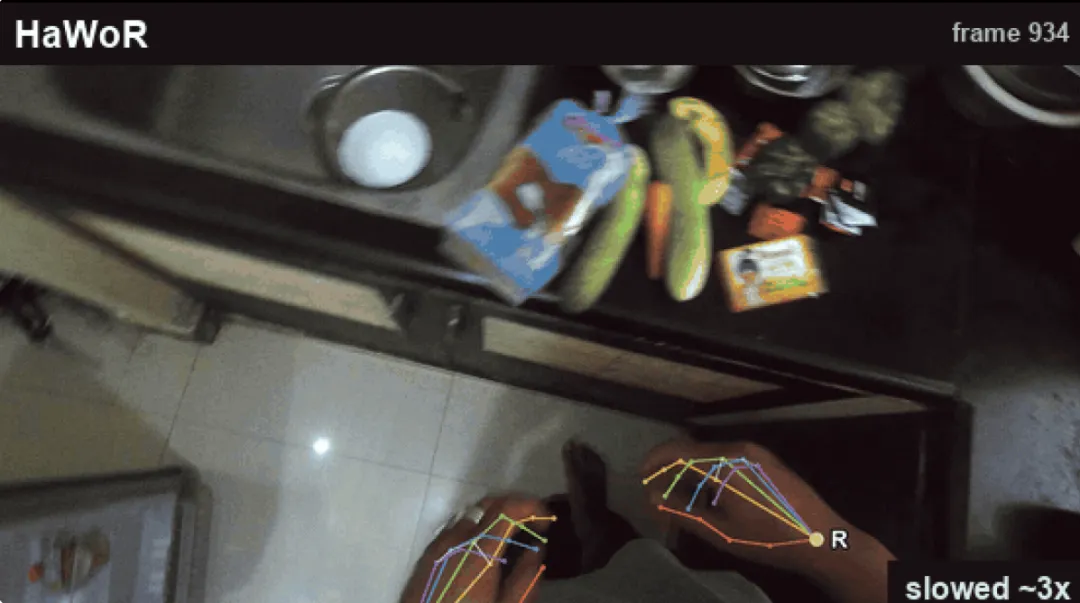
序列 3. HaWoR 在快速转头过程中的表现,画面经过慢放。画面变得模糊,左手丢失,补出的左手(L~)落在了佩戴者的脚上。
遮挡和画面边缘:只露出半只手,就等于没有手
在真实场景中,手有很多时候处于部分遮挡状态:伸进箱子里,被毛巾或盘子挡住,或者有一半处于画面之外。当执行操作的手在画面右上方被毛巾遮挡时,EgoForce 没有输出这只手,而 HaWoR 仍能检测到它。在使用吹叶机的工作人员的视频中,空着的左手在画面底部边缘时隐时现,但 Dyn-HaMR 在全部 1,795 帧中都没有输出这只手。当双手都深入箱子时,WiLoR 混淆了左右手。而对于刮除填缝材料的工作人员平撑在画面底部边缘地面上的右手,HaWoR 只在四分之一的帧中检测到了它。
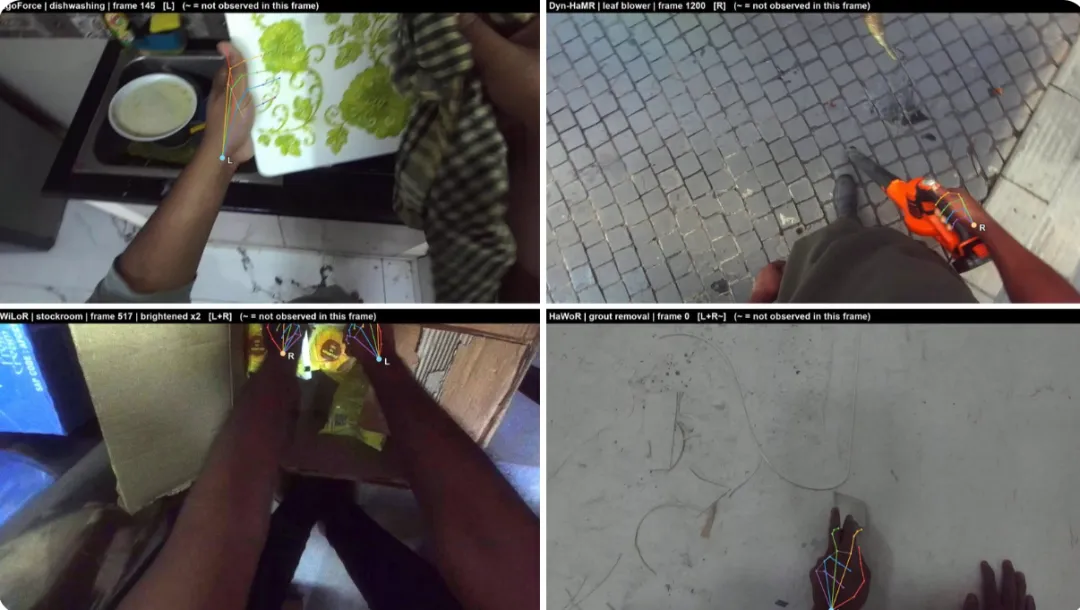
图 2. 部分遮挡的手。左上:EgoForce 漏掉了毛巾后面的右手。右上:Dyn-HaMR 漏掉了画面底部边缘使用吹叶机的工作人员的左手。左下:WiLoR 混淆了箱子里的双手,画面经过提亮。右下:HaWoR 漏掉了画面右下边缘的右手。
丢失一只手只是问题的一部分。当擦洗的手移动到画面右边缘时,Dyn-HaMR 连续 128 帧丢失了这只手,同时将左手标签跳转到了右手上。
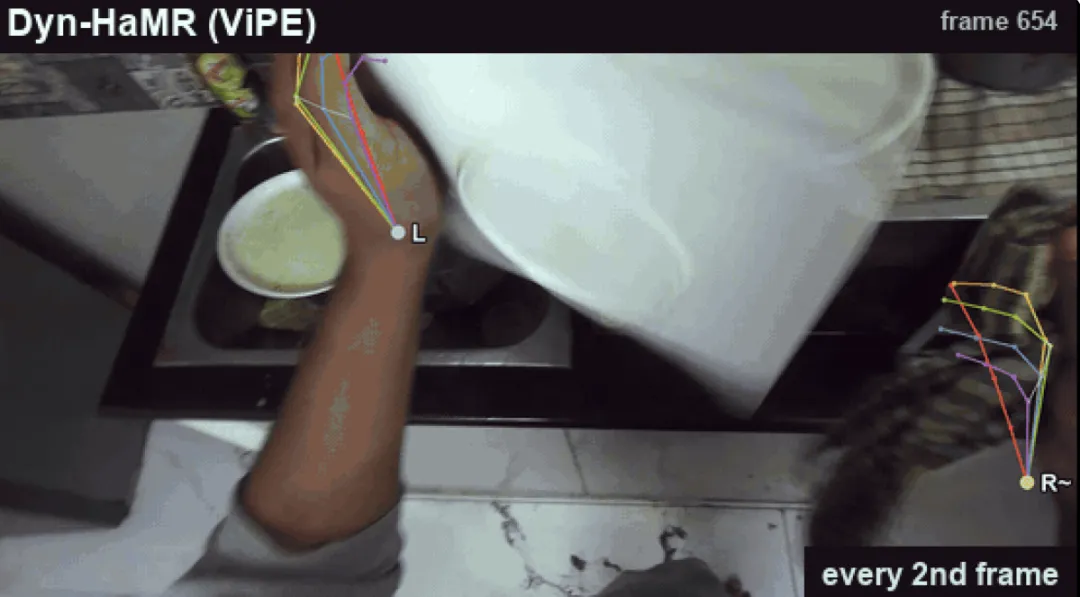
序列 4. 当擦洗的手移动到画面右边缘时,Dyn-HaMR 的表现。补出的右手(R~)逐渐移出画面,而左手标签(L)移动到了右手上。
杂乱场景:脚、前臂和地面变成了手
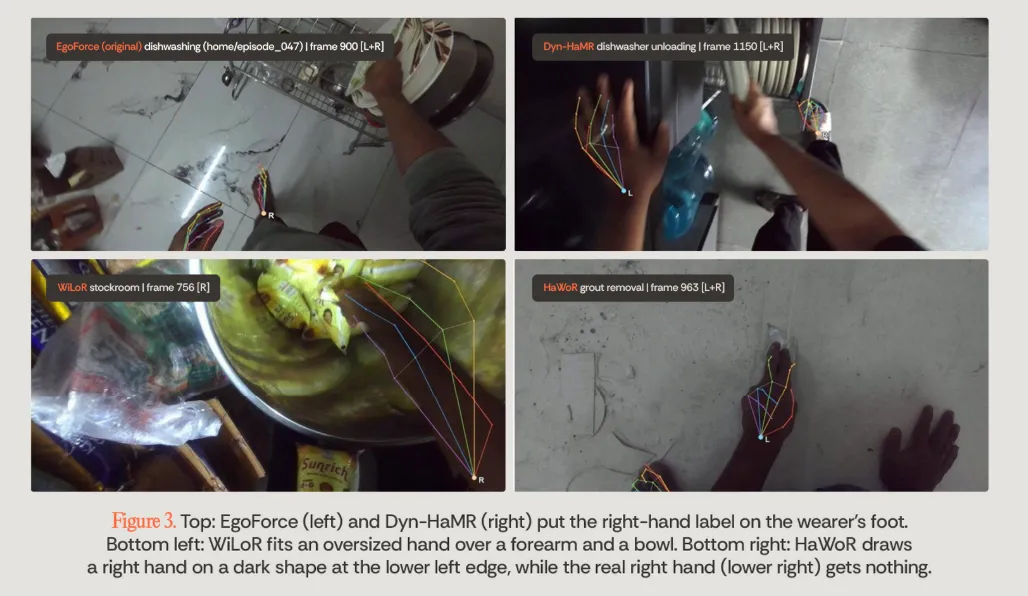
头戴相机向下拍摄佩戴者自己的身体。脚、腿和前臂与双手同时出现在画面中,从上方看,它们可能与手非常相似。每个模型都曾在某个时刻把手画在并非手的东西上:EgoForce 和 Dyn-HaMR 将手画在佩戴者的脚上,WiLoR 将手画在前臂和碗上,HaWoR 将手画在画面底部边缘的一个深色形状上。
不可能正确的深度估计
当佩戴者低头看向碗碟架时,EgoForce 将双手放到了相机后方,持续约 1.5 秒。在整个洗碗视频片段中,EgoForce 的输出有 12% 具有真实手部不可能达到的深度。Dyn-HaMR 即使在正确估计了相机参数的视频片段中,也将一只手放在距离佩戴者头部 3.6 米的位置,而另一只手距离头部只有半米。即使是 HaWoR 补出的手也存在问题:在刮除填缝材料的视频片段中,31% 的补出手至少有一个关节位于相机后方。
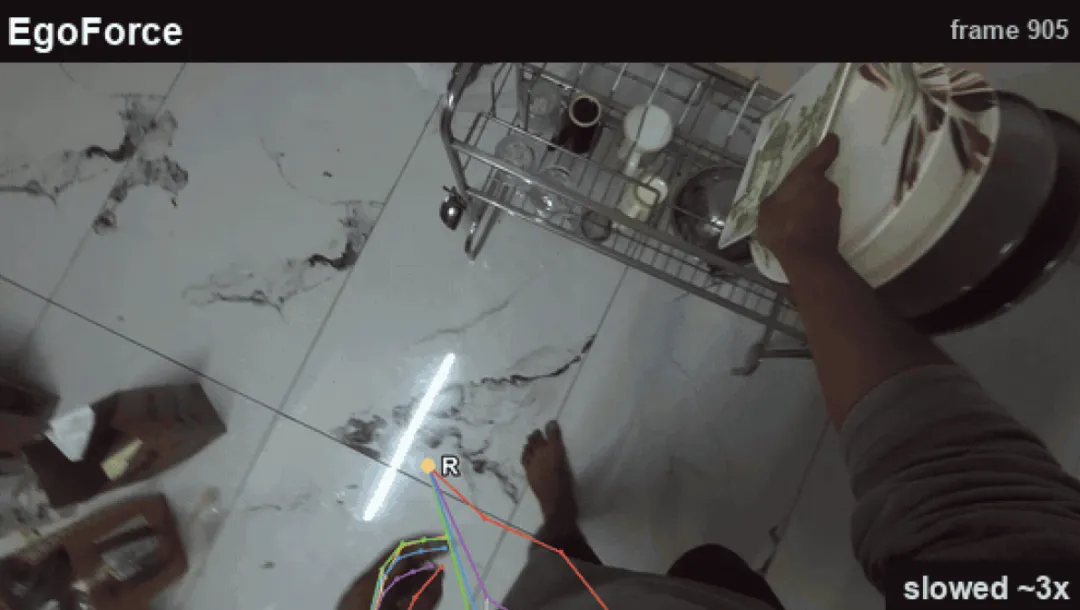
序列 5. 佩戴者低头看向碗碟架时 EgoForce 的表现,画面经过慢放。双手的关节都落在相机后方,因此骨架线条散落在地板上。
为什么这很重要:错误的手部数据会教给机器人错误的知识
基于第一人称视频训练的机器人策略,会逐帧从每只手的各个关节位置以及左右手身份中学习。上述每一种失误都会转化为错误的学习信号:
标签交换会教错手臂。如果左右手混淆,机器人就会学到使用错误的手臂去伸手。在昏暗的仓库中,这种情况最多发生在模型检测到双手的 84% 的帧中。
补出的手是一种看似确定的猜测。HaWoR 和 Dyn-HaMR 用看起来和运动起来都像真实手部的结果填补缺失片段,因此即使这些手飘在微波炉上方或落在佩戴者的脚上,也可能被当成真实数据。
画在错误物体上的手意味着一次从未发生的抓取。拟合到脚、前臂或碗上的手,记录的是一个没有人做过的动作。
不可能的深度意味着不可能的运动。一只距离佩戴者头部 3.6 米的手,或者关节位于相机后方的手,描述的是任何手臂都无法完成的运动。
这些并非边缘情况。真实工作会让多种困难条件同时出现:仓库视频片段同时具有昏暗、快速运动和场景杂乱的问题。
更糟的是,常见的质量检查会漏掉其中大部分问题。对齐检查将每只 3D 手与由这只手本身计算得到的 2D 关节进行比较,因此默认就能通过;而覆盖率统计会将补出的手也算作已检测到的手。如果仅根据这两个指标筛选数据集,本文中几乎所有失误都会被保留下来。
原因:Benchmark 遗漏的困难条件
模型本身没有坏,困难的是实际条件
在我们的视频中,当双手静止、光线良好且没有遮挡时,四个模型都能正确追踪。因此,失误来自实际条件,而不是相机故障或佩戴相机的人。
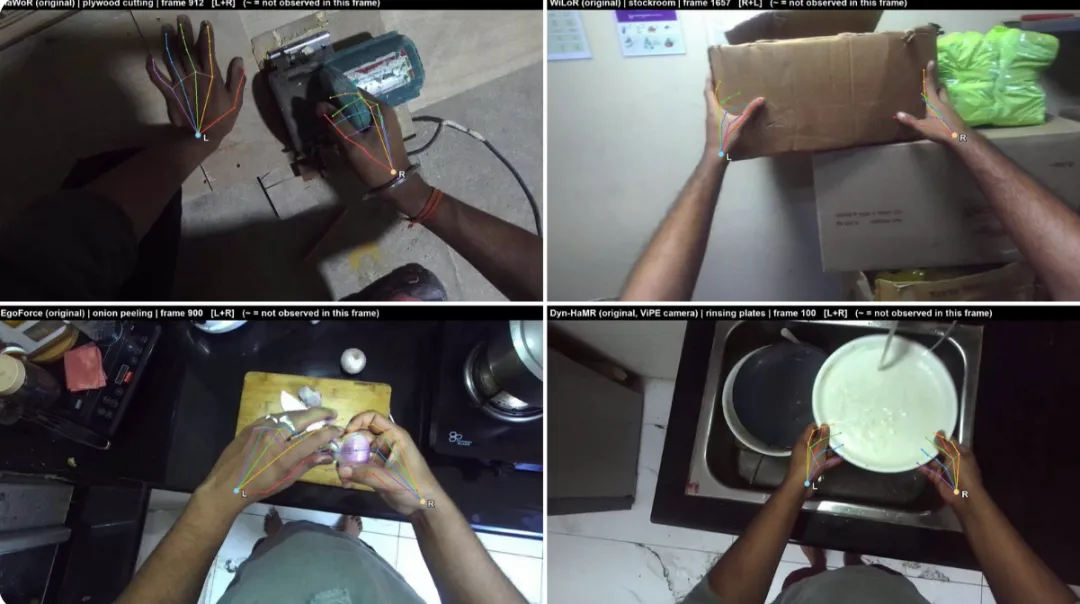
图 4. 当双手静止、光线充足且处于视野中时,四个模型都能正确追踪;使用的头戴相机与产生上述所有失误的视频所用的相机是同一种。
这些条件恰恰是 Benchmark 所遗漏的。为了获得精确标注而构建的数据集,需要良好的光线、稳定的相机和清晰可见的手部,而这些正是模型表现最好的条件。模型在我们的视频中出现的每类失误都有其具体机制。
弱光:区分左右手的线索逐渐消失
见:序列 1 和表 2
这些模型根据单帧中手本身的外观来判断左右:拇指位于哪一侧、看到的是指关节还是手掌。在昏暗光线下,这些线索会最先消失。图像噪声增加,边缘变得模糊,相机自动曝光会延长快门开启时间,因此任何运动的物体都会产生拖影。检测器通常仍能检测到手,但对左右手的判断变得不可靠。HaWoR 和 Dyn-HaMR 都使用 WiLoR 的手部检测器,因此会继承它的判断结果。HaWoR 将追踪到的每只手在各帧中出现次数最多的标签作为其标签,这可以修正良好光照下偶发的错误,却无法修正长时间连续出现的错误标签。
快速运动和模糊:找不到手指
快速运动的手会变成一片模糊区域,根本找不到手指,而手部检测器主要从清晰图像中学习。在我们的视频中,模型丢失手部之前,手的运动速度通常是平时的 1.5 至 4 倍。WiLoR 和 EgoForce 这类不填补缺失片段的模型会直接漏掉手。HaWoR 和 Dyn-HaMR 这类视频模型也会丢失手部,但随后会填补缺失片段:HaWoR 使用学习得到的运动模型,一次最多填补 4 秒;Dyn-HaMR 则将缺失片段两侧的手部位置平滑连接起来。结果看起来平滑而确定,但它们只是猜测。即使在可以用动作捕捉数据进行核验的 HOT3D 上,HaWoR 补出的手中,也只有不到五分之一落在真实手部附近。
遮挡和画面边缘:不完整的手被丢弃
见:图 2 和序列 4
头戴相机从近距离、上方向下观察手部。我们的相机垂直视场角比 Benchmark 相机更窄:我们的相机为 ,EgoStandard 为 ,HOT3D 为 。因此,在靠近身体的位置操作时,手通常位于画面底部或侧面,有一部分被画面裁掉。再加上毛巾、盘子或箱子侧面的遮挡,可能就只剩几根手指可见。检测器主要从完整、可见的手部中学习,因此会给这些不完整的手部视图打出低分并将其丢弃。EgoForce 的代码更进一步:只要一只手位于图像内的关键点少于一半,就会将其丢弃。之后,追踪器会丢失这只手,或者将它的标签赋给仍在视野中的另一只手。
杂乱场景:没有机制检查手是否属于佩戴者
见:图 3
Benchmark 场景整洁,手位于视野中央。我们的场景中则充满肤色形状,而这些模型都不会检查一只“手”是否连接着手臂,或者是否处于相机佩戴者的手臂可及范围内。在我们检查的帧中,这类错误很少,但只需少量错误,就足以在从未发生抓取的地方记录一次抓取。
深度:单个镜头无法测量距离
见:序列 5
这些模型只使用我们双目相机中的一个镜头,而单个镜头无法测量深度。它们根据手部看起来的大小,以及从数据中学到的手部知识来推断深度。当输入情况比较特殊时,例如相机正对下方、半只手处于画面之外,或手模糊成一片,这种推断就可能失效。快速运动会让情况变得更糟:手缓慢运动时,EgoForce 的深度估计在相邻帧之间变化约 0.4 厘米;快速运动时,变化幅度约为其三倍。这些模型都没有强制满足最基本的一条规则:手应当处于手臂可及范围内。
共同根源
这些失误大多始于同一个环节:检测手部并判断它是左手还是右手。HaWoR 和 Dyn-HaMR 都使用 WiLoR 的手部检测器,因此第一步的错误判断会传递到所有建立在该检测器之上的模型。
解决方案:Humyn-HART 21,一个为真实工作场景构建的手部追踪器
Humyn-HART 21 的全称为 Hand Analysis Recognition and Tracking。
如果一只手从未被检测到,或者携带了错误的标签,那么后续再好的 3D 模型也无法修正这一问题。这就是我们针对本文中的条件构建自己的手部追踪系统的原因:
昏暗光线:区分左右手的视觉线索逐渐消失,标签发生交换。
运动模糊:双手快速运动和头部快速转动时,现有检测器会丢失手部。
位于画面边缘或部分遮挡的手:现有检测器会给出低分并将其丢弃。
杂乱场景:脚、前臂和肤色形状会被误认为手,另一个人的手也可能被误认为佩戴者的手。
解决方案有多有效:我们目前了解的情况,以及后续如何衡量
Humyn-HART 21 旨在持续锁定佩戴者自己的双手,即使视野中出现其他人的手也能做到。我们首先在一个多人共用的分拣工位测试了它,整个过程中,一名同事始终处于手臂可及范围内。在 6 分钟内,一个基线追踪器有 13 次将追踪身份切换到同事的手上。Humyn-HART 21 的次数为零。
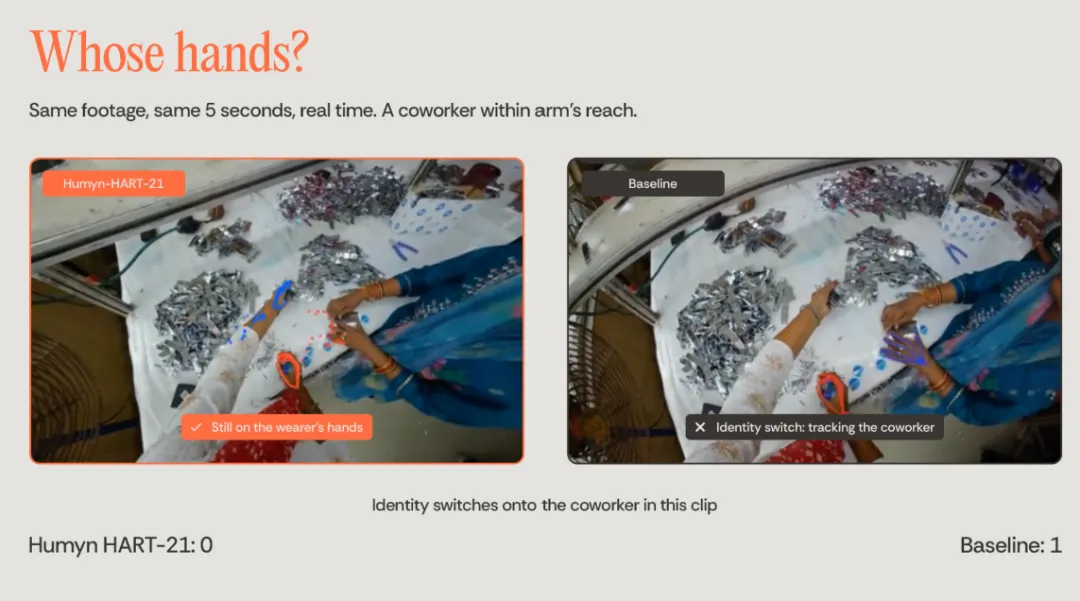
身份错误并非噪声,而是教给机器人的错误知识。
本研究中的两个发现表明,为什么修正这第一步能够带来收益:
当手部清晰可见时,模型能够正常工作。在我们的视频中较为平稳的片段里(图 4),四个模型都能正确追踪手部;使用的头戴相机与产生上述所有失误的视频所用的相机相同。
多个模型建立在同一个检测器之上。HaWoR 和 Dyn-HaMR 都继承了 WiLoR 的检测器及其判断结果,因此改进检测可以从源头解决这些失误,而不必逐个修改模型。
目前这还只是一个条件下的测试。接下来,我们将测量在更多人员密集的工位中出现的身份切换次数和关键点精度。我们也会使用本文评测四个模型的相同方法,在本文涉及的条件下——昏暗光线、运动模糊、手部位于画面边缘和杂乱场景——评测 HART 21,并分享其表现。
测试方法:我们在没有重新训练的情况下运行了 WiLoR、HaWoR、EgoForce 和 Dyn-HaMR 的已发布版本。Benchmark 分数使用各数据集的参考标注;我们的视频片段大多约为一分钟,使用头戴式 ZED 双目相机采集。所有叠加画面均绘制模型自身的输出,没有进行任何添加或修正;昏暗帧经过提亮,以便观察。
来源:human five