
拿到一个物体的四张照片,我们通常能认出它的正面、侧面和背面。但如果要把这些照片变成一个可以自由旋转的三维模型,问题就复杂了。照片分别是从哪里拍的?不同照片里的轮廓能否拼成同一个物体?没有拍到的地方,又应该是什么样?
这几个问题其实紧密相关。判断拍摄方向,需要对物体形状有所了解;恢复物体形状,又需要知道每张照片的拍摄方向。输入越少,遮挡越多,两者就越难分开解决。
忆生科技联合香港大学提出的 GenSfM,选择让物体和相机在同一个三维生成过程中逐步成形。输入四张未标定的物体图像,无需事先给出相机内外参,模型即可联合恢复完整物体和各张图像对应的相机参数。这项工作已被 NeurIPS 2026 接收。
约76秒演示:从四张输入图像出发,观察形状与相机的联合去噪、输入视角重投影,以及合成和真实拍摄物体的重建结果。
一个三维结果,需要同时回答两件事
三维生成的展示常常从一段转台视频开始:物体转过一圈,看起来是否完整,纹理是否清楚。但对于多视角重建,还有一个同样关键的问题——这个三维结果能否解释输入的每一张照片?
例如视频中的折叠拖车。除了观察车架、车轮和布料是否生成完整,还可以沿着预测出的相机方向,把三维结果重新渲染成二维图像,再与原始照片对照。车轮位置、车架边缘和表面图案是否对应,可以用来检查物体与相机是否一致。
GenSfM希望得到的是一组相互对应的输出:一个完整的三维物体,以及能够解释各张输入图像的相机。因此,相机恢复也参与了物体生成,并为后续细节恢复提供依据。
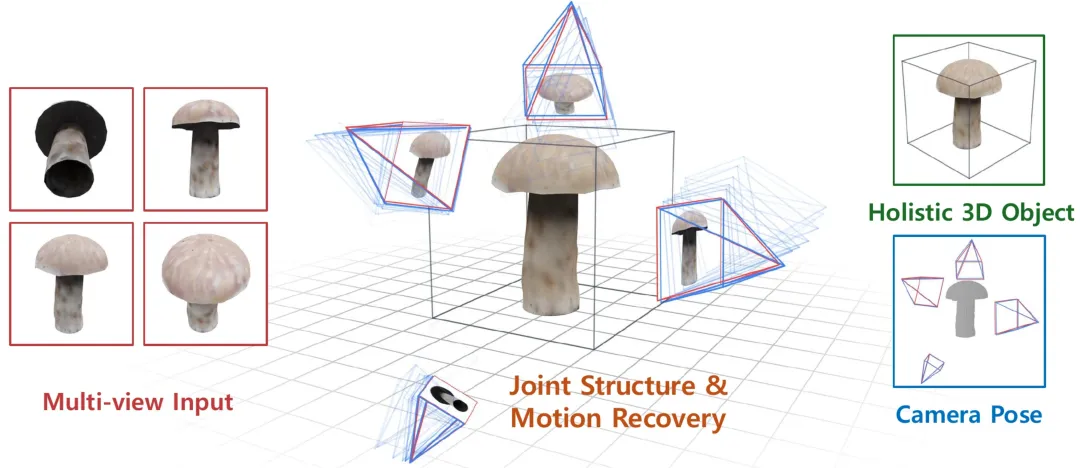
同一三维空间中的物体与相机。蓝色表示预测相机,红色表示参考相机。
让形状与相机共同参与推断
传统运动恢复结构(Structure from Motion,SfM)通常先从多张图像中寻找特征对应,再利用几何关系估计相机和稀疏三维点,并联合优化。要得到完整表面,还需要进一步进行稠密重建。
输入缩减到少数几个视角,可用的对应关系和表面覆盖都会减少。一处轮廓变窄,既可能来自物体本身的形状,也可能来自观察角度的变化。仅凭局部图像信息,很难排除这些不同解释。
生成模型带来了另一类线索。它可以从大量三维实例中学习物体形状的分布,用已见部分推断被遮挡或未拍摄的区域。团队此前的CUPID [2]已经探索了单图条件下的物体与相机联合生成,并支持多视角扩展。GenSfM进一步将多张图像放入统一的联合推理过程。
在GenSfM中,各张图像共同约束一份共享的物体表示,每张图像则保留自己的相机表示。它们一起进入原生三维扩散模型,在去噪过程中共同更新。这样,某张图中缺失的结构可以从其他图像获得补充,逐渐形成的物体形状也能为相机判断提供线索。
这里的“原生三维”意味着模型直接在三维物体表示上进行生成。多张图像的线索最终汇集到同一个三维物体中。
从空间关系到表面细节,分两步完成
GenSfM沿用了TRELLIS [1]先粗后细的框架。第一阶段联合生成粗结构与相机。第二阶段使用这些相机建立图像与三维位置的投影关系,进一步恢复几何和外观。
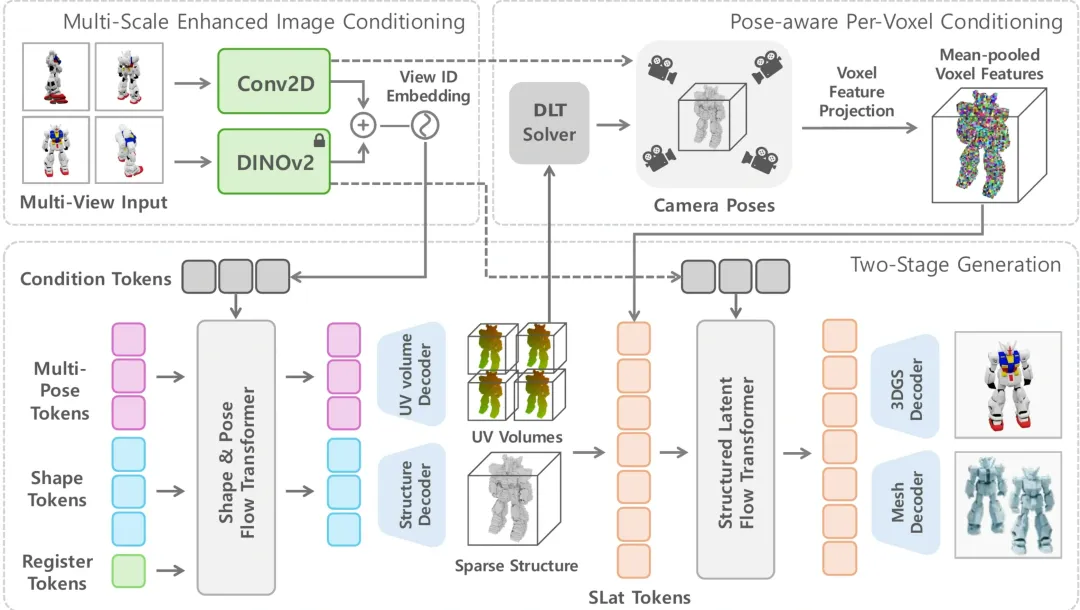
第一阶段从图像条件联合恢复粗结构与相机,通过DLT求解相机参数。第二阶段沿预测相机的投影关系采样图像特征,细化三维结果。
整个推理流程无需串联独立的外部相机估计器和重建器,也不需要对每个物体额外运行后处理优化。形状与相机在第一阶段共同推断,第二阶段直接使用由此得到的空间关系。
多视角输入时,模型还必须知道每份相机表示属于哪张图像。为此,GenSfM给图像特征及其对应的相机表示加入相同的视角标签,并利用共享的全局信息表示汇集多张图像的线索。标签标明的是来源,具体的拍摄角度仍然需要模型自行推断。
输入图像的信息由两类特征提供:DINOv2负责物体与结构的语义线索,小型卷积网络补充多尺度的颜色、边缘和纹理信息。前者帮助理解整体,后者为局部差异和细节恢复提供依据。
相机也可以写成一份空间表示
物体具有三维结构,适合用体素等空间表示来组织。那么,怎样让相机进入同一个生成过程?
GenSfM使用的是 UV体素网格。可以把它理解为一份投影坐标表:对三维网格中的每个位置,记录它在某张图像上对应的二维坐标(u,v)。每个输入视角各有一份这样的网格,用稠密的3D–2D对应关系描述相机的投影方式。
这种表示和物体结构共用一套64×64×64体素网格,位置一一对应,三维扩散模型可以把两者放在一起处理。为了降低稠密网格的冗余,共享的相机编码器先将其压缩为 4×4×4的潜在网格。联合去噪时,模型处理的是一份物体形状潜变量和多份紧凑的相机潜变量。
生成完成后,相机潜变量被解码回UV体素网格,再通过DLT根据三维位置与二维投影求出相机矩阵,恢复内参与外参。由此,模型可以从同一轮联合生成中获得粗结构和多组相机。
找到拍摄方向之后,纹理就有了定位依据
比如背包侧面的图案,不仅需要被生成出来,还需要出现在正确的表面位置。
如果只通过Attention注入图像特征,图像区域与三维位置之间的关系主要由网络隐式学习。GenSfM在第二阶段进一步利用第一阶段的相机,为局部特征提供明确的采样位置:将粗结构中的活跃体素投影到各张输入图像,再从对应坐标提取特征。
这些采样特征分为语义和纹理两路。DINOv2提供语义信息,卷积网络提供局部外观线索。不同视角的特征在各自分支内取平均。语义特征随后通过冻结的SLat编码器转换到三维潜在空间,并与纹理特征一起拼接到待去噪的体素特征中。
预测相机由此把输入中的图案、边缘和颜色,与需要细化的三维位置联系起来。模型既能利用整体图像条件,也能沿投影关系获取局部信息,从而改善颜色和表面图案的还原。
没有被输入图像覆盖的区域,仍靠生成先验补全。最终得到的SLat表示可以解码为三维高斯或网格。
实验分别检查物体质量与相机质量
评估既要看生成的物体是否接近参考结果,也要看预测相机是否恢复了正确的视角关系。
论文在Toys4K和GSO中分别选取400个测试物体,每个物体使用两组互不重叠的四视角输入。这两个测试集均未参与训练。外观评估使用未作为输入的新视角,几何与相机则分别进行评估。
先看三维生成。与多视角基线TRELLIS-M相比,GenSfM的新视角PSNR在Toys4K上提高 4.53 dB,在GSO上提高 3.22 dB,几何F-score也同步提高。PSNR衡量渲染图像与参考图像的接近程度,F-score衡量给定距离阈值下恢复表面与参考几何的吻合程度。
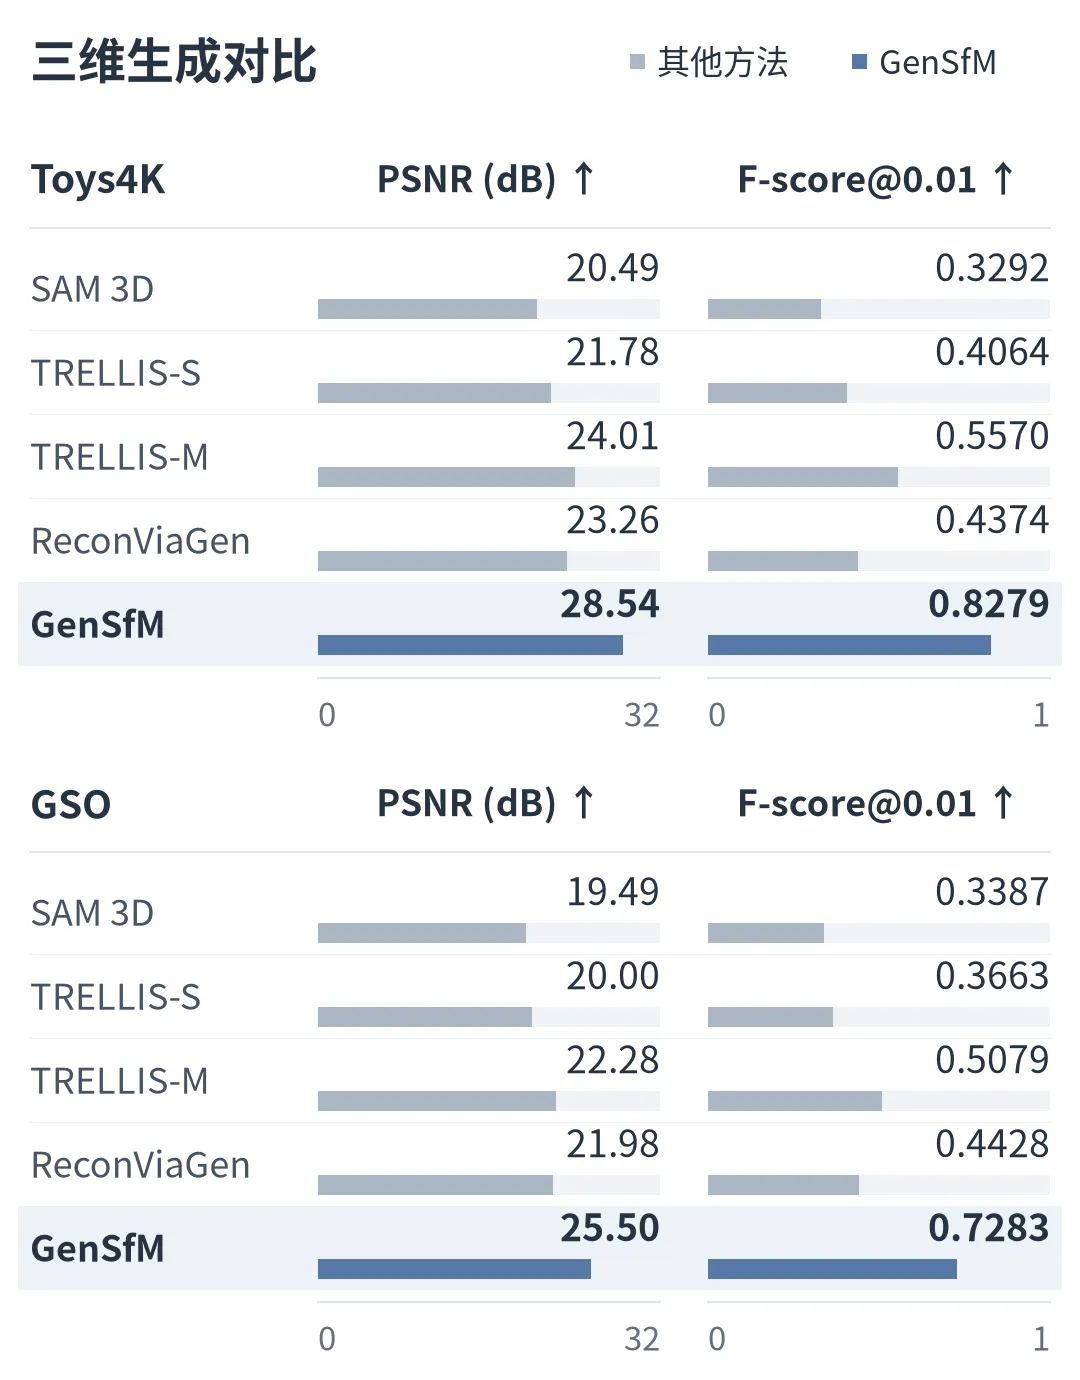
上行为Toys4K,下行为GSO;每组左侧为PSNR,右侧为F-score(距离阈值0.01),均为越高越好。结果经过参考几何辅助的相似变换ICP对齐。
SAM 3D [3]与TRELLIS-S是单图基线,其中SAM 3D分别使用四张输入生成,再对四次输出的指标取平均。TRELLIS-M、ReconViaGen [4]与GenSfM使用多视角输入。TRELLIS-M在每次去噪更新时随机选择一张图作为条件,GenSfM则让多个视角共同参与推断,并显式恢复各视角与物体的空间关系。
再看相机。论文使用视角之间的相对关系进行评估,以避开整体坐标选择的影响。在自行预测内参的条件下,GenSfM在Toys4K和GSO上的相对旋转误差分别为 1.60°和1.27°,低于图中对比的FreeSplatter [5]、ReconViaGen [4]和VGGT [6]。
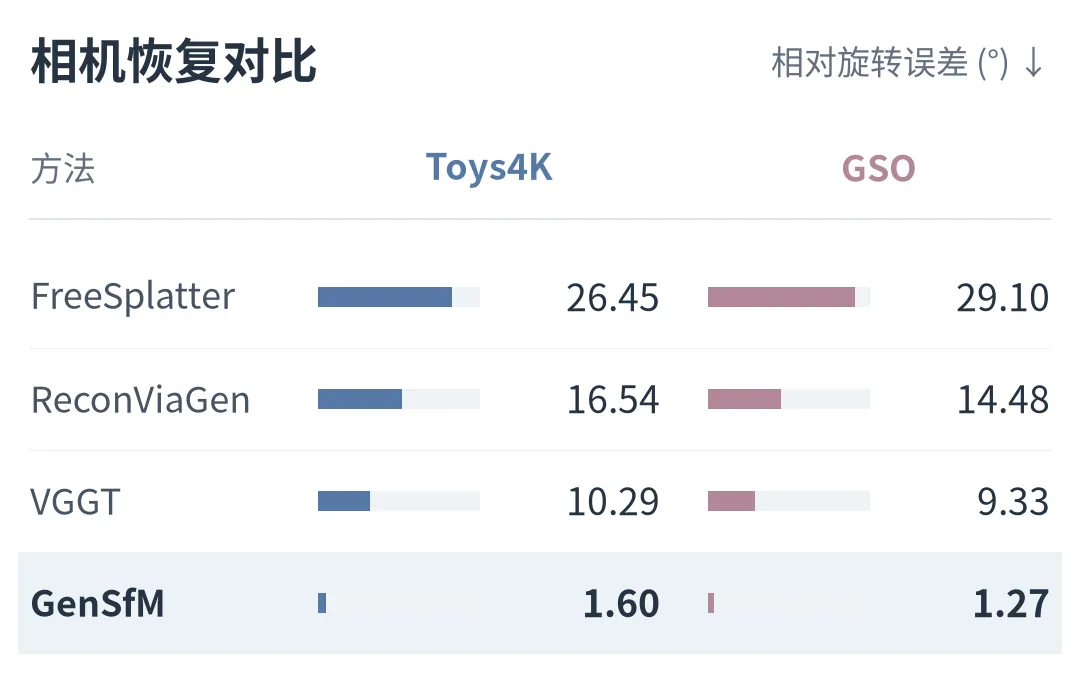
左为Toys4K,右为GSO;单位为度,越低越好。GenSfM使用预测内参。原始预测相机的两两相对位姿按容许位姿歧义的规则计分,不经过ICP对齐。
回到具体物体,看不同视角能否对应
下图中的钟表既需要区分表盘与背面,也需要保留顶部提环和底部支脚。背包则同时考验肩带等结构的位置,以及侧面图案的还原。
对比包含SAM 3D [3]与TRELLIS [1]。除输入列外,各列采用相同的新视角逐一对应,最右侧为参考模型渲染。GenSfM列展示三维高斯渲染。
转台视频用来观察输入之外的角度是否完整,输入视角重投影则用来检查已有轮廓与纹理是否和输入匹配,两者相互补充。
GenSfM目前面向单个物体,未见表面的恢复仍依赖生成先验,效果也会受到训练分布和表示分辨率的影响。在这个范围内,它展示了一条将物体生成与相机恢复结合起来的路径,先用几张未标定图像共同推断三维结构,再用恢复出的投影关系把图像细节送回三维空间。
论文:Generative Structure from Motion with Native 3D Diffusion(NeurIPS 2026)
项目主页:
论文全文已在arXiv公开,欢迎访问项目主页查看更多重建结果与交互案例,或前往代码仓库了解实现细节与使用方法。
参考文献
Jianfeng Xiang 等. Structured 3D Latents for Scalable and Versatile 3D Generation(TRELLIS). arXiv:2412.01506, 2024.
Binbin Huang 等. CUPID: Generative 3D Reconstruction via Joint Object and Pose Modeling. arXiv:2510.20776, 2025.
SAM 3D Team 等. SAM 3D: 3Dfy Anything in Images. arXiv:2511.16624, 2025.
Jiahao Chang 等. ReconViaGen: Towards Accurate Multi-view 3D Object Reconstruction via Generation. arXiv:2510.23306, 2025.
Jiale Xu 等. FreeSplatter: Pose-free Gaussian Splatting for Sparse-view 3D Reconstruction. arXiv:2412.09573, 2024.
Jianyuan Wang 等. VGGT: Visual Geometry Grounded Transformer. arXiv:2503.11651, 2025.
来源:human five