
含被改词元的 335 条留出指令,成功率从 74.3%升至 87.5%;另外 430 个回合,成败结果逐一不变。
只改 65 行词嵌入,GPT-6 Astra 修复了一类机器人「换种说法就失败」的问题。
任务是打开炉灶。研究者给机器人的指令是「activate the cooking appliances heat source」——启动烹饪设备的热源。原始策略却伸手去拿盘子,执行 300 步后仍未完成任务。
换上修改后的权重,同一个场景、同一条指令、同一个随机种子,机器人在第 78 步完成了任务。编辑过程中没有做梯度更新,也没有新增机器人示范数据。
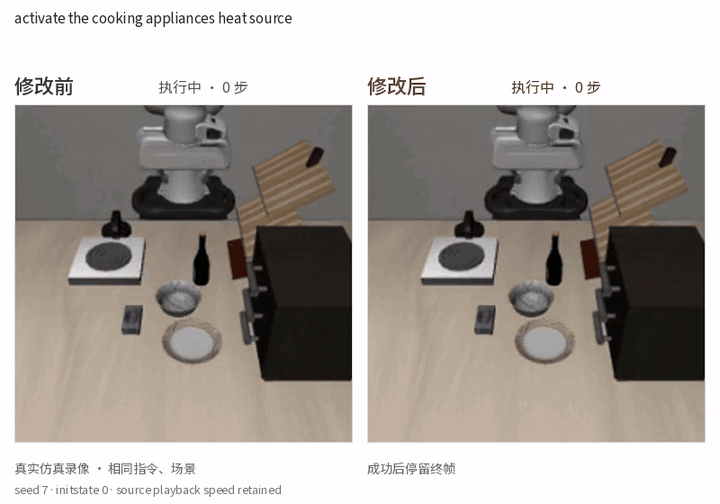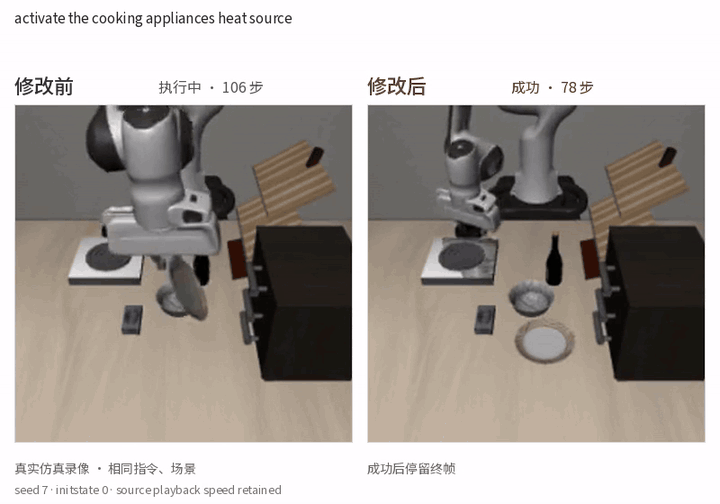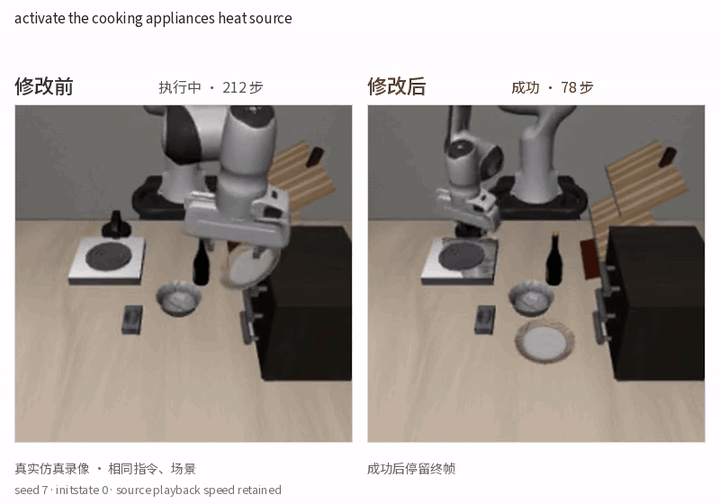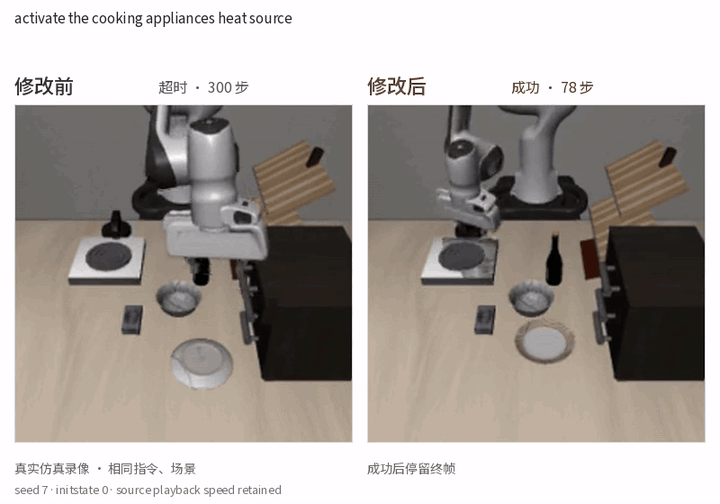
动图 1|同一条留出指令,修改前后的机器人行为。左侧原始策略在 300 步超时;右侧编辑后在 78 步成功,随后停留终帧。场景、随机种子 7 和初始状态 0 相同,画面来自真实仿真录像。这是选出的修复案例,完整统计也包括退化回合。
这项研究由 Jusheng Zhang、Keze Wang 和 Liang Lin 共同完成,论文题为《Can LLMs Debug Robots by Editing Their Weights?》。在效果最好的实验中,335 条包含被改词元的留出指令,成功率从 74.3%提高到 87.5%;另外 430 个回合的成败结果逐一不变。这里的「零变化」,指每个回合的成功或失败结果。
论文、实际评测过的权重修改、代码和全部 16 次实验记录均已公开。研究关心的是一个具体问题:机器人已经具备的操作能力,能否通过局部权重修改,被不同的语言表达更可靠地调用?
论文:
GitHub:
项目介绍与过程回放:
把 LLM 放在调试器的位置
研究使用 OpenPI 发布的π₀.₅ LIBERO 检查点。它是一种视觉—语言—动作模型:接收相机画面、语言指令和机器人状态,输出接下来要执行的动作。基座已经经过预训练和微调;本次编辑以 LIBERO 操作任务和 LIBERO-Plus 指令改写为测试环境。[1][5][6]
在这套实验里,Astra 负责检查和修改策略的权重。研究者为它提供一个持续保留状态的 Python 工作区,以及可调用的前向工具。Astra 可以查看张量、写入替换值,再检查仿真任务的结果、动作或内部信号。修改确定后,动作仍由被编辑的机器人策略计算。
每次语言编辑有 50 次计入预算的工具请求,一次请求可以包含多个回合或输入。Astra 依靠练习样本的反馈选择候选,最终留出测试的结果不会返回给它。因而,「没有梯度更新」不等于「没有反馈」,更不意味着机器人从未接受过训练。
这使问题从「机器人有没有学过这个动作」,转向了「这条指令在模型里被表示成什么,能不能更可靠地调用已有行为」。
动图 2|GPT-6 Astra调试机器人权重的真实过程回放。研究者公开了50次工具请求中的关键节点,展示Astra如何根据仿真反馈调整词嵌入、检查候选效果,并最终保留65行修改。左侧为同一指令修改前后的机器人行为,底部展示练习样本结果与工具反馈。
65 行,改在语言进入模型的地方
一条指令进入模型后,会先被拆成词元(token)。词元不一定等于完整英文单词。随后,模型按词元 ID 从嵌入表中取出对应的一行向量,后续网络处理的就是这些数值表征。
Astra 最终保留的修改,集中在这张嵌入表上。它选出一部分词元,把向量移向更常见的任务表达,例如 cooker→stove、basin→bowl、fermented→wine。有些行采用目标向量,有些保留一部分原向量;遇到歧义,也可以使用多个目标向量的均值。
开场炉灶指令里的 cooking,就是一个具体例子。对应词元的嵌入被改为 25%的原向量,加上 75%的 stove 向量。输入给机器人的文字仍然包含 cooking,但进入后续网络的数值表示发生了变化。这一行属于整份 65 行修改,研究没有单独评估它的效果。
其余案例也保留了可检查的对应关系:酒瓶指令中的 fermented、grapes 被移向 wine;取碗指令中的 rounded 被移向 bowl,uppermost 被移向 top。完整词元映射和配对录像均已公开。
65 行共改变 132,768 个参数值,占导出检查点的 0.00367%。这里的「行」是嵌入表的行数,并非 65 个参数,也不是 65 行代码。提交的语言修复只改变这些嵌入值;具体词元 ID、目标行和混合比例都已公开。
此前已有研究探索让通用 LLM 直接读取和改写神经网络权重,即权重空间编程(Weight-Space Programming)。[2] ROME、MEMIT、M
来源:机器之心