
Coding Agent 的上下文越长,每一步调用的开销越高,能否在不影响任务完成的前提下压缩上下文?
Coding Agent 解决软件问题时,需要反复查看代码、修改程序、运行测试:每一步返回的文件内容、搜索结果和日志,都会留在上下文里,下一轮调用时还要整段重新带上。任务越难,上下文越长,每一步要处理的 token 就越多,费用也越高。统计发现,在 SWE-bench Verified 上,这些 observation 占了总 token 消耗的 45.7%,在 Terminal-Bench 上最高达到 67.8%。
能否直接压缩这些 observation?难点在于:压缩时很难知道被删去的内容后续是否还会被用到。
来自清华大学人工智能学院的团队提出了 CoACT:一种面向 Coding Agent 的 observation 压缩方法。它不看压缩结果像不像原文,而是看压缩之后,Agent 的下一步动作变没变。 在 SWE-bench Verified 的 200 个实例、三个 Agent 模型上,CoACT 平均减少 33.0% 的总 token 消耗,平均 PASS@1 从 69.0% 到 71.0%,任务表现与未压缩时相近。该工作已经被 CCF A 类会议 ICSE 2027 直接接收(Top 5%)。
论文标题:CoACT: Action-Preserving Observation Compression for Coding Agents
一、现有压缩方法的局限
已有方法大致分两路。一路是改写历史:滑动窗口丢掉较早的命令和输出,AgentDiet 则让模型定期回看历史,自己删掉重复或用不上的内容。但历史一旦被改写,原有的 KV Cache 就没法完整复用,模型还得重新预填充改写后的内容,token 少了,开销未必变少。
另一路是在新 observation 进入上下文之前就先压缩。之前的历史原封不动,缓存照常复用。CoACT 选的就是这条对 KV Cache 友好的路。
走这条路,先要想清楚压缩的目标。Agent 的目的是完成任务,因此压缩的效果应以任务能否完成来衡量。所以目标是:在任务成功率(PASS@1)与未压缩 Agent 接近的前提下,尽可能减少总 token 消耗。
这需要在两方面权衡:删减过多,Agent 可能缺少必要信息,导致任务失败或重复读取;删减过少,则无法有效降低开销。
二、核心想法:下一步动作保持(NAP)
最直接的验证办法,是让 Agent 读完压缩结果把任务跑完。但同一份 observation 可以有很多种压缩,每种都跑完全程,成本太高;一次任务里还要压缩很多次,也难以判断最终结果是由哪一次压缩造成的。
我们认为,Agent 的执行过程可以看作 “读取输出、执行动作、获得新输出” 的循环。假设初始环境相同、环境对相同动作的响应也相同,那么只要每次压缩后 Agent 的下一步动作不变,环境收到的操作和返回的结果就一样,往后的动作序列和最终结果,理论上也不会变。
基于这个推导,我们提出下一步动作保持(Next-Action Preservation,NAP):保持任务目标和历史相同,分别让 Agent 读压缩前后的 observation,再比较它接下来的动作。比如读完一段代码后,Agent 本来要去查看里面调用的某个函数,换成压缩结果后它还是去看这个函数,则认为这次压缩保持了下一步动作。这样可以对每次压缩单独检验,无需等到任务结束。
三、怎么造训练数据:
基于 NAP 的压缩示范构造
有了 NAP,我们训练了一个轻量压缩器(以 Qwen3.5-4B 为基座)。做法分几步:
先让教师模型 Gemini3-Flash,为同一份 observation 生成 8 份压缩候选;再让 Agent 在原始 observation 下多次采样,得到 8 个参考动作。每份压缩结果引出的动作,会与参考动作逐个比较,取最相似的 3 个求平均,得分达到 0.6 才算通过。比较时并不是比字符串,而是解析命令的操作类型、目标文件和读取范围,写法不同但读取同一段代码的命令,会被识别为相同操作。
通过检查后,再从中挑选更短的版本,作为训练示范。如果 8 份候选全军覆没,就用原始 observation 当目标,让模型学会该留的时候就留。
四、两阶段训练:离线引导与在线对齐
只用未压缩 Agent 的轨迹造数据,有个隐患:收集数据时,Agent 的历史都是完整的;真正部署后,前几步读到的内容也被压缩过,看到的历史已经不一样了。
CoACT 的做法是:第一阶段用离线轨迹做监督微调,得到初始压缩器;第二阶段让它实际参与 Agent 运行,保留此前已压缩的历史,重新做动作比较和长度筛选,得到第二批数据;最后合并两阶段数据训练最终压缩器。
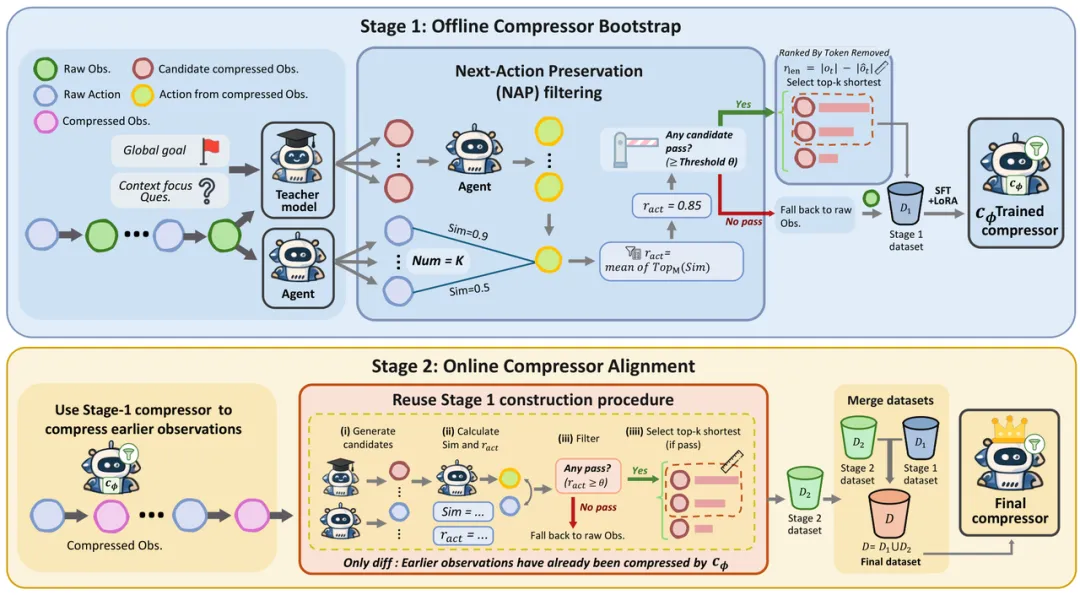
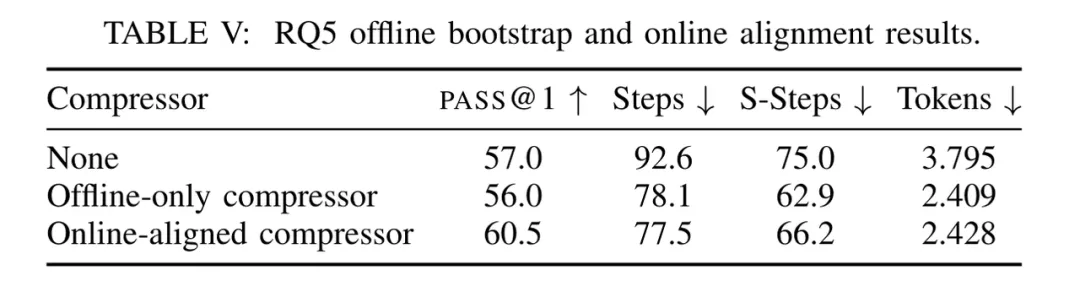
对照实验中,只用离线数据训练的压缩器,PASS@1 为 56.0%,略低于未压缩的 57.0%;加入第二阶段的在线数据后升到 60.5%,总 token 消耗基本相当。
五、实验结果:省下三分之一,性能没有变
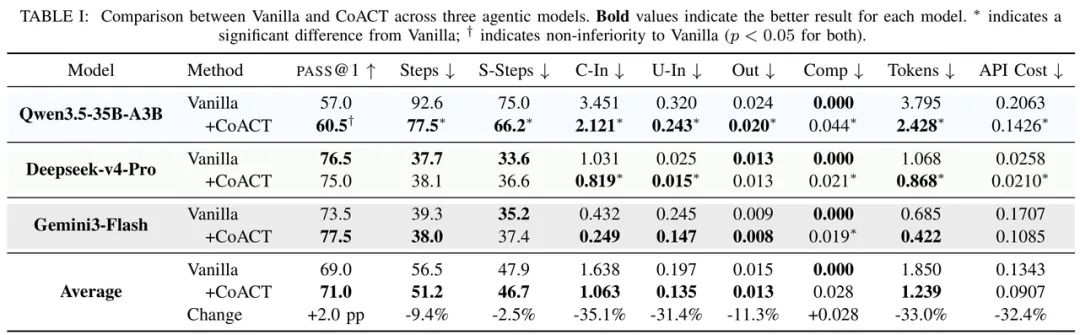
在 SWE-bench Verified 随机抽取的 200 个实例上,CoACT 在 Qwen3.5-35B-A3B、Deepseek-v4-Pro 和 Gemini3-Flash 三个模型上均减少了 token 消耗:Qwen 从 3.795M 降到 2.428M,Deepseek 从 1.068M 降到 0.868M,Gemini 从 0.685M 降到 0.422M,平均降幅 33.0%。三个模型的平均 PASS@1 从 69.0% 变为 71.0%:Qwen 和 Gemini 分别提升 3.5 和 4.0 个点,Deepseek 略降 1.5 个点。平均交互步数也从 56.5 步降到 51.2 步。
压缩后,那些又长又占地方的 observation 明显变少了:在 Qwen3.5-35B-A3B 上,超过 1K token 的 observation 占比从 32.3% 降到 9.4%。
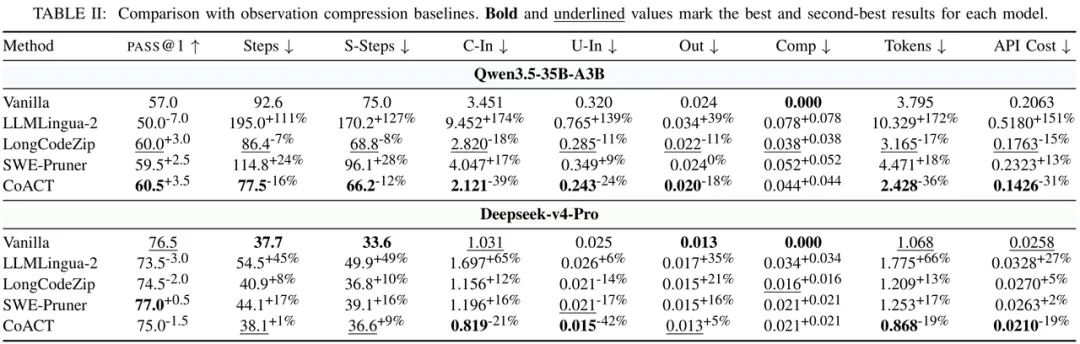
和已有的 observation 压缩方法相比,差距更有意思。以 Qwen 为例,LLMLingua-2 压缩后,PASS@1 从 57.0% 降到 50.0%,总 token 反而从 3.795M 涨到 10.329M;SWE-Pruner 涨到 4.471M;LongCodeZip 降到 3.165M;CoACT 为 2.428M,PASS@1 为 60.5%。在 Deepseek 上,三种基线的总 token 都高于未压缩的 1.068M,CoACT 则降到 0.868M,是两个评测模型上总 token 最低的方法。这说明,仅以缩短 observation 长度为目标,并不能保证整个任务的总开销下降。
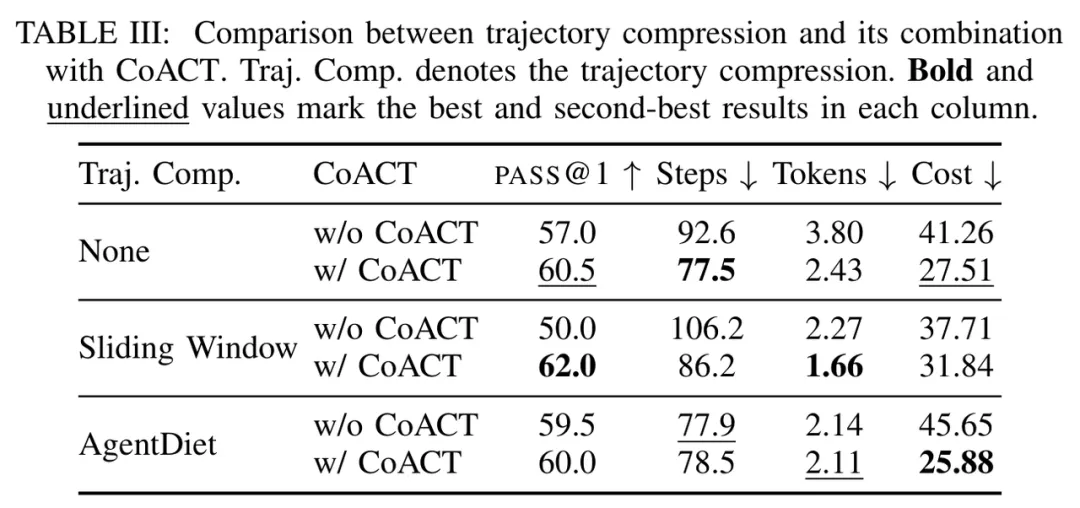
CoACT 作为单步压缩方法,还能和历史压缩方法配合。单独使用 AgentDiet 时,总 token 虽然减少,估算总费用却从未压缩的 41.26 美元涨到 45.65 美元,原因是改写历史影响了 KV Cache 复用。在 AgentDiet 流程中先加入 CoACT,估算总费用降到 25.88 美元,任务成功率保持相近,比单独使用 AgentDiet 少了约 43.3%。
作者介绍
本研究由清华大学人工智能学院 AI Agent 课题组完成。通讯作者为清华大学人工智能学院李佳助理教授,主要研究方向为 AI + 软件、可信智能体。第一作者陈浩瑞为清华大学人工智能学院 2027 级直博生(拟入学),主要研究方向为 Efficient AI。
© THE
来源:机器之心