
以四大顶会为圆心,看见机器人研究的新半径
——Best paper
随着11月CoRL 2026落幕,ICRA、RSS、IROS 和 CoRL 四场机器人领域的重要会议,都已经公布了今年的论文奖项。
当我们把四场会议的获奖工作放在一起看,会发现一个很有意思的现象:
今年的机器人顶会,并不只是奖励那些让机器人学会更多技能的研究,也越来越关注如何让这些技能训练得更快、执行得更稳,并在真实环境中持续工作。
有的把人类动作变成机器人可执行的训练数据,也有让强化学习从数小时压缩到几十分钟,以及研究机器人怎样长期记住变化的环境……
这次,我们从 ICRA、RSS、IROS 和 CoRL 四场会议中选出12篇具有代表性的获奖论文,看看今年机器人领域有哪些值得关注的研究成果。
ICRA 2026:机器人不仅要学会动作,还要学会完成任务
作为机器人领域规模最大的国际会议之一,ICRA今年于6月在奥地利维也纳举行。
本届大会的两篇 Best Conference Paper 工作,分别关注人类动作迁移和机器人长程任务规划。
而机器人学习专项奖,则把目光放在一个很基础、也很容易被忽视的问题上:相机位置发生变化,为什么机器人就可能不会操作了?
OmniRetarget:人类会做的动作,机器人为什么不能直接模仿?
🏆 Best Conference Paper Award、Best Paper Award on Robot Manipulation and Locomotion
发文团队:Amazon FAR、MIT、UC Berkeley、斯坦福大学、CMU等。
对于人形机器人来说,学习人类动作是一条很自然的技术路线。研究人员可以通过动作捕捉记录人类走路、跳跃、搬运物体的过程,再把这些动作转换成机器人的训练数据。
但问题在于,人类与机器人的身体结构并不一样。
人能够轻松完成的动作,机器人可能因为关节范围、身体比例或者重心位置不同而无法复现。如果只是要求机器人尽可能模仿人类姿态,生成的动作还可能出现脚底打滑、身体碰撞甚至失去平衡。
OmniRetarget提出,与其让机器人一味模仿人类的关节姿态,不如重点保留动作中的物理交互关系。
例如,跨越障碍物时,真正重要的不是膝盖具体弯曲多少度,而是脚能够越过障碍、身体不会发生碰撞。搬动物体时,手与物体的接触关系,也可能比手臂姿态更加重要。
研究通过交互网格建模身体、物体和地形之间的关系,再根据机器人的身体结构生成能够真正执行的动作。利用这套方法,团队生成了大量运动训练数据,并在Unitree G1上完成了多种全身运动验证。
这篇工作给人形机器人提供了一种更合理的学习方式:学习动作的目的,是完成相同的物理交互,而不只是摆出相似的姿势。
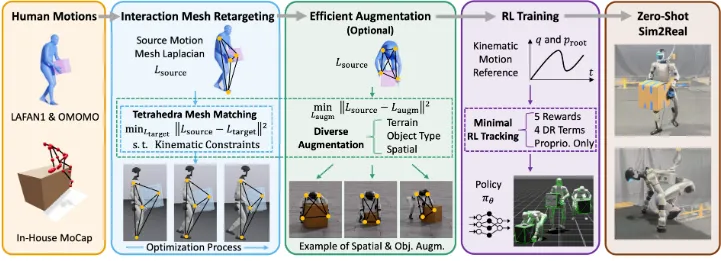
▲图 | OmniRetarget通过保留身体与环境之间的重要接触关系,让机器人用自己的身体完成类似的动作,而不是机械地模仿人类姿态。©【深蓝具身智能】编译
SymSkill:机器人会开抽屉,为什么还是不会收拾东西?
🏆 Best Conference Paper Award、Best Paper Award on Planning and Control
发文团队:宾夕法尼亚大学
让机器人学会打开一个抽屉并不算特别困难,但如果任务变成“把桌上的东西收进抽屉”,事情就复杂多了。
因为机器人不仅要会开抽屉,还要知道什么时候打开、什么时候抓取物体,以及放好之后应该做什么。如果中途某个动作失败,它还得判断如何恢复。
传统模仿学习通常擅长学习一个具体动作,却不一定擅长决定多个动作之间的执行顺序。
SymSkill试图让机器人同时学习动作技能和使用这些技能的条件。
它从约5分钟没有人工标签的自由操作数据中,学习出一些可复用的动作技能,以及对应的符号化状态关系。例如,只有抽屉打开之后,某些放置操作才可能执行;当环境发生变化,系统也能重新安排技能顺序。
这样,机器人面对复杂任务时,不必从头生成一整段连续动作,而是可以根据当前环境,从已经掌握的技能中选择合适的操作,并在失败后调整计划。
这项研究说明,机器人学习的难点已经不只是单个技能的成功率,而是如何把多个技能组织成一套能够应对变化的完整任务流程。
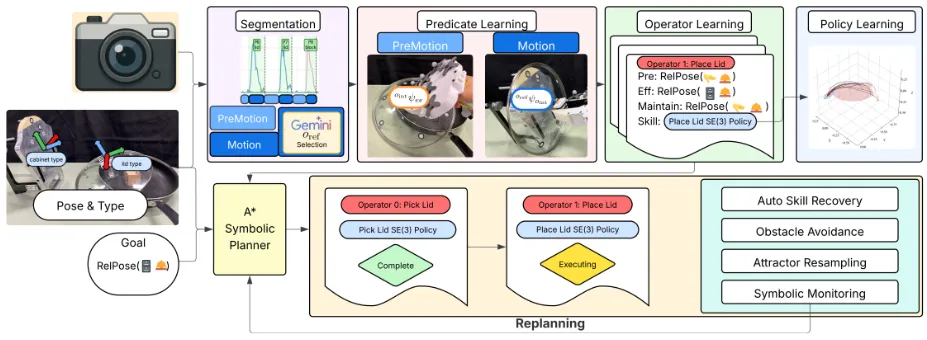
▲图 | SymSkill把长程任务拆成可复用的动作技能,同时学习每项技能适合在什么状态下执行。©【深蓝具身智能】编译
Do You Know Where Your Camera Is:摄像头换个位置,机器人就不会干活了?
🏆 Best Paper Award on Robot Learning
发文团队:TTIC、Waymo、约翰霍普金斯大学、Toyota Research Institute等
同样是一只机械臂抓取桌上的杯子,如果摄像头从正前方移动到侧面,为什么原本训练好的机器人策略可能突然表现变差?
原因其实很直接:模型在训练时可能记住了物体在图像中的位置,却没有充分理解图像和真实三维空间之间的关系。
当摄像头移动,画面中的物体位置和视角都会变化,但桌上的杯子并没有真的移动。
这篇论文提出,将相机的几何信息显式提供给机器人策略。具体来说,研究使用Plücker射线描述每个图像像素对应的空间射线,让模型不仅知道画面中有什么,还知道这些视觉信息是从哪个方向、哪个位置观察得到的。
通过这种方式,策略可以更好地区分物体真实的位置变化和相机视角变化,从而提高不同拍摄条件下的操作泛化能力。
这是一项相对基础的研究,但它提醒我们:机器人视觉模型不能只依赖图像本身,理解图像背后的三维几何关系,同样重要。
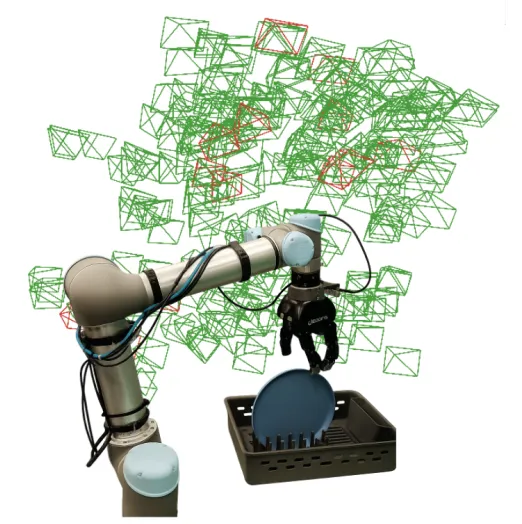
▲图 | 通过额外输入相机的空间位置和观察方向,模型能够更好地理解不同画面之间的几何关系,减少对固定摄像头视角的依赖。©【深蓝具身智能】编译
RSS 2026:让机器人训练更快,也让算法真正适应物理世界
相比ICRA对机器人学习与任务能力的关注,今年 RSS 的三篇主要获奖论文,呈现出另一个共同特点:
很多看起来已经成熟的机器人算法,仍然有大量效率和物理建模问题值得解决。
从强化学习到扩散轨迹生成,再到底层电机建模,获奖工作都在尝试消除算法实际运行时遇到的瓶颈。
FlashSAC:训练机器人走路,真的需要花几个小时吗?
🏆 Outstanding Paper Award
发文团队:Holiday Robotics、KAIST、KRAFTON等
强化学习是训练机器人运动控制的重要方法,但训练高自由度机器人通常相当耗时。
目前广泛使用的PPO算法相对稳定,却需要不断重新采集训练数据。另一类离策略强化学习方法可以反复利用过去的经验,但在高维机器人控制中,又容易因为价值估计误差不断积累而导致训练不稳定。
FlashSAC尝试解决的,就是这个效率和稳定性之间的矛盾。
它没有简单增加训练次数,而是选择使用更大的网络、更高的数据吞吐量,并对模型权重、特征和梯度进行约束,减少错误在训练中不断放大的问题。
这样一来,模型能够更充分地利用大量并行仿真数据,而不必靠频繁更新参数来提高学习效率。
在真实Unitree G1的运动训练实验中,FlashSAC约20分钟就能训练出稳定的平地行走策略,而对比的PPO方案需要约3小时。
对于机器人研究来说,这类效率提升十分重要。因为训练成本降低之后,研究人员就能更快测试新的动作、环境和机器人平台,而不必为每一次实验都付出大量计算资源。
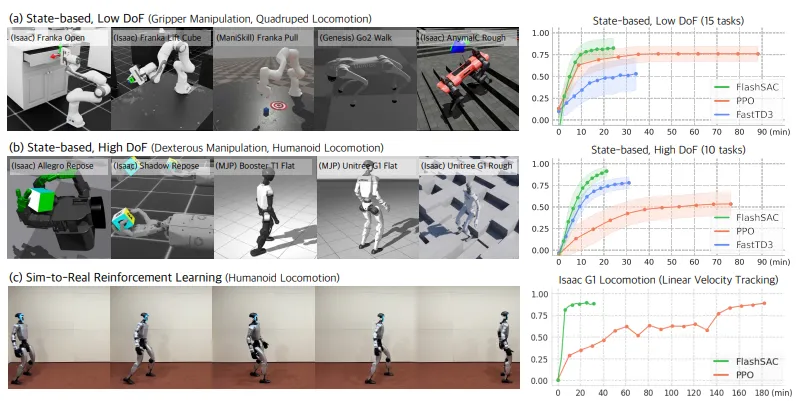
▲图 | FlashSAC通过更高效的数据利用和更稳定的训练策略,让高自由度机器人运动控制的学习过程明显加快。©【深蓝具身智能】编译
Muninn:扩散模型生成的动作很好,但机器人等不起怎么办?
🏆 Outstanding Student Paper Award
发文团队:伊利诺伊大学厄巴纳-香槟分校、佛罗里达国际大学等
扩散模型已经被广泛用于机器人轨迹生成。它能够从复杂的动作分布中生成平滑、多样的轨迹,但也存在一个问题:每次生成结果,都需要经过多轮去噪计算。
对于离线生成视频来说,多等一会儿可能没什么。但机器人需要持续根据环境变化更新动作,如果每次规划都要进行大量计算,就可能跟不上现实世界的变化。
Muninn提出了一种不需要重新训练模型的加速方法。
它观察到,扩散模型在相邻去噪步骤中,有些计算结果变化并不大。如果能够判断哪些结果可以安全复用,就不必每一步都重新执行完整网络。
因此,Muninn引入缓存机制,并估计复用缓存可能带来的误差。只要误差仍在允许范围内,就直接使用之前的计算结果;当误差风险变大时,再重新调用模型。
这种方式在保持轨迹质量与相关安全指标的同时,实现了最高约4.6倍的计算加速,并通过无人船、无人机和机械臂等硬件实验进行了验证。
这项研究给出了一种很实用的思路:想让机器人模型跑得更快,不一定非要重新训练一个小模型,有时优化推理过程本身也能取得明显收益。
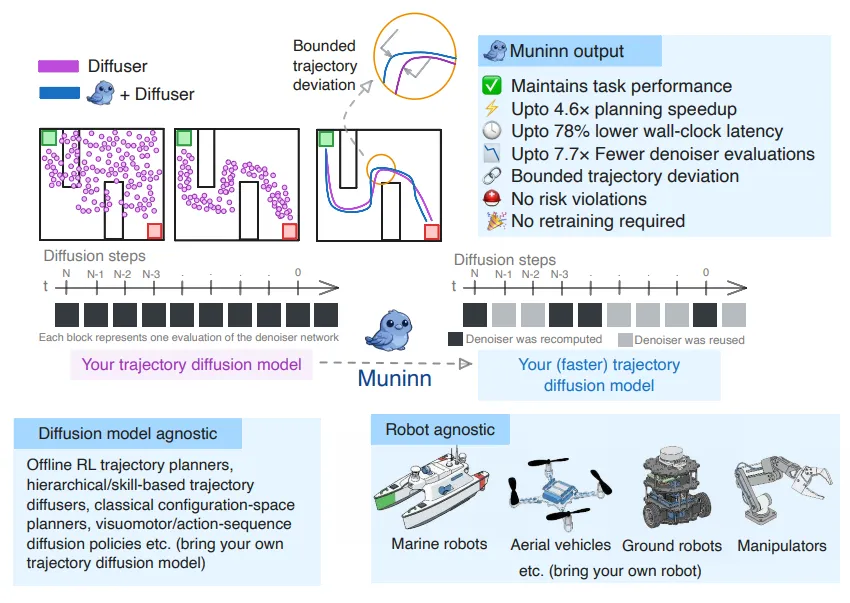
▲图 | Muninn不会让扩散模型在每一步都重复执行完整计算,而是根据预测误差决定是否复用已有结果。©【深蓝具身智能】编译
NeuralActuator:电机不够贵,机器人就无法准确感知受力吗?
🏆 Outstanding Systems Paper Award
发文团队:MIT、Amazon Robotics
机器人执行一个动作,最终还是要依靠电机。
但低成本电机并不总是能够按照理想的物理模型工作。齿轮摩擦、机械间隙、温度变化都会影响实际输出,导致仿真中的力矩与真机表现出现差异。
如果机器人没有高精度的力矩传感器,想准确判断自己施加了多大的力、是否碰到了外部物体,也会更加困难。
NeuralActuator提出了一个有意思的办法:通过神经网络学习电机真实的非线性行为。
研究将电机命令、电流、电压、温度和关节状态等历史信息输入Transformer模型,预测电机力矩、外部接触力和运行状态。
这样,机器人不必完全依赖昂贵的力觉传感器,也能够从已有的电机信息中估计部分外部受力情况。
团队在不同成本和结构的机械臂上验证了这套方法,并展示了其对机器人动力学建模和抓取任务的帮助。
这项研究提醒我们,机器人智能不只存在于视觉模型和高层决策中。对电机和执行器这些底层硬件的准确理解,同样会影响机器人最终能否稳定完成操作。
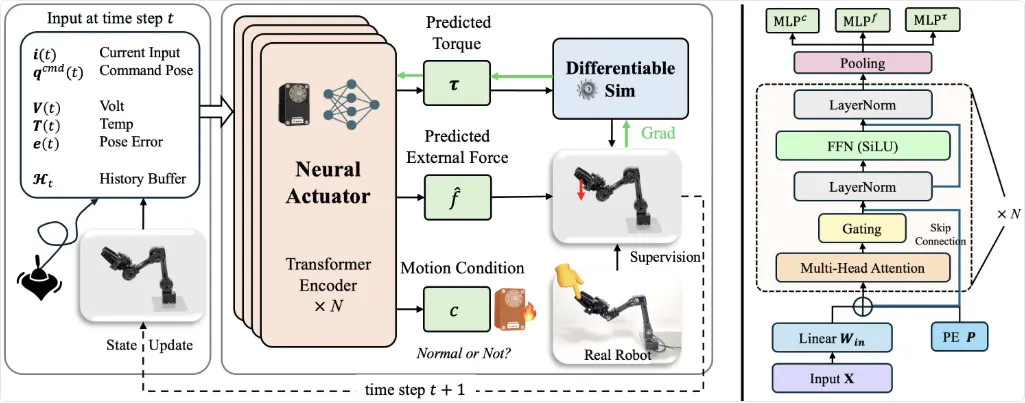
▲图 | NeuralActuator从电机命令、关节运动和电流等历史信息中学习真实执行器的动力学,再估计关节输出和外部接触力。©【深蓝具身智能】编译
IROS 2026:机器人开始关注长期工作与真实任务可靠性
IROS今年的获奖研究覆盖范围更广,从视觉语言导航、人形移动操作,到长期场景记忆和工业抓取,都有代表性成果。
LT-Mem:机器人在同一个地方待上一年,究竟应该记住什么?
🏆 Best Paper Award
发文团队:韩国大邱庆北科学技术院
一台长期在办公室工作的机器人:今天它看到椅子放在会议桌旁边,明天椅子被搬到门口,过几天又回到原来的位置。如果机器人每次都直接更新地图,就可能只记得椅子现在在哪里,却忘记它之前发生过什么变化。
这就是长期场景理解中的一个难题:机器人需要的不只是最新地图,还需要历史记忆。
LT-Mem提出了一套能够感知物体变化频率的时空记忆系统。
它先利用多次访问中的空间定位结果,把不同时刻观察到的物体对应起来,再根据物体是否经常移动,决定哪些信息应该更新、哪些历史需要保留。
更重要的是,它将记忆分成三种:
Live负责记录当前状态,Delta保存发生过的变化,Meta则记录长期统计信息。
例如,机器人可以回答“绿色椅子现在在哪里”,也能回答“这个篮子过去移动过几次”,甚至判断哪些物体适合长期作为导航参照物。
这种记忆方式让机器人在长期场景理解任务中取得更好的表现,同时减少了反复把历史图像送入大模型进行推理的开销。
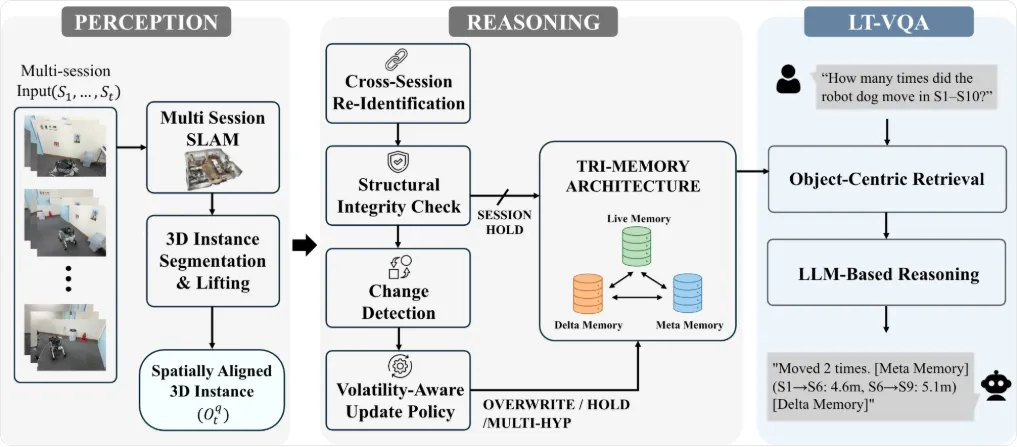
▲图 | LT-Mem不再只保存场景的最新状态,而是同时记录物体当前的位置、历史变化和长期统计信息。©【深蓝具身智能】编译
SteadyTray:机器人已经会走路,为什么端个托盘还是这么难?
🏆 Best Paper Award on Mobile Manipulation
发文团队:加州大学圣地亚哥分校
人形机器人已经能够完成相当复杂的行走动作,但如果让它端着一个放有物体的托盘向前走,任务就完全不同了。
因为双足机器人每走一步,都会产生身体摆动和落脚冲击。这些扰动会传到手臂和托盘,让没有固定的物体发生滑动,甚至直接掉下来。
如果从零开始训练一个同时负责走路和端稳托盘的大策略,成本很高,还可能破坏机器人原本已经掌握的行走能力。
SteadyTray选择把两件事情分开处理。原有的行走策略继续负责双足运动,额外的残差强化学习策略则控制上半身和手臂,用来抵消行走产生的晃动。
这样,机器人不需要重新学习怎样走路,而是在已经具备的运动能力上,增加一项稳定负载的技能。
团队在Unitree G1上完成了真实硬件验证,展示了机器人在行走过程中保持托盘稳定的能力。
这项工作反映了人形机器人研究中的一个实际方向:与其重新训练一个包办所有事情的模型,不如让已经成熟的技能相互配合,共同完成更复杂的工作。
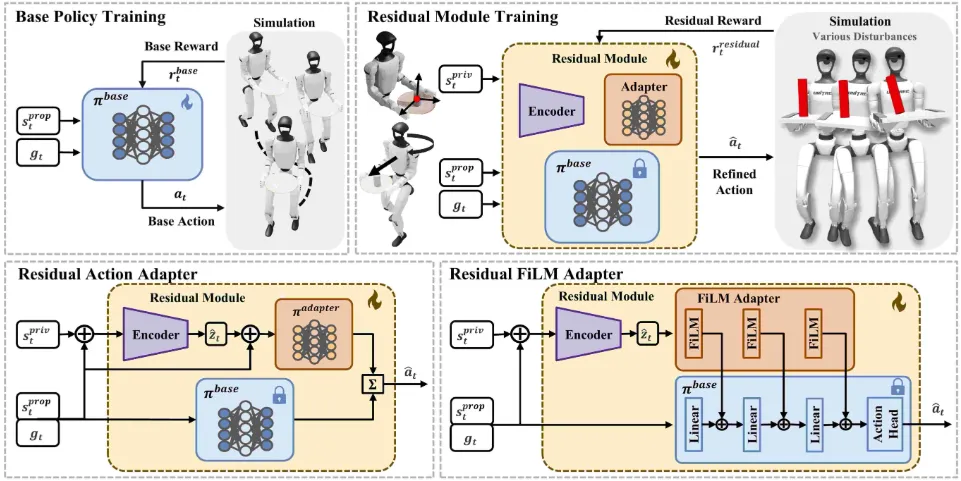
▲图 | SteadyTray保留已有的行走策略,再通过额外学习的上半身动作抵消步态扰动,让机器人能够一边走路一边稳定搬运物体。©【深蓝具身智能】编译
VL-Nav:机器人听懂了指令,为什么还是找不到目标?
🏆 Best Paper Award on Cognitive Robotics
发文团队:纽约州立大学布法罗分校、CMU等
“去找到打印机旁边的椅子。”
机器人要完成这一任务,首先得找到打印机,再判断它旁边有哪些椅子,最后确定应该去哪个位置。
这里的难点已经不只是识别物体,而是理解物体之间的空间关系。
传统视觉语言导航方法可以通过大量数据学习指令和动作之间的映射,但遇到复杂的相对位置关系时,仍可能出现推理错误。
VL-Nav提出了神经符号结合的方案。
视觉模型负责识别环境中的物体和语义信息,结构化符号推理则负责处理“旁边”“左侧”“同一层楼”等空间与逻辑关系,再将推理结果转化为导航目标。
这样的设计,让模型不必把所有空间关系都隐含在一个端到端黑箱中,而是通过显式的关系结构完成推断。
这篇研究也说明,大模型进入机器人之后,并不意味着所有传统结构化方法都失去了价值。对于某些需要明确逻辑和空间约束的任务,神经网络与符号方法的结合仍然具有优势。
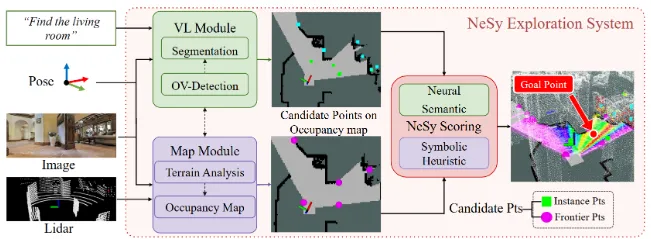
▲图 | VL-Nav将视觉感知和结构化关系推理结合起来,让机器人能够根据语言描述定位真正的导航目标。©【深蓝具身智能】编译
Picking Bins Empty:机器人抓得准,不代表它能把整箱零件抓完
🏆 Best Paper Award for Industrial Robotics Research for Applications
发文团队:梅赛德斯-奔驰、德国航空航天中心
工业机器人抓取零件,看起来已经是一项相当成熟的技术。
但现实中的料箱抓取有一个很实际的问题:机器人可能能够连续成功抓取很多次,却在最后几个零件被遮挡、姿态特殊或者抓取点不可用时突然卡住。
对于工厂来说,能抓起90%的零件和能把整箱零件抓空,完全不是同一种自动化体验。
Picking Bins Empty就是围绕这个问题展开的。
研究将基于模型的精确抓取和无模型的探索式抓取结合起来。当正常抓取方案失败时,系统会根据失败原因逐级切换处理方式,尝试寻找新的可行抓取点。
同时,它会根据夹爪实际运动反馈,在线统计哪些抓取方式更加可靠,并逐步减少对容易失败抓取点的使用。
在论文的工业零件实验中,这套方法把料箱清空率从基线的50.9%提升到了100%。
对于工业机器人来说,单次动作的最高成功率固然重要,但能否持续完成整个任务、减少人工介入,往往更直接决定技术的实际使用价值。
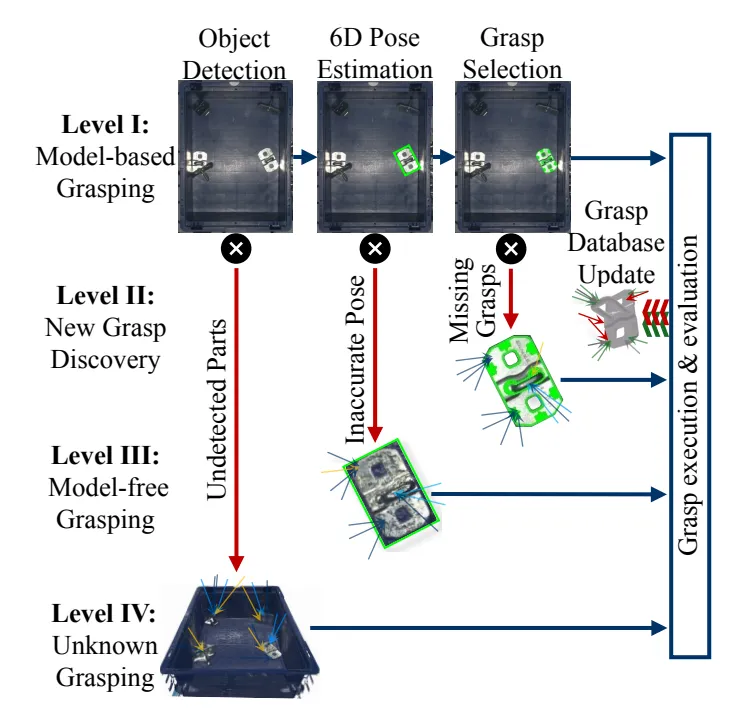
▲图 | 该系统通过分层回退和在线更新抓取点,减少因单次失败导致整项任务中断的情况。©【深蓝具身智能】编译
CoRL 2026:世界模型和长记忆,开始改变机器人怎么学习
11月刚刚举行的 CoRL,将今年机器人学习领域的一些热点推向了更具体的问题。
获得两项主要论文奖的SuperMimic和RoboTTT,分别研究训练效率与长期记忆。
一个试图利用可微世界模型大幅降低人形机器人训练成本,另一个则让机器人能够在执行任务时持续利用更长的历史经验。
SuperMimic:128张GPU训练7天,为什么现在单卡3小时就能追上?
🏆 Best Conference Paper Award
发文团队:加州大学伯克利分校
训练人形机器人完成大量全身运动,通常需要在物理仿真中进行海量强化学习。
当训练动作从几十种扩展到成千上万种时,计算成本会迅速增长。过去,一些高性能人形运动模型需要依赖大规模GPU集群才能完成训练。
SuperMimic提出了另一种思路:先学习一个能够预测机器人运动规律的可微世界模型,再让策略在这个模型中训练。
与传统物理仿真不同,可微世界模型能够提供动作变化对最终结果影响的梯度,让模型不必完全依赖大量试错来判断应该如何改进动作。
它相当于让机器人先在一个可以快速推演、也可以直接提供优化方向的虚拟世界中练习运动。
实验中,SuperMimic只使用一张GPU训练约3小时,就超过了此前需要128张GPU训练7天的SONIC模型在相应基准上的表现。研究还在真实Unitree G1上展示了多种复杂动作。
这项研究值得关注的地方,在于它让世界模型不再只是用于预测未来画面,也可以直接成为高效训练机器人运动策略的工具。
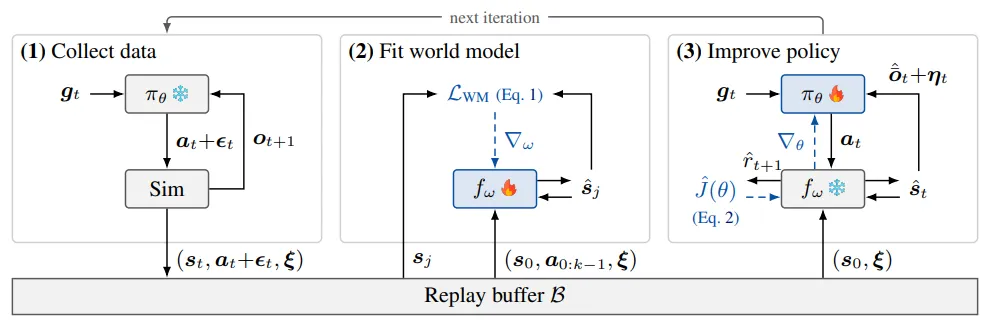
▲图 | SuperMimic利用一个共享的可微世界模型,让机器人在虚拟环境中快速推演身体运动,并通过梯度直接优化动作策略。©【深蓝具身智能】编译
RoboTTT:机器人做任务做到一半,为什么总是忘记前面发生了什么?
🏆 Best Student Paper Award
发文团队:NVIDIA、斯坦福大学、得克萨斯大学奥斯汀分校
对于机器人来说,完成一个需要持续几分钟的装配任务,难点不只是每一步动作是否准确。
它还需要记住之前装好了哪些零件、哪些步骤失败过、当前任务应该继续到哪里,以及如何根据过去的操作调整下一步动作。
但许多机器人策略只能利用当前画面和较短的历史观测。随着任务越来越长,历史信息难以完整保留,模型也容易出现重复操作或错误决策。
RoboTTT提出了一种不同的记忆方式。
它不再单纯依赖不断增长的历史缓存,而是使用测试时训练(Test-Time Training),将过去的视觉和动作经验逐步写入模型的快速更新参数中。
这样,机器人可以在持续执行任务的过程中,不断利用新的观察更新自己的内部状态,而不需要始终保存完整的历史画面。
RoboTTT将机器人策略的上下文扩展到了8000个时间步,并在真实机器人上完成了持续约5分钟、包含多个阶段的双臂装配任务。
更有意思的是,研究还展示了模型根据一段人类操作视频完成新配置装配任务的能力。
这意味着机器人策略正在尝试从单步动作预测,向更长时间范围内的持续学习和任务执行发展。
▲图 | RoboTTT在机器人执行任务的过程中不断利用新观察更新内部记忆,使模型能够参考更长时间范围内的操作历史。©【深蓝具身智能】编译
2026年的机器人研究,正在解决什么?
把这12篇获奖论文放在一起看,会发现今年的机器人研究虽然仍然围绕学习、感知和控制展开,但一些值得注意的变化已经出现。
第一,机器人学习正在变得更加高效。
OmniRetarget让人类动作更容易转化为机器人训练数据,FlashSAC缩短了强化学习所需的训练时间,Muninn减少了扩散模型重复计算,而SuperMimic进一步尝试用可微世界模型降低人形运动训练成本。
这些工作从不同角度解决了同一个问题:机器人不可能永远依靠增加计算资源和人工数据来获得能力,如何让每一次训练更有效,正在变得越来越重要。
第二,机器人开始更加重视长期执行,而不是单次动作。
SymSkill关心多个技能应该如何组织,LT-Mem研究长期场景记忆,RoboTTT尝试让机器人记住更长时间的操作历史。Picking Bins Empty则将重点放在了工业任务真正的完成率上。
它们共同提醒我们,机器人能够成功完成一次抓取、一次导航或者一次动作演示,并不代表它已经具备长期自主工作的能力。
真正复杂的任务,往往需要机器人持续理解环境、记住历史、处理失败,并根据实际情况调整后续行为。
第三,物理世界本身,依然是机器人无法绕开的核心问题。
NeuralActuator关注低成本电机的真实动力学,SteadyTray研究双足行走时产生的身体扰动,OmniRetarget强调人与机器人之间的身体和接触差异,VL-Nav则重新引入明确的空间结构。
这些研究说明,即使大模型拥有越来越强的视觉理解和推理能力,机器人最终仍然需要面对真实的力、摩擦、碰撞、几何关系和硬件限制。
模型越强,反而越需要可靠的物理感知、运动控制和工程系统,才能把智能真正转化为现实中的行动。
当然,12篇获奖论文不能代表机器人领域的全部研究方向,它们也不是对某条技术路线的最终裁决。但这些得到学术界认可的工作,至少让我们看到了几项持续受到重视的问题:如何降低训练成本、如何完成长程任务,以及如何让算法更加可靠地作用于物理世界。
如果说过去几年机器人研究不断证明“机器人还能学会什么”,那么2026年的这些获奖工作,已经开始更多地回答另一个问题:机器人学会之后,怎样才能真正把事情做好。
这或许是今年四场顶会获奖论文最值得读者记住的一条共同线索。
编辑|阿豹
审编|具身君
Ref
ICRA 2026
1. OmniRetarget: Interaction-Preserving Data Generation for Humanoid Whole-Body Loco-Manipulation and Scene Interaction
2. SymSkill: Symbol and Skill Co-Invention for Data-Efficient and Reactive Long-Horizon Manipulation
3. Do You Know Where Your Camera Is? View-Invariant Policy Learning with Camera Conditioning
RSS 2026
4. FlashSAC: Fast and Stable Off-Policy Reinforcement Learning for High-Dimensional Robot Control
5. Muninn: Your Trajectory Diffusion Model But Faster
6. NeuralActuator: Neural Actuation Modeling for Robot Dynamics and External Force Perception
IROS 2026
7. LT-Mem: Volatility-Aware Spatio-Temporal Memory for Lifelong Scene Understanding
8. SteadyTray: Learning Object Balancing Tasks in Humanoid Tray Transport via Residual Reinforcement Learning
9. VL-Nav: Neuro-Symbolic Reasoning-based Vision-Language Navigation
10. Picking Bins Empty: A Hierarchical Hybrid Approach with Online Self-Learning of Grasp Points for Reliable Industrial Bin-Picking
CoRL 2026
11. SuperMimic: Scaling Humanoid Whole-Body Control with One Differentiable World Model
12. RoboTTT: Context Scaling for Robot Policies
来源:深蓝具身智能