
机器人动作数据长期面临采集成本高、规模有限的问题,而互联网视频和人类第一视角数据中,包含着海量的物体交互与操作经验。如何利用这些数据训练机器人,是具身基础模型需要解决的问题。Motubrain 2.0 尝试将 200 万小时互联网视频与 50 万小时具身数据统一到一个 20B 参数的 World Action Model 中。250 万小时的数据规模,需要解决不同数据来源之间的表示差异,如何让视觉、语言与动作建立有效的监督关系,让视觉、语言与动作形成一致的监督关系,使模型能够从人类操作经验中学习,并将其迁移到真实机器人上。
Motubrain 2.0 采用 Text、Video、Action、Depth 四流架构,通过多模态联合预训练获得一定的 Zero-shot 任务泛化能力,再利用 Few-shot SFT 和 DAgger 提升特定任务的执行成功率。在此基础上,团队还搭建了由 VLM Agent、Memory、Skills、Tools 和 Action Model 组成的具身执行系统,并开始探索 Harness Evolution。
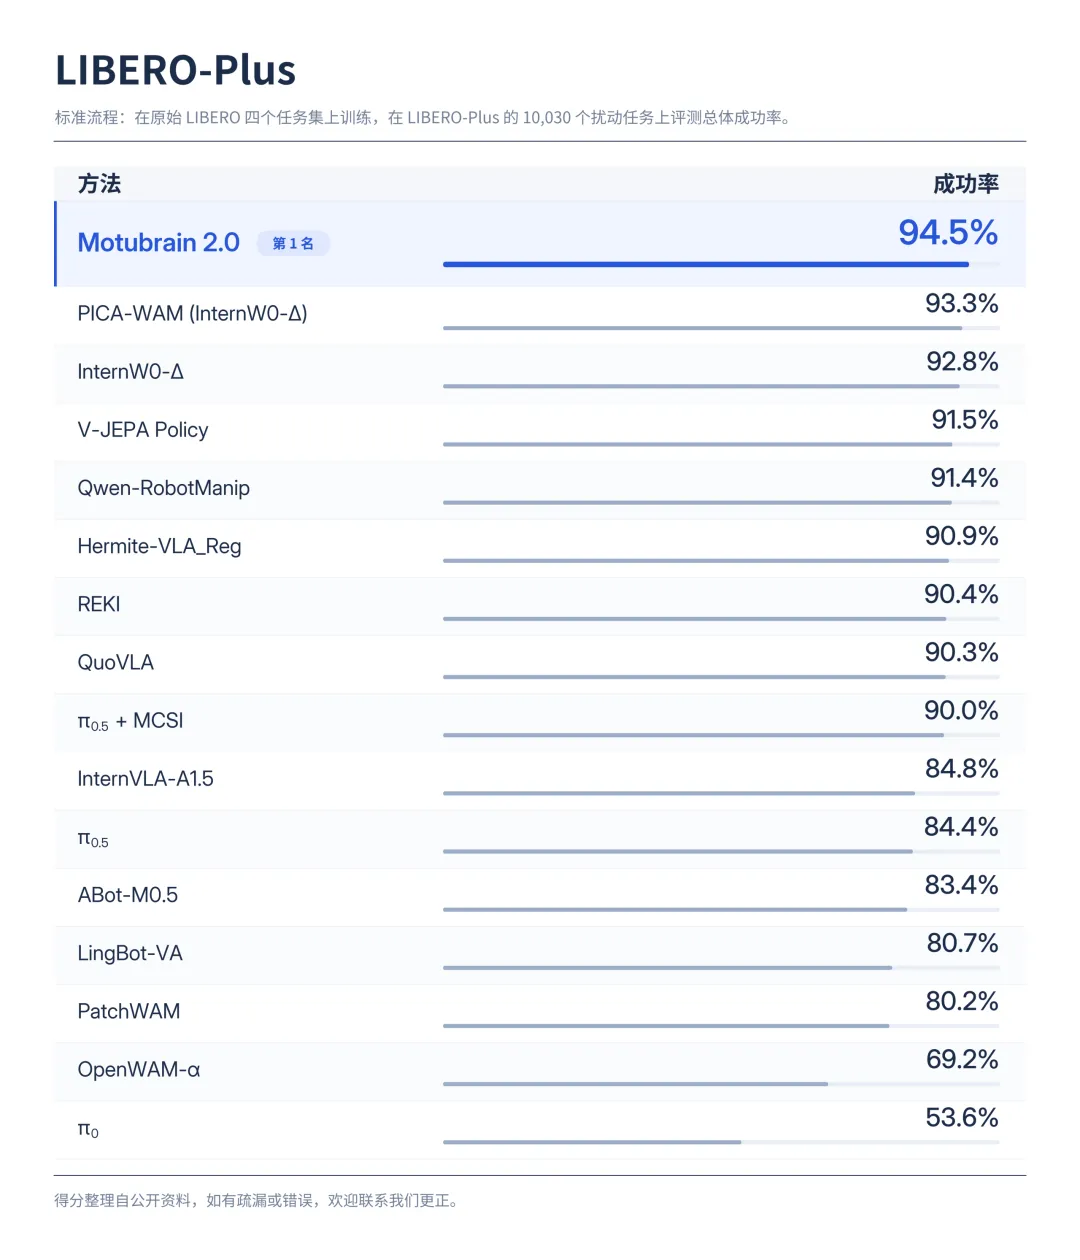
在外部评测中,Motubrain 2.0 也取得了不错的成绩:RoboCasa365(Top 1,Avg. 64.7%)、RoboTwin 2.0(Top 1,Clean-to-Clean:91.50%,Clean-to-Random:83.16%)、EBench(WAM 类别 Top 1)、LIBERO-Plus(Top 1)、VLABench(Top 1)和 RoboDojo(Top 3)。其中,LIBERO-Plus 和 VLABench 的排名由团队根据公开评测结果自行计算。以上均为纯模型评测结果,没有 Agent 参与。
此次Motubrain将预训练、后训练、Agent 和 RSI 的研发全程直播,公开了训练曲线、真机评测、数据处理经验以及训练中遇到的问题。本文结合团队的技术介绍和直播解读分享的QA,重点梳理Motubrain 2.0 的数据体系、模型架构、训练方法与 Agent 设计。
250 万小时数据如何进入同一个模型
Motubrain 2.0 的预训练数据由互联网视频和具身数据两大部分组成。团队披露的数据规模如下:
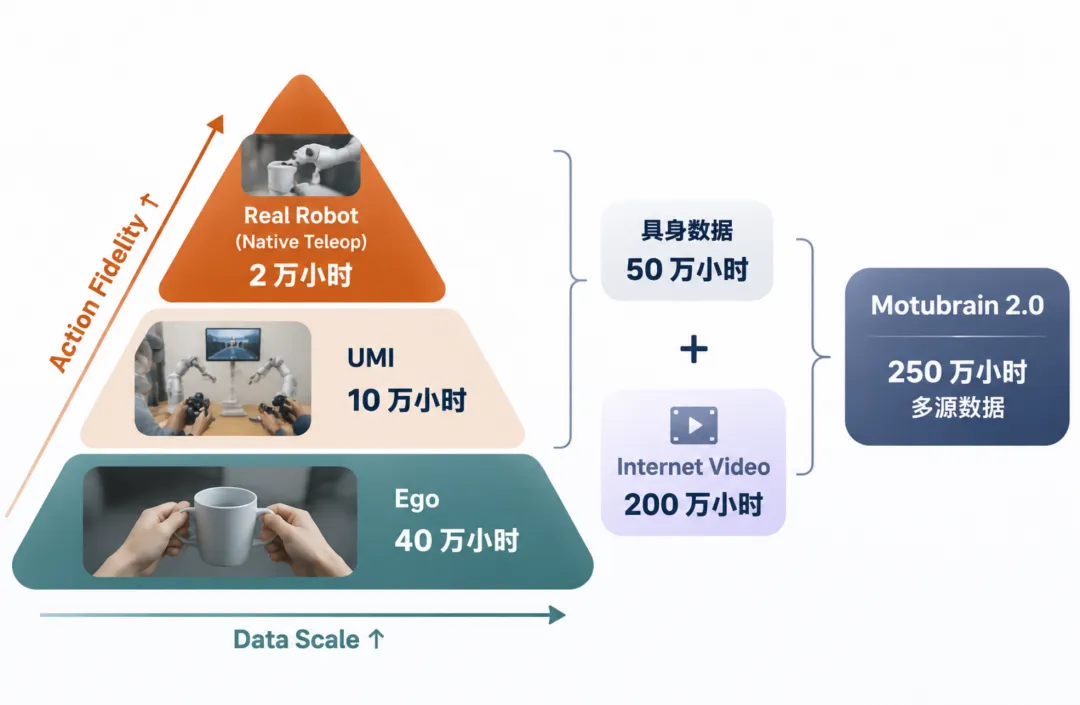
其中,具身数据约 50 万小时,包括 Ego、UMI 和真机数据。2 万小时真机数据涵盖多个本体,主要包括星尘 S1 和松灵机械臂。
大规模数据的获取只是第一步。互联网视频、Ego、UMI 和真机轨迹在相机视角、动作表示、视频分辨率和标注方式上存在明显差异。如何让不同来源的数据进入统一的训练框架,并在视觉、语言和动作三个层面建立对应关系,是整个数据工程需要解决的问题。
Motubrain在这部分积累了 140 多个数据处理算子,相关 Pipeline 持续开发了半年以上,后续计划开源其中一部分。数据对齐主要围绕 Action、Vision 和 Language 三个层面展开,其中 Action 对齐涉及的问题最多。
Ego 如何获得 Action 监督?
Ego 视频记录了人类在真实环境中的操作过程,但原始数据只有视觉观察,没有机器人可以直接使用的动作标签。对于缺少机器人动作标签的 Ego 视频,团队通过 Hand Pose 重建提取人手运动信息。具体做法是选取拇指、食指和中指等关键点,近似构造夹爪的 Hand Pose 与开合状态,再将手腕运动转换为机器人末端动作表示。
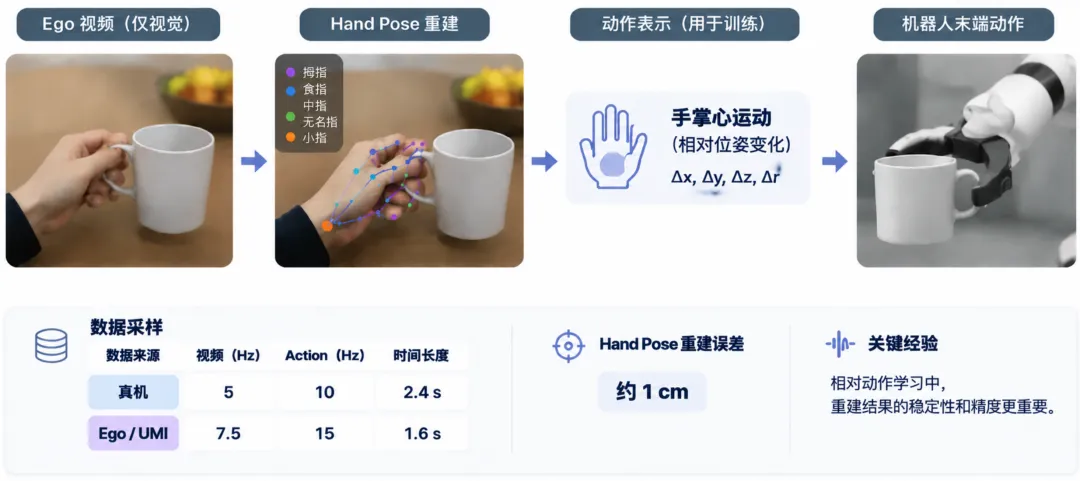
这里没有采用完整的 Human-to-Robot Retargeting。团队解释,他们当前训练的目标是夹爪,暂时不需要将人手的全部关节运动映射到机器人上。通过手腕坐标和夹爪开合信息,就可以建立相对简单的动作对应关系。
Ego 数据以 2Hz 采样,真机数据以 5Hz 采样。每次随机选择一个起始时刻,截取 2.4 秒的动作片段。Hand Pose 重建误差的要求约为 1cm,具体指标以及更多细节可以期待后续技术报告。
作者团队的同学还特别强调了一个细节,对于相对动作学习,重建结果的一致性比单帧的绝对精度更加重要。稳定的系统性偏差对相对位姿变化的影响相对有限,而随时间随机变化的重建误差则会直接影响动作监督质量。
跨本体动作如何统一?
不同机器人本体具有不同的机械结构、关节定义和世界坐标系。如果直接使用各自的绝对末端位姿,不同数据集之间很难建立统一的动作参考。
团队将不同来源的动作统一转换到相机参考系下。对于 Ego 数据,使用头部相机作为参考,需要结合相机外参将手部运动转换到相应坐标系;机器人数据也采用相对相机的动作表示,从而减少不同本体世界坐标定义带来的差异。
对于视觉条件下的操作任务,物体在图像中的上下左右可以由相机参考系直接确定。将人类手部运动和机器人末端动作转换到相机坐标系,有助于减少不同本体和数据采集环境带来的坐标差异。
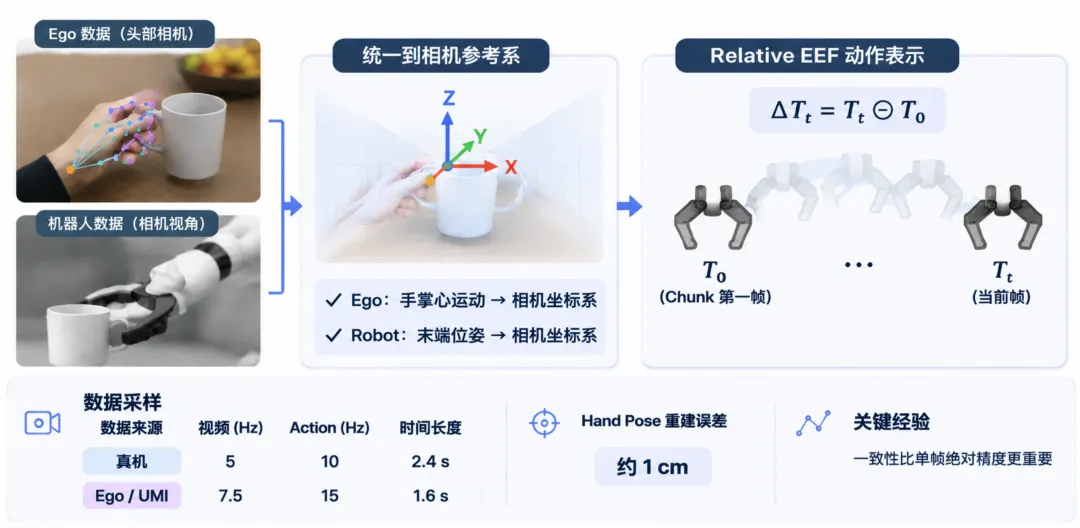
在此基础上,动作采用 Relative EEF 表示。一个 2.4 秒的 Action Chunk 内,每个时刻的 EEF 都相对于 Chunk 第一帧计算位姿变化:
其中, 是 Action Chunk 第一帧的末端位姿, 是当前时刻的末端位姿。模型学习的是相对于初始状态的位姿变化,而非直接预测绝对末端坐标。
这种表示既能减少不同本体之间的绝对坐标误差,也避免了连续 Delta 计算带来的误差累积。相机坐标系提供统一的空间参考,Relative EEF 则进一步统一了动作片段内部的位姿表达。
Vision 与 Language 如何处理?
视觉侧需要处理不同数据源在视频帧率、分辨率、宽高比和编码方式上的差异。团队对这些数据进行了统一处理,其中采用了 Variable Resolution 训练策略。
团队将不同视频的图像面积缩放到相近范围,同时保留原始宽高比,并对边缘进行必要裁剪,使最终尺寸满足 16 的倍数,以适配 VAE 输入。这样可以避免强制统一分辨率所带来的大量裁剪或 Padding。
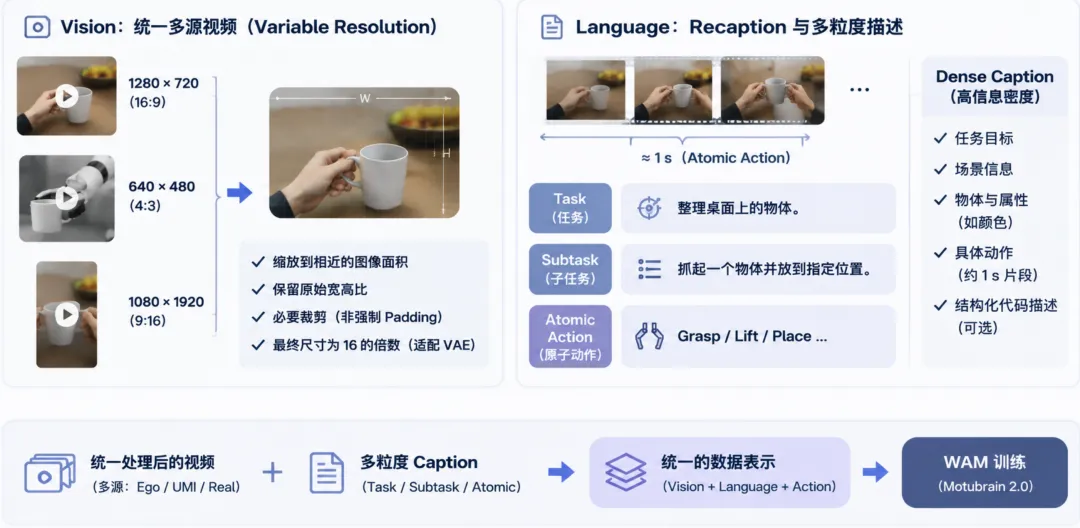
Language 侧则主要依靠 Recaption 统一不同来源的视频描述。团队不会直接使用采购数据原有的 Caption,而是按照内部标准重新标注,并将描述拆成三个粒度:
Task: 完整任务目标,例如整理桌面上的物体。
Subtask: 任务中的具体步骤,例如抓起一个物体并放到指定位置。
Atomic Action: 更细粒度的动作,例如 Grasp、Lift、Place。
每条数据都会生成这三种粒度的 Caption,训练时随机选择其中一种。这样,同一段操作视频既可以提供完整任务层面的监督,也可以提供子任务和原子动作层面的信息。
Motubrain希望通过更细粒度的 Caption,为模型提供尽可能丰富的条件信息。除了完整的任务目标,标注还会进一步覆盖场景、物体、颜色和具体动作,并将 Atomic Action 拆分到约一秒的片段。Video 和 Action 都采用条件生成方式,Condition 中的信息越充分,DiT 就越容易学习对应的生成任务。通过 Dense Caption 将任务、场景、物体和 Atomic Action 等信息显式提供给模型,可以降低生成过程对隐式信息推断的依赖。结构化代码描述同样可以作为高信息密度的 Condition,为生成过程提供更明确的约束。
数据处理最终要解决的,是不同来源的数据如何在同一套表示体系下参与训练。人类第一视角视频经过 Hand Pose 重建获得动作监督,不同本体的动作统一到相机坐标系和 Relative EEF,视频与语言则通过统一采样和 Recaption 建立对应关系。原本缺少机器人动作标签的人类操作视频,也由此获得了进入 WAM 训练的途径。
四流架构:让 Video 和 Depth 服务于 Action
MotuBrain 2.0 采用 Text、Video、Action、Depth 四流架构。
Text 提供任务指令,Video 提供视觉观察,Action 负责动作生成,Depth 提供空间几何信息。团队设计这套架构的出发点,是希望利用 Video 中更加丰富的监督信号帮助 Action 学习。
机器人动作数据相比互联网视频和语言数据,规模仍然有限。单纯依靠真机轨迹,模型很难覆盖足够丰富的物体、场景和操作方式。Video 能够提供大量与动作相关的视觉变化和物理交互信息,通过联合训练,可以让 Action 分支利用这些先验。
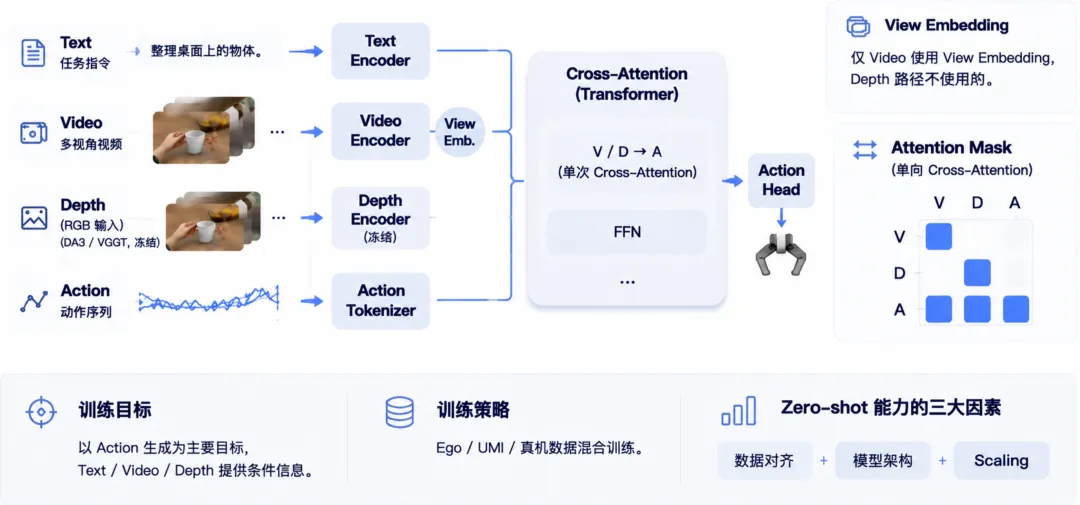
Depth 分支引入 DA3、VGGT 等已有模型的架构与预训练权重,作为独立的第四条流,并在训练过程中保持冻结。Action 分支通过 Cross-Attention 读取 Depth 特征,为动作生成提供额外的空间几何信息。
Video 和 Depth 分支均采用 View Embedding 处理多视角输入。不同相机画面分别编码,并加入对应的 View Embedding,随后通过 Joint Attention 实现跨视角的信息交互。模型不需要将不同视角的图像拼接成固定的 Pixel-space 大图,因此可以支持不同数量和布局的相机输入。相关消融实验中,View Embedding 相比传统拼图方式表现更好,且随着模型规模扩大,这一优势更加明显。
Video 与 Action 分支之间还设置了单向 Attention Mask,限制两个分支之间的信息流向。Action 分支可以通过 Attention 读取 Video 特征,Video 分支则不会读取 Action 信息。这样,视频中的视觉变化可以为动作学习提供先验,同时避免 Action 信息反向进入 Video 分支。
MotuBrain 2.0 的训练目标集中在 Action 生成,Text、Video 和 Depth 三个分支主要为动作建模提供条件信息。这一点也体现了它与 Cosmo 3 等全模态输入、全模态输出路线的区别:MotuBrain 更关注如何利用其他模态的先验提升机器人动作生成能力。
团队将 MotuBrain 2.0 的 Zero-shot 能力归结为数据对齐、模型架构和 Scaling 三个方面。不同来源的数据经过统一表示后可以共同参与训练,Video 和 Depth 为 Action 提供额外的视觉与空间先验,而模型和数据规模的扩大,则进一步推动这些知识向更多任务迁移。
预训练期间,团队没有将 Ego、UMI 和真机数据分阶段加入,而是直接混合训练。他们认为,分阶段训练可能使模型丢失此前获得的泛化能力和先验知识。
预训练后期:真机数据过采样引发的过拟合
Motubrain 2.0 的预训练曲线展示了 Clean 和 Random 两种场景下的成功率变化。
训练初期,Clean 场景的成功率高于 Random,因为场景相对简单,模型更容易学习。随着训练样本增加,两条曲线逐渐接近,模型进入相对稳定的阶段。真机评测本身存在较大方差,单次测试多失败一个样本,就可能让成功率变化约 10 个百分点。因此,团队也会参考 Avg. Score 判断模型整体表现,最终选择了 120K Step 的 Checkpoint。
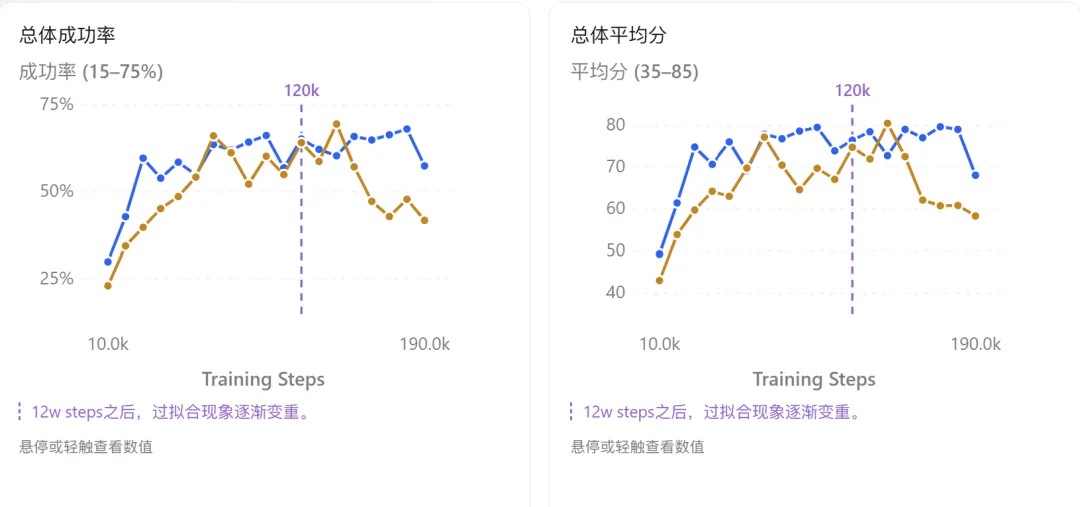
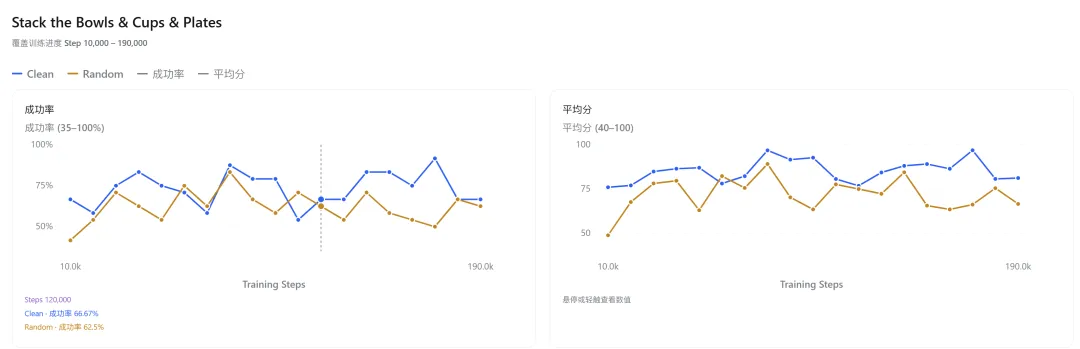
继续训练后,Clean 成功率仍然上涨,Random 却开始明显下降。团队将这一阶段判断为过拟合。
技术团队的同学在 QA 中详细解释了其中的数据原因。
原始数据中,真机只有 2 万小时,Ego 有 40 万小时,UMI 有 10 万小时。如果直接按照数据规模混合采样,真机数据占比会非常低。为了提高高质量真机数据在训练中的权重,团队主动调整了 Sample Weight,将真机数据相对于其他具身数据的采样比例提高到约 1:10。
问题也随之出现。
在 120K Step 左右,真机和 UMI 数据基本已经经过一个 Epoch,而 Ego 数据可能只训练了约三分之一到二分之一。真机数据被反复采样,Ego 数据却还没有得到充分利用。
对于 20B 模型而言,2 万小时真机数据显然不足以支撑持续训练。随着模型反复接触相似的真机分布,Clean 场景表现继续提升,Random 场景的泛化能力却开始下降。
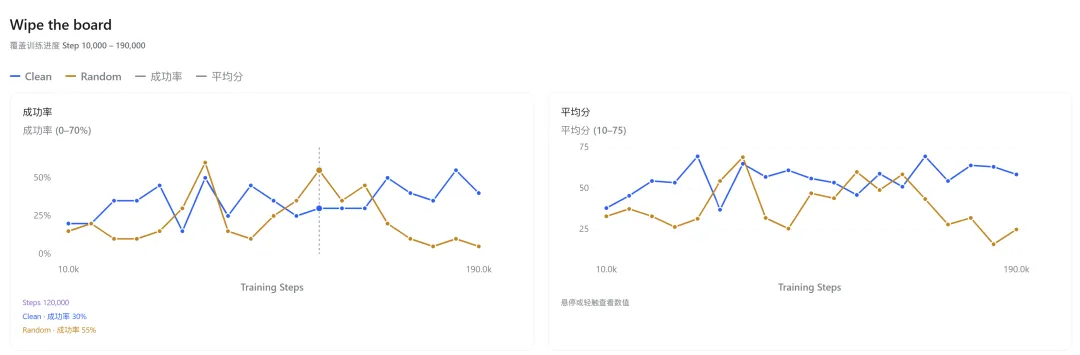
团队认为真机数据采样权重设置过高,是这次过拟合的重要原因之一。下一轮训练需要进一步调整真机数据的 Sample Weight,同时增加可用数据规模。
根据团队此前多轮小规模预训练积累的经验,Real Robot、UMI、Ego 的采样权重可以参考 1:5:20,进一步调整到 1:5:10 左右可能更合适。互联网视频的采样规模则需要比 Ego 高一个数量级以上。团队也明确表示,这些配置仍然来自经验积累,尚未完成系统性的 Data Balance 消融实验。
多源数据预训练中,原始数据规模与实际采样次数之间存在很大差异。模型究竟应该看到多少次真机轨迹、多少次人类操作视频,以及不同数据源的有效 Epoch 应该如何定义,都需要结合模型规模和数据质量进一步验证。
Ego 数据能为机器人带来什么
在 QA 中,有研究者直接询问:加入约 50 万小时 Ego 和 UMI 数据后,究竟给机器人操作带来了多少增益?
团队表示,他们做过纯真机数据与混合数据的对比。对于未见过的物体,纯真机训练模型在 Zero-shot Pick-and-Place 任务上的成功率可能下降到 50%,而加入 Ego 和 UMI 后,模型在简单任务上可以达到 100%。
团队还分享了一个内部测试案例:机器人训练数据中没有大量使用刀具的真机轨迹,但 Ego 视频里存在大量人类拿刀切菜、做饭的场景。经过 Ego 数据训练后,模型能够识别刀具,并尝试使用刀具完成切割操作。
这类数据提供的知识,超出了机器人自身采集轨迹所能覆盖的范围。人类日常操作中包含大量物体使用方式、工具功能和操作顺序,Ego 视频可以将这些经验带入机器人模型。
Few-shot 后训练:从一条示范开始
预训练模型获得较广泛的任务先验后,后训练阶段主要解决特定任务的执行成功率问题。
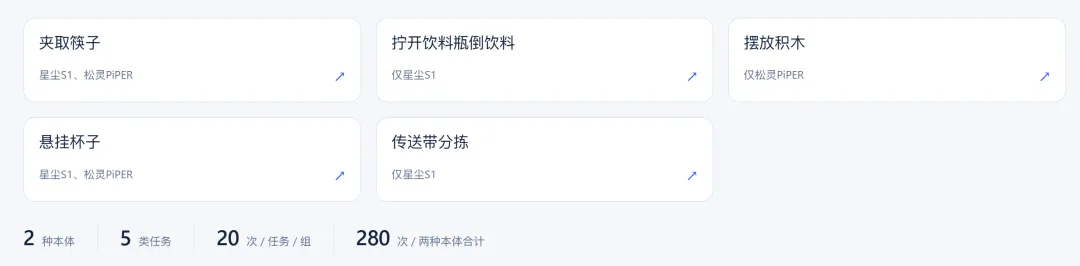
团队在讲解时分享了几类任务:拧开饮料瓶并倒水、捡起筷子插入桶中、将杯子挂到挂钩上,以及在传送带上进行动态分拣。
这些任务分别考察长程操作、精细操作、空间感知和动态环境适应能力。
头部摄像头视角
拧瓶盖倒水需要机器人先旋开较紧的瓶盖,再控制瓶身完成倒水;插筷子要求抓取非常细的物体,并将其准确放入桶中;挂杯子需要识别杯把的位置,通过旋转让把手对准挂钩;传送带分拣则要求机器人在物体持续运动的情况下完成分类。
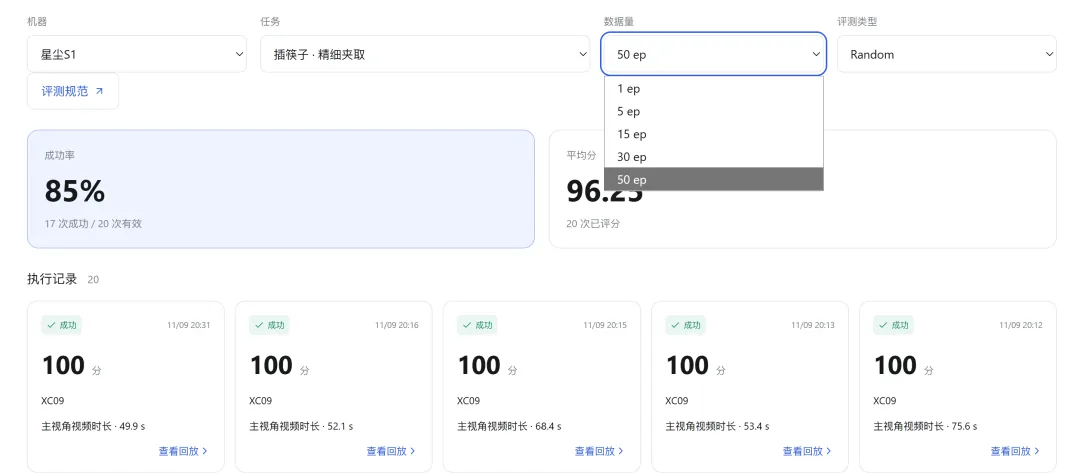
团队展示的 Few-shot 结果中,插筷子任务只需要一条示范就能出现明显效果;拧瓶盖任务使用 5 条数据后,成功率迅速提升;挂杯子任务在 5 条数据后开始明显改善,15 条左右已经接近 80%;传送带分拣使用约 5–15 条数据,也能达到约 75% 的成功率。
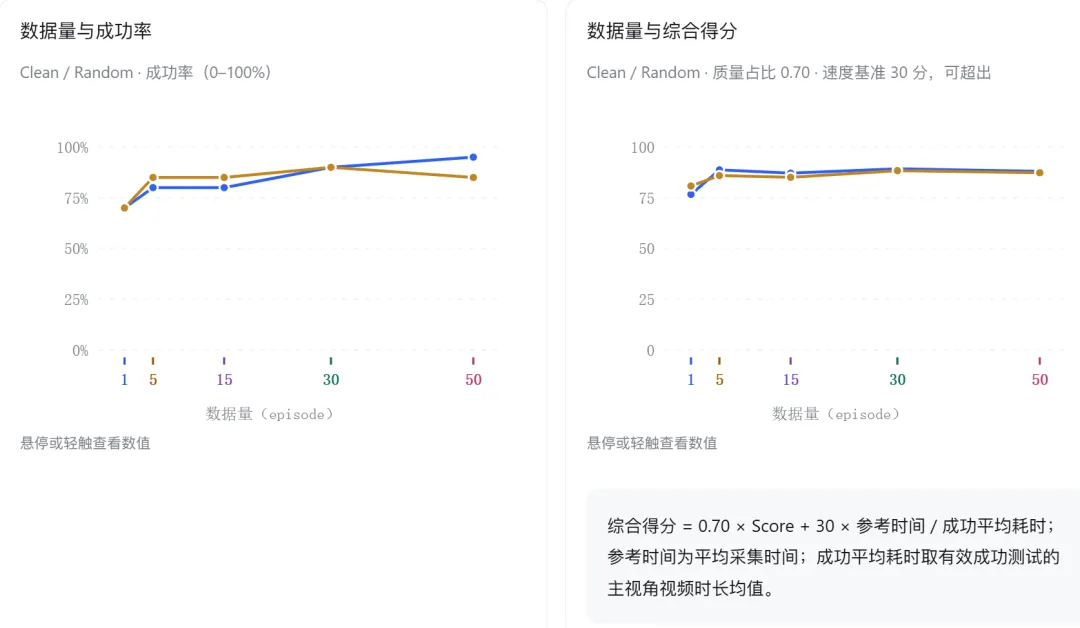
这些实验的共同点是,预训练模型已经具备一定的任务理解和动作先验。后训练数据只需要告诉模型目标任务的具体执行方式,就能够快速适应。
后训练主要采用 SFT,并加入少量 DAgger。团队明确表示,Few-shot 实验中使用的就是对应数量的目标示范数据,没有额外混入其他训练数据。无论示范数量多少,训练统一采用 4 个 Epoch,通常只需要几百个 Step。
团队采用统一的 4 Epoch 训练设置,控制 Few-shot 后训练的训练量,避免针对少量任务过度训练。后训练的目标是快速适应特定任务,同时尽量保留预训练阶段获得的泛化能力。
后训练还加入了 Training RTC,使不同 Action Chunk 之间能够更加连续地衔接。相比预训练 Checkpoint 测试时明显的动作停顿,后训练模型在连续执行任务时更加流畅。
团队目前仍然以 SFT 和 DAgger 为主要方案。SFT 最终会遇到成功率上限,模型总会在 Corner Case 上失败。如果需要达到 99.99% 这类工业级可靠性,RL 仍然是需要考虑的方向。但现阶段,团队更希望将资源投入模型的泛化能力,而不是针对少数任务持续提高成功率。
Agent:让 VLM 负责规划,让 WAM 负责操作
在 WAM 之上,Motubrain还构建了一个分层 Agent 系统。
上层由 VLM/LLM Agent 负责任务理解、规划和工具选择,下层则包括 Memory、Skills、Tools,以及 Motubrain 2.0 Action Model。WAM 主要承担精细操作和连续动作生成,Agent 负责更高层的语义推理与执行组织。
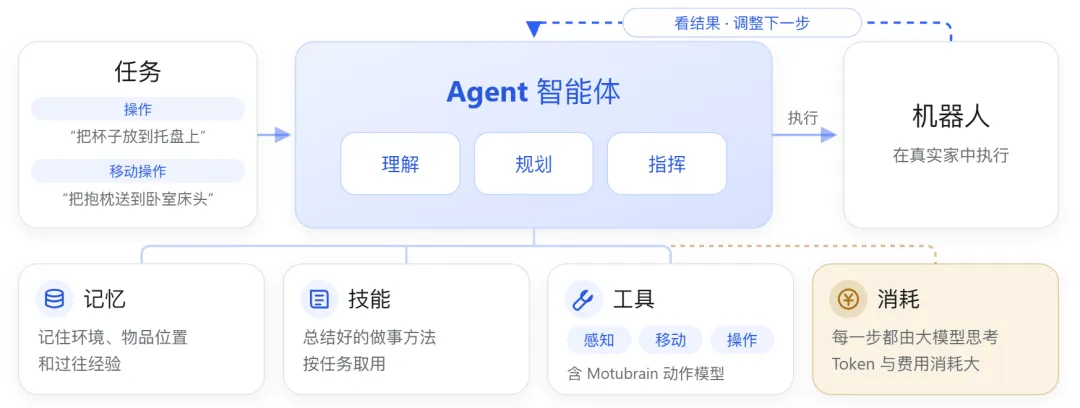
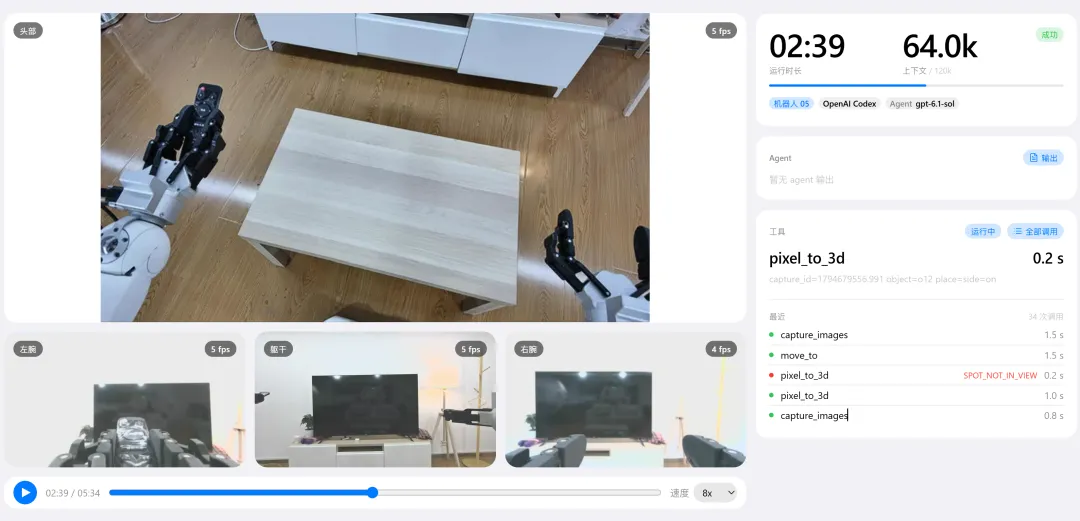
团队展示了一个将绿色杯子从岩板桌搬到岛台的案例。Agent 会先调用 Capture Image 获取图像,再使用 Pixel-to-3D 将图像中的像素位置映射到三维空间,随后根据目标位置调用 EEF 控制工具完成移动。
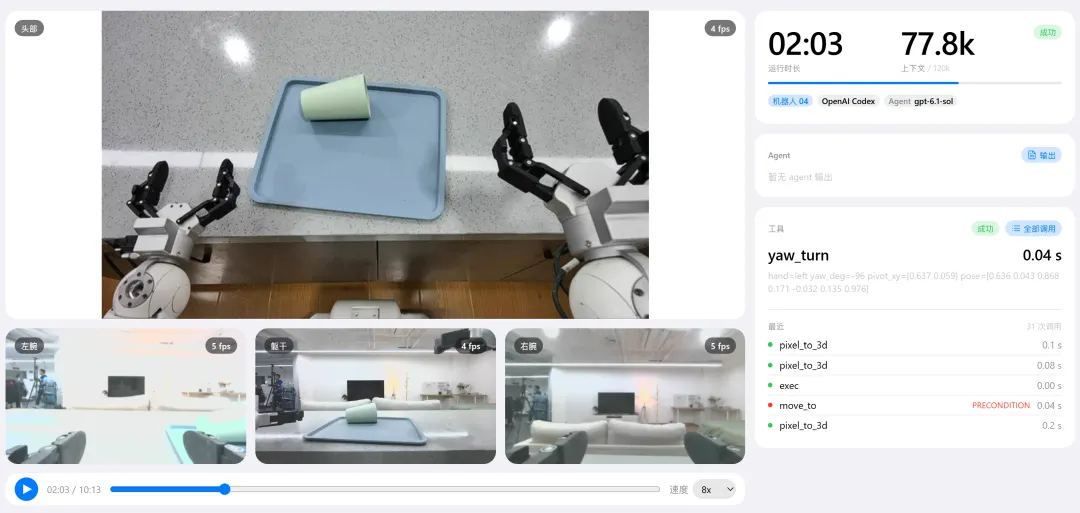
Pixel-to-3D 依赖头部和躯干相机的标定。机器人正前方区域的空间映射误差可以控制在约 1cm 以内,更远或偏向两侧的位置可能达到 3–4cm。
Agent 采用同步的工具调用方式:完成一次 Tool 调用后,等待执行结果返回,再决定下一步操作。它可以根据新的 Observation 调整后续动作,而不是一次性生成完整的任务执行序列。
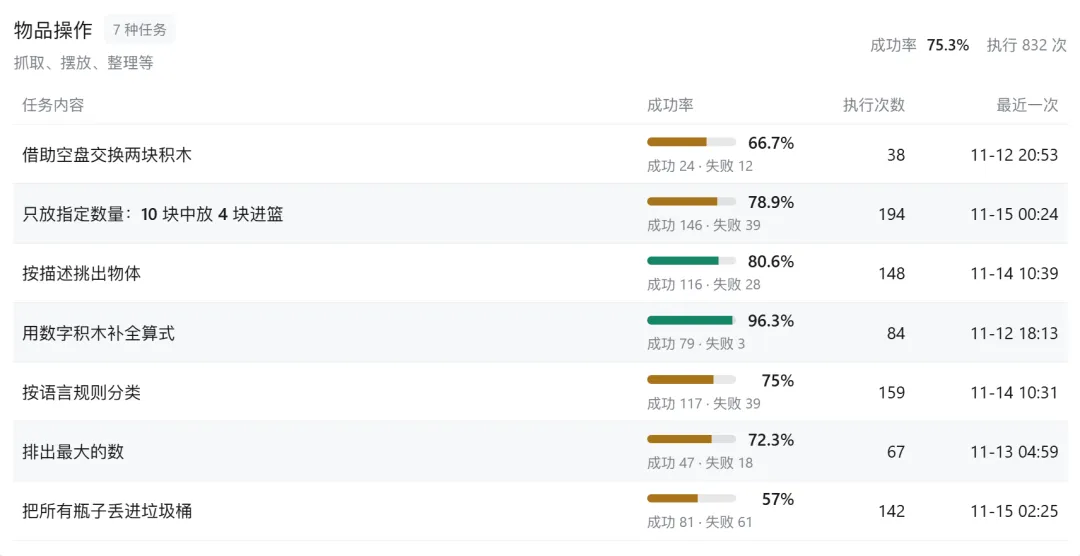
另一个案例更能体现上层规划的作用。
机器人需要将右手中的遥控器放到茶几上,但由于地图构建出现偏差,机器人移动到茶几右侧后,发现右手无法完成放置。Agent 随后调整执行计划,让机器人移动到旁边的书桌,将遥控器从右手交给左手,再移动到茶几完成任务。
这个过程中,WAM 不需要解决整个任务规划问题。Agent 根据当前空间状态和执行结果重新组织操作步骤,底层模型负责完成对应动作。
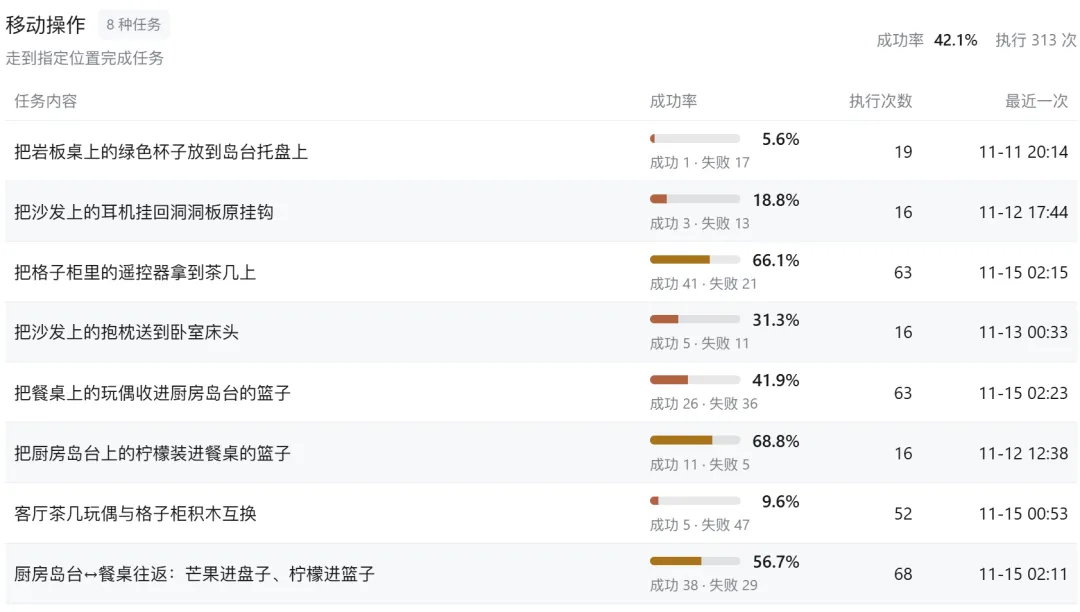
对于简单 Pick-and-Place,Agent 有时可以直接调用空间定位和 EEF 控制工具,不一定需要 WAM。面对拧瓶盖、插筷子、动态分拣等任务,VLM 的单独执行能力有限,才更需要调用底层 Action Model。
这种执行路径并没有被完全写死。Agent 可以根据任务判断应该调用哪些工具、是否使用 WAM,以及如何组织整个操作流程。
RSI:当前主要演化的是 Harness
Motubrain 2.0 的最后一个阶段是 RSI 的初步探索。
团队为 Agent 搭建了 Harness 框架,包括 Memory、Skills 和 Tools,并希望利用执行经验持续改进整个系统。
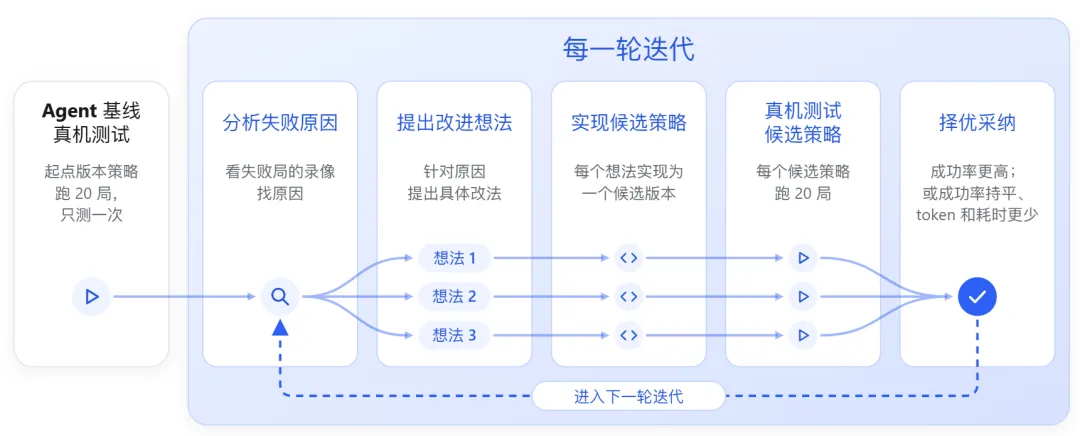
RSI 主要作用于 Harness 层面,WAM 的 Policy 权重暂时没有更新。工具和工作流程可以通过系统演化进行调整,但这还不等于底层动作模型已经实现自主持续学习。
团队认为,通用 VLM 在具身环境中仍然存在一些限制,例如推理延迟较高、三维坐标估计不够准确,以及需要多次调用视觉工具进行确认。Agent 如何与 WAM 协同,如何根据任务特点选择合适的执行方式,都需要进一步优化。
未来,团队也提出可以收集 Agent 指令、Observation 和 Action 数据,再用于 WAM 的训练。其设想是利用更强的 VLM 完成复杂任务,将其执行经验蒸馏到动作模型中,使底层模型获得更丰富的任务能力。
这仍然是一个待探索的方向。
Motubrain 2.0 当前展示的系统,已经能够将 VLM 的规划能力、工具调用和 WAM 的动作执行组织在一起。RSI 则开始尝试让这套系统根据自身经验调整 Harness。至于如何进一步将经验转化为新的 Action 数据,并持续更新 Policy,还需要后续实验回答。
让技术进步成为更多人的事
Motubrain 2.0 此次公开的内容,覆盖了多源数据预训练、跨本体动作对齐、Few-shot 后训练,以及 VLM Agent 与 WAM 的协同。从 140 多个数据处理算子,到四流架构的设计,再到训练过程中遇到的数据过采样和过拟合问题,团队将一套具身基础模型从数据准备、模型训练到真机评测的过程呈现在了社区面前。
分享的同学在直播结束后写小红书公开帖中谈到了他对平台价值的理解,一个平台的价值,不只体现在自身创造了多少成果,也体现在它帮助多少人取得了进步。他以清华和 Windows 为例,前者通过培养学生成就自身,后者通过开发者生态不断扩大价值。真正有生命力的平台,会让参与其中的人获得成长,也让他们创造的价值反过来推动平台和整个生态向前发展。
具身智能仍处于快速探索阶段,大规模数据处理、跨本体动作对齐、模型训练和真机部署,都需要大量工程积累。很多经验藏在训练曲线、数据 Pipeline、失败案例和具体的工程决策里。如果这些内容只留在团队内部,其他研究者就只能重新走一遍相似的路。把过程公开出来,意味着更多人可以在已有实践上继续探索,把时间花在新的问题上。
Motubrain选择用二十多天的连续直播呈现2.0的完整研发过程,周三的分享答疑也有认真回答社区同学们提出的一百多个技术问题。接下来,团队还计划开放相关模型与代码,并发布比上一版更加详细的技术报告。
技术普惠也不只是把代码放到 GitHub 上。它还意味着让研究者看见真实的技术路径,让工程师理解系统背后的取舍,让后来者能够复用已有工具和经验,让每个人的贡献都有机会被看见。一个团队积累的技术能力,由此才有机会转化为整个行业共同拥有的知识资产。
一个团队能走多远,或许也取决于它愿意带着多少人一起往前走。
来源:human five